SSync 用選擇式蒸餾改善影片物件分解

SSync 針對影片物件分解常見的對齊成本高、訊號互相拖累問題,提出更精準的學習方式。它不是改整套架構,而是補強 slot-based 方法的弱點。

SSync

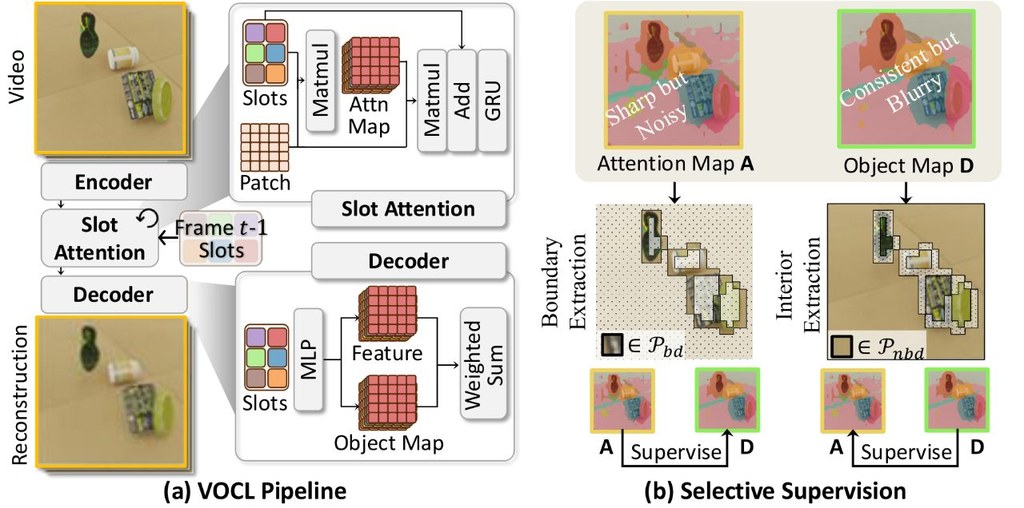
現有的 video object-centric learning(VOCL)多數沿用 slot-based frameworks,通常建基於 reconstruction-driven encoder–decoder architectures:encoder 產生 attention maps,decoder 產生 object maps,再嘗試把兩者對齊。近年的 dense alignment strategy 會對所有 spatio-temporal patches 做 contrastive learning,但這種全對全對齊會把 encoder 的雜訊和 decoder 的模糊邊界一併放大,計算量亦會升到 quadratic complexity,影片一長就更難擴展。

SSync(Selective Synergistic Learning)屬於一個可插入現有流程的 PyTorch 學習模組,目標是改善影片中的物件分解質素。它不是強迫所有 patch 全面一致,而是只挑選較可信的訊號做 mutual-distillation:用 encoder 幫手修邊界,用 decoder 清理物件內部雜訊,方向相當明確。

這項目把「全部都對齊」改成 selective distillation,並透過 pseudo-labeling 把成本降到 linear complexity。作者亦加入 transitive pseudo-label merging,處理 slot redundancy,將時序上反覆重疊的 slots 合併,減少模型把同一物件拆成多份的偏差。

如果你本身有研究 Slot Attention、影片分解、無監督物件發現,這項工作相當值得細看;如果你只是想快速試概念,亦可直接留意作者提供的 PyTorch implementation、Hugging Face 權重和 project page。它屬於 plug-and-play module,較適合已有 VOCL 基礎模型的人接入比較,而不是給完全零基礎讀者當成獨立應用程式。

  • 核心問題:dense alignment strategy 計算昂貴,亦會傳播 encoder 與 decoder 各自的錯誤
  • 核心方法:Selective Synergistic Learning 只蒸餾可靠線索,分開處理 boundary refinement 與 interior denoising
  • 結構補強:加入 transitive pseudo-label merging,減少 slot redundancy
  • 論文聲稱:可提升 decomposition quality,並對 slot configurations 有較強 robustness
  • 相關技術詞:VOCL、slot-based frameworks、Slot Attention、mutual-distillation、pseudo-labeling

整體來看,SSync 的價值不在於另起爐灶,而是在既有 slot-based video learning 範式上,直接指出 dense patch alignment 的兩個痛點:錯誤傳播與計算擴張。對研究型讀者而言,這比單純再堆模型容量更有意思;對工程導向團隊而言,它也提供了一個較容易插入現有項目的改良方向。
GitHub: https://github.com/wjun0830/SSync

項目:https://wjun0830.github.io/SSync/

Categories: 開源, 模型, 視覺模型, Video, 框架, IDE, Python, 編程, 深度學習

MultiLCB:即時追蹤程式模型表現

一個聚焦多語言編程能力的公開評測平台,可比較不同模型在時間變化下的表現。

codeLogo

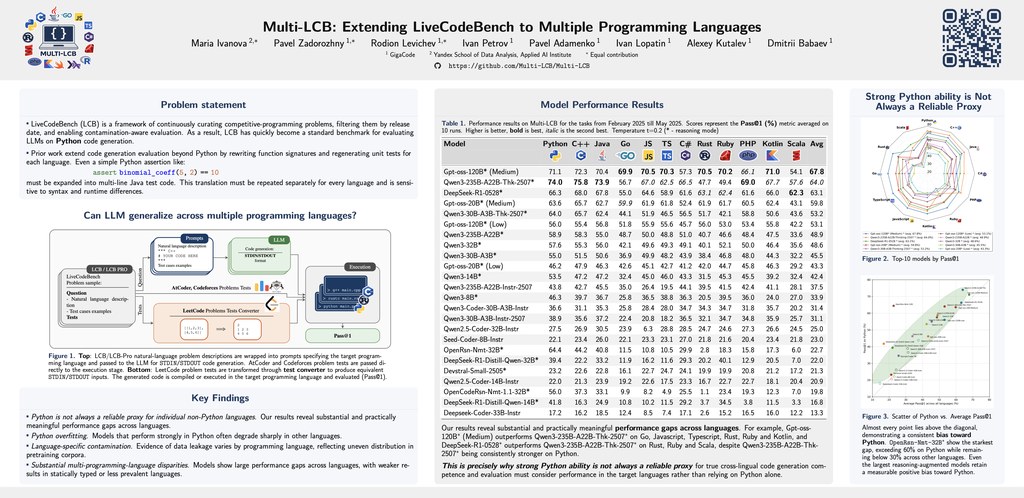
MultiLCB(Multi Live Code Bench)是一個公開的編程模型評測項目,重點是用動態榜單和比較工具,觀察不同模型在多種程式語言上的表現。網站提供 Main Leaderboard、Model Comparison,以及按月份查看 pass@1 變化,適合想快速了解模型編碼能力的人。

這個項目處理的問題很明確:不少編程模型成績只停留在單次發布,難以看出時間變化、語言差異和推理設定的影響。MultiLCB 把資料整理成可篩選的介面,支援語言、難度、平台,以及是否使用 CoT(Chain-of-Thought)等條件,方便直接比較。

使用時,讀者可先在 Leaderboard 選擇日期範圍,再按 Python、JavaScript、TypeScript、Java、C++、C#、Go、Rust、Ruby、PHP、Kotlin、Scala 等語言篩選。若想深入看兩個或多個模型差距,可打開 Compare 頁面,用 pass@1 與平均分數交叉檢視,也可留意每月走勢圖。

  • 支援 LCB、LCB-PRO、LCB-PRO-AGENTIC 多種基準
  • 可按語言、難度、平台、CoT 條件篩選
  • 以 pass@1 為核心指標,方便直觀比較
  • 提供月份變化圖,較易看出模型進步或波動

這類項目特別適合模型研究者、AI 工程師、技術媒體,以及需要挑選 coding model 的團隊。從頁面可見,它偏向基準測試與橫向比較工具;至於數據來源、題目構成和完整評測方法,仍要配合站內 Code、Hf、Submit 或相關說明頁面再作確認。

項目: https://multi-lcb.github.io/

Categories: 開源, Agentic, 模型, Vibe Coding, 工具, Python NLP, Python, 編程

Kimi-K2.7-Code:面向編碼的開源模型

Kimi-K2.7-Code 已登上 Hugging Face,聚焦程式生成與對話格式處理。本文整理它的定位、用途與可留意之處。

Og image

Kimi-K2.7-Code 是 moonshotai 發佈在 Hugging Face 的開源模型,從頁面可見它與程式碼生成、訊息格式化及工具調用相關內容有密切關係。公開資訊顯示,這個項目已可透過部分推理服務直接調用,亦有一定下載量,反映社群關注度不低。

對一般開發者來說,這個項目最直接的用途,是用來處理編碼助理、對話模板、函式呼叫與多角色訊息編排等工作。頁面展示的內容包括 macro、message role、tool_calls 及 generation prompt 等結構,代表它並非只回答文字,也重視代理式互動流程中的輸入輸出格式。

如果你想試用,基本可從 Hugging Face 模型頁開始,查看可用的 Inference Providers,或在支援的平台以 API 方式接入。使用時要留意,當前頁面可見資料較多集中在模板與訊息渲染片段,對模型規模、基準測試與訓練細節的說明仍然有限,因此較適合先做功能驗證,再決定是否納入正式流程。

  • 定位偏向編碼與結構化對話處理
  • 支援 tool_calls、role 標記等代理式互動元素
  • 已上架 Hugging Face,並有推理服務可選
  • 公開頁面暫未見完整性能評測與訓練說明

這個項目較適合開發 AI 編碼助手、聊天工具、Agentic workflow,或想研究模型提示模板的人。若你重視開源、可自行部署,以及需要處理函式調用格式,Kimi-K2.7-Code 會是一個值得觀察的選擇;若要比較模型能力,則仍需配合更多公開測試結果。

項目: https://huggingface.co/moonshotai/Kimi-K2.7-Code

Categories: 開源, 模型, 編程

LoopCoder:只多跑一輪,成效反而更好

LoopCoder-v2 研究 PLT 在測試階段的迴圈次數選擇,顯示兩輪往往比三輪以上更穩定。對寫程式、工具呼叫和代理式任務,這個項目提供了更實際的取捨參考。

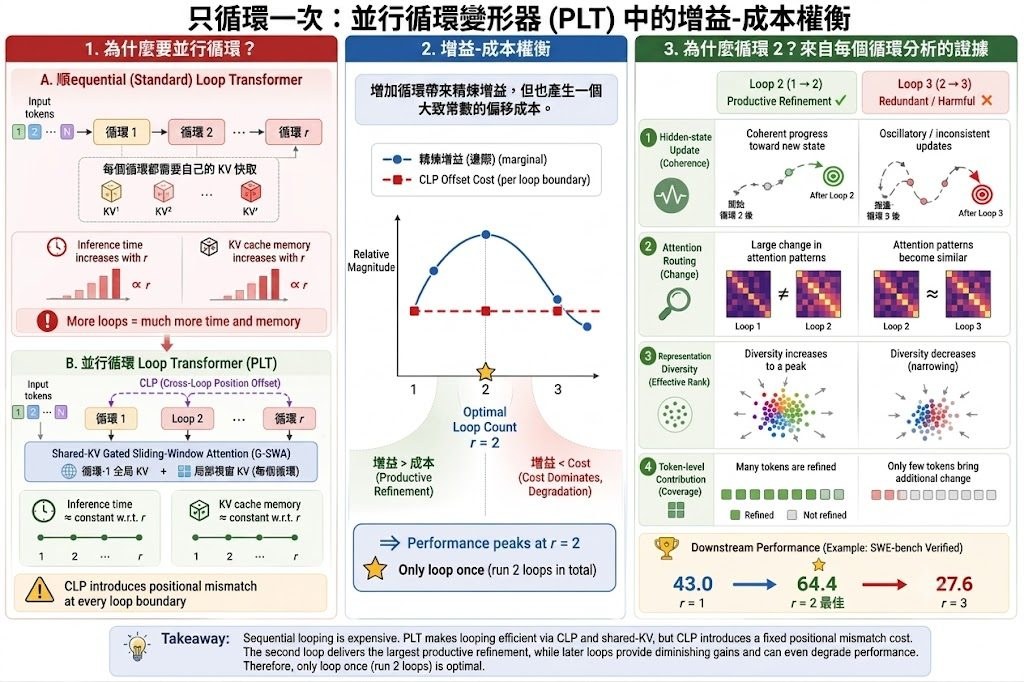
Only Loop Once: gain–cost trade-off in Parallel Loop Transformers

LoopCoder-v2 是一個基於 Parallel Loop Transformers(PLT)的程式碼模型系列,目標是解決「推理步數愈多,成本與表現未必同步上升」的問題。傳統 Looped Transformers 會透過重複共享區塊去增加 latent computation,但每多一輪都會拉高延遲和 KV-cache 記憶體;PLT 則用 Cross-Loop Position Offsets(CLP)和 Shared-KV Gated Sliding-Window Attention(G-SWA)把成本壓低,讓迴圈數變成可以調整的設計參數。

這個項目直接拆解「多跑幾輪到底值不值得」。作者用 gain–cost 角度分析 loop count:額外一輪可以帶來表示更新,但 CLP 也會引入位置不匹配的成本;兩邊一對比,就能解釋為何 LoopCoder-v2 在很多情況下是兩輪最好,而不是愈多愈好。這種分析方式比單看分數更有參考價值,因為它把效果升降和內部機制連在一起。

從結果看,LoopCoder-v2 的 7B 版本在多個程式相關測試都有明顯改善,尤其是 SWE-bench Verified 由 43.0 升到 64.4,Multi-SWE 由 14.0 升到 31.0,Terminal-Bench 亦有提升。相反,三輪或四輪時分數明顯回落,表示這個項目不是單純靠「加更多計算」換表現,而是存在一個較清晰的最佳點。作者亦用 hidden-state dynamics、attention evolution 和 output distribution shift 去佐證第二輪帶來主要增益,之後的輪次多數只會增加冗餘。

如果你想找的是可直接跑的模型,這個項目提供了 Hugging Face 上的 7B 權重,能透過 Transformers 載入後做文本生成或程式碼任務測試。適合關注 code generation、code reasoning、agentic software engineering、tool-use 的人,也適合想研究 test-time compute scaling、模型推理效率,或想比較 loop count 對表現影響的讀者。

  • 主要類型是模型研究項目,同時包含評測與推理分析
  • 核心結論是:兩輪通常是最佳平衡點,三輪以上可能反而拖低表現
  • CLP 令平行迴圈可行,G-SWA 則把 KV-cache 成本維持在近乎固定水平
  • 7B 版本在 SWE-bench Verified、Multi-SWE、Terminal-Bench、BFCL 等測試都有較完整結果
  • 適合用來分析程式碼模型、代理式任務,以及測試階段算力分配

GitHub: https://github.com/CSJianYang/LoopCoder

Paper: https://arxiv.org/pdf/2606.18023

Categories: 開源, Agentic, AI productions, RAG, 模型, 框架, 軟件, 工具, Python, 編程

VisualClaw:會進化的視覺代理

VisualClaw 不只是接駁模型的工具,還把記憶、技能與影片處理串成可持續改良的代理系統。

VisualClaw icon

現時不少 vision-language agents 主要靠固定提示、整段影片送入模型,或者一次性工具調用去完成任務;作者認為這種 fixed scaffold 容易令延遲、成本同提示長度一齊上升,而且部署後幾乎唔會自己累積經驗。VisualClaw 因而提出一個 modular multimodal agent system,夾在 Claude Code、Codex、OpenClaw 同上游 LLM providers 之間,加入 retrieved memory、skill bank、self-evolution、video processing 同 evaluation hooks。

這個項目屬於框架兼工具型基建,重點唔係再訓練一個新模型,而係幫 Computer-use agents、tool-using vision-language agents 更有效處理影片、工作空間同多輪任務。配套的 VisualClawArena 則是獨立 benchmark/data release,收錄 200 個 scenario,要求代理真正在 workspace 內用影片證據、文件、動態更新與 executable checks 解題,補回一般 video-QA benchmark 對工具使用情境測試不足的缺口。

把它當成 gateway proxy,用熟悉的 OpenAI 或 Anthropic 相容介面接到現有 agent workflow,再逐步打開 skills、memory、video cascade 等模組。對已經在用 Claude Code 或 Codex 的團隊,這種接法尤其實用,因為毋須由零重寫整個代理流程。

  • 核心結構清楚:gateway design 加上 pre/post hooks,方便在提示前後插入技能、記憶與評測。
  • 創新位具體:以 hybrid encoding 處理 streaming video,配合 cascaded gate、keyframe context、hot/cold top-k injection,目標是壓低成本而保留關鍵視覺證據。
  • 會累積經驗:self-evolution 會根據失敗回合與成功記憶更新 skill bank,唔係每次都由同一套靜態提示開始。
  • 評測唔只看答對:VisualClawArena 把多輪問題、影片、workspace 操作同評估輸出綁埋一齊,更接近真實代理任務。

在 4 個 video-QA benchmarks、2 個 VLMs(Gemini 3 Flash、GPT-5.2)上,VisualClaw 對 full-frame upload 的每題 API 成本平均可減 98%,相對 offline uniform 8 frame baseline 亦再降 25.9%,同時多數設定下準確率有提升。到 VisualClawArena,配合 Codex(GPT-5.5)與 Claude Code(Sonnet 4.6)等 backend,macro accuracy 分別提升 2.9% 同 3.2%;如果你關心的是可插拔代理基建、多模態工作流,或者想為 live vision 與影片任務加上可持續進化能力,這個項目比單純模型包裝器更有研究同落地價值。

GitHub: https://github.com/UCSC-VLAA/VisualClaw

項目: https://ucsc-vlaa.github.io/VisualClaw/

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, OpenAI, Gemini, API, Video, 框架, Vibe Coding, 工具, IDE, Mac, 編程, OpenClaw, Anthropic, Skill 技能

當 AI 程式助手遇上滿山數據:CoDA-Bench 想考甚麼?

中國人民大學團隊發表的 CoDA-Bench,把 AI 代理人丟進藏有數百檔案的 Linux 沙盒,測試牠們在真實數據密集場景下找檔案、寫代碼、做分析的綜合能力。

CoDA-Bench

現有針對 AI 程式代理(AI coding agents)的評測,大致分為兩類:一類專注於軟件工程任務(例如 SWE-Bench、Terminal-Bench),只考驗代碼本身;另一類專注於數據分析能力(例如 DS-1000、DA-Code、DataSciBench),卻把所需數據直接攤在桌面,等着代理去讀。中國人民大學數據實驗室團隊指出,這種把「代碼」與「數據」分開評估的範式,與真實開發場景脫節——現實中的工程師,往往要在堆滿雜亂檔案的環境中,自己摸索出哪些數據有用,再寫代碼處理它們。

為此他們提出 CoDA-Bench(Code and Data-intensive Benchmark),屬於 benchmark 類型的評測框架。它建構了一個基於 Kaggle 生態的 Linux 沙盒,每個任務環境平均包含約 980 個檔案,總共 1,009 道題目橫跨 31 個主題社區,要求代理先在語意相近的眾多檔案中大海撈針,再整合異質資料、撰寫分析代碼,產出最終答案。

團隊測試了多款頂尖代理後發現,即使表現最好的系統,成功率也只有 61.1%,暴露出現有模型在「數據發現」與「代碼執行」之間缺乏有效銜接。這個缺口正好為下一代研究指明方向:未來的代理不只要會寫代碼,更要懂得在雜亂的檔案系統中自行導航。

如果你從事 Agentic AI 研發、數據分析自動化,或想測試 LLM 在複雜環境中的推理與編程整合能力,這套開源 benchmark 提供了一個貼近現實的試金石。完整題目已釋出於 HuggingFace,評估則可透過 Docker 一鍵執行。

重點摘要:
修正舊範式:突破 SWE-Bench 與 DS-1000 把代碼與數據分開考的做法,統一在同一環境內評測。
真實規模沙盒:每題約 980 個檔案,模擬 Kaggle 上雜亂而龐大的真實數據環境。
雙重能力整合:同時考驗資料探索、檔案導航、跨格式整合與代碼生成四個面向。
成績慘淡:頂尖代理在完整題集上僅約 61.1% 成功率,顯示仍有明顯改進空間。
完整開源:包含 1,009 道題目、31 個社區數據(約 43 GB),以及 Docker 評測流程。

GitHub: https://github.com/ruc-datalab/CoDA-Bench

Paper: https://arxiv.org/pdf/2606.15300

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 框架, Vibe Coding, 軟件, Linux, 編程, 中國, Dataset 數據集

iMaC:把機械臂動作變成可預測影像

iMaC 不是只餵動作向量入模型,而是把未來動作轉成影像控制。這種 world model 更貼近機械臂與場景的空間互動。

overview

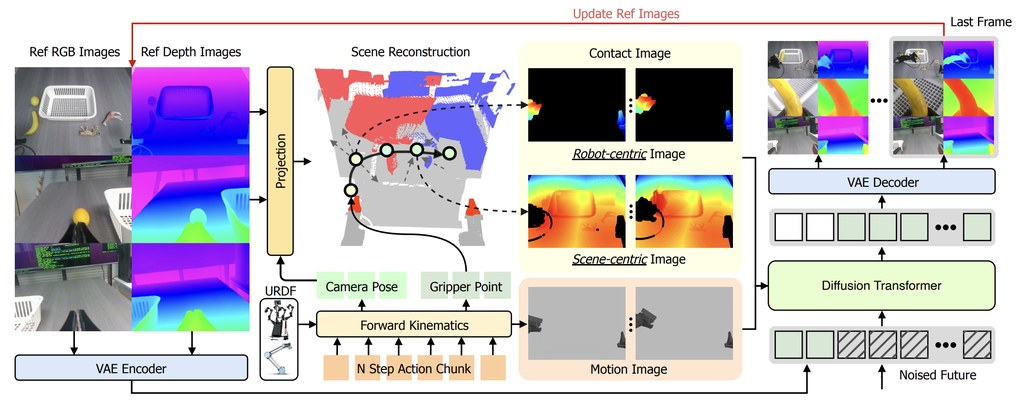
現時不少 action-conditioned video models 會把未來動作壓成 compact vectors,再經 learned conditioning modules 交給模型處理;作者認為這種做法要模型自行猜測細微空間後果,遇到 real manipulation 時,幾厘米差距已足以改變接觸、物件移動與任務成敗。iMaC 屬於世界模型與影片生成模型,核心是把 future joint actions 轉成 image-like controls,減少「動作有輸入,但空間關係表達不足」的問題。

這個項目的方法相當具體:先利用 robot URDF 與 forward kinematics,渲染 future robot-observation control videos,也就是 motion images;之後再加入 depth 作為輔助訊號,配合 3D pointclouds 建立 two-stream geometry controls,也就是 contact images。舊範式主要靠抽象向量條件化,iMaC 則把「未來機械臂會出現在哪裡、如何接近場景」直接變成可見控制,這是它最清晰的技術分野。

GitHub 儲存庫提供 training、preprocessing 與 inference code,覆蓋 RND-mix stage-one、stage-two,以及 WorldArena 三條流程。想試這個項目的人,會先由資料前處理、depth 與 3D condition 建立開始,再跑 validation inference 看生成影片是否跟動作一致;若本身做 robotic policy evaluation,還可以接到 WorldArena 或 online RND evaluation 場景。

  • 把 actions 轉成 motion images 與 contact images,空間條件更明確
  • 用 depth encoding 和 3D pointclouds 強化 robot-scene 幾何理解
  • 加入 training-time rollout strategy,目標是支援更長時序生成並減少 exposure bias
  • 儲存庫同時涵蓋訓練、前處理、推論,不只是論文展示模型
  • 相關組件包括 Wan transformer variants、Diffusion inference pipelines、RobotWin 2.0、WorldArena

性能方面,論文指出它在八個長時序真實機械人操作任務中,world-model success estimates 與真實 policy performance 呈強正相關。這個結果的價值不在於取代真機測試,而是在正式落機前,先用生成式 world model 篩選 policy checkpoints;對研究 embodied evaluation、robotics 與世界模型的人來說,iMaC 屬於相當值得跟進的一個方向。

GitHub: https://github.com/imac-wm/iMac

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, 清華大學, AI productions, 模型, 視頻模型, 世界模型, 模型訓練, Stable Diffusion, Video, Image, Robotic, Vibe Coding, Mac, 3D, , 編程, Win

LWS:聽寫說三通道:語音模型也能即時寫出程式碼?

LWS 讓語音模型在說話的同時持續書寫文字,保留編寫程式與結構化分析等文字能力,重新定義即時語音互動的輸出形式。

Listen-Write-Speak tri-channel legend

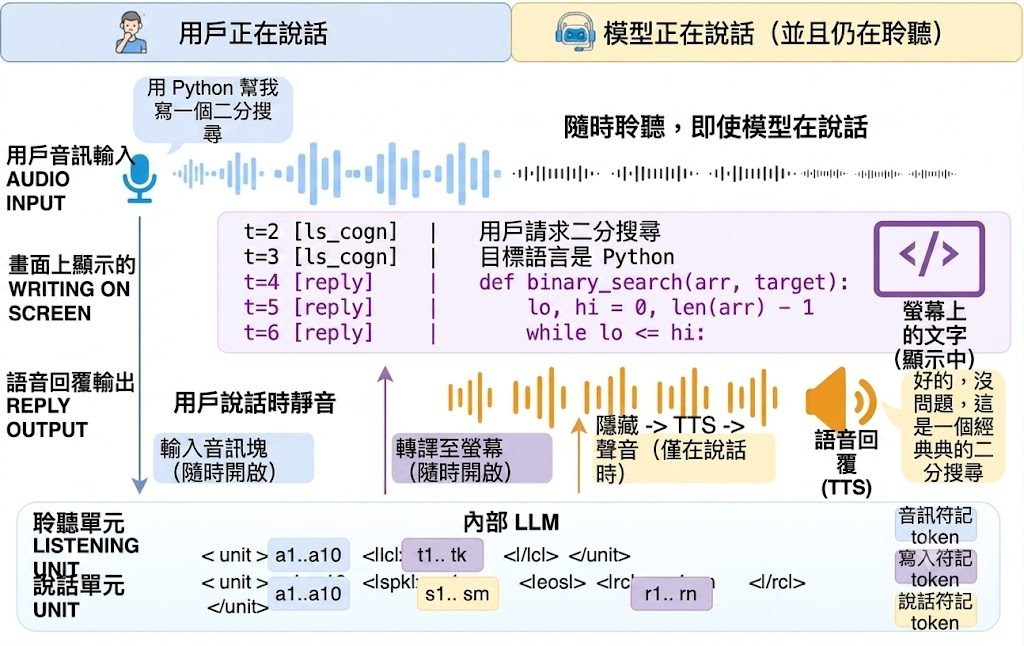
一般語音大型語言模型只能說出口頭回應,許多文字擅長的工作(例如編寫程式、條列分析、逐步推理)在即時對話中往往被犧牲。Listen-Write-Speak(LWS)正是針對這個瓶頸而設計,它讓單一自回歸大型語言模型同時處理三個通道:持續聆聽使用者音訊、即時生成可見的文字、並行輸出語音回應,三者共享同一個因果注意力脈絡。

這是模型、框架,還是什麼? LWS 是一個完整的語音模型項目,包含推理服務、Triplex/LWS runtime、前端展示以及測試,並非單純的網頁展示殼層。它建基於 OpenBMB 的 MiniCPM-o-4_5,再透過 Token Schema 機制在不改動模型架構的前提下,把文字輸出提升為第一公民的通道。

創新之處在於打破了「文字只是隱藏中間狀態」的慣例:寫入螢幕的內容不再只是語音的草稿,而是可被檢視、可被複製、可被審核的正式輸出。這對於需要邊說邊整理思緒的場景特別有幫助,例如教學、編程輔助、會議摘要。

性能與評估方面,項目在 VoiceBench AlpacaEval 達到 4.72 分,書寫與語音一致性為 92.6%,並在 Full-Duplex-Bench 與多語言 URO-Bench 都有穩定表現,顯示三通道並行並未犧牲即時反應。

適合的對象包括研究語音介面的開發者、需要可審核對話紀錄的團隊,以及對全雙工(full-duplex)互動有興趣的 AI 工程師。如想測試,可透過 ModelScope 下載基座模型 OpenBMB/MiniCPM-o-4_5 與 LWS 資產後運行推理服務與前端展示。

重點摘要

  • 三通道並行:聆聽、可見書寫、語音輸出共享一個因果注意力脈絡
  • 文字優先:寫入內容是第一公民輸出,不再是隱藏草稿
  • 無需改架構:透過 Token Schema 在標準自回歸 LLM 上實現
  • 完整開源 runtime:包含推理服務、runtime 與前端,非單純展示
  • 多項基準驗證:在 Full-Duplex-Bench、VoiceBench、URO-Bench 均有報告數據

GitHub: https://github.com/zly-idleness/lws_demo

項目: https://royalzhang.com/project/lws-page/

Categories: 開源, 編程, 語音

SWE-Explore-Bench:拆解編碼代理如何理解你的程式碼

這個基準將編碼代理的探索能力獨立評分,以 848 個真實議題為基礎,衡量代理能否在動手修改前找對行級上下文。

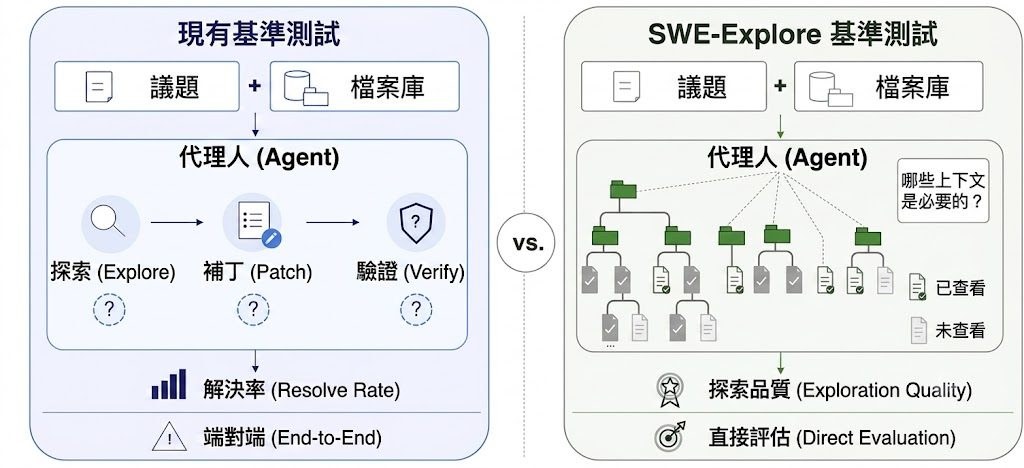
SWE-Explore evaluates repository exploration directly instead of only end-to-end repair.

SWE-Explore-Bench 由上海交通大學、香港中文大學等團隊推出,專門考核編碼代理在「真正落筆修改前」探索程式碼庫的表現。現有的 SWE-bench 等基準只給出最終通過與否的二元結果,難以分辨代理是因為找對位置而成功,還是碰巧蒙對。這個項目把探索這一步抽離出來單獨計分,更貼近診斷代理能力的本質。

具體做法是收集同一議題的多條成功修復軌跡,從中抽取代理實際讀取的程式碼行範圍,整合出共識的核心上下文,再保留部分模型獨有的可選上下文。代理需要輸出一份按行範圍排序的程式碼區域清單,評分涵蓋覆蓋率、排序品質、上下文效率,以及下游受限修補驗證四個維度。這種行級監督比傳統的檔案級定位更細緻,能揭示代理的真正瓶頸。

資料集涵蓋 10 種程式語言、203 個開源項目中的 848 個議題,並提供 OpenAI 相容的端點,方便接駁不同 LLM 進行行範圍精修。實測結果顯示,具備代理能力的探索器明顯領先傳統檢索器,現代方法在檔案層級已相當成熟,但行級覆蓋與高效排序仍是區分頂尖方案的分水嶺。

適合關注 SWE-agent、AutoCodeRover、OpenHands 等代理框架的研究者、開發者及基準設計者使用。對想了解自家代理「讀碼環節」強弱的團隊而言,這是一個值得放入評測管線的參考項目。

GitHub: https://github.com/Qiushao-E/SWE-Explore-Bench

Paper: https://arxiv.org/pdf/2606.07297

Categories: 開源, 香港中文大學, 框架, 編程

Anime.js 4 網頁特效的萬用引擎

想為網站加動感,但又唔想在 CSS、SVG 同互動事件之間來回拆件,Anime.js 4 提供咗一套幾完整嘅 JavaScript 動畫工作流。

Anime.js V4 logo animation

做網頁動效最麻煩嘅位,往往唔係寫出第一個 fade 或 rotate,而係當畫面同時牽涉 CSS transforms、SVG 路徑、滾動觸發同拖曳互動時,邏輯會好快分散。Anime.js 屬於 JavaScript 動畫庫,重點係用同一套 API 處理 CSS properties、SVG、DOM attributes 同 JavaScript Objects,令介面動畫、資料視覺化同品牌展示頁可以用較一致嘅方式編排。

相比只覆蓋單一動畫層的做法,Anime.js 4 的價值在於它唔止負責補間效果,仲連 timeline、stagger、Scroll Observer、SVG utilities 同 Draggable 都放入同一個工具箱。代價亦清楚:它比較適合本身已經用 JavaScript 控制互動節奏的前端項目,若果只需要極簡 hover 或過場,直接用 CSS 或 WAAPI 可能更輕。

Anime.js 通常會經 npm 納入前端項目,再按需要引入 animatecreateTimelinecreateDraggable 等模組;官方亦強調可按功能分開載入,方便控制 bundle size。由文件與首頁示例可見,最值得試的是把單一元素動畫、滾動同步、SVG 路徑跟隨與拖曳回彈放入同一頁,看看整體編排是否比你現有寫法更順手。

  • 同一套 API 覆蓋 CSS、SVG、DOM attributes 同 JavaScript Objects
  • 內建 Timeline、Stagger、Scroll Observer、Draggable,適合多步驟互動頁面
  • 支援 modular import,有助控制前端打包體積
  • 強項在複合型動效編排,不是追求最少抽象的微型工具

Anime.js 主打 fast、lightweight,同時保留足夠完整的動畫編排能力。對需要經常做行銷頁、產品展示、資料互動介面或設計系統微動效的團隊來說,Anime.js 吸引力不在單一特效,而在於它把原本容易四散的動畫控制集中成一條可維護的工作流。

項目主頁 · GitHub

Categories: 開源, API, , 編程, UI/UX

Page 5 of 11
1 3 4 5 6 7 11