OpenCode V2:程式碼探索與修改兩種模式

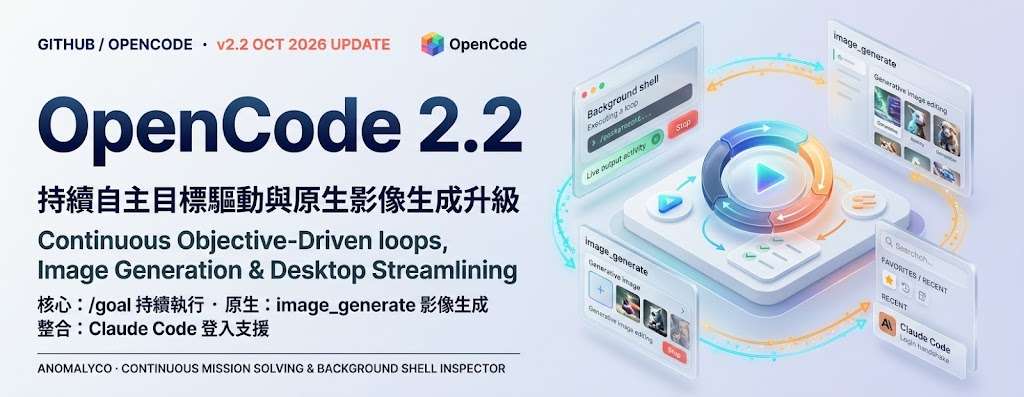
新功能加入 /goal,能持續目標驅動循環(自主執行直至目標完成)。接手陌生程式碼時,OpenCode 會先協助分析,再切換至開發模式;但模型配置與硬件門檻仍未交代。

OpenCode logo

V2 連續 3 日更新!OpenCode 能在接手陌生程式碼時,先讓 OpenCode 分析結構及規劃修改,再交由開發模式處理。這個開源 AI 編程代理工具以不同權限配合工作階段,並非獨立模型。

很多時,開發技術差異在於代理模式:預設 build 具完整存取權,負責開發;plan 則以唯讀方式探索程式碼,執行 bash 指令前會要求批准。兩者是操作模式,不是兩款模型。

  • build 適合需要修改程式碼的開發工作。
  • plan 適合熟悉陌生儲存庫及規劃變更。
  • 可透過 npm、Homebrew 等套件管理器安裝。
  • 另有桌面應用程式測試版,可於 opencode.ai/download 下載。

需要先審視再修改程式碼的開發者,可考慮這套分工方式;選用前仍須確認模型配置與運算需求。安裝前亦應移除早於 0.1.x 的版本。

GitHub

Categories: 開源, 模型, 工具, 庫, 編程

oMLX:高效能推論伺服器

當搭配如 Claude Code、OpenClaw、Hermes Agent 這類每輪都發送巨大 Context / Tool Transcript 的 Coding Agent 時,oMLX 能直接命中快取,大幅縮短每輪等待時間。

oMLX

在 Mac 跑編程助手,oMLX 可讓常用模型常駐記憶體,並從選單列管理服務。能使用 Mac 原生 MLX 的吞吐與批次處理。

它以連續批次處理(Continuous batching)配合分層鍵值快取(Key-Value cache,KV cache):常用區塊留在記憶體,冷資料以 safetensors 格式存入固態硬碟(SSD)。後續請求的前綴吻合便可重用,伺服器重啟後亦能恢復,但不代表任意改寫上下文都能免除重算。

  • 可設定上下文長度限制。
  • 記憶體不足時,按最近最少使用(Least Recently Used,LRU)策略移出模型。
  • 管理介面支援手動載入及卸載模型。

硬件需 Apple Silicon Mac,並為模型及快取預留記憶體與 SSD 空間;來源未列最低容量、模型清單或具體測速,不能據此保證大型模型的速度。

安裝可從 Releases 下載 .dmg,拖入 Applications,並支援程式內更新。需要反覆處理相同上下文的編程工作較能受惠;SSD 快取節省重算,卻不能取代模型推理所需的記憶體。

GitHub

Categories: 開源, 模型, 工具, Mac, 編程, Anthropic, 蘋果

magpie:通過本機閘道,把不同 AI 編程代接上同一模型

Claude Code、Codex、Gemini CLI 等代理可以各自改用其他模型或訂閱帳戶;配額用完時,Magpie 亦可按設定切換帳戶或路由到其他服務。

magpie

想讓 Claude Code 用 Kimi、Codex 用 DeepSeek,或者讓 OpenCode 使用 ChatGPT 訂閱模型,不必逐個代理手動改一堆設定。Magpie 是一款跨平台工具,透過本機閘道統一管理模型與供應商,並從選單列切換代理設定;它改動的是各代理自己的關鍵設定,並非把不同代理合併成同一個程式。

它支援 API key、本機模型,以及 Claude、ChatGPT、Copilot、Gemini、Grok 等已登入帳戶。Claude 整合會呼叫本機的 Claude CLI,並透過 MCP(Model Context Protocol)橋接代理工具;ChatGPT 訂閱模型則可供其他代理使用。這讓使用者能沿用熟悉的代理工作流程,同時更換背後的模型來源。

配額耗盡時,Magpie 可改用同一供應商的另一個帳戶;若設定了路由群組,也可轉往其他模型或供應商。沒有備用帳戶或路由群組時,錯誤仍會傳回代理,因此不中斷並非無條件保證。隱私遮罩則須在設定中手動開啟,啟用後會在請求離開本機前遮蔽提示中的金鑰、密碼和電郵地址,再把內容還原到回覆。

  • 從同一份清單為不同代理選擇模型,減少逐個修改設定的工作。
  • 可混用雲端 API、本機模型和已登入的訂閱帳戶。
  • 帳戶或路由備援可降低配額用盡造成的中斷,但須先配置可用的後備路徑。
  • 隱私遮罩預設關閉,敏感資料保護需自行啟用。

對同時使用多個 AI 編程代理、需要管理不同供應商帳戶的個人或團隊,Magpie 可集中處理切換與備援;若只用單一帳戶,或不希望工具改寫代理設定,收益會較有限。項目支援 macOS、Windows、Linux、Docker 和 Termux;提供下載與文件,但所給資料未列出效能測試或延遲數據,選用前宜確認所需代理、模型與登入方式均在支援範圍內。

GitHub

Categories: 開源, MCP, 模型, 微軟, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Linux, 編程, Anthropic, Kimi, MiniMax

video-shotcraft:用一張產品圖製作可編輯的宣傳片

video-shotcraft 將 Claude Code 或 Codex 接到影片製作流程,以 Remotion 排版真實產品截圖,交付可編輯 MP4。

video-shotcraft logo

只要向 Claude Code 或 Codex 提出「替產品製作宣傳片」,video-shotcraft 便會擷取產品真實頁面,選取鏡頭、編排故事線,再以 Remotion 動畫化。最終輸出 MP4、瀏覽器編輯器 Motion Workbench,以及剪映可編輯草稿,方便後續修改。它不是端到端影片生成模型,而是一套整合截圖、動態配方、節拍與音效的 agent skill。

  • 以真實截圖及文案作畫面素材,保留品牌外觀與文字清晰度
  • 提供 124 張 recipe cards,涵蓋 150 種鏡頭及預覽
  • 流程涵蓋 storyboard、Remotion 動畫、節拍同步、聲效及逐格檢查
  • 可交付 MP4、Motion Workbench 與剪映草稿

這種做法與文生影片模型的分別,在於每一幀都由程式碼繪製,而不是生成抽象影像;代價是成品取決於頁面素材、shot recipe 的覆蓋範圍及 Remotion 排版,創意空間主要來自鏡頭選擇和動態組合。36.2 秒的 ready template 可供快速改稿,但較長或講解密集的產品影片仍需要重新編排內容。

產品團隊、獨立開發者及需要反覆製作版本宣傳片的 marketing 部門,都可從「保留可編輯性」中受益。工程師可用現有網站截圖建立視覺稿,內容團隊亦可沿用剪映草稿調整節奏,省去由錄屏再逐段重做動畫的時間。

一行 “幫我安裝這個 skill:https://github.com/Vincentwei1021/video-shotcraft” 便完整安裝。適合希望將影片製作納入 coding agent 工作流、而非直接生成寫實片段的團隊。

項目主頁 · GitHub · 作品展示

Categories: 開源, Agentic, AI productions, Video, Image, Vibe Coding, 編程, Anthropic, 動畫, 聲效, Skill 技能

CLI-Anything 讓 AI 代理直接操控軟件

CLI-Anything 把圖像、CAD、3D 等軟件包裝成可供 AI 代理操作的 CLI,打通代理與既有工具之間的斷層。

icon

當 AI 代理需要製作 CAD、3D 場景、圖表、遊戲或字幕,CLI-Anything 會把原本面向人類操作的軟件轉成可調用的 CLI。它屬於開源的 Agentic 工具與 CLI 生成框架,處理的是代理缺乏一致介面、難以持續操作軟件及產出可驗證成果的問題。

項目以 /cli-anything 作為主要入口,並配合預覽、即時預覽及 trajectory loops,讓代理不只發出指令,還能逐步產生和檢查真實 artifact。README 亦列出 Cursor plugin、Hub 及 skills,反映它同時照顧 CLI 生成端和代理使用端;舊版本則可能要改用 /cli-anything:cli-anything。

和只依賴 GUI 操作或個別 API 整合的做法相比,CLI-Anything 嘗試為不同軟件建立較統一的代理介面,方便重用流程,但效果仍取決於每個軟件的 CLI harness 是否完整,以及代理能否正確理解工具狀態。項目提供 CLI-Hub,使用者可瀏覽、安裝及管理社群建立的 CLI;原始資料未交代各 harness 的詳細安裝步驟、資源要求或一致的性能基準。

CLI-Anything: Turn ANY App into a CLI for Claude Code & Codex (GIMP, Blender, LibreOffice & More!)

• 支援把多類軟件轉成 AI 代理可調用的 CLI
• 以預覽與 trajectory loops 協助產生可檢查的成果
• 提供 CLI-Hub 管理社群 CLI
• 適合需要串連設計、製作及自動化流程的團隊
• 仍需逐一確認各軟件 harness 的成熟度

對熟悉 Cursor 或其他代理工作流的開發者,這套方法適合用來延伸圖像處理、CAD、3D 製作及內容生產流程;對只想即時使用單一軟件的使用者,則要先確認所需 CLI 是否已建立及可用。

GitHub

Categories: 開源, 香港大學, Agentic, API, Image, World-Action Model, 框架, 軟件, 工具, IDE, 3D, 編程, Skill 技能

Kimi K3.1 Pro:開放權重 1M 上下文支援長鏈路代理

完整 model weights 預定於 11 月 4 日釋出。1M-token 上下文支援編程與長鏈路代理,Kimi K3.1 Pro 亦延伸至 3D 創作及金融研究。

Og image

面對超長文件、終端機任務和多步驟研究,Kimi K3.1 Pro 以 1M-token context window 支援長鏈路代理工作,並把 coding、3D creation 與 financial research 放進 3T-class open-weight model。它是 Kimi K3 的 post-trained 版本。

訓練加入更大 post-training compute,在數百個下游領域進行 joint reinforcement learning(joint RL);RL framework、long-context inference、sandbox infrastructure 及 rollout scheduling 亦一併優化,目標是令能力提升更穩定。

  • 長上下文:1M-token context window,適合長文件及多步驟工作。
  • 代理場景:涵蓋 coding、3D creation 及 financial research。
  • 速度選項:Kimi K3.1 Pro Highspeed 標稱快 2 至 3 倍。
  • 權重安排:完整 model weights 預定於 11 月 4 日釋出。

Terminal-Bench 4.0 以資源受限終端機任務和嚴格測試評估 coding agents;K3.1 Pro 得分 65.7%,高於 GPT-6 Astra 的 58.2%,接近 Claude Opus 5.5 的 66.4%,可作為編程代理場景的參考。

模型可於 Kimi Work、Kimi Code 及 Kimi API 使用。

項目主頁

Categories: Agentic, 模型, 模型訓練, API, Image, 框架, Vibe Coding, 3D, Python, 編程, Anthropic, Kimi, 任何模型, 強化學習

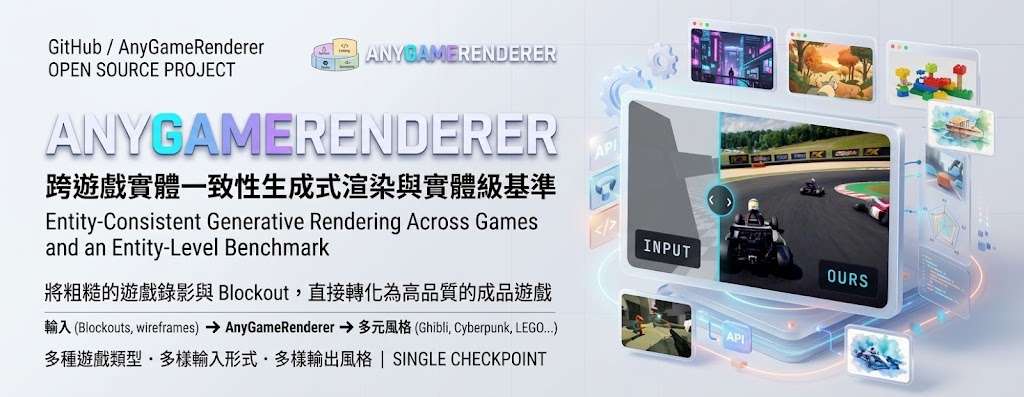
AnyGameRenderer 把粗糙遊戲錄影變成可玩風格畫面

由灰色方塊與代理色組成的遊戲錄影,配合文字提示即可重繪成不同風格,同時保留角色、物件數量與動作時間。

genre trenchfire

遊戲原型仍是灰色方塊、彩色幾何體,AnyGameRenderer 就能把一段 24 fps、2 至 15 秒的普通影片,重繪成 AAA 寫實、LEGO、Ghibli、蠟筆或 synthwave 等風格。它屬於生成式影片模型,處理的是「畫面變漂亮後,角色位置、數量和出現時間仍要對得上」的問題。

輸入不需要逐物件標籤、引擎掛鈎或固定遊戲引擎格式,wireframe、semantic map、粗略 3D mockup、彩色 primitive 和 engine whitebox 都可作為來源。單一 checkpoint 已涵蓋 tower defense、kart racing、shooters、survivors-like 和回合制戰鬥等類型,適合 AI 遊戲生成工具、原型展示和美術風格探索。

  • 保留 entity correspondence,細小及遠距離物件較不容易消失
  • 文字提示可改變整體美術風格,同一段輸入可產生多種世界觀
  • 以 entity-level benchmark 評估,而非只看逐幀畫面相似度
  • LoRA 訓練尺寸為 1344×768、124 frames;更長影片可執行,但未按該長度訓練

59 個測試案例、753 個 ground-truth entities 中,temporal match 由 zero-shot base 的 50.9% 升至 62.9%,position match 由 57.1% 升至 61.9%;未渲染率由 4.1% 降至 2.9%,hallucination rate 由 52.1% 降至 46.0%。提升仍未代表每個物件都能穩定對齊,長片段和高密度場景仍需檢查輸出。

需要 Python 3.10、PyTorch 2.9.1+cu128 等環境資訊,以及 setup_env.sh 和權重下載流程;完整執行仍需要相應 GPU 環境。項目同時公開模型與資料集連結,較適合希望把可玩原型快速轉成視覺樣片的開發者和研究團隊。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Video, 工具, 3D, Python, 編程, Dataset 數據集, LoRA

Agent4Sci 把 AI 編程代理放進真實科學實驗場

AI 編程代理能否在有限算力、沒有人工協助的情況下,超越論文已發表的最佳結果?Agent4Sci 讓代理在真實機器學習科研任務中接受長時間測試,並檢查成果是否可信。

protocol

面對一篇研究論文、程式碼、訓練資料和指定指標,AI 編程代理能否在固定算力內推進結果?Agent4Sci 是一個長時間測試與評估工具,涵蓋 11 個科學領域的 20 個基準和 25 項任務,檢視前沿代理在沒有人工協助下能否超越已發表的最佳表現。

它不以排行榜為目標,而是讓代理在標準化環境中修改程式、執行實驗和提交成果。每項任務會先核對已發表的基準結果、修整資料切分,並封存測試集;代理只能查看訓練及驗證資料,避免直接利用測試答案調整結果。

評估分成三步:代理進行實驗並提交成果,另一個代理在封存的測試集上評分,第三個代理則審查過程有否選擇性呈報、測試資料污染、操弄指標或硬編碼輸出。這種分工有助分辨模型進步是否來自有效研究,而非鑽評測漏洞;但長時間實驗本身結果波動較大,作者也提醒應把結果視為研究能力的探測,而不是穩定排名。

  • 覆蓋 20 個基準、25 項任務及 11 個科學領域。
  • 以固定運算預算測量代理相對於已發表最佳結果的進步幅度。
  • 測試集封存,並由獨立階段評分及審查評測操弄風險。
  • 提供 research、experiment 和 checklist 工作流程,分別支援文獻引導構思、實驗安排及定期檢查研究方向。

研究團隊、AI 代理開發者及機器學習科研團隊,可用它檢查代理能否在真實程式碼和資料條件下完成持續實驗,而不只是產生看似合理的修改。儲存庫提供 agent4sci run 執行評估流程,另有後端與自建基準容器的說明;提供的資料未列出完整安裝及模型預設細節,因此無法據此判斷所需 API、算力配置或具體執行時間。

GitHub

Categories: 開源, Agentic, 模型, 模型訓練, API, 工具, 庫, 編程

Hy Memory 共享不同 Agent 的記憶

Hy Memory 的模型、框架、應用三層全開源。將聊天脈絡、工作進度與代碼修改原因分開管理,再讓不同 AI 工具共享同一份記憶。
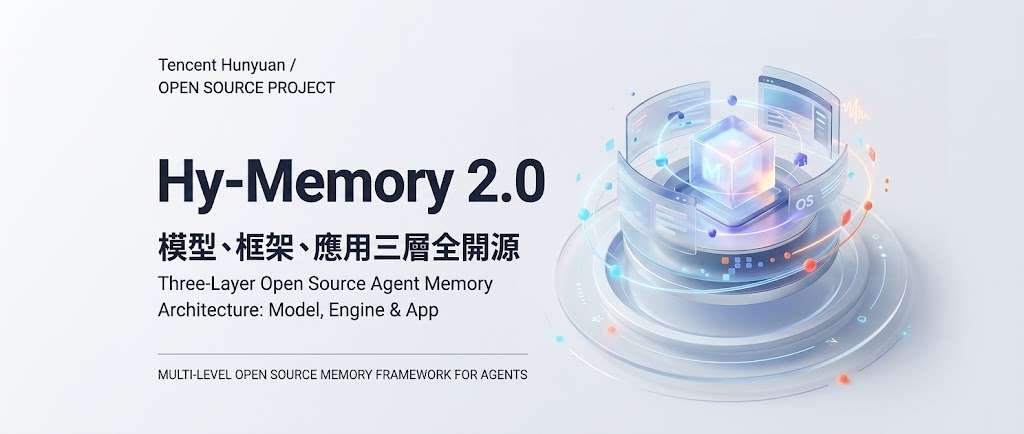
Tencent Hunyuan

當 AI 需要記住的不只是單句事實,還包括事情是如何發展、任務做到哪一步,以及代碼為何這樣修改,Hy Memory 便提供了一套較完整的處理方式。它屬於面向 LLM agents 的認知記憶引擎與 Python SDK,將 Chat、Working、Coding 三類場景分開處理,減少長對話和長期任務中召回錯誤脈絡的問題。

Chat 以分層長期記憶整理事件及後續發展;Working 同時保存任務事實與可重用經驗,重用前會檢查適用條件;Coding 則以版本演化鏈追蹤每次改動,將相關指令、真實 diff 和指定函式區塊連結起來。這比單純把內容切段後交給向量搜尋更適合需要延續工作的 Agent,但也依賴清晰的 user id、workspace id 和代碼變更來源。

• 自動按工具呼叫及搜尋模式分流到三類記憶
• 支援記憶的新增、更新、刪除、列出及 System 2 演化
• Coding 可讀取本地 Git diff,亦可處理 path、old、new 替換記錄
• MemHub 將 Claude Code、Cursor、Codex、OpenCode 和 Qwen Code 等工具的資料集中管理

評測涵蓋四套 benchmark:LoCoMo 聊天記憶準確率為 72.6%,MemoryArena 工作記憶平均分為 55.31%,CodeMemoryBench 的問答及解決率為 64.2% 和 35.6%,SWE-ContextBench 解決率為 28.3%。官方亦指記憶儲存佔用維持在較低水平,但不同任務和資料來源仍會影響結果。

透過 hy-memory SDK 接入,按場景寫入及搜尋;不指定場景時,無工具呼叫的寫入會直接進入 Chat,帶工具呼叫的內容才會分類。Hy-Memory-30B-A3B 是負責記憶讀寫的專用模型,約有 3B 激活參數,並可與引擎分開使用;MemHub 則提供 local-first 桌面及 CLI 產品,適合需要跨 AI 工具延續對話或編程工作的個人與團隊。

項目主頁 · GitHub · 模型
Categories: 開源, 騰訊, Agentic, 模型, API, 工具, IDE, Python, 編程, Dataset 數據集

fde-gym:評測由寫程式推進到交付整個系統

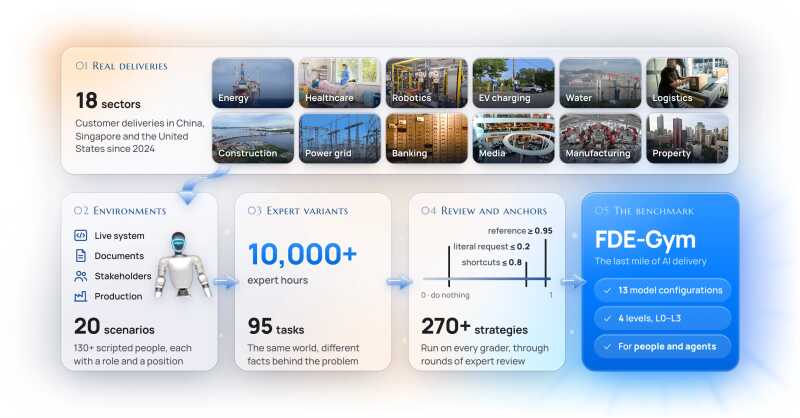
FDE Gym 把 AI 評測放入真實交付場景,檢驗代理能否在資訊不完整下令系統真正運作。

FDE Gym, the online judge for the LLM era: you need practice solving real problems

面對客戶只交來一段需求、現成系統、文件和幾位可詢問的人,AI 代理要處理的不只是寫程式。FDE Gym 屬於面向 coding agent 的端到端線上評測工具,將每個案例還原成 Forward Deployed Engineer(FDE)交付工作,最後按系統上線後面對的保留流量評分。

它刻意把需求澄清、未寫明的流程規則、人手介入時機和事故責任放入同一個工作流程。代理可以閱讀客戶交接資料、操作終端機、向相關人員提問,再交付可運行系統;評分不只看程式碼是否通過範例,而是看沒有預先展示的情境能否處理妥當。

• 20 個案例涵蓋端到端客戶交付情境
• 評測對象是 coding agent 及其交付的運行中系統
• 以 held-out traffic 檢驗未公開情境,而非只測固定輸入輸出
• 代理需要判斷哪些工作可自動化,哪些必須交由人員處理

相較經典 online judge 只提供完整題目、輸入輸出格式和樣例,FDE Gym 將模糊需求與現場決策納入評測,因此更接近企業採用 AI 代理時遇到的風險。不過,結果會同時受代理的提問策略、工具能力和交付系統質素影響,未必能單獨反映某個模型的程式編寫能力。

項目以 TypeScript 建成,提供網站工作台、案例管理及執行案例的機器;自建版本可配合 managed database 和 cloud object store,亦可新增案例及運行節點。案例資料另有 Hugging Face 資源,文件亦交代隔離範圍,適合研究團隊比較 coding agent、建立內部測試集,或讓負責 AI 產品交付的工程師測試代理能否處理上線後的未知情況。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 微軟, Vibe Coding, 工具, 編程, Dataset 數據集

Page 1 of 14
1 2 3 … 14