AgentDoG:輕量級 AI agent 安全護欄

AgentDoG 1.5 針對 AI agent 安全而設,主打輕量部署與即時監察。對要管理高風險自動化流程的團隊特別有參考價值。

AgentDoG Welcome

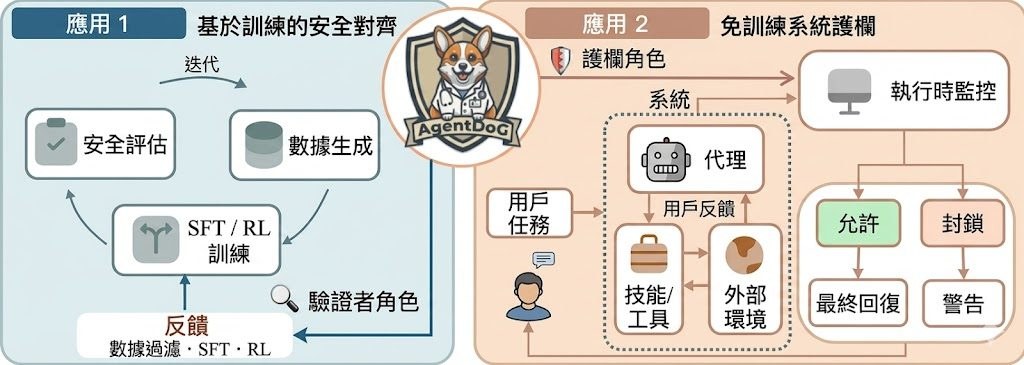
AgentDoG 1.5 是一個針對 AI agent 安全與對齊的項目,重點不只是事後評分,而是把風險診斷、訓練同線上護欄串連起來。它面對的是長流程規劃、工具調用,以及跨環境互動帶來的新風險,特別貼近 OpenClaw、Codex 這類 agent 場景。

使用這個項目時,可先到 Hugging Face 或 ModelScope 找出以 AgentDoG- 開頭的 checkpoints,再按自己要做的是安全分類、訓練還是線上監察去配合相應模型。對一般團隊來說,最容易理解的用途是把它當成部署前的安全檢查器,或部署中的即時守門員。

這個項目的核心進展,在於它用更新過的 agent safety taxonomy 配合 ATBench family,把安全問題拆成更細緻的風險類型,再用大約 1k 訓練樣本建立輕量版本。公開資料亦提到它提供 0.8B、2B、4B、8B 等型號,並支援 agentic SFT 與 RL 訓練流程,令成本和擴展性較易控制。

  • 支援 AgentDoG-0.8B、AgentDoG-2B、AgentDoG-4B、AgentDoG-8B 等版本
  • 針對 ATBench-Pro、AT-Codex、AT-Claw 等基準作安全診斷
  • 標準 8-core 機器可支援超過 10,000 個並行 agentic environments
  • 可作 training-free online guardrail,用於即時安全監察與介入

資料顯示,AgentDoG 1.5 在多個基準上可接近,甚至部分情況超過 GPT-5.4、Gemini-3-Flash、Qwen3.5-397B、Qwen3-235B、Qwen3-Guard 等模型;其中 AgentDoG-4B 與 AgentDoG-4B-U 的結果較突出。不過不同數據集差異明顯,較穩妥的看法是:它在 agent 安全這個窄而深的任務上很有競爭力。

這個項目較適合正在做 AI agent、工具調用工作流、企業自動化,或需要把安全檢查放進部署流程的團隊。若你關心的不是聊天效果,而是 agent 會否在複雜環境中做錯事、越權或造成真實風險,AgentDoG 的定位就相當清晰。
GitHub: https://github.com/AI45Lab/AgentDoG

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 編程, 安全, 中國

LiteCoder:輕量編程代理再推前一步

LiteCoder聚焦小中型 code agent 模型,連同模型、資料集與終端環境一併開放。對想研究 terminal agent 訓練流程的人,參考價值相當高。

image.png

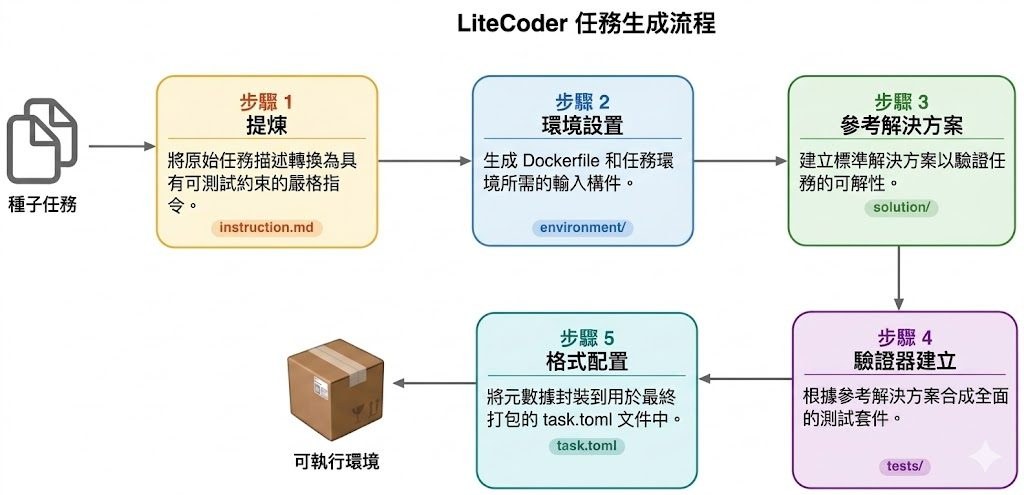
LiteCoder 是一個圍繞終端機代理訓練的項目,核心目標很清楚:讓小型和中型 code agent 模型,在 command-line 工作流中做得更好。它今次公開的不只是 LiteCoder-Terminal-SFT 模型與資料,還包括 11,255 條軌跡資料,以及 602 個附完整測試的 Harbor terminal environments,整體比單放模型更有研究價值。

一般 coding model 比較像「幫你寫 code」。
這個更像「幫你在 terminal 裡完成任務」,所以它的重點是行動能力,不是只會生成代碼片段 。

這個項目主要回應兩個常見難題:一是 terminal agent 訓練資料難找,二是很多任務描述無法直接驗證成效。LiteCoder 以可執行環境取代純文字題目,並把任務整理成可測試約束,令模型學到的不只是答題格式,而是多步驟操作、回饋修正與狀態轉換。

使用時可先從已公開的模型與 datasets 入手,再配合 GitHub 內的 code 檢視資料結構、環境生成方法與訓練脈絡。對研究者或工程團隊來說,這種「模型+資料+環境」一套齊的形式,方便重現結果,也方便延伸到 RL、偏好優化或自家 terminal 任務。

  • 已公開相關模型:LiteCoder-Terminal-30b-a3b-sft、LiteCoder-Terminal-4b-sft
  • 已公開相關資料:LiteCoder-Terminal-SFT、LiteCoder-Terminal-World-Model-SFT、LiteCoder-Terminal-RL-preview
  • 資料規模由不足 1k 擴大到 11,255 trajectories,涵蓋 10 個 domains
  • 訓練由 Terminus-only 擴展到 multi-scaffold,任務類別也加入 coding、scientific/numerical computing、games
  • 基準結果較前一版提升,並報告 Terminal Bench 1.0/2.0/Pro 與 pass@4

從論文附帶資訊看,Qwen-family models 經過 Supervised Fine-Tuning(SFT)後,表現明顯優於 base model;其中 32B 版本在 Terminal Bench 1.0、2.0、Pro 的 pass@1 分別達 29.06%、18.54%、34.00%。數字不算誇張,但對長步驟 terminal 任務來說已有參考意義。

這個項目特別適合想研究 Computer-use agents、CLI agent、合成環境生成,或想建立可驗證訓練流程的人。若你關心的不是聊天回覆,而是模型能否在終端機內逐步完成工作,LiteCoder 提供了一條相對完整而且可追蹤的路線。

GitHub: https://github.com/icip-cas/LiteCoder

Paper: https://arxiv.org/pdf/2605.29559

Categories: 開源, Agentic, 模型, 編程, 中國


gemma-chat:離線寫Code助手:Mac本機AI實測

這個專案把編程助手搬到 Mac 本機運行,主打離線、免 API key,同時兼顧即時預覽。

Gemma 4 Desktop

對於重視私隱,或者經常處於無網絡環境的人來說,這個專案最吸引的地方,是把 AI 編程助手完全放到 Mac 本機執行。它屬於 Electron 應用程式,透過 Apple 的 MLX 框架在 Apple Silicon 裝置上運行,首次下載模型後,就算冇 Wi-Fi 亦可繼續使用。

實際使用上,你只要用自然語言描述想做的內容,例如簡單網頁、計算機介面或多檔案小專案,系統就會在沙盒工作區內自動產生程式碼,並提供即時預覽。這種邊生成、邊查看效果的方式,對非專業開發者特別友善,因為可以直接用畫面理解改動。

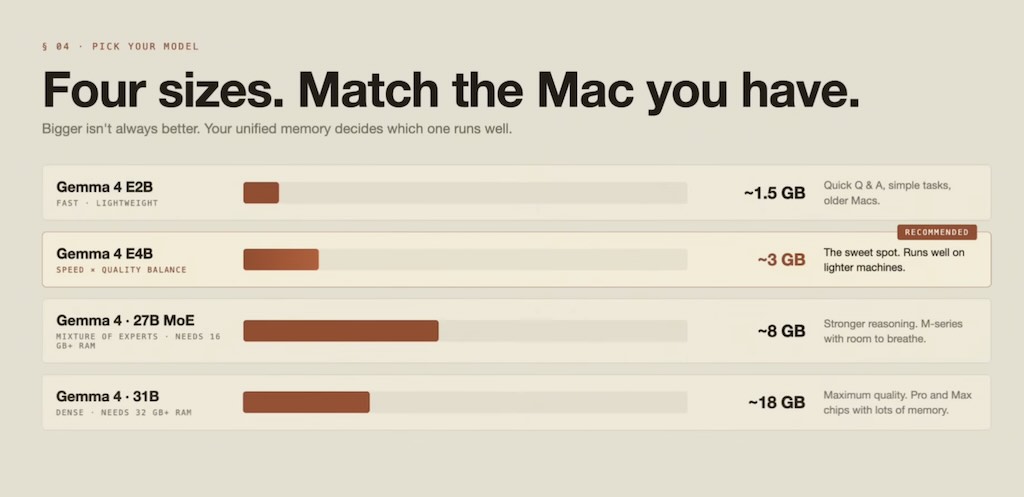
它的創新不只在「本地化」,而是在本機環境中同時整合了聊天、工具使用與建構模式。除了可作一般對話,還支援語音輸入,以及在不同 Gemma 4 變體之間切換;如果你需要更平衡的速度與能力,README 明確推薦 Gemma 4 E4B,而較大型版本則對記憶體要求更高。

Gemma 4 Desktop Coder by Google: 100% Free & Local, Build Apps OFFLINE on Your Mac
  • 全程本機運行,不需 API key,也不用把程式碼送上雲端
  • Build Mode 可建立多檔案專案,並即時預覽結果
  • Chat Mode 支援工具使用,例如網址擷取、計算及指令操作
  • 首次啟動自動配置,包括 Python 虛擬環境與 MLX 執行環境

最適合的場景,包括飛機上、網絡不穩定的地方、內部原型開發,或不想把敏感程式碼交給第三方服務的團隊。要留意的是,它目前明確針對 macOS 與 Apple Silicon,亦需要先下載模型;所以如果你用的是其他平台,或者電腦資源有限,體驗可能會受限制。整體而言,這是一個相當清晰的「離線 AI 編程」示範,也顯示本地小型模型已開始具備實用價值。

Source: https://github.com/ammaarreshi/gemma-chat

Categories: 開源, 編程, 蘋果

coreb:這個 code search 基準有咩特別?

CoREB 用實際程式題目評估代碼搜尋與重排,重點不只係搵到答案,仲要排得準。

Repository image for hq-bench/coreb

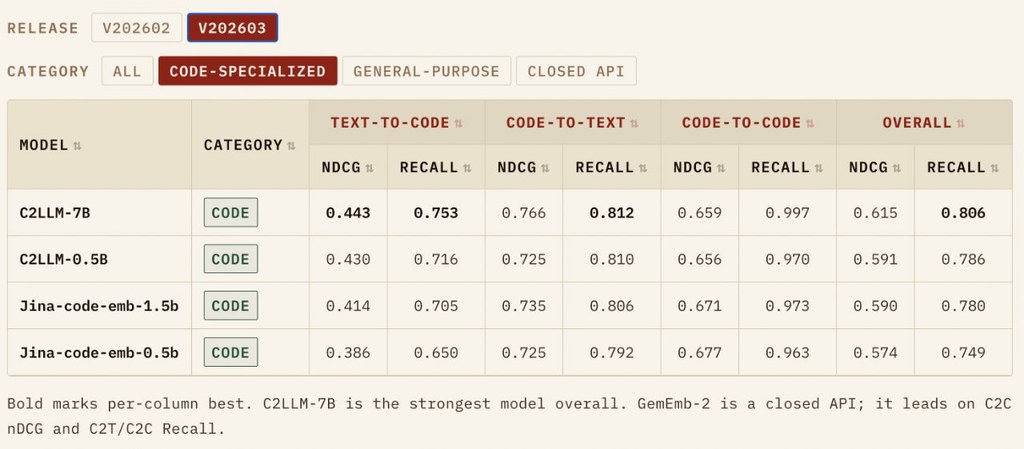
CoREB 係一個針對程式碼 embedding models 搜尋同 reranking 的評測基準,透過 LoRA 在混合重排序器語料庫上對Qwen3-Reranker-4B進行了微調。CoREB 分三種常見場景:用文字搵 code、用 code 搵相似 code,以及由 code 反推題目描述。一般人可以理解成:唔只測「搵唔搵到」,仲測「排位準唔準」。

實際使用上,你可以直接載入資料集,讀取 queries、qrels 同 code/text 語料,再用標準資訊檢索評分工具做評估;如果係模型開發者,亦可以接上兩階段流程,先做 embedding 檢索,再用 cross-encoder 重排。這個設計方便將現有搜尋模型快速放入同一把尺比較。

它最有價值的地方,係用三級相關性標註,將「真正答案」同「同題但錯嘅干擾項」分開,避免只係二元對錯。再加上問題切分唔重疊、涵蓋五種程式語言,令測試更貼近真實開發情境,而唔係只考記憶。

  • 支援 Text-to-Code、Code-to-Code、Code-to-Text 三類任務
  • 以三級相關性處理 hard negative,對排序更敏感
  • 涵蓋 Python、C++、Java、Go、Ruby
  • 訓練/測試分割避免題目重疊
  • 適合比較檢索模型同 reranker 的整體效果

如果你做的是程式碼搜尋、AI coding assistant,或者想評估向量檢索加重排的完整流程,CoREB 會幾有參考價值。特別係想避免資料污染、又想睇模型喺唔同語言同任務之間的差異,呢個基準算係比較務實的一種選擇。

Source: https://github.com/hq-bench/coreb

Categories: 開源, Embedding, 模型, 編程, 中國

awesome-llm-mas-rl:用軌跡看懂 LLM 多代理強化學習

這不是單純的論文清單,而是把 LLM 多代理強化學習整理成可追溯研究地圖的實用資源。

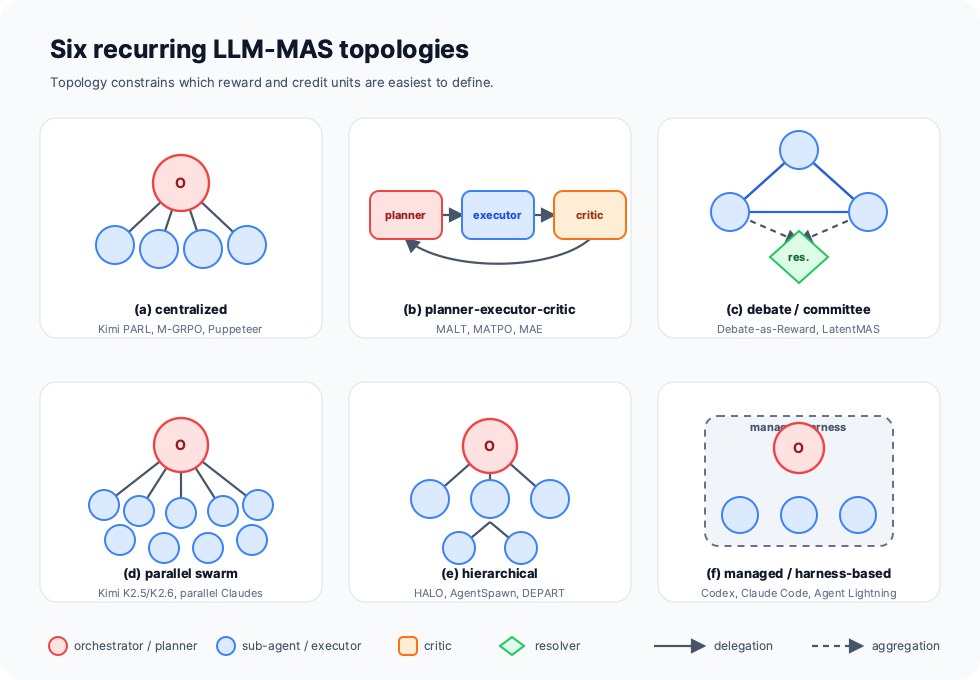
Six recurring LLM-MAS topologies

這個儲存庫聚焦在 LLM 多代理系統的強化學習與後訓練方法,但它的價值不只在蒐集文獻,更在於用一致的結構整理研究脈絡。相較一般 awesome list 偏向羅列連結,這個專案明顯更重視可稽核性、分類邏輯與後續分析用途。

實際使用上,讀者可以先從保留論文池與分類表快速瀏覽研究全貌,再進一步對照 CSV 與相關腳本確認統計與來源。若你正在做文獻回顧、研究選題,或想建立自己的資料集,這種「README 易讀、資料檔可驗證」的設計會比純手工整理更可靠。

它最值得注意的創新,是把 orchestration trace 當成核心組織概念:不只看單一代理的動作,而是追蹤任務分派、子代理生成、代理間通訊、工具呼叫、結果聚合、獎勵與成本等決策流程。對研究者來說,這讓多代理系統中的訓練訊號、責任歸因與系統證據更容易被明確描述,也更接近真實工作流。

  • 收錄 84 筆保留文獻,並附 32 筆排除紀錄,研究邊界相對清楚
  • 提供 JSON Schema、範例 trace 與無相依驗證器,方便檢查資料格式
  • 涵蓋 reward、credit design、benchmark、安全性與系統證據等面向
  • 適合用來建立文獻地圖,而不只是當作連結書籤

整體來看,這個專案最適合研究 LLM agent、multi-agent orchestration、RL 訓練流程的人使用,特別是需要整理證據鏈與實驗描述的學術或工程團隊。若你只是想找熱門論文,它可能稍微學術;但若你在意研究可重現性與結構化分析,這份資源相當有參考價值。

Source: https://github.com/xxzcc/awesome-llm-mas-rl

Categories: 編程

CWM (Code World Model) 32B – Meta 開源編程模型

Meta FAIR 的「Code World Model (CWM)」是一個 32B 參數、專門為「帶世界模型的程式碼生成研究」設計的開放權重 LLM。它的關鍵點是:不只學 code syntax,而是透過大量「執行軌跡」去內化程式執行對系統狀態的影響,並在多任務 RL 下強化 agentic coding 能力。 CWM 是什麼? 訓練流程與 world modeling 設計 CWM 的訓練 pipeline 不是單純「pretrain → SFT」,而是刻意插入 world‑model mid‑training,再加上多任務 RL: 這種設計的重點是:讓 RL 是「從已經具備世界模型的基底」開始,而不是只在純 token LLM 上做 RL,理論上比較容易學到長程規劃與工具使用策略。 模型架構與上下文長度 基準測試成績 在多個開源 benchmark 上,CWM 以 32B 級別達到非常有競爭力甚至 SOTA 的表現: 對你這種做 RAG / agent / tools‑calling 工作流的人來說,這顆模型的亮點其實是「在環境中操作和修 […]

Meta FAIR 的「Code World Model (CWM)」是一個 32B 參數、專門為「帶世界模型的程式碼生成研究」設計的開放權重 LLM。它的關鍵點是:不只學 code syntax,而是透過大量「執行軌跡」去內化程式執行對系統狀態的影響,並在多任務 RL 下強化 agentic coding 能力。


CWM 是什麼?

  • CWM(Code World Model)是一個 32 億參數(32B)、dense、decoder‑only 的 Transformer LLM,主要面向程式碼生成與程式相關推理。
  • 它被設計成「世界模型式」的 code LLM:不只預測下一個 token,而是學會在腦中「模擬程式執行過程」及其對環境狀態的影響。
  • 官方目標是提供一個強大的開放權重 testbed,讓研究者探索「世界模型 + agentic reasoning/planning」如何提升程式碼生成與軟體工程工作流。

訓練流程與 world modeling 設計

CWM 的訓練 pipeline 不是單純「pretrain → SFT」,而是刻意插入 world‑model mid‑training,再加上多任務 RL:

  • 前期:先在一般語言與程式碼資料上做大規模預訓練,建立廣泛的語言、程式知識基礎。
  • Mid‑training(世界模型核心):
    • 在大量「observation‑action 軌跡」上進一步訓練,這些軌跡來自 Python interpreter 執行 trace,以及在 Docker container 中以 agent 方式操作系統的互動紀錄。
    • 這類資料讓模型看到「程式片段/指令 → 執行過程 → 輸出與系統狀態變化」,等於學習一個對應「code → world dynamics」的隱式世界模型。
  • 後期 post‑training:
    • 先進行 supervised fine‑tuning,引入明確的 reasoning format、step‑by‑step 推理風格等標註資料。
    • 再用 multi‑task RL(文中提到使用 GRPO 類型方法)在可驗證的 coding 任務、數學問題、多輪軟體工程環境中進行強化學習,reward 來自於測試通過率、解答正確與任務完成度。

這種設計的重點是:讓 RL 是「從已經具備世界模型的基底」開始,而不是只在純 token LLM 上做 RL,理論上比較容易學到長程規劃與工具使用策略。


模型架構與上下文長度

  • CWM 是一個 64 層的 decoder‑only Transformer,採用現代 LLM 常見配置(例如 RoPE 位置編碼、SwiGLU FFN、GQA 等)。
  • 參數規模為 32B,詞彙表約 128k token,明顯針對大型 codebase 與多語言程式碼場景設計。
  • 上下文長度最高達約 131k tokens,可容納整個專案、多檔案上下文與長程互動軌跡。
  • 為了處理這種長上下文,它使用「交錯式注意力」:
    • 多數層採局部 attention(例如 8,192 token 視窗),每隔數層插入一次 global/sliding attention 層可以看到完整 131k 上下文,文中描述比率約為 3:1。
    • 這樣的設計在計算量可控的前提下,仍能在多層中“刷新”全局資訊,對閱讀大型 codebase 與長對話 debugging 特別有利。

基準測試成績

在多個開源 benchmark 上,CWM 以 32B 級別達到非常有競爭力甚至 SOTA 的表現:

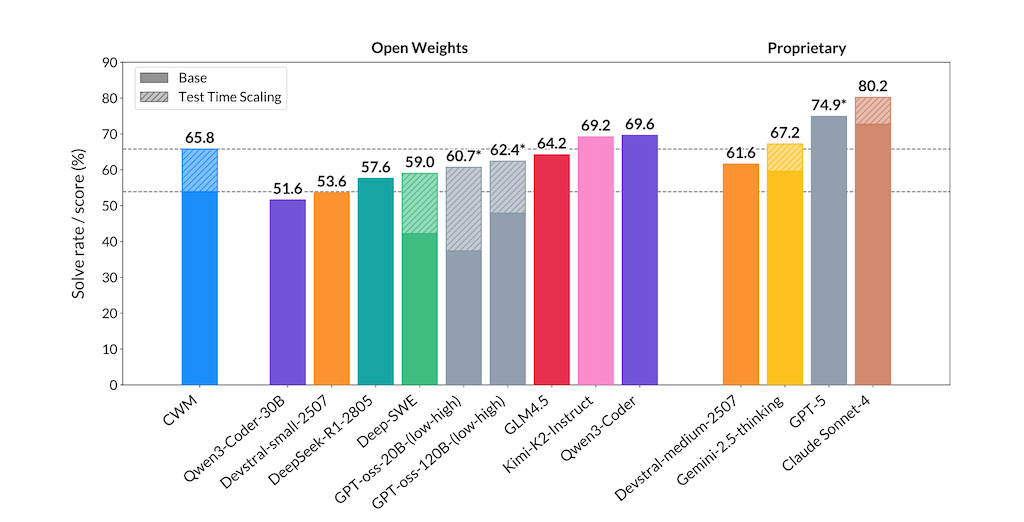
  • SWE‑bench Verified:pass@1 約 53.9%(不做 test‑time scaling),在採用 test‑time scaling 後可達約 65.8%。
  • LiveCodeBench:v5 約 68.6,v6 約 63.5(pass@1)。
  • 數學與推理:
    • Math‑500 約 96.6%。
    • AIME 2024 約 76.0%。
    • CruxEval Output 約 94.3%。
  • 論文與解讀都提到:在同等或相近參數規模的開放權重 LLM 中,CWM 在一般 coding 與更 agentic 的軟體工程任務上都具有「best‑in‑class」水準,甚至接近或追平一些封閉大模型。

對你這種做 RAG / agent / tools‑calling 工作流的人來說,這顆模型的亮點其實是「在環境中操作和修 bug 的能力」,而不只是單輪 code completion 分數。


權重釋出與取得方式

  • Meta 以「開放權重」形式釋出 CWM,提供多個 checkpoint:
    • mid‑training 後的 world‑model 版本。
    • SFT 後版本。
    • RL 後完整版。
      方便研究者分析各階段對能力的影響。
  • 社群整理指出,CWM 權重目前在 GitHub 與 Hugging Face 上提供,包含 transformers 版權重與推理程式碼;Meta 採用自家訂定的 open‑weights 授權條款,主要定位在研究用途,具體使用限制需看 AI at Meta 官方頁與 HF model card 條款。
  • Hugging Face transformers 已內建 CwmForCausalLM 與對應 tokenizer。

與一般 code LLM 的本質差異

和傳統只在「靜態 code corpora + 少量程式執行資料」上訓練的 code LLM 相比,CWM 的幾個關鍵差異:

  • 訓練核心是「大量程式執行與 agent interaction 的軌跡」,把「程式 → 執行 → 狀態變化」當成序列學習對象,形成隱式世界模型,而不只是 code token 統計模型。
  • RL 設計是圍繞「可驗證結果」(例如測試通過、問題解答正確、多輪任務完成),而不僅是人類偏好/指令跟從,這對長程規劃與工具調度尤其重要。
  • 長上下文 + 交錯 attention 讓模型可以在一次推理中讀完整個 repo、ticket 歷史與多輪 log,這是很多傳統 code LLM 現階段比較薄弱的地方。
Categories: 模型, 編程

tLLM 推論引擎擴展

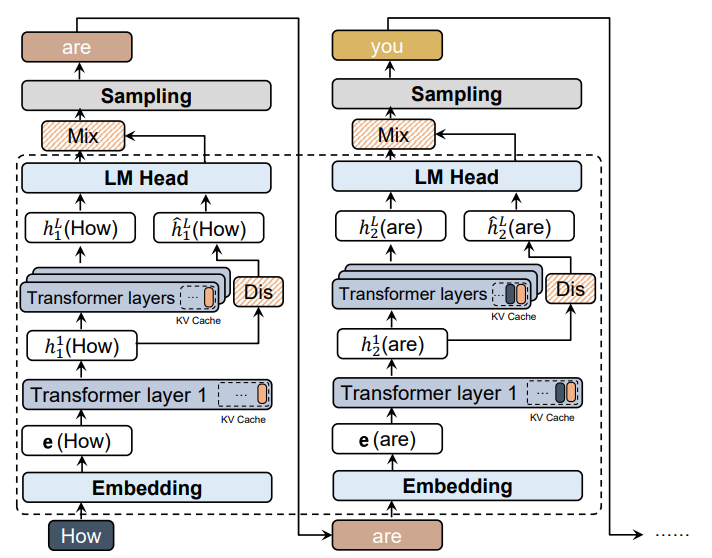
tLLM 是 vLLM 推論引擎的運行時擴展層,提供生產者/消費者(Producer/Consumer)架構,能在生產環境中訓練和管理蒸餾器。 tLLM 的角色 tLLM 可應用於醫療問答系統中,提升 RAG 生成的多樣性與準確性,特別適合配合 MedGemma 專案。 透過 ESamp (Exploratory Sampling )方法,在高吞吐 vLLM 服務下動態訓練輕量蒸餾器,引導模型探索未見語義區域,避免重複答案。 案例:醫療 RAG 系統 假設您建置一個基於 MedGemma 的繁體中文醫療 RAG 系統,處理患者查詢如「糖尿病併發症預防」。 此案例在 RTX 4090 上吞吐 4000+ tokens/sec,適合部署於 WhatsApp 查詢閘道,提升 Cantonese/繁中醫療 NLP 效能。 程式碼範例:整合 tLLM 至 vLLM Engine,engine = TLlmEngine.from_engine_args(engine_args) 啟動生產者/消費者。

tLLM 是 vLLM 推論引擎的運行時擴展層,提供生產者/消費者(Producer/Consumer)架構,能在生產環境中訓練和管理蒸餾器

tLLM 的角色

  • 生產者管道:從 vLLM 推論中即時捕捉 LLM 的深層隱藏狀態(latent representations)
  • 消費者管道:非同步訓練輕量 MLP(~1M 參數),這就是 Latent Distiller(潛在蒸餾器)

tLLM 可應用於醫療問答系統中,提升 RAG 生成的多樣性與準確性,特別適合配合 MedGemma 專案。 透過 ESamp (Exploratory Sampling )方法,在高吞吐 vLLM 服務下動態訓練輕量蒸餾器,引導模型探索未見語義區域,避免重複答案。

案例:醫療 RAG 系統

假設您建置一個基於 MedGemma 的繁體中文醫療 RAG 系統,處理患者查詢如「糖尿病併發症預防」。

  • 標準 vLLM:依賴檢索文件生成單一答案,易陷入常見模式,Pass@1 低於 60%。
  • tLLM + ESamp:啟用生產者管道捕捉隱藏表示,消費者訓練 Latent Distiller(MLP,~1M 參數),使用預測誤差作為新穎度信號。
  • 運行流程:批次 32 查詢並行生成,蒸餾器線上更新(<5% 開銷),重新取樣產生多樣候選(如生活調整、藥物、飲食多視角),Pass@k 提升 20-30%。

此案例在 RTX 4090 上吞吐 4000+ tokens/sec,適合部署於 WhatsApp 查詢閘道,提升 Cantonese/繁中醫療 NLP 效能。 程式碼範例:整合 tLLM 至 vLLM Engine,engine = TLlmEngine.from_engine_args(engine_args) 啟動生產者/消費者。

Categories: 開源, 模型訓練, 編程

ClawGym 構建高效的 Claw 代理框架

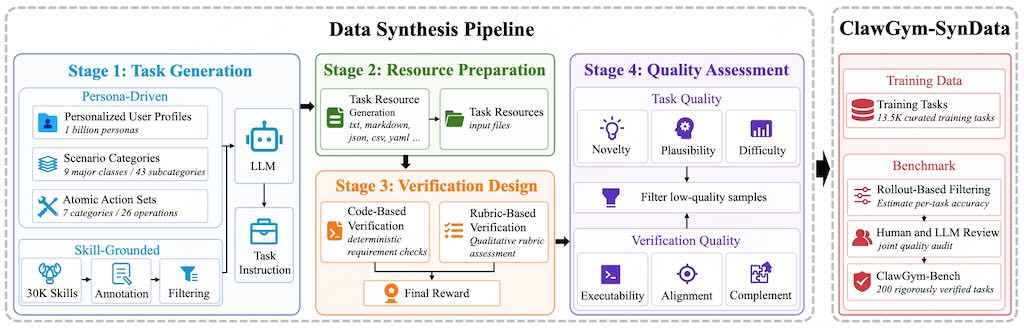
ClawGym 框架的主要用途在於訓練和評估能夠在真實系統上執行任務的 AI 代理。以下是它的核心應用場景: 代理訓練與開發 ClawGym 提供完整的流程讓開發者能夠構建高效的 Claw 代理。框架透過合成大規模任務數據(13.5K 個經過篩選的任務)和智能軌跡收集,使 LLM 模型能夠學習如何在 OpenClaw 框架上自動執行真實任務。 自動化辦公與生產力 根據 OpenClaw 生態應用,Claw 代理可以執行: 企業級多智能體協作 ClawGym 支持構建多智能體團隊系統,實現: 性能評估與基準測試 ClawGym-Bench 提供了 200 個真實場景的評估基準,測試代理在辦公協同、信息檢索、內容創作、數據處理等場景的表現。

ClawGym 框架的主要用途在於訓練和評估能夠在真實系統上執行任務的 AI 代理。以下是它的核心應用場景:

代理訓練與開發

ClawGym 提供完整的流程讓開發者能夠構建高效的 Claw 代理。框架透過合成大規模任務數據(13.5K 個經過篩選的任務)和智能軌跡收集,使 LLM 模型能夠學習如何在 OpenClaw 框架上自動執行真實任務。

自動化辦公與生產力

根據 OpenClaw 生態應用,Claw 代理可以執行:

  • 代碼沙箱運行:自動編寫並執行 Python 腳本,完成非結構化數據的抓取與清洗
  • 跨應用自動化:通過自然語言完成複雜的多步驟工作流,例如「幫我設計一個監控面板,每天定時抓取 A 股新上市企業數據」,代理會自主規劃路徑:編寫爬蟲 → 抓取數據 → 自動修正邏輯 → 生成展示頁面
  • 辦公助手場景:寫代碼、寫文檔、處理日常流程

企業級多智能體協作

ClawGym 支持構建多智能體團隊系統,實現:

  • 多個 AI 分析師並行評估投資價值
  • 多智能體深度研究項目和趨勢分析
  • 代碼漏洞和架構質量的聯合審查

性能評估與基準測試

ClawGym-Bench 提供了 200 個真實場景的評估基準,測試代理在辦公協同、信息檢索、內容創作、數據處理等場景的表現。

Categories: 開源, Agentic, , 編程, OpenClaw

Page 6 of 11
1 4 5 6 7 8 11