EdgeBench 用 134 個長任務量度智能體成長

模型識幾多,未必等於學得幾快。EdgeBench想回答的,是智能體在真實環境中隨時間互動後,能力會怎樣上升。

ligo gw

跑一次就評分的基準,通常只能看出模型本身已經識乜;EdgeBench關注的是另一件事:當智能體放進接近真實工作的環境,連續做十幾個鐘、接收回饋再反覆修正,它究竟會唔會愈做愈好。這是一個研究 environment learning 的 benchmark,核心問題不是單次答對率,而是學習曲線能否反映長時間互動後的能力變化。

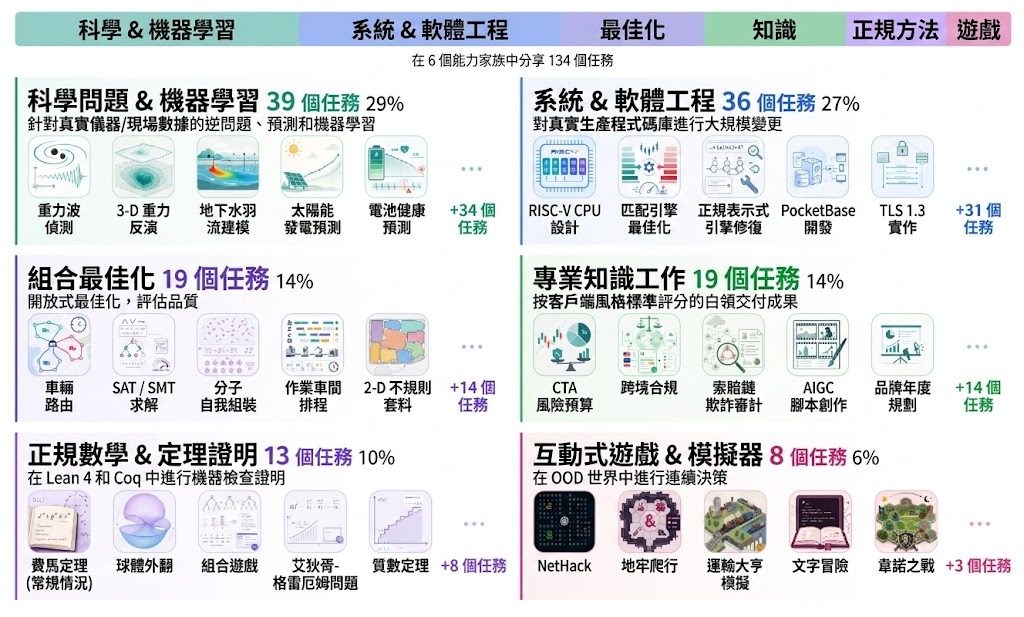
它把 134 個任務分成六大類,包括科學與機器學習、系統與軟件工程、組合最佳化、知識工作、形式數學同遊戲,而且每個任務最少運行 12 小時,部分延伸到 72 小時以上。這個設計接近真實工作流,因為智能體需要面對 build logs、test failures、objective values、simulator traces、實驗誤差等回饋,而唔係只靠一次生成結果交卷。

同常見 benchmark 相比,EdgeBench的差異在於它量度「隨經驗累積而改善」的能力。研究者指出,多個模型在 134 個任務上的整體表現,都可用 log-sigmoid function 擬合,R²約為 0.997 至 0.999,表示 environment interaction time 與表現提升之間有相當穩定的關係。這令它不只是一張排行榜,也是一個用來觀察 scaling laws of environment learning 的分析工具。

  • 覆蓋 134 個真實世界長時任務,重點放在學習速度與上限
  • 任務橫跨科學、編程、最佳化、知識工作、數學與遊戲
  • 每項任務持續 12 小時以上,部分超過 72 小時
  • 回饋訊號來自接近真實工作的執行環境,而非單次靜態題目
  • 整體學習曲線可用 log-sigmoid function 高精度擬合

這套 benchmark 對做 Agentic 項目、長流程自動化、程式代理與研究型智能體的人最有參考價值,因為它直接呈現模型在長時間任務中的耐力、修正能力與邊做邊學的幅度。現有資料集中在 benchmark 設計、任務結構、資料集與分析結果,未提供具體安裝步驟或完整使用流程;能確定的是,這個項目由 ByteDance Seed 發表,並附有 Paper、GitHub 與 Dataset 入口。
項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, Agentic, 模型訓練, DeepSeek, 框架, 軟件, 編程, Anthropic, Dataset 數據集

open-design:本地優先的開源設計工具

open-design 是一款本地優先的桌面應用,讓 AI 編碼代理直接生成設計稿、頁面與多媒體內容。

Og image

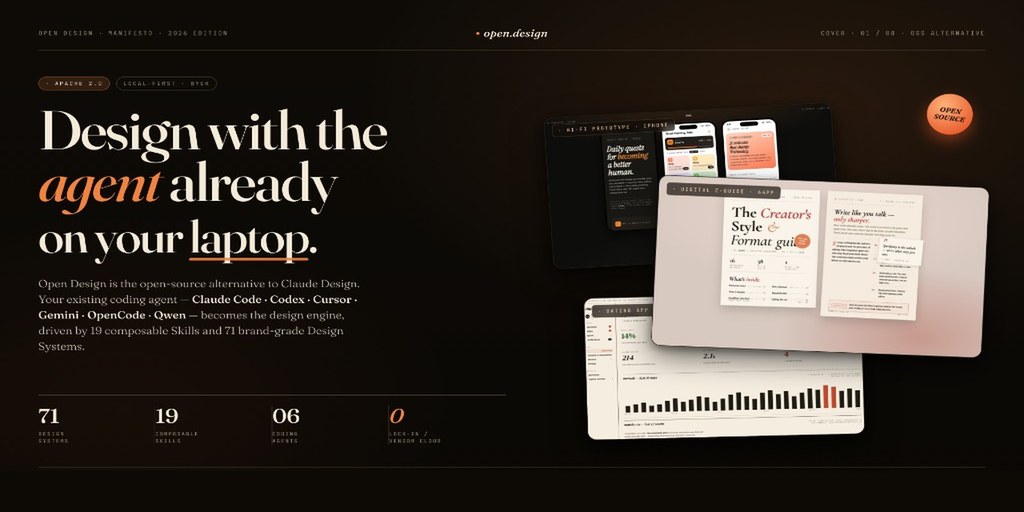
open-design 是一款本地優先(local-first)的開源桌面應用程式,主打讓 AI 編碼代理(coding agent)直接充當設計引擎,協助用戶快速產出原型設計(prototypes)、登陸頁面(landing pages)、儀表板(dashboards)、投影片、圖片甚至影片等各種多媒體素材,並輸出真實可用的檔案。這個項目的定位是 Claude Design 的開源替代方案,強調在桌面環境中本地執行,無需依賴雲端服務即可完成設計工作。

與傳統的設計工具相比,open-design 的最大差異在於將 AI 編碼代理作為核心驅動力,用戶可以透過自然語言指令讓代理直接生成設計內容,省去手動拖拽元件的繁瑣流程。從 GitHub 上的數據可見,該項目已獲得超過 7.5 萬顆星及 8 千多次 fork,社群關注度相當高,顯示開源社群對本地化 AI 設計工具的強烈需求。

這個項目最適合需要快速產出網頁原型或行銷素材的開發者、設計師及內容創作者。對於重視資料隱私、希望在本地環境完成設計工作的人來說,local-first 的架構尤為吸引。開發者亦可將其整合到現有的編碼工作流中,讓 AI 代理同時負責程式碼與設計兩個層面。

以下是這個項目的重點摘要:

  • 屬於本地優先的開源桌面應用,定位為 Claude Design 的替代方案
  • 核心功能是讓 AI 編碼代理生成設計稿、頁面、儀表板及多媒體內容
  • 強調本地執行,無需依賴雲端服務,保障資料私隱
  • 適用於開發者、設計師及內容創作者快速產出原型與行銷素材
  • 社群關注度高,GitHub 上已累積超過 7.5 萬顆星

由於該項目仍處於活躍開發階段,功能成熟度與跨平台支援等細節尚未完全明朗,建議有興趣的使用者持續關注其更新進度。

項目主頁

以下是該網頁主要內容(麻省理工學院電子工程與計算機科學系 MIT EECS 的訪談文章)的繁體中文翻譯:

(more…)
Categories: 開源, Agentic, MCP, Vibe Coding, 編程, 安全, Skill 技能

PAW:把英文編譯成本地函數

PAW(programasweights-python) 不是一般 LLM 封裝,而是把文字需求變成可離線執行的小型神經函數。它瞄準規則難寫、又不想長期依賴 API 的文字處理工作。

Repository image for programasweights/programasweights-python

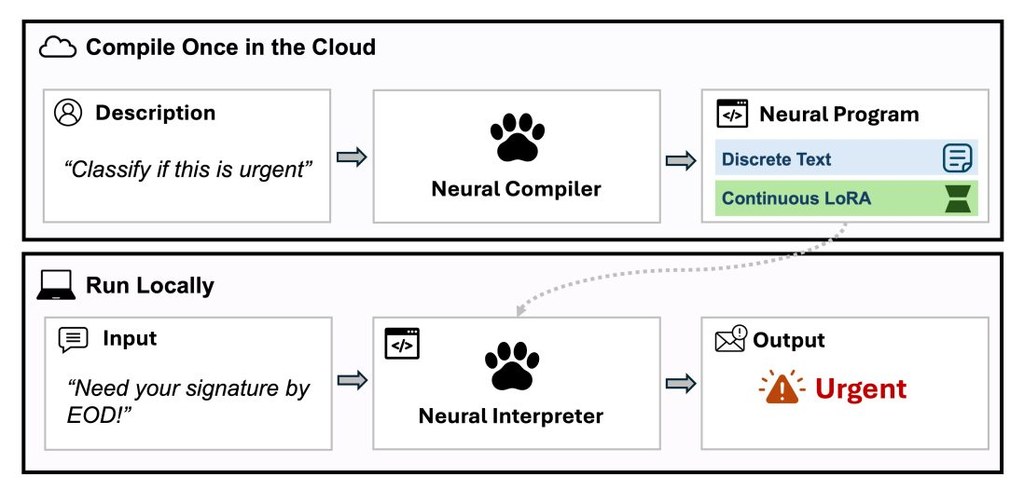
PAW(programasweights-python)是一個 Python 工具兼研究原型,屬於把「自然語言」規格編譯成小型神經函數的項目。它要解決的是一類很難用正則表達式或硬編碼規則寫穩定的工作,例如修復壞掉的 JSON、模糊搜尋、分類、抽取欄位,以及把文字意圖對應到正確操作。

現有做法通常有兩條路:一條是手寫規則,遇到錯字、格式飄移同邊界情況就容易失準;另一條是把每次輸入都送去 LLM API,換來較高彈性,但會帶來網絡依賴、成本同重現性問題。Program-as-Weights(PAW)提出的做法,是先用一個 compiler 把英文描述編譯成可重用的神經程式,之後每次呼叫都在本機執行,定位由「每次都問模型」改成「先造好工具再反覆用」。

安裝路線相當直接:Python 端可透過套件取得預編譯函數,亦可自行 compile;瀏覽器端則有 @programasweights/web,但只限用 paw-4b-gpt2 這條較細的 runtime。部署取捨也寫得清楚,paw-4b-qwen3-0.6b 準確度較高,程式體積約 22 MB,本地推理約 0.05 至 0.5 秒;paw-4b-gpt2 準確度較低,但程式只有約 5 MB,支援 WebAssembly,較適合前端或輕量分發。

項目的技術定位:作者把這類問題稱為 fuzzy-function programming,並釋出 FuzzyBench 這個 10M examples 數據集,用 4B compiler 為 frozen interpreter 產生 parameter-efficient adapters。文中指出,0.6B Qwen3 interpreter 執行 PAW 程式時,效果可接近直接 prompting Qwen3-32B,同時把推理記憶體壓到約五十分之一,並在 MacBook M3 達到 30 tokens/s;這些數字有助理解它不是單純包裝模型,而是在成本、可重用性與離線能力之間重新分配。

  • 核心價值:把一次性的自然語言需求,轉成可重複呼叫的本地函數
  • 適合情境:日誌分流、格式修復、文字分類、資料抽取、意圖路由
  • 主要取捨:比直接調用大型 API 更可控、可離線,但編譯器與 runtime 選型會影響準確度與體積
  • 相關模型paw-4b-qwen3-0.6bpaw-4b-gpt2,論文亦以 Qwen3-32B 作對照
  • 受益團隊:重視本地執行、穩定輸出、低成本重複推理的開發團隊會較易受惠

這個項目最適合放在「規則太脆弱、API 又太重」的中間地帶。它未必取代通用 LLM,但對一批固定任務而言,先編譯、後離線執行的方式更像真正可落地的工程工具。

項目主頁 · GitHub · Paper

Categories: 開源, Qwen, API, Python, 編程, Dataset 數據集

Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

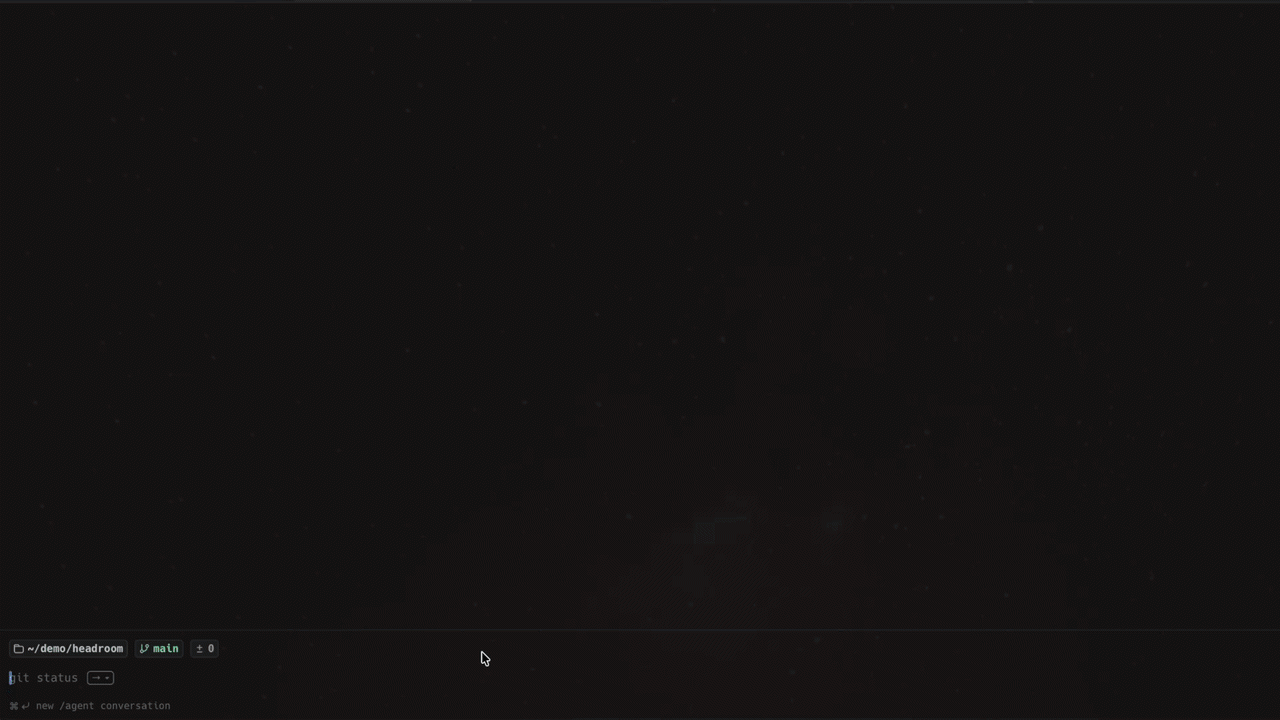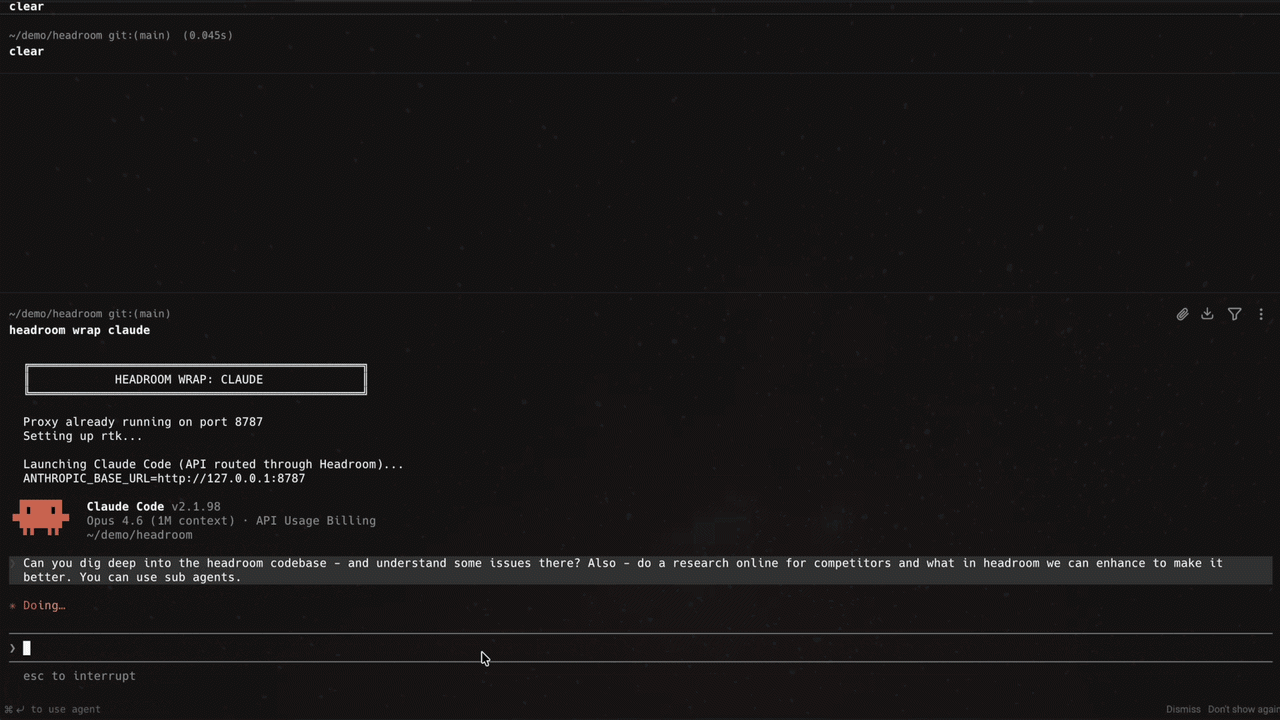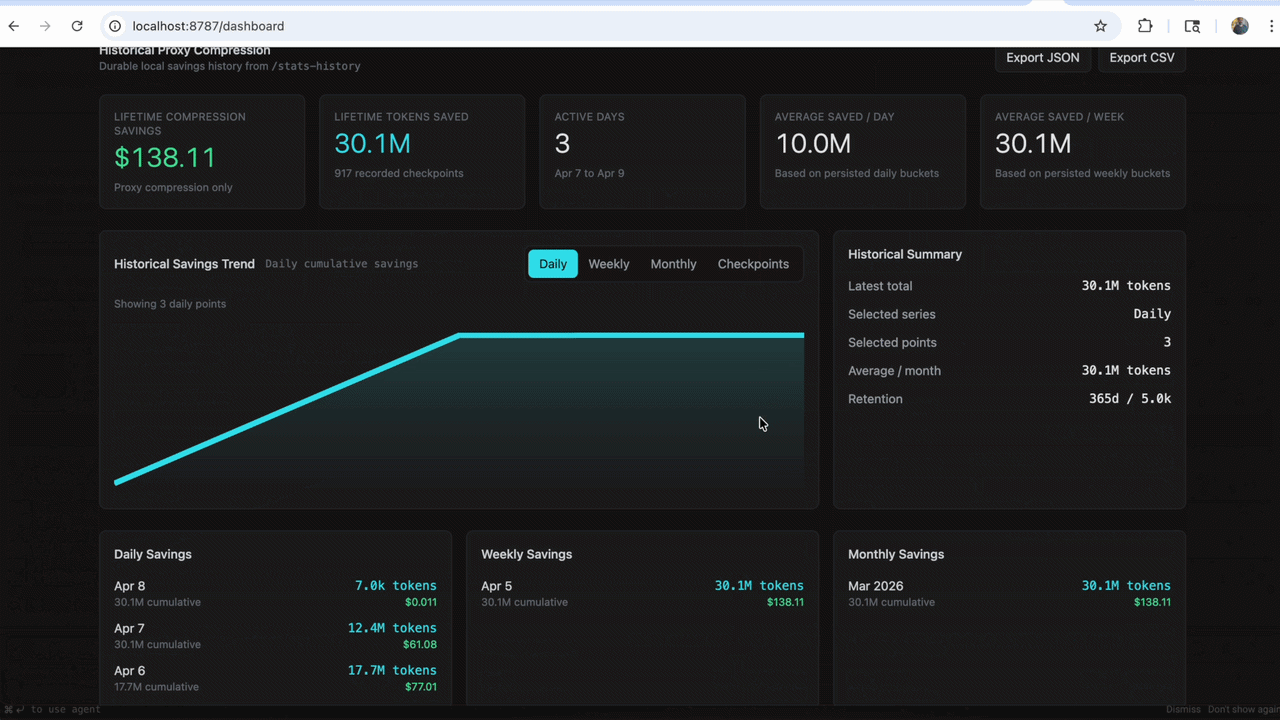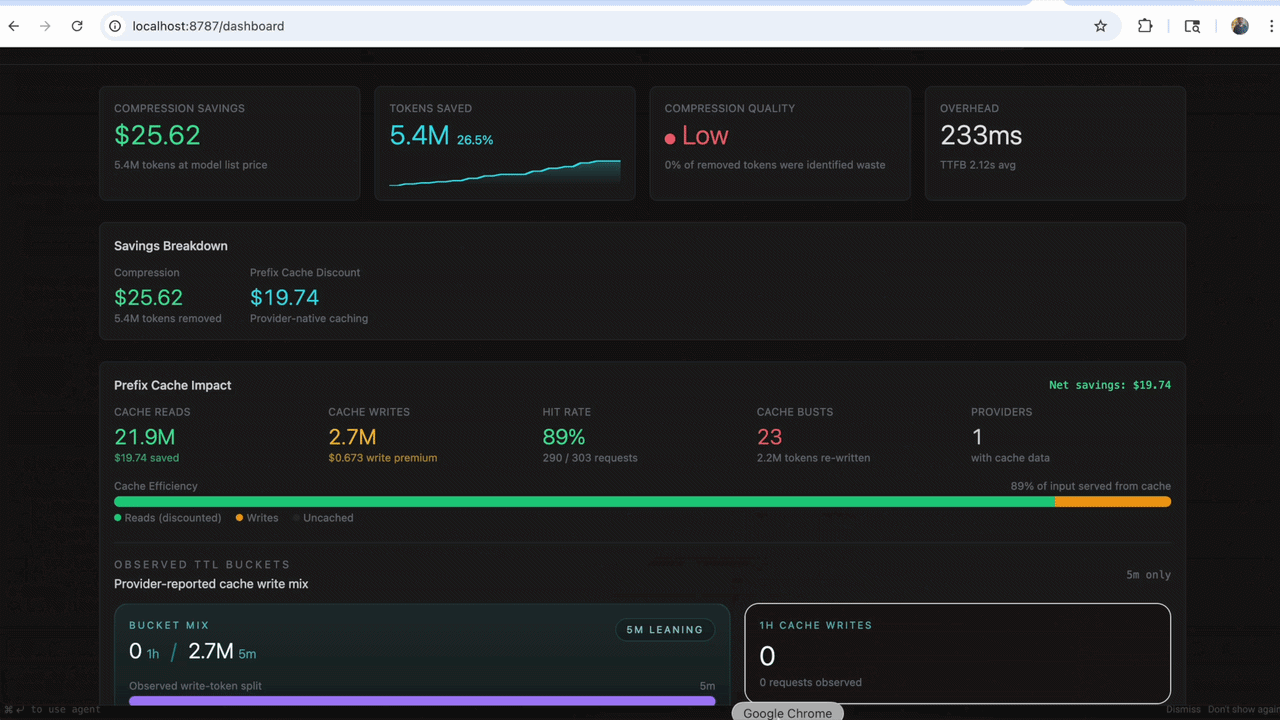
Headroom in action

Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。

GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, , 編程, Anthropic

微軟用殘差強化學習補強機械人 VLA

這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。

Og image

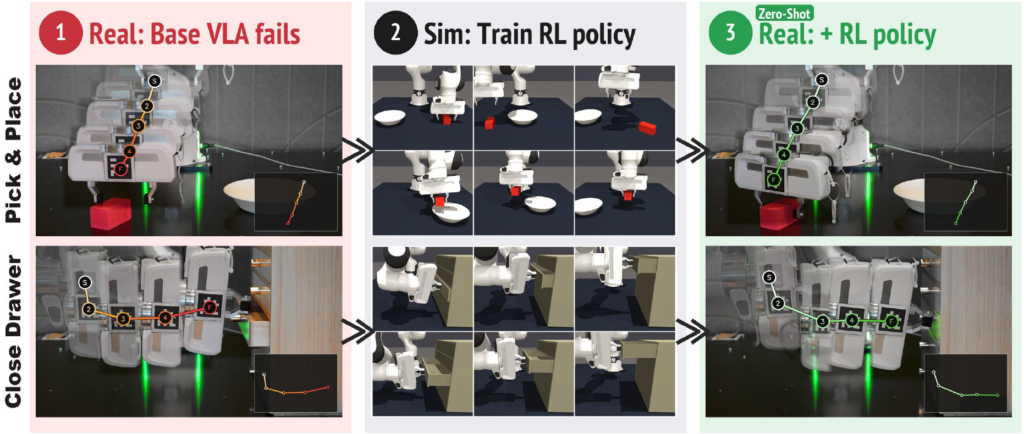
這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。

核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。

這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。

  • 保留 frozen base VLA,不用重訓整個模型
  • residual policy 以物件中心狀態為主,減少依賴影像對齊
  • 目標是 zero-shot sim-to-real enhancement
  • 適合需要精準抓取、放置或接觸操作的機械人工作流

這類方法較適合關注 VLARobotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。

項目主頁 · Paper

Categories: Agentic, AI productions, 視覺模型, 多模態模型, 微軟, Image, VLA, Robotic, 框架, 編程, 安全

多模態程式碼生成論文整理:視覺輸入如何改變寫程式

一份聚焦於「看圖寫程式」的論文清單,涵蓋 UI、圖表、SVG、CAD 等多模態程式碼生成的研究與基準。

mllm code logo

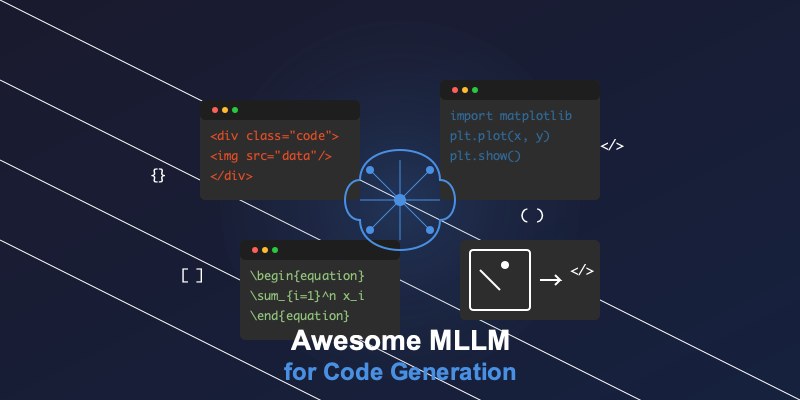
Awesome-Multimodal-LLM-for-Code 是一份論文整理型資源庫(paper list / survey collection),專門蒐集「多模態大型語言模型(Multimodal LLM, MLLM)用於程式碼生成」相關的研究論文、基準測試與評估方法,核心任務是把「視覺輸入」與「程式碼輸出」串接起來,例如把 UI 截圖、圖表、SVG 向量圖、CAD 草圖轉成可執行的程式碼。

傳統的 text-to-code 研究主要處理純文字描述生成程式碼,但很多真實任務的意圖是透過圖片、影片或互動畫面來表達的,純文字範式無法處理版面配置、視覺語意與互動行為等約束。這個資源庫把研究切成清楚的子題,包括 Web/Mobile UI 程式碼生成、科學圖表程式碼生成、視覺豐富的程式設計題、SVG 生成、簡報生成、UML、CAD、海報、3D 點雲、遊戲程式碼,以及程式修復等,方便研究者按場景查找對應論文。

與一般 Awesome 列表相比,這份資源的差異在於聚焦於「視覺證據如何影響程式正確性」,並收錄了 Design2Code、ChartMimic、Chart2Code、StarVector、PPTAgent、ScienceAgentBench 等具代表性的基準測試與模型。從支援資料可以看到,附帶的 survey 論文進一步把領域分成 GUI、科學視覺化、結構化圖形與前沿任務四大類,並指出視覺相似度不足以評估正確性,還需要語意、互動與領域約束的證據。

前端工程師、資料視覺化研究者、AI 程式碼助手開發者,以及做 benchmark 設計的人特別有用,能快速掌握 MLLM 在程式碼任務上的最新進展與評測方法。

重點摘要:

  • 屬於論文整理資源庫,聚焦多模態程式碼生成
  • 涵蓋 UI、圖表、SVG、CAD、簡報、3D 等十多個子題
  • 收錄 Design2Code、ChartMimic、ScienceAgentBench 等基準
  • 強調視覺相似度不足以評估程式正確性
  • 原始資料未提供安裝或部署方式,僅供論文索引與閱讀

GitHub: https://github.com/xjywhu/Awesome-Multimodal-LLM-for-Code

Categories: 開源, 香港中文大學, 香港大學, 南京大學, 香港, 編程, 中國

Google AI Studio’s Interactions API

Interactions API 讓開發者用同一介面連接 Gemini 模型與 agents。它重點解決多種互動方式分散、整合複雜的問題。

Og image

Gemini Interactions API 是實驗性 API,可讓開發人員使用 Gemini 模型建構生成式 AI 應用程式。Gemini 是 Google 最強大的模型,打從設計之初就具有多模態的特質。可歸納內容,完美解讀、操作及結合語言、圖片、音訊、影片和程式碼等不同類型的資訊。您可以使用 Gemini API 處理各種用途,例如:跨文字和圖片進行推論、生成內容、對話式代理程式、摘要和分類系統等。

這是一個供開發者使用的 API,屬於 Google AI Studio 的 Interactions API。它的主要用途,是用一個統一介面去操作 Gemini models 與 agents,方便把模型回應、工具呼叫和代理人流程放在同一套工作流內處理。

和一般逐步拼接多個端點的做法相比,較值得留意的是它主打「統一」:同時面向模型和 agents,減少來回切換不同介面的負擔。這對要做多步驟互動、工具協調、或需要把 AI 行為包成穩定流程的團隊會更實用。

  • 統一處理 Gemini models 與 agents
  • 適合原型、整合與工作流測試
  • 方便把模型回應與工具呼叫串接
  • 較適合開發者與 agent 應用場景

項目主頁: blog.google

Categories: Agentic, AI productions, 模型, Google, OpenAI, Gemini, API, 軟件, 工具, 編程

HyperFrame 配合 Claude Code 製作 Vox 風格影片

這段影片展示用 AI 工具整理敘事影片流程。重點在於把腳本、視覺與製作步驟串連起來。

Og image

現有資料主要來自 YouTube 標題與簡短描述,資訊不算完整,但仍可看出內容圍繞 HyperFrame 與 Claude Code 兩個工具,示範如何做出接近 Vox 風格的解說影片。讀者可先把它理解為一個 AI 輔助影片製作項目:由工具協助處理腳本、畫面規劃或製作流程,而不只是單一步驟生成。

這類項目想處理的問題,很可能是把資料整理、敘事結構、畫面設計與影片產出連成一條工作流。相比只用單一影片生成模型,這種做法更接近內容製作流程本身,重點不只是「出片」,而是如何把想法變成有節奏、有資訊層次的短片。

從標題判斷,Claude Code 可能負責文字、結構或流程協調,HyperFrame 則可能用於畫面或影片製作環節。不過頁面未提供更詳細技術內容、模型名稱或量化結果,因此未能確認兩者各自負責的步驟,也不能判斷成品質素是否穩定。

可先留意幾個重點:
– 這是一個偏向工作流整合的影片製作項目
– 目標風格是資訊密度較高的 Vox 式解說內容
– 適合內容創作者、營銷製作與短片腳本規劃
– 現有頁面缺少性能數據、成本與時間比較

如果想進一步測試,較可行的方法是先觀看原片,記錄它如何拆分腳本、旁白、畫面節奏與素材安排,再用同類工具重建其中一小段。以目前資料來看,這項內容較適合作為工作流觀察,而不是完整教學或技術評測。

項目主頁: https://www.youtube.com/watch?v=XVsGK99E9FA

Categories: AI productions, Video, Vibe Coding, 教學, 工具, Content Creator, 編程, Anthropic

SR-REAL 把空間推理拆成兩條路

SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

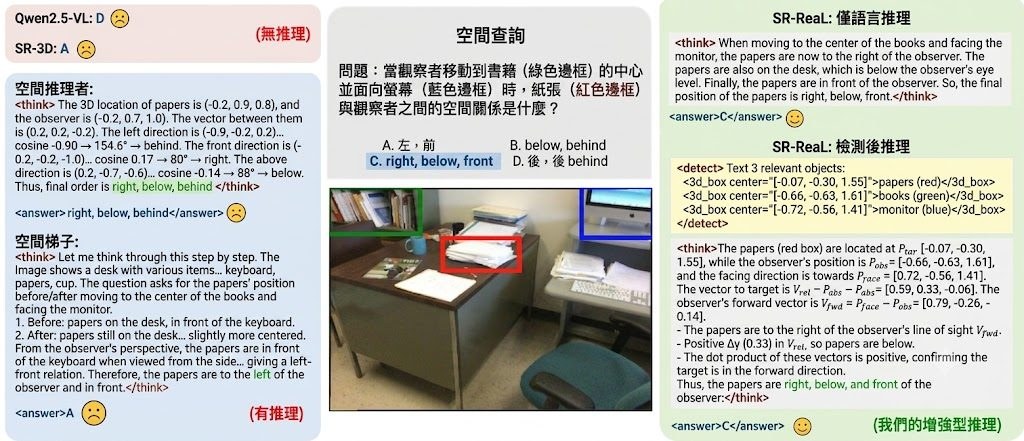
現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, , 編程

ENPIRE : NVIDIA 閉環系統訓練機械人自我改良

ENPIRE 把真實機械人訓練變成可反覆優化流程,讓 coding agents 直接參與改良策略。

NVIDIA

ENPIRE 是一個用於真實世界機械人策略自我改良的框架,重點不是單一模型,而是把「重設場景、執行策略、檢查結果、再改進」串成可重複閉環。它針對的問題很明確:靈巧操作任務一直很依賴人手監督與大量調參,令機械人研究難以擴展。

系統由四個模組組成:Environment(EN)負責自動重設與驗證、Policy Improvement(PI)負責發動策略改良、Rollout(R)負責在單機或多機械人上測試、Evolution(E)則讓 coding agents 分析紀錄、查閱文獻、調整訓練基建與演算法程式。與常見只在模擬器或純數碼環境做 agent 優化的方法相比,ENPIRE 把回饋迴路直接放到真實機械人上。

列出的案例包括 PushT、Pin Insertion、Tie Zip-tie 與 GPU Insertion,可見它瞄準的是需要精準操作的任務。按頁面描述,frontier coding agents 在這套流程下,可把部分真實操作任務推高至 99% 成功率,但不同任務、機械人配置與訓練設定之間仍可能有差異,閱讀時宜把它視為特定條件下的結果。

若想理解這個項目,可先從它的閉環結構入手,再看 Policy Improvement 支援哪些路線,例如 heuristic learning、tool calling、behavior cloning、offline RL 與 online RL。頁面亦提到 robot fleet scaling、simulation evaluation、auto evaluation 與 auto reset,反映這個項目不只關心模型表現,也在處理如何把測試與迭代流程自動化。

  • 核心價值:把真實機械人訓練流程標準化,減少人手介入
  • 主要差異:不是只生成策略,而是連同驗證、重設、改良一起自動執行
  • 適合讀者:機械人研究者、Agentic AI 開發者、關心自動化實驗流程的人
  • 已提方法:heuristic learning、tool calling、behavior cloning、offline RL、online RL

這項目較適合放在機械人學習、自主代理與真實世界實驗自動化的脈絡下理解。若你關心 Computer-use agents 或 coding agents 能否走出螢幕、直接管理物理系統的迭代流程,ENPIRE 提供了一個相當具體的方向。

項目: https://research.nvidia.com/labs/gear/enpire/

Categories: 開源, Agentic, 模型, 模型訓練, NVIDIA, Robotic, 框架, Vibe Coding, Clone, 編程

Page 4 of 11
1 2 3 4 5 6 11