RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

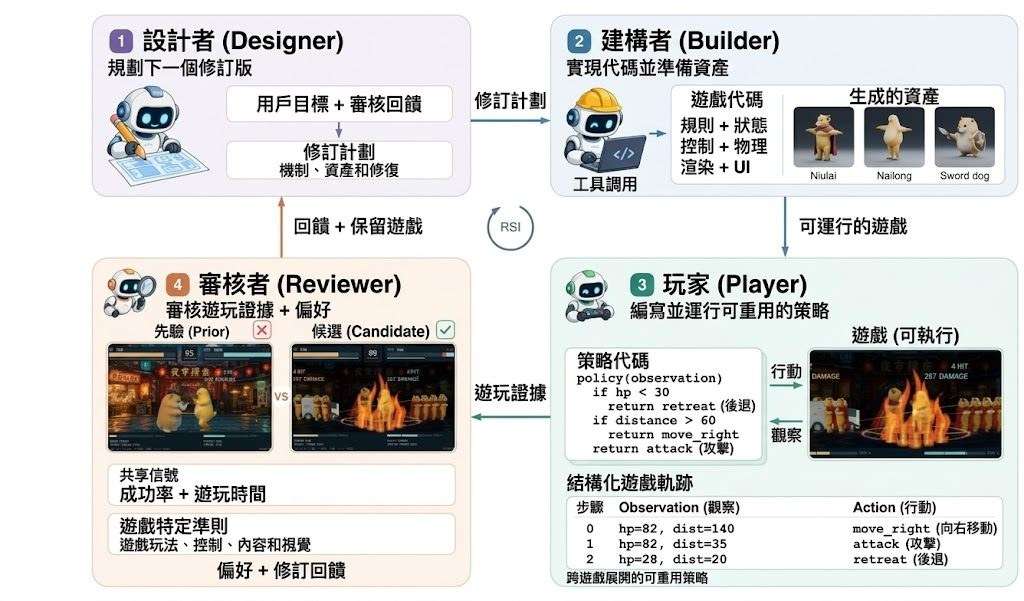
遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points
項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

RSIGame:生成遊戲及自行測試與進化

RSIGame 讓 AI 由遊戲構想開始反覆遊玩、找錯和改寫程式,直到品質提升飽和,再保留最佳版本。

RSIGame

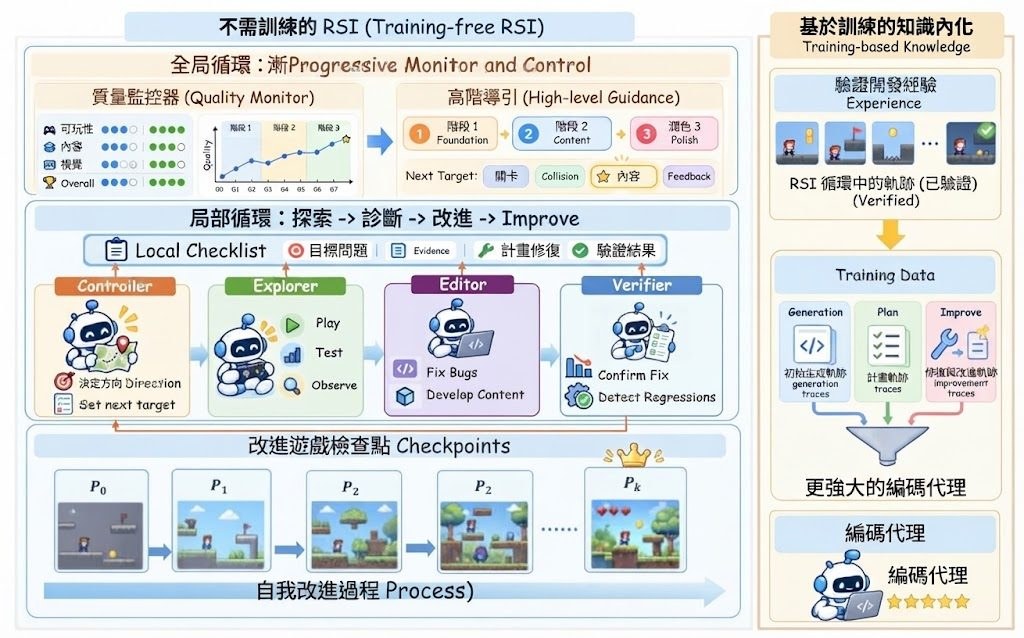
由一句高層遊戲構想開始,系統會自行產生可玩的版本,透過 AI agents 反覆遊玩、檢查問題,再改寫遊戲程式。RSIGame 屬於 autonomous agentic game development framework,實際處理的是生成遊戲難以持續修正、容易只迎合少量測試案例的問題。

RSIGame 把流程分成 local loop 和 global loop:前者執行 explore-diagnose-improve,廣泛探索遊戲、整理問題優先次序,再按證據修改;後者追蹤整體品質、保存最佳 checkpoint,並在長時間開發中識別停滯或回退。測試指引亦會逐步累積,令後續檢查不只依賴原本的提示。

透過 Hugging Face Space 輸入基本遊戲概念或設計方向,查看 agents 如何自動遊玩及產生較高評分版本。GitHub 項目要求 Python >=3.11,並以每次提交執行的測試檢查憑證外洩和內部 import 解析;自行研究或部署時,仍要留意所需模型、遊戲引擎及執行環境未在提供資料中完整列明。

在 140 個 GameCraft-Bench 任務、兩個遊戲引擎及五個生成器的相同開發預算下,RSIGame 持續提升遊戲品質。經驗內化後,Qwen3.8-27B 在 Godot 取得 61.38、在 Phaser 取得 58.53,超過 GPT-5.5 一次生成的分數,同時把 Qwen 的生成 token 減少 11 倍;結果仍屬基準測試,不能直接等同於所有遊戲類型的穩定表現。

  • 由高層構想生成遊戲,再自行遊玩、診斷和修正
  • local loop 負責局部問題,global loop 負責品質與版本選擇
  • 支援 Godot 和 Phaser 等遊戲引擎評估
  • 透過訓練內化成功的開發經驗,減少後續生成成本

RSIGame 適合研究 agentic coding、遊戲生成及長流程自我改進的團隊,也適合作為檢驗 AI 是否能處理多輪程式修正的研究框架。它的代價是流程需要較多執行時間、模型及遊戲環境配合,評分提升亦受測試任務和開發預算影響。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, Qwen, 框架, Python, 編程

LEGO-Anything:由單張圖片生成可編輯 3D 世界

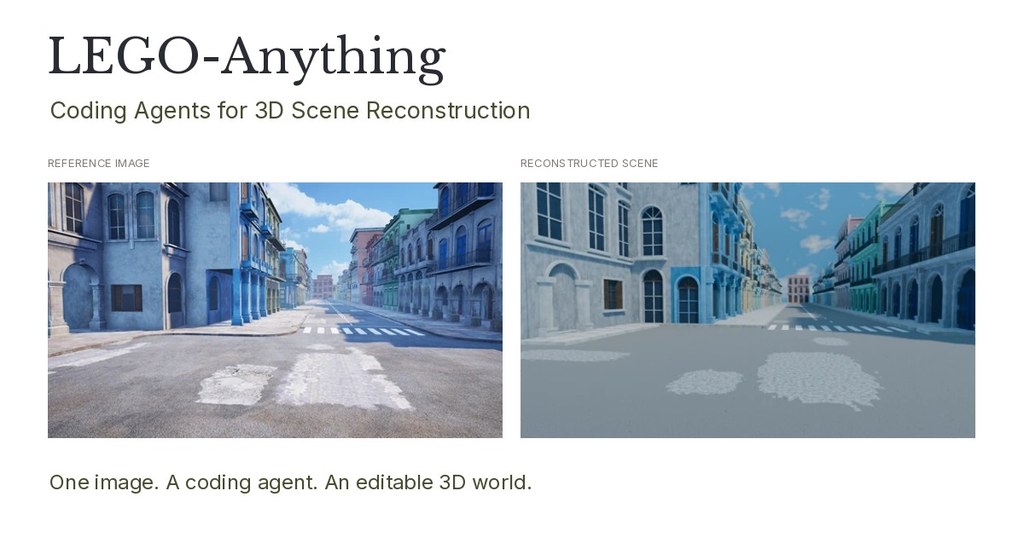
由一張圖片開始,coding agent 會逐步寫程式、渲染和修正,產出可查詢及編輯的 Blender 3D 場景。

Og image

由一張 RGB 圖片開始,coding agent 會自行規劃、執行 Blender 程式、渲染結果,再按視覺檢查持續修正,將參考畫面轉成可編輯、可查詢及可匯出的 3D 世界。LEGO-Anything 同時涵蓋 agentic scene reconstruction 的框架、評測基準 LEGO-Bench,以及協助分析建構過程的 LEGO-Plugin。

項目處理的核心問題,是如何讓模型不只生成一張相似圖片,而是建立具備幾何結構、鏡頭和物件狀態的可執行場景。Agent Workspace 管理產物,Action Space 提供操作,Blender Code Structure 保存可修改的場景狀態,Scene Construction Workflow 則把參考解讀、程式生成、渲染和驗證串連起來。

LEGO-Bench 收錄來自104個場景的208張圖片,涵蓋8個環境、17個主題及443項資產,並以 Indoor、Outdoor 和 Easy 至 Hard 的物件集合測試不同難度。評分同時考慮 Blender 場景是否有效、可見表面幾何重建,以及重新渲染後的色彩吻合度;無效提交或未能完成評估的案例會取得零分。

目前公開結果顯示,GPT-6-astra 在室內及戶外分別取得53.4%及39.6%的 Overall 分數,高於其他參與比較的 coding agents;戶外場景在各難度層級都較難處理,而場景有效率仍未代表幾何和視覺細節已經高度吻合。對需要可修改 Blender 資產、可重現場景或研究 Computer-use agents 3D 操作能力的工作流,這套框架提供了較完整的測試方式。

  • 由單張圖片生成可執行的 Blender 場景
  • 透過寫程式、渲染和驗證逐步修正結果
  • 同時評估場景有效性、幾何重建和外觀吻合度
  • LEGO-Bench 涵蓋室內、戶外及多級物件難度
  • 戶外場景和高視覺保真度仍是主要限制

項目主頁

Categories: 開源, Agentic, Image, 框架, Vibe Coding, 3D, 編程, Dataset 數據集

Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

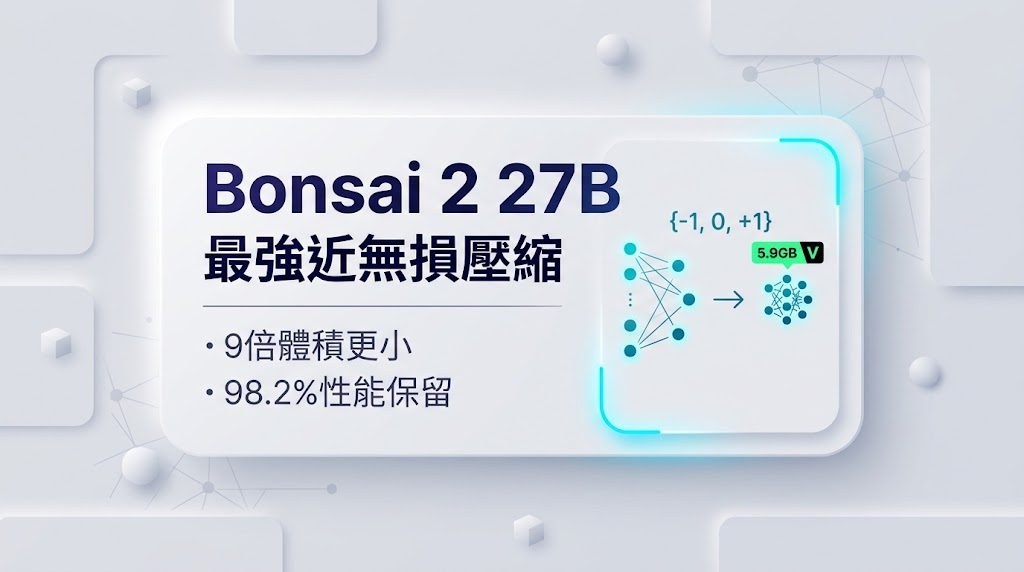
Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

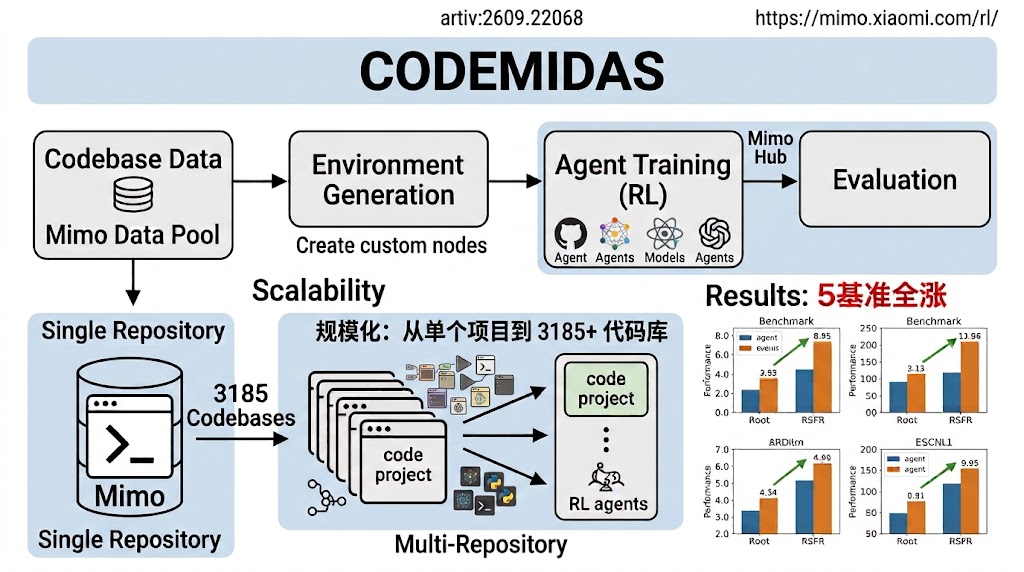
小米公開 CodeMidas 強化學習訓練進度

小米以即時指標公開 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練狀態,並連結至程式編碼代理研究。

CodeMidas 把模型訓練過程帶到公開視野,展示 mimo-v2.6-pro 與 mimo-v2.6-flash 兩組 reinforcement-learning runs 的即時指標。對需要追蹤模型能力如何形成的研究者和開發者而言,這類介面可用來觀察訓練是否持續、何時中斷,以及不同模型版本的進度差異。

小米以 trainer 直接提供的 metrics 為主,未有完整列出指標定義、數值解讀或最終評測結果。因此,讀者可以把它視為訓練監察入口,而不是已完成模型的性能報告;畫面亦提示可能出現重新連線狀態,資料連續性仍需留意。

根據 CodeMidas 研究,mimo 從程式碼本身擴展 agentic coding reinforcement learning environments。這個方向處理的問題,是如何建立足夠多、又能反映真實編程任務的訓練環境,讓 coding agents 在程式修改、執行與驗證等流程中學習,而不只依賴靜態範例。

資訊:
– 同時追蹤 mimo-v2.6-pro 與 mimo-v2.6-flash 的強化學習訓練
– 指標由 trainer 即時更新,適合觀察訓練進程
– CodeMidas 聚焦由程式碼擴展 agentic coding RL environments

對模型研究、AI agent 和編程工具開發者來說,頁面提供了一個觀察訓練公開化的窗口;一般使用者則應等待正式模型說明和獨立評測,才適合判斷其編碼能力及穩定性。

項目主頁 · 模型

Categories: 開源, 香港大學, 北京大學, Agentic, 模型訓練, 工具, Discord, 編程, 小米-Xiaomi

[技術文章] Coding harnesses 編程代理 : Context 管理、規劃與動作介面誰最影響表現?

同一個模型,搭配不同的 coding harness,表現可以差很遠。這份實證研究把 harness 拆成三個零件逐個測,告訴你哪個零件在邊種情況下真正有作用。

Hero image preview

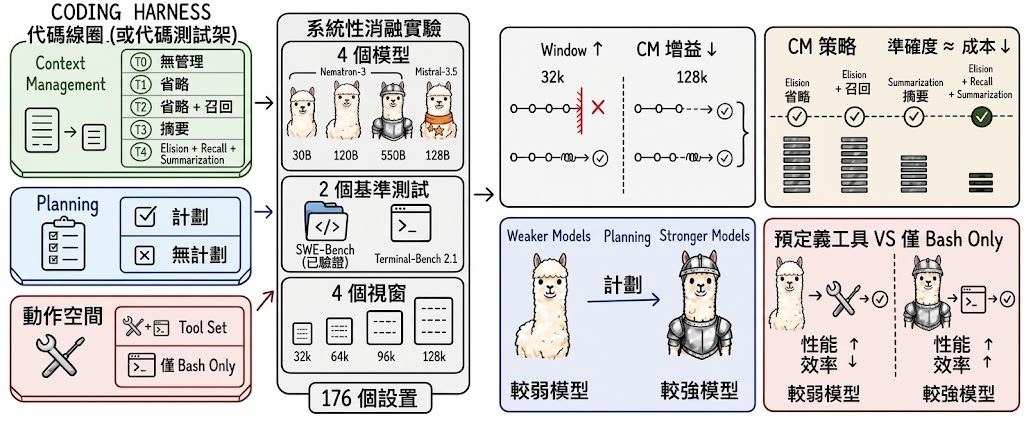
在 SWE-Bench Verified、Terminal-Bench 2.1 呢類基準上,坊間討論往往直接以「Claude 用某個 harness 表現最好」作結,例如 Cao et al. (2026) 比較後發現 Claude-Opus-4.5 配 OpenHands 最強,而 Claude-Sonnet-4.5 則在 SWE-Agent 上表現較佳。問題係,當我哋直接比較兩個完整嘅 harness,所觀察到嘅差異其實係 plan、action space、context management 三個零件同時變化嘅結果——換句話講,「邊個 harness 比較好」呢條問題,根本答唔到「邊個零件有用」。作者指出,以往研究多把 harness 視為單一系統去比,結果令個別零件嘅效用難以釐清。

為咗拆開睇,呢篇論文用咗一個輕量級 coding harness,固定執行迴圈,只改動三個零件:規劃、動作空間、上下文管理。團隊用四個模型喺 SWE-Bench Verified 同 Terminal-Bench 2.1 上測試咗 176 個配對設定,涵蓋五種上下文管理策略、四種上下文視窗預算,再加規劃同動作空間嘅針對性消融。

研究發現幾個有趣嘅條件性效果。第一,context 管理喺視窗預算愈緊嘅時候愈有價值,大部分效益其實嚟自避免 context-overflow 失敗,而非提升行為質素。第二,在眾多策略中,「先做規則式 elision、再做 LLM 摘要」呢種分階段做法整體效率最高;允許被刪內容可恢復嘅機制,模型幾乎唔會用到,亦無帶嚟準確度提升。第三,規劃嘅角色會隨模型能力變:對弱模型係準確度嘅支柱,對強模型就變成慳成本嘅工具,準確度變化唔大。第四,預定義工具對 bash 能力弱嘅模型有幫助,但 bash 能力強嘅模型只需要 bash 介面就夠,而且喺命令行主導嘅任務上成本低好多。

軌跡分析進一步解釋:context 管理延長執行軌跡但唔大幅改變行為,規劃改變軌跡停止嘅位置,動作空間就改變程式碼被寫出嚟嘅粒度。換句話講,三個零件影響嘅其實係代理行為嘅唔同面向。對從事編程代理相關工作嘅人,呢套模組化框架提供咗一個可以繼續累積、比較新零件嘅方法,亦提示設計時要按模型能力同預算做取捨,而非盲目堆砌功能。

重點摘要:

  • harness 唔應該當成單一系統去比,拆開 plan、action space、context management 三個零件先睇得清
  • context 管理喺視窗愈緊愈有用,核心係防 overflow,而非提升行為質素
  • 規則式 elision 配合 LLM 摘要嘅分階段策略,效率表現最好
  • 規劃對弱模型係必需、對強模型只係慳錢
  • bash 能力夠強嘅模型用純 bash 介面,喺 CLI 任務上可以大幅降低成本

Paper

Categories: Agentic, 框架, 軟件, 工具, 編程

ProgramDistill:把網頁 App 反推成 SWE 基準任務

ProgramDistill 把互動的網頁行為變成修復題目,讓 AI 編程代理靠一部會動嘅「參考 App」重新砌返功能,再自動驗收。

Microsoft Research

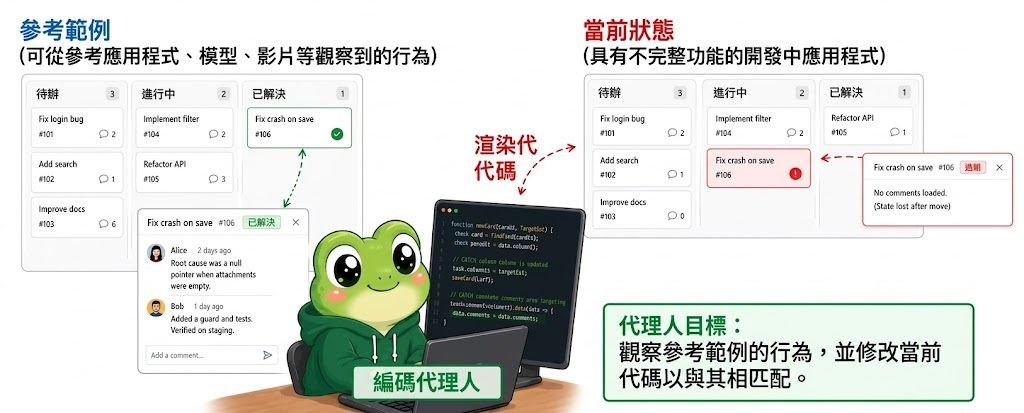
好多時開發並非由一份寫得好清楚嘅規格開始,而係先見到一個行得通嘅版本,再去諗點補返。ProgramDistill 模擬嘅正係呢種工作流:代理可以同一部「參考 App」互動,但睇唔到佢嘅源碼,只能改另一份缺咗功能嘅應用程式,再睇最後行起上嚟嘅行為同原裝嘅一唔一樣。換言之,重點唔係抄程式碼,而係要還原出來嘅效果同參考版本吻合。

要規模化做呢件事,每條任務都要有「可以重播嘅行為」加「可靠嘅驗證」。ProgramDistill 用一條叫 mine-craft-patch 嘅自動管線,靠多個 LLM 代理合作,由行得通嘅應用同源碼出發,自動搵出可記錄嘅行為、存成可重播嘅 trace,再刪走負責該行為嘅源碼,整出一份「修復題」。每條 trace 本身就係一個可執行嘅驗收器,因為佢記低咗瀏覽器動作、成功訊號同前置依賴,自動重播就識得計分。

呢套方法喺 26 個應用上面搵到 1,975 個經重播驗證嘅行為,再組成 4,063 條任務。題目難度可以由「要還原幾深層嘅依賴」控制到,即係話可以設計到「只係補一個細行為」,亦可以迫代理一次過補返連鎖反應。

重點摘要:

  • 用可重播行為做驗收:trace 同時係題目亦係計分機制,省咗另寫驗收邏輯。
  • 唔睇源碼、只睇效果:代理要靠互動參考 App 嚟推測行為。
  • 難度可調:還原深度愈深,要一齊修好嘅行為就愈多。
  • 規模化合成:26 個應用就整到四千幾條 SWE 任務。
  • 評估目標係還原效果,唔係程式碼樣相似唔相似。

對做編程代理嘅團隊,或者想練 SWE-bench 類型基準嘅人嚟講,呢套管線提供咗一個起點:由真實 Web App 自動生出一批可驗證、難度可控嘅任務,省卻人手逐條寫題目嘅工序。

項目主頁

Categories: 開源, Agentic, 微軟, 軟件, 編程, Dataset 數據集

Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。

GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, 庫, 編程, Anthropic, Skill 技能

Page 3 of 14
1 2 3 4 5 … 14