moe_vie 視覺編碼器:CLIP 規模 MoE 化,最細版本也貼近 SOTA

Meta 團隊把 Mixture-of-Experts 帶進 CLIP 風格視覺編碼器,用細粒度專家路由配合自訂 Triton kernel,在零樣本分類與檢索上貼近體型大 1.7 倍的 SOTA 編碼器。

Repository image for facebookresearch/moe_vie

視覺編碼器愈變愈大,準確度換來的是推論成本與延遲同時膨脹,特別是高解析度圖片與長影片情境。MoE-ViE 想打破這個取捨:把 Mixture-of-Experts(MoE)機制引入 CLIP 風格的對比預訓練流程,讓模型總容量擴大,但每張圖、每段片只啟用一部分專家,把容量與實際計算脫勾。

與一般 MoE 不同,MoE-ViE 採用細粒度專家拓樸(fine-grained MoE topology),並提出一個無輔助損失(auxiliary-loss-free)的變體來平衡專家負載,避免傳統 MoE 常見的負載不均問題。同時,作者針對 MoE 額外開銷撰寫了專門的 Triton kernel,把推論延遲拉回接近密集模型的水準。

項目以 Vision Transformer 骨幹搭配上述 MoE 設計,配合穩健的對比預訓練流程(contrastive pretraining recipe),一口氣釋出 B / L / H 三個尺寸的模型,覆蓋 224 / 384 / 448px 解析度。在 ImageNet-1k、ObjectNet、COCO 文字檢索圖片、Kinetics-400、MSR-VTT 文字檢索影片等基準上,零樣本表現與各項強 CLIP baseline 相當甚至更佳,其中 H/14 版本在保持約 76% 延遲的情況下,貼近體型大 1.7 倍的 SOTA 編碼器。當對接 LLM 組成視覺語言模型時,MoE-ViE 在圖像與影片基準上亦勝過多個啟用參數多達 5 倍的編碼器。

另一個針對影片能力的處理方式是 frame-level distillation 加上一個新設計的凍結機制,目的是在引入影片理解的同時保留原本學到的圖像知識。這個步驟令同一組視覺編碼器可以同時服務圖像與影片任務,而不必訓練兩套模型。

重點摘要:

  • MoE 化的 CLIP 風格視覺編碼器:以 Mixture-of-Experts Vision Transformer 配合對比預訓練,支援 B / L / H 三種規模。
  • 細粒度專家拓樸 + 無輔助損失平衡:避免傳統 MoE 的專家負載不均,並以自訂 Triton kernel 控制推論延遲。
  • 圖像與影片兼顧:frame-level distillation 配合新凍結機制,讓單一編碼器同時處理圖像與影片理解。
  • 對接 LLM 後仍具競爭力:在多項圖像與影片基準上,表現勝過啟用參數多達 5 倍的既有編碼器。
  • 官方釋出代碼與零樣本評測套件:提供模型定義、配置檔與可重現的零樣本評估流程,惟授權為 CC BY-NC 4.0,需留意非商用限制。

本項目由 Meta 團隊發佈。需要留意的是授權為 CC BY-NC 4.0,僅限非商用場景使用;訓練細節、資料組成與對齊 LLM 的實作屬研究配置,重現成本不低,較適合作研究基準而非即取即用的產品元件。

GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Meta

V-RAE 重整影片潛空間,生成更快更準

V-RAE把影片生成前最難處理的時間冗餘壓細,同時保住語意結構。對想做重建、生成同預測建模的團隊,呢個方向幾有參考價值。

V-RAE method

做影片生成時,潛空間一旦又大又雜,訓練速度、重建品質同後續生成都會一齊受拖累。V-RAE放喺呢個位置切入:它屬於影片表示自編碼器模型,將 frozen vision foundation model 的表徵再壓成更緊湊的 generative latents,處理的是影片表示太冗長、但又不能失去語意同動態連續性的問題。

V-RAE不是重新訓練整個視覺骨幹,而是接在 DINOv3、SigLIP2、V-JEPA2.1、EUPE 這類 frozen encoder 之上,用 lightweight temporal pooling module 減少時間維度上的重複資訊,再交由 video decoder 重建連續動作。這種做法的取捨在於,它更依賴現成視覺表徵的品質,但換來較輕量的影片 latent 壓縮流程,亦令 semantic latents 可以變成 directly decodable predictive state space。

V-RAE:重构视频潜在空间以实现高效生成 2026-08-16

項目提供了訓練、評估與重建示例所需的程式結構,安裝條件寫明要用 Linux、NVIDIA GPUs、CUDA 相容驅動、FFmpeg,以及 Python 3.10 或以上。可配合已釋出的 checkpoints 與對應 frozen encoder 做重建測試,但能否自由下載、下載範圍是否完整,仍要以當前發佈頁面為準,不適宜直接假設任何人都可無限制取得全部模型。

結果 V-RAE在 K600 reconstruction 取得 2.13 rFVD,數值優於文中比較的大型 pretrained video VAEs;class-conditional generation 則在 UCF101 與 K600 分別達到 117.86 與 19.16 gFVD,並提到可快最多 6 倍收斂。作者亦提出 tFVD,令它與人類判斷的一致性提升,在 UCF101 與 K600 的 Pearson correlation 分別達到 r = 0.621 與 r = 0.919,這點對影片生成評測有直接意義。

  • 接在 frozen vision foundation model 後面做壓縮,避免由零建立整套影片表徵
  • 用 temporal pooling 減少時間冗餘,同時保住 semantic structure
  • 同時覆蓋 reconstruction、class-conditional generation 與 predictive modeling 場景
  • 倉庫已包含 training、evaluation、sampling 所需結構,但部署前提偏向研究級 Linux + NVIDIA GPU 環境
  • 適合研究影片生成、世界狀態建模、長序列表示學習的團隊參考其 latent 設計

V-RAE較適合有影片模型實驗能力的研究團隊、做 VideoDiT 類生成流程的人,以及想把影片 latent 拿去做預測狀態空間建模的項目。對於怎樣把強大的視覺表徵轉成更可生成、可重建、可評測的影片 latent,已經給出一條相當具體的路線。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Linux, Python

needle:14MB 本地工具模型,專攻結構化操作

Needle 2 把工具呼叫、裝置操作和結構化抽取收進單一 14MB 引擎,本地跑完整對話只需約 28MB RAM。它適合要低記憶體、離線部署又要輸出 JSON 的工作流。

Needle

Needle 2 屬於用於 tool calling 的小型模型,同時處理 device use 和 structured extraction。它把輸入文字轉成可直接接入工作流的結構化結果,適合在本地裝置、隔離網絡環境或資源很緊的情況下部署。

這個 Python package 提供 inference、LoRA fine-tuning 和 export,安裝後會先從 Hugging Face 下載一次 engine,再在本機快取,之後不再依賴網絡。開發者只要描述工具,模型就會按 schema 產生 JSON,並用 byte-level grammar 收窄輸出範圍,減少格式跑偏。

This 14MB AI Model Runs Locally — Needle 2 Explained

它和同類小模型的取捨很明確:45M 參數、單一 14MB binary,換來的是極低記憶體佔用和離線運行能力;官方測試也顯示,它會和 FunctionGemma 270M、LFM2.5 230M 及 Apple FM 互有勝負,但體積小得多。另一個做法是加入 confidence score,低於門檻就可以交回人工或上層流程處理。

  • 單一引擎打包,部署時不用分開管理權重檔
  • 以 JSON 與 schema 約束輸出,方便串接工具鏈
  • 支援大量工具目錄,但每輪只取 top five
  • 256-token sliding window 令記憶體維持在約 28MB
  • 適合離線裝置、邊緣設備和需要穩定結構輸出的團隊

GitHub · 模型

Categories: 開源, 模型, 模型訓練, Python, 庫, 蘋果

Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

Agent Lightning v1.0:把代理訓練接回真實工具流

Agent Lightning v1.0 讓代理在保留工具、上下文和環境的情況下直接訓練。它也把 Kubernetes、程式編寫和獎勵防作弊流程一併整合起來。

logo

Agent Lightning v1.0 針對一個常見卡位:代理訓練往往要靠額外沙箱或改寫流程,令工具、控制流和環境脫節。這個項目把訓練直接接回真實 agent harness,代理可以經由 Agent Lightning v1.0 proxy 運作,而不用改動原本架構。

它的設計取向相當清晰,核心程式碼大約 3,500 行,重寫後把複雜度壓低。代理亦可直接作為 Kubernetes Jobs 執行,不必依賴外部 sandbox 服務,對要跑長時間 rollout 或分散式訓練的團隊會方便很多。

文檔同時提供完整的 coding-agent 訓練流程,涵蓋資料清理、reward-hacking 防護和訓練腳本。這代表它不只停留在概念層面,而是把一條可落地的訓練管線交到使用者手上。

  • 保留工具、上下文、控制流和環境在訓練迴圈內
  • 透過 proxy 接入現有 agents,減少改動成本
  • 原生支援 Kubernetes Jobs,部署更直接
  • 提供 coding agent 範例,連資料清理和防作弊流程都包進去
  • 適合做具互動工具、程式執行或多步推理的 agent 訓練

項目主頁

Categories: 開源, Agentic, 模型訓練, 微軟, DeepSeek, API, Vibe Coding, Python, 編程

GRNEdit 用少量參數做通用影片編輯

想改影片風格、背景或局部內容,又唔想整段重生成,GRNEdit 提出一條較慳參數的路線。它把可編輯範圍先用 binary evidence 拆清,再逐步細修畫面。

Xidian University

一段影片要改風格、換背景、刪走局部人物,最難通常唔係生成新畫面,而係改得準之餘,原本動作、主體身份同未編輯部分都要保持穩定。GRNEdit 屬於影片編輯框架,處理的正是這類通用影片編輯問題,而且走的是 Generative Refinement Networks 配合 binary evidence 的路線,不是靠大幅加參數去硬推效果。

GRNEdit 先用 binary evidence 分開哪些區域應該被改、哪些內容要盡量維持,之後再沿住 refinement 過程逐步生成目標語意、結構同細節。這樣做的取捨,在於它把編輯能力壓縮到相當輕量的增量上;公開資訊表示,相對 GRN backbone 只增加少於 3% 額外參數,但聲稱可跟領先的影片編輯模型競爭。

從示例看,GRNEdit覆蓋 global style、背景替換、local removal、加入新元素,以及移除字幕等多種任務,重點不是單一特效,而是同一套框架處理不同編輯指令。較適合研究影片生成、內容製作流程,或者想把多種編輯模式收斂到同一模型系統的團隊參考;不過目前公開內容仍以推理程式碼和預印本為主,training code 與 model weights 都未提供,部署與重現門檻仍然存在。

  • 以 binary evidence 先界定可編輯範圍,再逐步 refinement
  • 相對 GRN backbone,只需少於 3% 額外參數
  • 同一框架支援風格化、換背景、移除、添加與複合編輯
  • 公開資料主打推理與結果展示,完整訓練與權重尚未釋出

模型權重暫未開放,但有足夠資訊足夠理解它的方法定位。對關注影片編輯模型的人來說,GRNEdit最有意思的地方,是它把「改動範圍判定」放到生成前段處理,嘗試用更小的參數成本換取更穩定的時序保留與更通用的編輯能力。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練

[技術文章] pixel-space 模型可以追平甚至超過 latent-space 對應模型

研究聚焦 pixel-space text-to-image diffusion models 的訓練卡位,找出點樣喺大規模條件下兼顧畫質同速度。作者用 latent-to-pixel 策略,令 pixel-space 模型更接近甚至超過 latent-space 表現。

Hero image preview

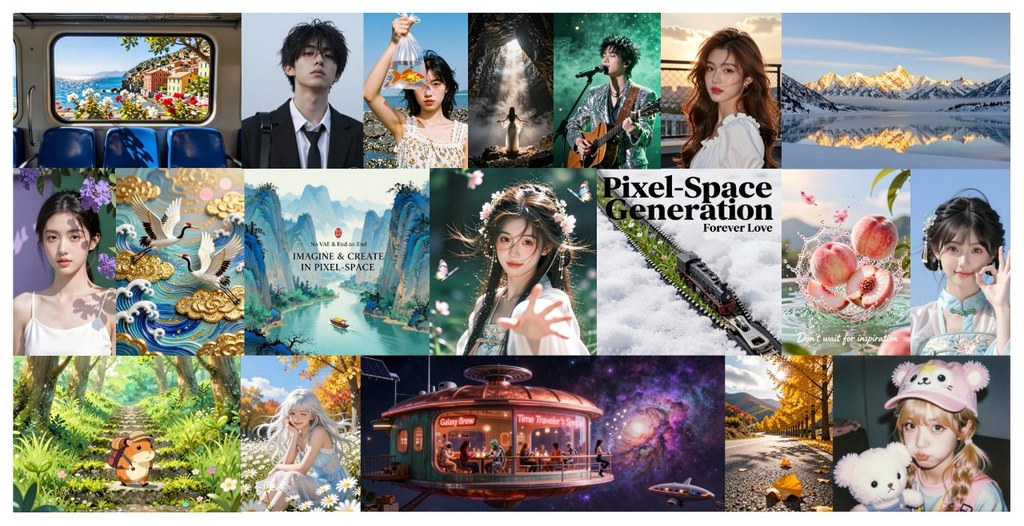
上圖是透過 pixel-space text-to-image diffusion models 的方法訓練的 Z-Image-Turbo (Pixel) 產生的圖像。在企業級 H800 GPU 上,推理延遲僅約 0.2 秒。

Pixel-space text-to-image diffusion models 一直有兩個吸引位:直接生成像素,唔受 VAE 壓縮上限限制,亦可以省去解碼步驟。但喺大規模訓練下,佢哋收斂速度明顯慢過 latent-space 模型,令「畫質、效率、可訓練性」三者之間嘅平衡一直唔夠成熟。

呢篇工作針對嘅正係呢個落差。作者先比較 pixel-space 同 latent-space 喺大規模 pre-training 下嘅行為,再提出 latent-to-pixel 策略:先喺 latent space 學到生成先驗,再轉去 pixel space 做 post-training,避免一開始就喺難度更高嘅像素空間硬推。

佢哋亦系統研究咗多個轉換設計,包括 weight initialization、data composition、prediction target、decoder architecture 同 noise schedule,整理出一套可行做法。結果顯示,做法調整得當之後,pixel-space 模型可以追平甚至超過 latent-space 對應模型,推理端仲有 3.18 到 4.75 倍嘅速度提升。

  • 直接處理 pixel-space diffusion models 喺大規模訓練時收斂慢嘅問題
  • 用 latent-to-pixel 路線,先學先驗,再轉入像素空間微調
  • 檢視多個關鍵訓練選項,搵出實用 recipe
  • 在畫質不退讓之下,換取更快的 end-to-end inference
  • 對想做高效文生圖系統、又在意生成細節保留嘅團隊最有參考價值

Paper

Categories: 香港科技大學, 南京大學, 阿里巴巴, 模型, 模型訓練, Image, txt2img, 香港

ClawGym:為 Claw 類代理搭建可訓練環境

ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

NaviDC-OCR:1.2B 參數文檔 VLM,統一處理相機與數碼文件

NaviDC-OCR 把文件理解收斂到一個輕量 Vision-Language Model(VLM)流程,對掃描件和手機拍攝文件都能一起處理。它的重點不只在識別文字,還在版面、表格與公式之間的結構還原。

icon

NaviDC-OCR 是一個輕量級 Vision-Language Model(VLM),專門處理 document understanding,也就是把文件內容、版面和結構一併讀出來。它最實際的價值,在於同時應付 digital documents 和 camera-captured documents,尤其適合文件拍攝角度不正、透視變形或版面較複雜的情境。

這個項目已釋出模型權重與 technical report,使用方式偏向直接載入 Hugging Face 上的模型做推理或再訓練,而不是一套獨立應用程式。它的訓練流程結合 Multi-node Consensus Voting(MCV)、Image-to-Image Self-Verification,以及 progressive four-stage training,顯示作者把大量標註成本轉移到自動化資料整理與驗證。

  • 1.2B 參數,定位是輕量部署而非堆大模型。
  • 同時面向掃描文件與相機拍攝文件,覆蓋範圍比只做單一路徑的做法更廣。
  • Geometry-aware Document Modeling 與 Curvature-Guided Douglas-Peucker Sampling(CGDP)主要針對彎曲、傾斜和變形頁面。
  • Content-Structure Decoupled Learning 令表格與公式的內容和結構分開學,較適合複雜文件。
  • 作者聲稱在多個 benchmark 上有強表現,但具體部署成本仍要視推理框架與硬件而定。

和不少只偏重 OCR 文字抽取的做法相比,NaviDC-OCR 更像是把「看懂文件」放在第一位:它不只要讀字,還要保留版面關係與幾何資訊。這會令它在企業文件處理、票據整理、表格抽取、學術文件解析,或者手機拍照掃描的工作流裡更有用,但它仍然是研究型模型,落地時要留意速度、記憶體與實際文件分佈是否接近訓練資料。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, Dataset 數據集

HRM-Text 把基礎模型預訓練門檻壓到千美元級

想自己預訓練文字模型,通常先被算力同數據成本勸退。HRM-Text嘗試把呢道門檻大幅壓低,連完整訓練流程都一併開放。

banner

最值得留意的地方,不是又多一個 1B 級文字模型,而是有人把「由零開始預訓練 foundation model」整理成一個可落地的開源項目。HRM-Text 屬於模型加訓練框架類型,處理的是中小團隊想自建文字生成模型時,算力、數據量同工程門檻都過高的問題。

它採用 Hierarchical Recurrent Model(HRM)架構,並加入 task completion 同 latent space reasoning,重點不是單純追更大參數,而是用 hierarchical recurrent architecture、PrefixLM sequence packing、FlashAttention 3 同 PyTorch FSDP2,把預訓練成本壓到傳統做法的 130 至 600 倍更低算力需求,以及 150 至 900 倍更低數據需求。呢個取捨很鮮明:換來的不是萬能部署環境,而是一條偏向研究與訓練端、對 Hopper-class GPU 仍有明確要求的路線。

部署同測試方式亦算完整。儲存庫已包含 training、checkpointing、evaluation,同 checkpoint 轉成 Hugging Face Transformers 格式的工具,配合 companion 的 data_io 管線準備 tokenized data 後,就可以按單節點或多節點方式開跑;不過 native Transformers 支援要等下一個 release,native vLLM 支援亦仍在進行中,所以現時較適合想重現訓練流程、驗證成本結構,或者研究 HRM 架構本身的團隊。

參考跑分不算保守:0.6B 版本用 8 張 H100、約 50 小時,GSM8k 有 77.6%,MATH 51.2%;1B 版本用 16 張 H100、約 46 小時,GSM8k 提升到 84.7%,MMLU 60.7%,ARC-C 81.9%。呢啲數字未必代表它已經適合所有產品化場景,但足以證明這條路不是紙上談兵,尤其對大學實驗室、國家語言模型計劃,或者想為小語種、自有語料建立 base model 的團隊,有相當現實的吸引力。

  • 把 foundation model 預訓練成本壓到約千美元級,重點在完整流程而不只是一個模型權重
  • 同時提供訓練、評估、checkpoint 轉換工具,方便重現與延伸研究
  • 目前較依賴 H100 等 Hopper-class GPU,部署彈性未算完全成熟
  • 適合研究機構、語言科技團隊,同要自建基礎模型能力的項目
  • 原生 Transformers 與 vLLM 支援仍在補齊,短期內較偏訓練端使用

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Python, Dataset 數據集

Page 22 of 38
1 … 20 21 22 23 24 … 38