WorldTrace 令影片世界模型記住更遠場景

影片世界要模型生成得夠長,往往先開始失憶。WorldTrace 針對呢個斷層,想保住長時段生成同遠距場景回想能力。

Og image

做長時間影片生成時,Video World Models 最易出現的問題唔係畫面唔夠靚,而是走出訓練長度之後開始「唔認得之前見過乜」。WorldTrace 針對的正是呢種視覺記憶失效:它屬於 Video World Models 的記憶機制改良方法,重點是令 Key-Value (KV) cache 裡已壓縮的內容,過了原本訓練範圍之後仍然可以被模型重新定位和讀取。

核心思路不是再訓練一個新生成器,而是用 training-free 方式處理記憶可尋址性。研究指出,問題關鍵在 temporal Rotary Positional Embeddings (RoPE) 偏移超出訓練 horizon 後,注意力機制即使保留了舊畫面資訊,都未必再讀得到;再加上在 RoPE 旋轉空間直接平均 key,會令不同 phase 互相抵消,令記憶內容變得模糊。WorldTrace 透過固定、仍屬 in-distribution 的 slot 位置保存壓縮記憶,避免記憶「存在但搵唔返」。

同一套記憶框架下,它分成兩個方向:WorldTrace-Field 用 rotation-invariant 的歷史聚合方式,支援較連貫的長 rollout;WorldTrace-Landmark 則保留較接近原樣的 scene traces,讓模型隔了更長時間後,仍有機會回想曾經到過的場景。這種分工反映出一個很實際的取捨:有些情境重視連續生成的穩定性,有些則更需要精準回憶特定地點或視覺片段。

  • 針對訓練 horizon 以外的記憶失效,而不是單純提升畫質
  • 保持壓縮後的 KV memory 可尋址,重點在 fixed in-distribution slot positions
  • WorldTrace-Field 偏重長序列生成的一致性
  • WorldTrace-Landmark 偏重遠距離場景召回與保留視覺痕跡
  • 原始資料將它描述為 training-free,未見提供安裝、下載或部署流程

這類方法較適合需要長時間互動、持續追蹤場景變化,或者要求模型記得自己曾經去過哪裡的工作流,例如互動式模擬、可探索影片環境與長時段世界狀態建模。現有資料亦提到它獲 ICML 2026 F2S Workshop Best Paper,但公開內容目前集中在方法動機與設計,效能細節在這份摘要材料中仍然有限,閱讀時應留意完整論文是否提供更完整的量化結果與測試設定。

項目主頁 · 項目

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, 框架, Dataset 數據集

LISA:讓 MEG 語音解碼由準確走向可解釋

LISA 把腦磁訊號配對到語音嵌入,並保留空間、時間與聲音特徵線索。

LISA architecture and analysis pipeline

將一段 3 秒、208 通道的腦磁圖(magnetoencephalography,MEG)訊號配對到聽到的語音,同時追查證據來自哪個腦部位置與時間段,正是 LISA 要處理的問題。它屬於可解釋神經解碼模型,透過對比式檢索目標,把 MEG 片段映射至對應音訊的 Wav2Vec2 表徵。

LISA 的價值不只在於找出正確語音片段,而是把空間濾波器、時間濾波器和分支結構直接保留下來,方便轉換成感測器空間或皮質來源的分析結果。它採用幾何感知的空間注意力,配合 25 個可解釋分支,每個分支使用 150 ms 時間核心,再接兩個時間卷積區塊。

在 MEG-MASC 實驗中,模型於 1,005 個候選語音片段取得 39.75 ± 0.34% Top-1 準確率及 70.4% Top-10 準確率;完整解碼器有 486,619 個可訓練參數,約為 Défossez et al. 方法的二十分之一。配對 MEG 遮蔽分析亦發現,19 項測試聲音特徵中有 15 項對檢索有貢獻,惟這些結果仍屬特定資料集與實驗設定,不能直接推廣至所有腦訊號任務。

  • 可抽取空間及時間濾波器,支援後續神經科學分析
  • 內置 preprocessing、training、evaluation 與 analysis 程式
  • Python 3.11 的 LISA 環境可用於 synthetic demo 或新資料集
  • CPU 可以執行,訓練階段使用 CUDA-capable GPU 會較合適
  • 重現 MEG-MASC 清理流程,儲存空間峰值約需 300 GB

研究人員可先用 synthetic demo 熟習張量流程,再按文件改接其他 EEG(electroencephalography,EEG)或 MEG 資料。相較只追求檢索準確率的深度解碼器,LISA 以較小模型換取可追溯性;需要完整重現結果的人,仍要準備資料集、環境及較大的儲存空間。

項目主頁 · GitHub

Categories: 開源, 模型訓練, 框架, Medical醫學, 語音

Ego2Robot 把人類影片轉成機械人訓練數據

Ego2Robot將第一身人類操作影片轉化成大規模機械人訓練數據,改善 VLA 模型面對陌生環境時的泛化能力。

Ego2Robot pipeline overview

機械人要應付陌生場景,往往需要大量而且多樣化的示範數據;Ego2Robot選擇從第一身人類操作影片取材,將人手動作轉換成不同機械人形態可以使用的訓練資料。這個數據合成項目面向 Vision-Language-Action(VLA)模型預訓練,處理人類影片與機械人動作、視覺外觀不一致的問題。

流程分為動作對齊、視覺對齊和品質篩選三部分。系統會把拇指、食指、中指指尖及手腕等關鍵點重新映射到夾爪的 TCP、開合幅度和方向,再以 Savitzky–Golay 及 SLERP 平滑動作;視覺處理則結合 SAM 3、ProPainter、機械人底座姿態搜尋和 IK solving,把機械人手臂合成到已修補的人類場景中。

項目支援已有手部姿態標註的數據集,也可以從原始影片估算姿態,後者使用 WiLoR 逐幀重建和 DynHaMR 時序最佳化。統一流程可以平行產生 15 種 robot morphologies,累積 18,561 小時訓練數據,涵蓋較多任務、場景和機械人配置。

重點包括:
– 同時支援 curated datasets 和 in-the-wild videos
– 以多層 quality curation 篩走動作及視覺合成中的低質資料
– RoboTwin 2.0 加入視覺外觀、場景佈局、機械人形態和任務語義等干擾軸
– 與機械人數據聯合預訓練後,多種 out-of-distribution 情況下的泛化能力提升
– 改善效果亦在真實機械人部署中獲得驗證

對需要建立通用機械人操作模型的研究團隊,Ego2Robot提供了一條減少真人示範收集成本的路線。不過,合成數據的品質仍取決於手部姿態估算、動作重定向、逆運動學和場景合成是否準確,因此它較適合作為真實機械人數據的補充,而不是完全取代實體部署資料。

項目主頁

Categories: 阿里巴巴, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, 中國, Dataset 數據集

Meta 提出多模態預訓練的關鍵:視覺要及早融入

模型學習文字、看圖與生成圖像,未必會自然互相增益。這組研究拆解知識如何流動,並提出更有效的多模態預訓練配方。

Og image

對需要同時理解文字與影像、甚至生成影像的模型來說,最難處理的不只是資料量,而是不同能力會否互相拖累。這項由 Meta FAIR、Reality Labs 與 University of Oxford 團隊進行的研究,以統一多模態預訓練為焦點,探討語言、視覺理解和視覺生成怎樣共同學習。

研究發現,跨模態知識流動並不對等。語言資料可普遍提升各類視覺任務;視覺理解會為影像生成提供強而有力的先驗知識;視覺生成對其他能力的直接幫助則較有限,主要透過加快低階概念學習,間接改善理解能力。團隊亦以 CLEVR 合成資料集配合真實世界資料,分辨不同概念之間的轉移方式。

  • 語言可增強視覺理解與視覺生成能力
  • 任務愈複雜,模態之間愈可能出現競爭
  • 參數共享方式會改變不同模態能否產生協同效果
  • 視覺路徑應由預訓練初期同步學習
  • 延後加入視覺訓練,可能造成「vision laziness」

「vision laziness」指模型過度依賴語言捷徑,未有充分學習影像訊號。研究比較早期統一訓練、後期整合及順序式訓練後認為,視覺與語言由一開始共同演化,表現會較穩定;將視覺資料延後加入,即使模型其後接觸影像,也未必能補回早期錯失的表徵學習。

團隊把受控實驗得出的資料混合比例與擴展策略,套用至以 2T tokens 訓練的 13.5B Mixture-of-Experts(MoE)模型驗證。對設計多模態基礎模型的人而言,研究提供的價值不在單一架構,而是指出資料配比、任務難度、共享設計與整合時機,均會直接影響模型是否真正學會運用視覺。

項目主頁 · Paper

Categories: 多模態模型, 模型訓練, Meta

HelloWorld:按一下 F,讓影片世界角色回望你

HelloWorld 讓影片世界模型中的角色回應鏡頭,並以時間控制維持場景與鏡頭運動的連貫性。

Teaser

按一下 F,畫面角色可以轉身望向鏡頭、揮手、點頭或作簡短問候,同時維持場景細節和鏡頭軌跡。HelloWorld 屬於 video world model,處理的是虛擬角色如何對使用者作出具時間位置的社交回應,而不只是生成一段靜態互動片段。

它以 self-distillation training 微調基礎影片生成模型,使用模型自行合成、同時包含社交互動和 camera motion 的資料,讓模型學會 camera-pose conditioning,並減少互動品質下降的取捨。推理階段加入 training-free temporal control,透過 temporal cross-attention mask 將角色回應限制在 F 按鍵觸發的時間窗口內。

目前 Code & Benchmark 標示為 Coming soon,因此讀者暫時較適合先觀看 Demo Video 和論文,了解互動效果及方法;現有資料未提供安裝流程、硬件要求或可直接部署的版本。這亦意味著它更接近研究原型,尚未能按一般開源工具的方式即時整合到自己的工作流。

HelloWorldBench 包含 400 個樣本,除了三項傳統指標,亦加入 ActAcc、TimeAcc 和 GazeDev,分別聚焦動作準確度、時間準確度及視線偏差。較適合研究影片世界模型、遊戲角色互動或虛擬場景控制的團隊;對需要現成產品方案的人,程式碼尚未公開仍是主要限制。

  • 單一 F 按鍵觸發角色面向鏡頭回應
  • self-distillation 同時保留互動品質和鏡頭運動
  • temporal cross-attention mask 不需重新訓練即可控制回應時段
  • HelloWorldBench 以 400 個樣本量度社交互動
  • 程式碼與基準測試仍未提供,部署可行性有待確認

GitHub · Paper

Categories: 開源, 世界模型, 模型訓練, Video, Dataset 數據集

Vision-DeepResearch:由靜態圖片走向連續影片的 DeepResearch Agent

Video-DeepResearch 將視覺搜尋延伸至連續影片,要求模型先理解跨畫面的證據,再進行網絡探索。

icon

面對需要翻查影片內容、再結合網絡資料回答的問題,單靠文字搜尋往往會漏掉關鍵畫面。Video-DeepResearch 是一個多模態研究型 Agent 項目,透過 Video-DeepResearch(Video-DR)處理連續影片中的時空資訊,並把視覺理解與網絡探索分開安排。

它修正了兩個常見卡位:模型偏向使用文字工具,較少主動檢視影片;模型亦可能直接依賴內部記憶,未有真正完成工具輔助搜尋。Pipeline 先逐階段解鎖視覺工具,要求模型完成跨畫面 grounding,再進入網絡檢索,取捨是流程較嚴謹,但推理成本和執行時間亦可能增加。

訓練流程先以 Supervised Fine-Tuning(SFT)建立基本能力,再使用 Group Relative Policy Optimization(GRPO)強化自主探索。項目同時提供 30 K 個 video-grounded QA pairs、7 K 條整理後的 trajectories,以及程式碼、資料集和模型權重,研究團隊可按需要測試基準、重現訓練或直接載入模型。

  • Video-DR-35B-A3B 在 Video-DR 達到 68.0% accuracy
  • 比 Claude-4.5-Sonnet 的 63.0% 高 5.0 個百分點
  • GPT-5 和 Gemini 2.5 Pro 分別為 57.0% 和 62.0%
  • Vision-DeepResearch-30B-A3B 延續同一研究方向,另有 SFT-only 的 8B 版本

現有結果反映它在影片證據與網絡資料需要互相驗證的工作較有價值,例如研究、媒體核查和長片段問答;但 68.0% 仍代表部分問題會出錯,較適合作為研究平台和可檢驗的 Agent 架構,而不是無需監督的影片分析服務。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港理工大學, Agentic, 多模態模型, 模型訓練, Qwen, OpenAI, Gemini, Video, 香港, Anthropic, Dataset 數據集

awesome-agentic-world-model:由 World Model 走向可互動的 Agent-Centric World Proxy

這份開源索引把世界建模重新連接到代理人的規劃、學習與驗證流程,亦清楚標出目前仍未解決的取捨。

Repository image for worldbench/awesome-agentic-world-model

需要持續試錯的 AI agent,未必每次都要真的操作環境;有時預測未來狀態、渲染視角、模擬執行結果,甚至取回技能或驗證計劃,已足以支援下一步決策。這個項目屬於開源研究索引與分類框架,實際處理的是如何整理 Agentic world modeling 相關工作,讓讀者按代理人需要的資訊尋找合適方法。

它不會像可直接下載的模型或部署服務般產生結果,價值在於把傳統被動預測下一個物理狀態的 World Model,延伸為面向代理人的 Agent-Centric World Proxy。相比只回答「下一刻會發生甚麼」,World Proxy 也可以回答「這個計劃能否執行」、「應取回哪段經驗」或「下一步應觀察甚麼」,但不同研究的成熟度和驗證方式仍然不一致。

分類採用兩條軸線:六種 Proxy functions 包括 Dynamics、Spatial、Execution、Memory / Experience、Skill 及 Reward / Verification;三個 empowerment levels 則分為 L1 inference-time guidance、L2 training-time optimization,以及 L3 Agent-Proxy co-evolution。這個關係有助分辨模型是在決策時提供提示、訓練時改善能力,還是與 agent 一同持續演化。

  • 用途:按功能及能力層級尋找研究工作
  • 內容:整理模型、論文、arXiv ID、發表場合與年份
  • 維護:接受新增項目、分類修正及連結更正
  • 限制:本身沒有推理 API、安裝流程或統一性能基準

它適合研究人員、建立 agent pipeline 的工程團隊,以及需要比較 Dynamics、Memory 或 Verification 方法的人;但若目標是立即部署系統,仍須自行選擇並安裝清單內的個別模型或工具。

項目目前更像一張持續更新的研究地圖,而非完成度一致的 benchmark。它的優點是提供共同語言,將 world modeling 從單一狀態預測重新放回規劃、學習和互動成本的脈絡;限制則是清單依賴社群維護,分類邊界仍會隨 Agentic world modeling 發展而變動。

項目主頁 · GitHub

Categories: 開源, Agentic, 世界模型, 模型訓練, API, Dataset 數據集, Skill 技能

DeepVoyager-VL 把視覺線索放回搜尋流程中

DeepVoyager-VL不只是睇圖再答題,而係會用新取得嘅視覺證據決定下一步搜尋。對長流程多模態檢索項目而言,呢個改動幾關鍵。

Comparison of multimodal search data synthesis paradigms

當一個多模態 agent 要連續查多步資訊,最易失準嘅位置往往唔係答題,而係中途搵錯線索。DeepVoyager-VL處理嘅正正係呢個問題:佢屬於長流程多模態 deep-search 框架,讓新取得嘅圖片證據直接影響下一輪檢索,而唔係只喺輸入開頭或答案結尾先用到視覺資訊。

呢種做法令佢同一般把視覺訊息包裝成前置條件嘅方法有明顯分別。DeepVoyager-VL背後用 EventVoyage-VL 生成帶有中間視覺依賴嘅長流程問題,再用整理過嘅 trajectories 做 Supervised Fine-Tuning(SFT),而唔加額外 reinforcement learning 階段;取捨好清楚,訓練流程較可重現,但效果仍然要靠資料合成質素同軌跡篩選撐住。

倉庫而家已經放出 paper、project page,同可重現嘅 Megatron SFT training bundle,亦提供 DeepVoyager-VL-8B 同 DeepVoyager-VL-30B-A3B 模型,以及 EventVoyage-VL dataset。想理解點樣驗證,最直接係沿住現成模型、資料集同訓練 bundle 睇完整流程;README 亦提到 SWIFT RUNTIME=bundled 會使用儲存庫內嘅 source trees,定位上比較接近研究與訓練復現項目,而唔係即開即用嘅消費級產品。

  • 核心改動:把 vision in the loop 放入搜尋中段,圖片可按需要先載入或裁切
  • 資料來源:EventVoyage-VL 先做 structure-before-language synthesis,再抽出可監督軌跡
  • 訓練路線:以 supervised-only 為主,冇再疊 reinforcement learning 階段
  • 結果:8B 同 30B-A3B 平均分別為 54.8 同 58.6,並在十個 benchmark 入面分別拿下八個同九個最佳成績

分數本身已經講到定位:DeepVoyager-VL不只是追求更大模型,而係想改善「見到新圖之後,下一步應該搵乜」呢個決策環節。較受益嘅會係做多步檢索、多模態問答、研究型 agent pipeline 嘅團隊;要留意嘅限制亦同樣直接,成效高度依賴合成資料點樣把中途視覺依賴編排得夠真實,離開相關 benchmark 之後,泛化深度仲要靠後續驗證。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 北京大學, 華為, Agentic, 模型, 多模態模型, 模型訓練, 框架, Dataset 數據集

N0-TWAM 把觸覺帶進機械人決策

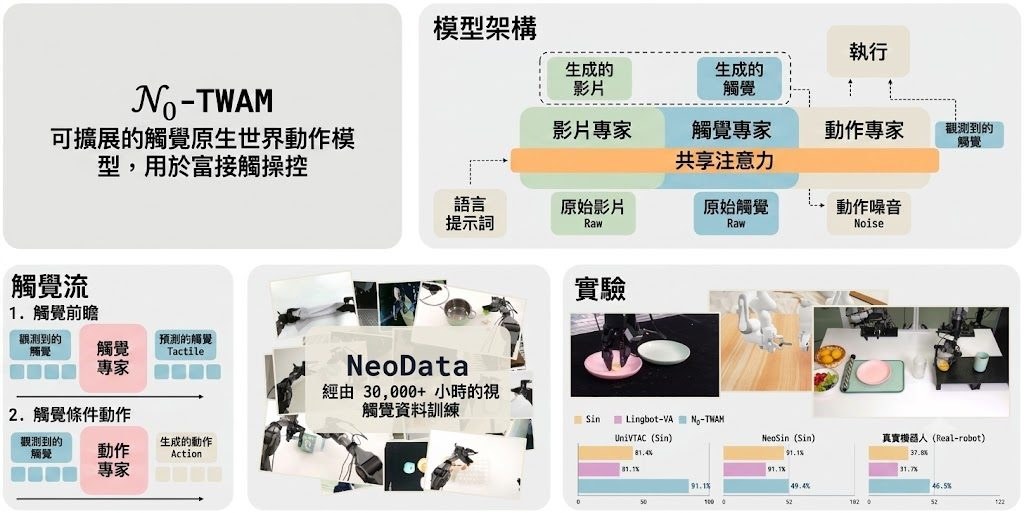
鏡頭睇到嘅畫面未必足夠,N0-TWAM連觸覺一齊預測,再生成動作。對接觸密集操作來說,這個方向比只看影像更貼近現場需要。

teaser

插頭有冇卡住、夾爪有冇真係受力,單靠畫面往往判斷唔完整。N0-TWAM放喺呢個空缺上處理問題:它屬於世界動作模型,將 vision、tactile 同 action 一齊建模,先推進未來會見到乜、摸到乜,再輸出低層動作,目標直指 contact-rich manipulation。

它吸引之處不只是多加一種感測,而係把觸覺當成未來狀態的一部分,而唔係事後補充訊號。相比只預測影片的 world-action model,或者直接由當前觀察回歸動作的 VLA policy,N0-TWAM更著重「預測之後再行動」;代價是系統更重,儲存庫亦只釋出 pretrained checkpoint、inference server 同 post-training toolkit,未包含大規模預訓練流程。

  • 可直接載入 pretrained checkpoint,再用自家 demonstrations 做 post-training
  • 可經 websocket 部署,由 observation 持續取回動作,也可接到自家 robot 或 simulator 做 closed-loop 控制
  • 支援 NeoSim 的 closed-loop benchmark,方便用 vision–tactile 場景驗證表現
  • 核心做法是 Mixture-of-Transformers (MoT),分開 video、tactile、action 三個 experts,再共享注意力交換資訊

模型背後沿用 WAN2.2 TI2V-5B video diffusion transformer 作 backbone,重組成三個 experts,並用 rectified-flow / flow-matching 目標聯合學習。readme 亦交代 action space 是 20-dim dual-arm end-effector,配合 tactile-aware execution,明顯不是聊天式 agent,而是面向機械臂操作與接觸控制的研究模型。

它在 UniVTAC、NeoSim 與八個 real-robot tasks 的平均成功率分別達到 84.5%、49.4% 和 46.3%。這些結果說明觸覺對高接觸操作有實質幫助;同時也要留意,部署門檻仍然偏研究導向,較適合機械人團隊、模擬環境開發者,以及已經有 demonstrations 與感測資料流的項目直接接入測試。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 模型訓練, Video, VLA, Robotic, Dataset 數據集

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

Text prompt scaling law overview

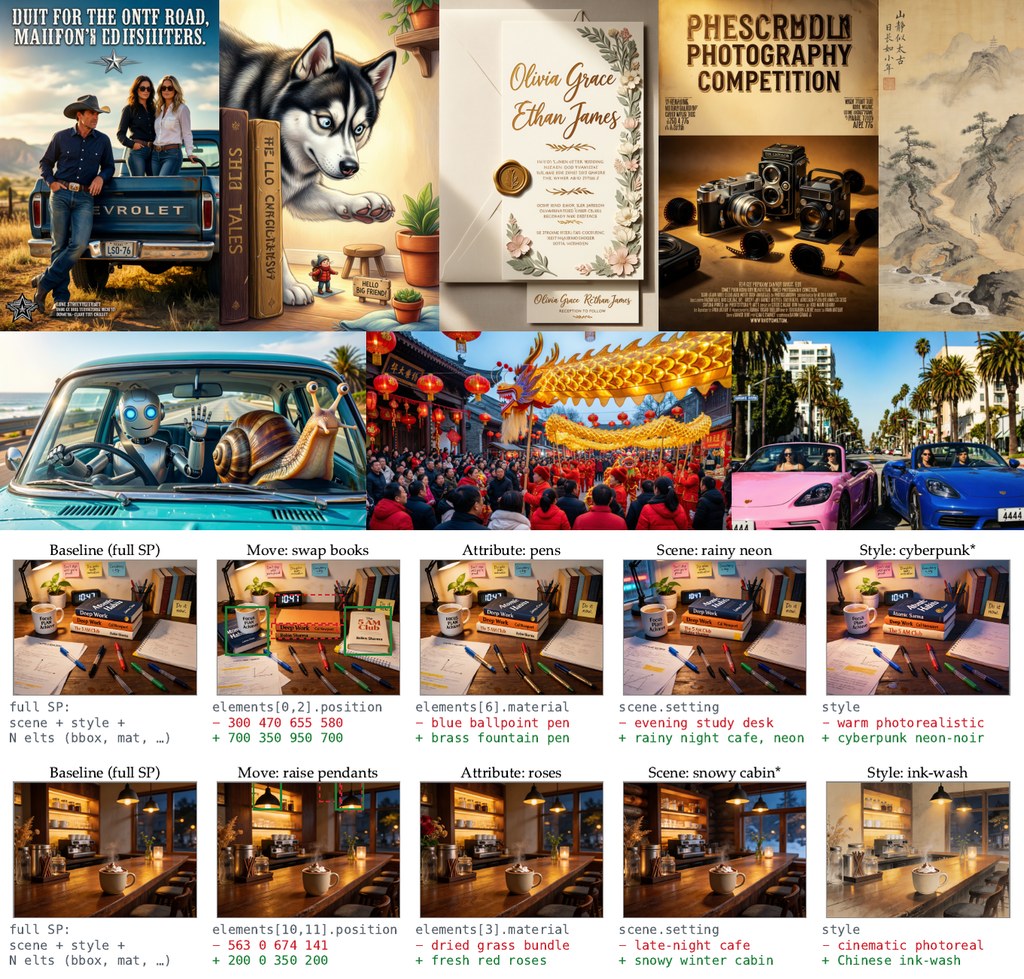
文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation

這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

Page 24 of 38
1 … 22 23 24 25 26 … 38