SparsePR 讓影片生成以稀疏注意力加速,毋須重新訓練

SparsePR 將稀疏注意力帶入四款影片模型,在維持生成質素的同時,把執行速度提升最多 2.61 倍。

Repository image for PardisTaghavi/SparsePR

影片生成最吃資源的部分,往往不是提示詞或輸出格式,而是 Video Transformer 裏大量 Attention 計算。SparsePR 屬於 training-free sparse attention 參考實作,透過減少不必要的 query、key/value 互動,加速 HunyuanVideo-13B、Wan2.2-I2V-A14B、Cosmos-Predict2.5-14B 及 Cosmos3-Nano-16B,毋須額外訓練模型。

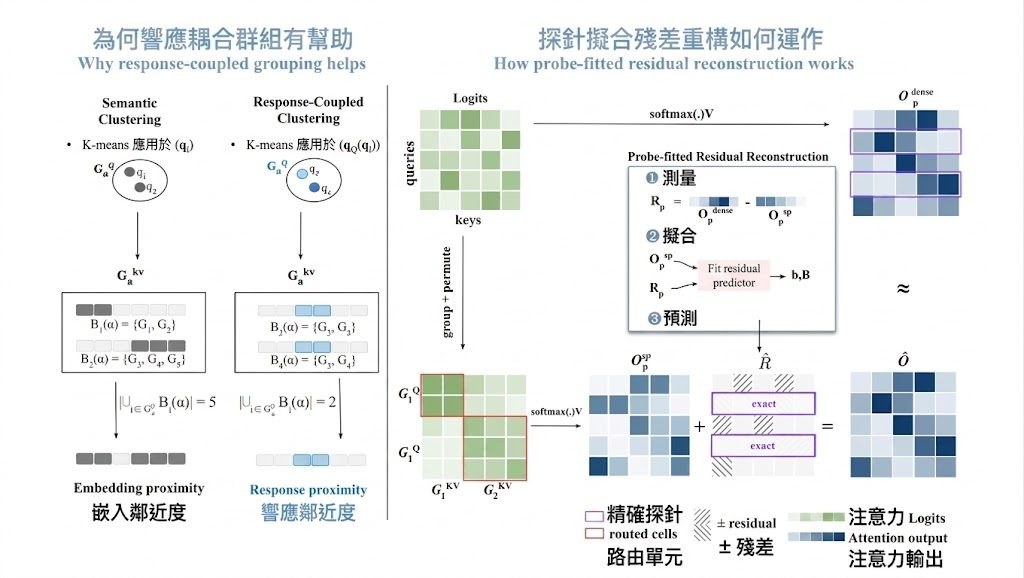
它沒有單純按注意力集中程度刪走區塊,而是以 Response-Coupled Partitioning 按目前回應分組,再用少量 exact probe rows 配合 Probe-Fitted Residual Reconstruction,補回稀疏計算遺漏的輸出。使用者可透過同一個介面,在 dense baseline 與 SparsePR 之間切換,直接比較影片質素、速度和顯存取捨。

  • 執行 pair density 約 21.9% 至 26.0%
  • 端到端速度提升約 1.48 至 2.61 倍
  • 涵蓋文字轉影片、圖像轉影片及 image-to-world 情境
  • 在 VBench 及 PBench 進行評估,部分 Cosmos-Predict2.5-14B 結果達 40.33 dB

項目要求 Linux,並建議使用 NVIDIA H100;HunyuanVideo、Wan2.2、Cosmos-Predict2.5 與 Cosmos3 需要分開的 CUDA 12.8 wheel 環境,原因是 Cosmos3 依賴較新的 Diffusers 和 Transformers。可選的 fused CUDA kernels 有助進一步執行,但安裝門檻明顯高於一般影片生成工具,模型 checkpoint 亦要從官方 Hugging Face 儲存庫取得。

SparsePR 適合研究影片生成效率、建立高端 GPU 推理基準,或需要在保留畫面質素下減少計算量的團隊。它目前仍是參考實作,支援模型和硬件環境較有限;對只有消費級 GPU、只想快速試玩影片生成的使用者,成本與環境配置可能抵銷加速帶來的好處。
項目主頁 · GitHub

Categories: 開源, 模型訓練, NVIDIA, Video, Image, 框架, Linux

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

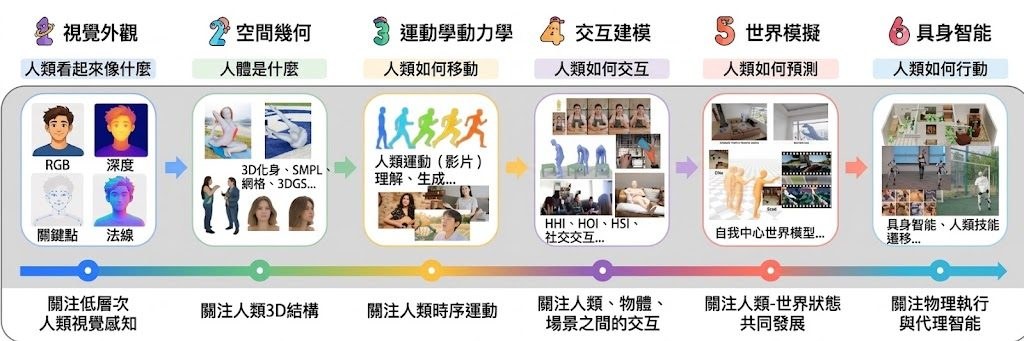
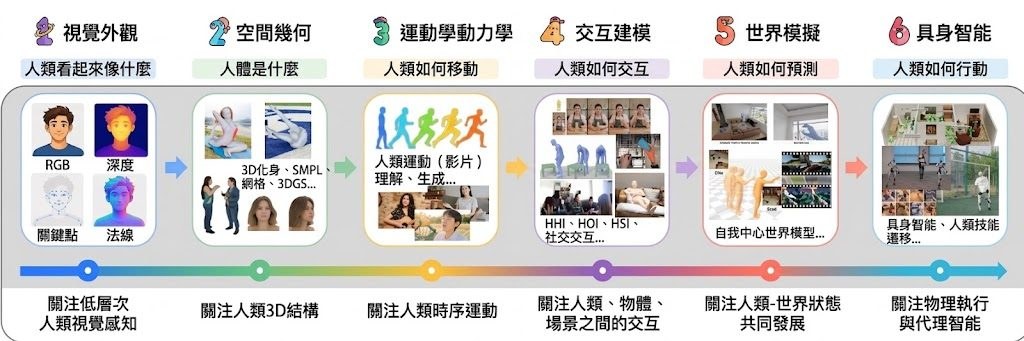
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

[技術文章] RecVerse 讓購物代理更像真人行為

RecVerse以分層記憶和整段軌跡訓練,模擬更貼近真人的網上購物流程。

Hero image preview

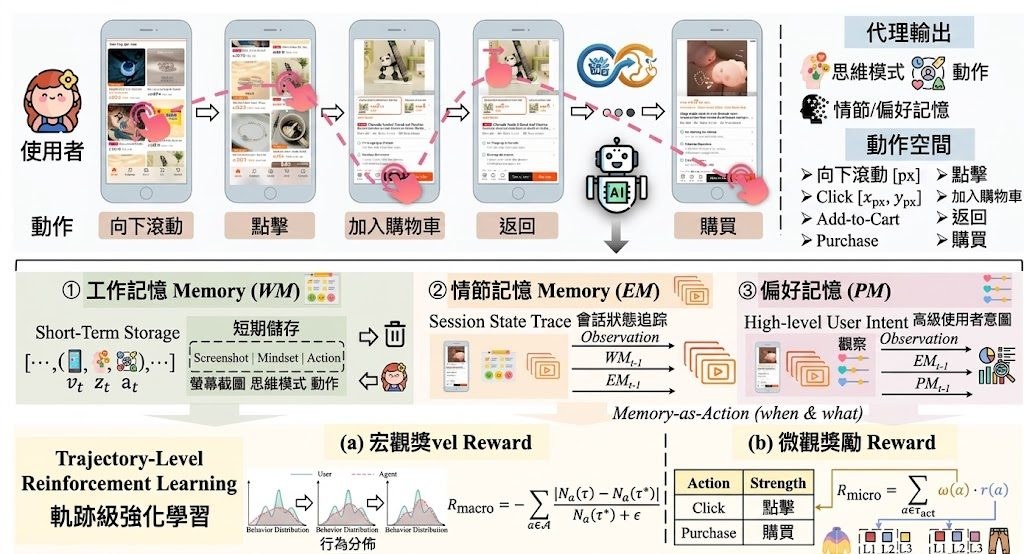
網上購物模擬器要重現真人由瀏覽、比較到購買的連續決定,才能支援推薦系統的離線測試和 Reinforcement Learning(RL)訓練。RecVerse 是一個以 GUI 為基礎的模擬代理,透過螢幕截圖理解頁面,生成多輪購物軌跡,處理長時間瀏覽中用戶狀態不斷變化的問題。

現有做法各有缺口:Rule-based simulators 依賴向量化商品特徵和預設行動空間,難以涵蓋複雜的電商介面;Large Language Models(LLMs)和 Vision-Language Models(VLMs)代理雖然加入推理及 persona 建模,長會話仍可能丟失早期觀察,或者把所有歷史硬塞進 context window。逐步模仿每個已記錄行動,亦可能令整段流程出現過度探索或過分被動等不自然模式。

RecVerse以認知啟發的分層記憶處理長期資訊,包括短期焦點用的 Working Memory、保存本次會話軌跡的 Episodic Memory,以及記錄高層次意圖的 Preference Memory。記憶更新本身被視為行動,代理可以按情況學習何時及應該保存哪些資訊。

訓練時,系統改用 trajectory-level RL,直接為完整購物會話評分,同時對齊真人的宏觀行動類型分佈和微觀購物意圖。研究團隊亦發布 USB(UserSimulationBenchmark)互動式電商 GUI 軌跡數據集;實驗結果指 RecVerse 在行為忠實度和意圖一致性上均優於現有基線。

  • 以螢幕截圖理解電商 GUI,生成多輪購物行為
  • 透過三層記憶保留短期焦點、會話經歷和用戶偏好
  • 用完整軌跡目標修正逐步模仿帶來的不自然行為
  • USB 提供互動式電商 GUI 軌跡數據集
  • 可用於推薦策略的離線及反事實測試

Paper

Categories: 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, 中國

AgentMercury 生成可驗證商業世界

把企業情境轉成可執行環境,讓AI代理在多服務流程中訓練,再轉移到未見過的評測項目。

Og image

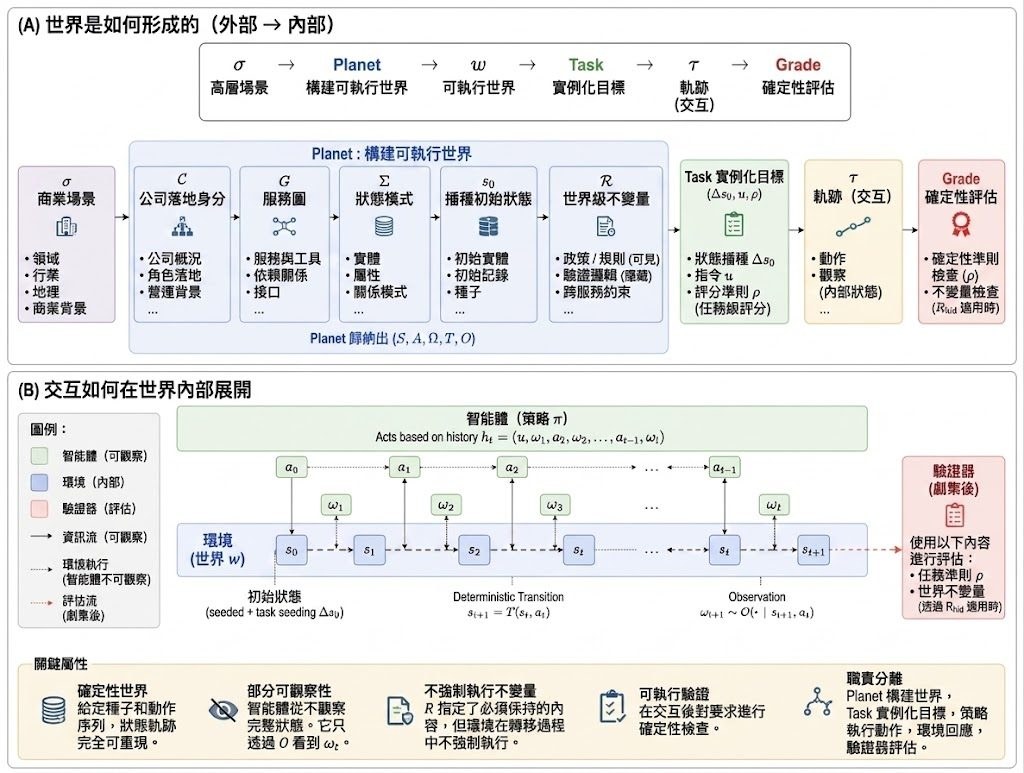
當AI代理要處理跨部門企業流程,難點往往不只在於選擇工具,還要在多個服務之間維持一致狀態,最後交出可以核實的結果。AgentMercury是一個用於訓練 Computer-use agents(CUAs)的環境生成項目,讓高層次商業情境直接變成可執行、可重播和可驗證的虛擬世界,代理可以在其中進行多輪操作,而系統會按完成後的狀態計算獎勵。

常見做法會先為指定任務或 benchmark 手工建立環境,環境自然只覆蓋測試者預先想到的流程。AgentMercury則把環境建構本身交給 Planet:它由公司身份、服務圖、資料表結構、初始狀態和跨服務不變條件組成一個完整世界,再由 Task 在共享世界上加入不同目標和評分規則。一個世界可以承載多個任務,減少每個新流程都要重新造環境的成本。

驗證條件主要以環境資料庫上的 SQL 形式執行。代理完成一輪操作後,系統會根據任務 rubric 和隱藏的不變條件,對整條 trajectory 進行確定性評分;環境不會在每一步替代理判斷對錯,代理必須自行處理跨服務要求,完成後才接受檢查。這種安排讓結果可以重播,也令 Reinforcement Learning(RL)訓練得到較穩定的回饋。

目前項目整理出4,783個 executable worlds,涵蓋14個產業和50個國家,包含13.98M seeded state rows、842種工具和43,300個可驗證 RL 任務。典型世界約有13項服務、65種工具、31張狀態表,以及約15個以 SQL 編寫的 deterministic verifiers;訓練資料涉及4,326個公司環境,但 Qwen3.5-4B 的報告只使用其中3,200個任務取得梯度,仍覆蓋53.5%的環境、62.9%的產業和75.8%的工具。

項目以 Qwen3.5-4B 和 Qwen3.5-35B-A3B 進行 RL 訓練,代理透過 Model Context Protocol(MCP)操作即時形式的商業軟件,並以 GRPO(Group Relative Policy Optimization)為主要優化方法,SAO 則作為另一種選項。Qwen3.5-4B 的平均獎勵約由0.25升至0.53,截斷回應比例由78%降至3%;在未參與訓練的 EnterpriseOps-Gym 八個企業領域,平均分數由12.3升至15.7,增幅為27.6%。35B-A3B 使用 GRPO 和 SAO 後,平均分數分別由24.8升至28.1及28.3,但結果仍屬項目所報告的訓練和評測範圍,未代表代理已能可靠處理所有企業工作。

  • 將高層次商業情境編譯成可執行世界,而不是只為單一任務造環境
  • 以共享資料庫、SQL 驗證條件和可重播評分檢查跨服務結果
  • 提供4,783個環境、842種工具和43,300個可驗證 RL 任務
  • Qwen3.5 系列在多輪 MCP 工具操作訓練後,獎勵和未見領域表現均有改善
  • 仍需留意合成環境與真實企業軟件之間的差距,以及評測範圍有限的問題

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, Qwen, Dataset 數據集

τ₀-VLA:為長程機械人任務補上分層推理

τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

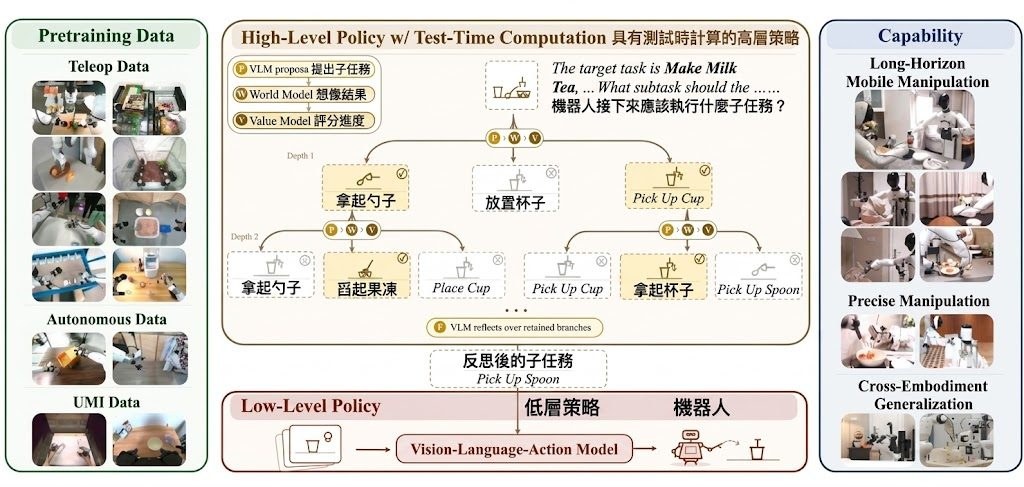
τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, VLA, World-Action Model, Python

NAPE 簡化自監督音訊片段訓練

NAPE 以因果 Transformer 預測下一個音訊 patch embedding,省去解碼器與 tokenizer,探索更精簡的音訊表徵學習方法。

NAPE Architecture

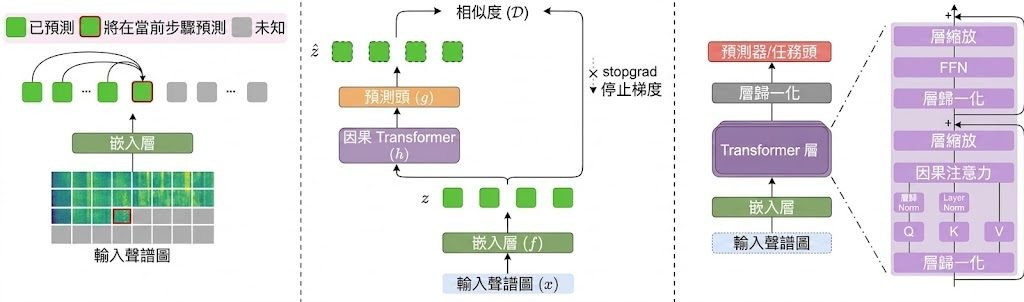
音訊模型要兼顧訓練成本、表徵能力與模型規模,往往需要加入多個輔助模組。NAPE(Next Audio Patch Embedding prediction)是一個自監督音訊表徵學習框架,將 log-mel spectrogram 切成 patch,再由因果 Transformer 根據前面的片段預測下一個 patch embedding。

NAPE 沒有 reconstruction decoder、acoustic tokenizer、student-teacher 架構或額外正則化損失。它依靠三個機制維持學習訊號:causal masking 隱藏未來位置、prediction shift 要求位置 t 預測 t+1,以及 stop-gradient 固定目標 embedding,避免模型退化成輸出相同向量。

二維 spectrogram 會按指定 scanning order 轉成一維序列,研究涵蓋 raster、diagonal、zigzag 和 time-major 四種排列;其中 raster、diagonal 及時間方向的排列較符合聲音事件的發展。模型在 AudioSet 預訓練,再於 AudioSet-2M、AudioSet-20K、ESC-50、Speech Commands V1/V2 和 IEMOCAP 進行微調或 linear probing,資料顯示它在多項任務取得 state-of-the-art fine-tuning 結果,並具備穩定的跨規模擴展能力,但原始資訊沒有提供各項具體分數。

要求系統有 Python 3.10、PyTorch 2.8.0 和 Transformers 4.56.2 的環境,並提供 requirements 檔及部分資料集處理程式;ESC-50、Speech Commands V1/V2 和 IEMOCAP 有下載腳本,AudioSet 則要自行處理涉及 YouTube 的下載流程。研究團隊亦列出程式碼及預訓練 checkpoint 的發布資訊,但 Hugging Face checkpoint 仍標示為待辦,不能把完整模型取得流程視為已經齊備。

  • 訓練訊號精簡:只用下一個 patch embedding 預測與 stop-gradient。
  • 適合音訊表徵:可支援語音指令、環境聲音及情緒辨識等任務。
  • 排列順序有影響:spectrogram 的線性化方式會改變模型看到的時間關係。
  • 測試門檻清楚:需要 AudioSet 或下游資料集,以及 W&B 追蹤實驗。
  • 限制在資料流程:AudioSet 不提供同等簡化的下載方式,checkpoint 取得狀態亦未完全明確。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, Audio, Python, 語音

ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 上海人工智慧實驗室, 騰訊, 世界模型, 模型訓練, Video, World-Action Model

FACET-Terminal:讓終端任務由可執行環境先行生成

FACET 把技能、Docker 環境、解法與驗證器連成同一狀態,產出可真正執行驗證的終端任務。

FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis

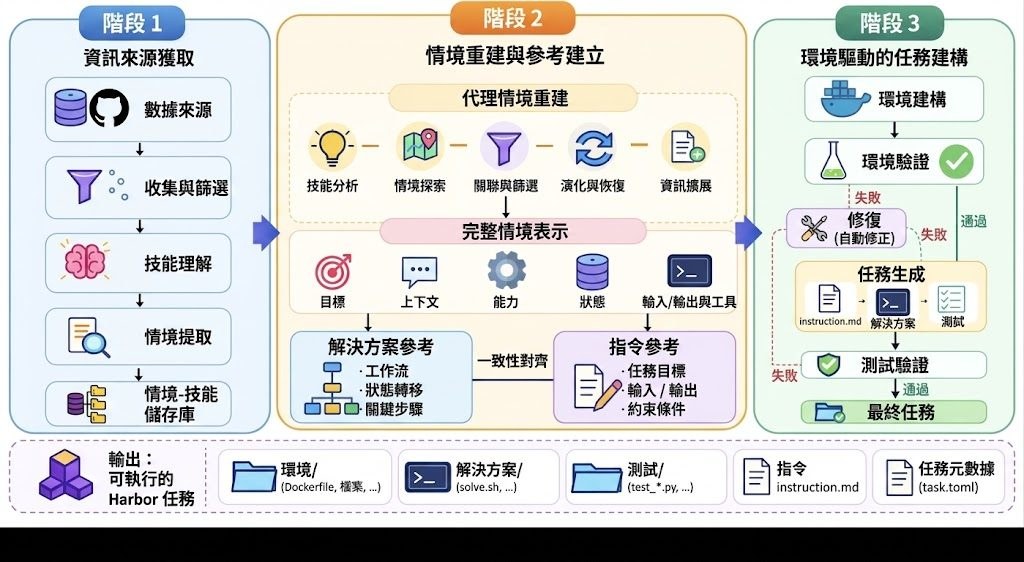
終端 AI Agent 最怕指令寫得合理,環境、解法和驗證器卻互相對不上。FACET(Fine-grained Agentic Construction of Executable Tasks)是一套終端任務合成框架,先建立並修復 Docker 環境,再讓指令、參考解法和驗證器共享同一套執行狀態,處理複雜任務難以穩定測試的問題。

項目由 71,341 個來源技能整理出 7,852 條場景—技能種子,最後取得 6,078 個通過執行驗證的任務,並從成功 rollout 篩選約 1.2K 條完整軌跡,用於監督微調 Qwen3.5 系列模型。環境中的檔案、路徑、套件、連接埠、資料結構和測試資料會沿流程傳遞,減少純文字交接造成的落差。

資源包括 FACET-Terminal-Tasks-6k 數據集,以及 FACET-Terminal-Qwen3.5-4B、9B 和 27B 模型。要重現任務合成流程,需要 Python 3.11–3.13、uv、Docker 和模型 API;配置與 Python 程式集中在 facet/,並提供 FORWARD、REVERSE、JOINT 三種生成策略作比較。

Terminal-Bench 2.1 的三次獨立執行平均結果顯示,4B、9B、27B 模型分別由 17.60、27.34、40.82 提升至 24.72、35.58、47.57;4B 相對提升 40.5%,27B 更接近同設定下 Qwen3.5-397B 的 49.06。這批數據規模仍然有限,任務質素亦依賴 Docker 環境和驗證器是否正確,較適合研究 Agent 訓練、Terminal-Bench 評測及需要可重現終端操作的團隊。

  • 資料基礎:6,078 個通過執行驗證的任務
  • 生成方式:環境先行,指令、解法與驗證器共享狀態
  • 公開模型:Qwen3.5 4B、9B、27B
  • 評測結果:27B 在 Terminal-Bench 2.1 達 47.57
  • 適合場景:終端 Agent 訓練、任務合成及可重現評測

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 模型訓練, API, Python, 中國, Dataset 數據集

SkillGate:9B 模型修補任務中的技能

SkillGate 針對代理在長任務中揀技能時得不到足夠學習訊號的問題,將選擇與執行分開計算。你可以把它理解成一套訓練方法,讓模型學懂何時讀哪份技能文件。

SkillGate mechanism demo

SkillGate 是一套用來訓練 agent 選技能的開源方法,處理的是長鏈任務裡「揀啱技能」比「做完動作」更難學的問題。它把技能讀取視為中途決策,避免單靠結果獎勵去反推整條路徑,令選擇技能的 token 不再被後段執行訊號沖淡。

SkillGate 同時分出兩條互不干擾的信用路徑:結果分數只回傳到執行 token,而動作局部的優勢值只回到技能名稱 token。這樣做的目的,是讓模型在讀技能文件時得到更直接的學習訊號,而不是等整段任務成敗去間接修正。

作者做了 12,800 條訓練軌跡分析,指出技能選擇 token 的損失權重中位數只有 0.14%,而且不少樣本的優勢值會因為後段失敗而變成負值。這類「selector credit starvation」問題,正是 SkillGate 想修正的核心。

在五個 agentic 基準上,9B 規模版本錄得 53.2% 試驗成功率,屬於同級裡較強的結果。資料集和模型都已公開,訓練與評估亦配合字節對齊的實際提示詞流程,適合做 agent 訓練、技能庫管理,或者研究長鏈強化學習的人參考。

  • 把技能選擇同任務執行分開計分,減少信用稀釋
  • 針對 mid-episode 技能讀取決策,不只看最終成敗
  • 9B 版本在五個 agentic 基準上有 53.2% 成功率
  • 公開了模型同資源,方便重現同類訓練流程
  • 對需要大量技能庫的 agent 系統較有參考價值

GitHub · 模型

Categories: 開源, Agentic, 模型訓練

Page 21 of 38
1 … 19 20 21 22 23 … 38