Super-Star:讓數字人邊聽邊做

Super Star 將串流語音、對話和身體動作連成一條即時管線,令 3D 數字人毋須等待完整語音才開始配合手勢。

logo

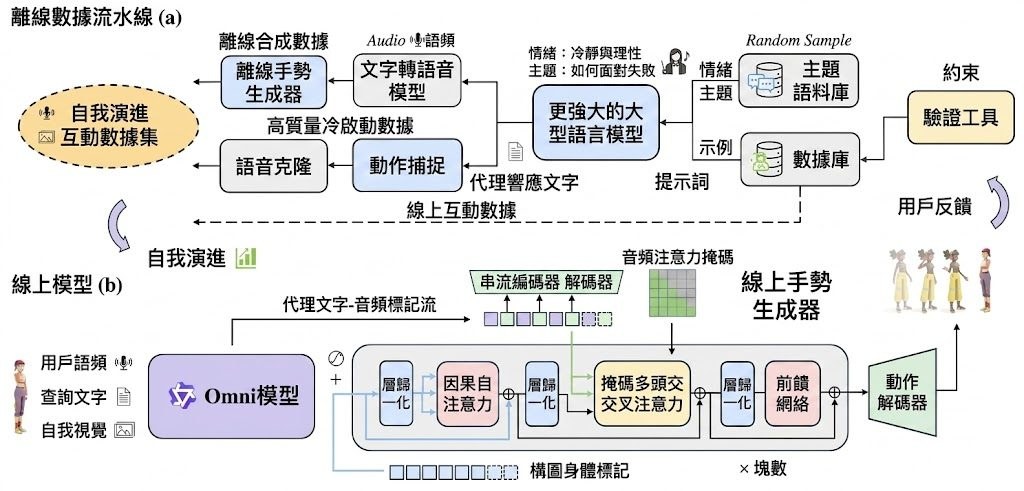
數字人要一邊回應、一邊自然做出配合語氣的動作,關鍵不只是生成語音,而是不能偷看未來內容。Super Star 屬於面向 3D 數字人的即時互動框架,處理多模態輸入、串流回應語音,以及與語音同步的身體姿態生成。

Super-Star 把 Streaming Speech Response 與 Online Gesture Generator 兩個模組接合。前者採用 Qwen3-omni 產生串流回應語音,後者是因果多模態自回歸模型,根據目前收到的語音和 motion history 預測下一段動作,因此可在低延遲下生成手勢,不需等整段對話完成。

離線資料流程會按主題和情緒建立人機對話,再為回應語句生成 co-speech gestures;線上互動收集到的使用者偏好,會回流到 closed-loop self-evolving data pipeline,支援持續調整。相比先取得完整語音再生成動作的做法,Super Star 以較少未來資訊換取即時性,但動作預測亦更依賴目前語音片段和歷史狀態。

  • 串流語音與動作同步,適合虛擬陪伴、直播角色及互動式數字人
  • Qwen3-omni 負責回應語音,Online Gesture Generator 負責身體動作
  • 研究結果主張改善 latency-quality trade-off、語音動作同步及使用者偏好
  • 訓練 Motion Tokenizer 和 Online Gesture Generator 時需要 WAV 音訊
  • CUDA driver 需為 12.4 或以上,完整執行細節仍要配合 Qwen3-omni 及 vLLM-Omni 文件

提供的資料包含 training、inference 和 evaluation code。訓練部分使用 RQVAE 的第一層 codebook 解碼,對應論文線上模型採用的 VQVAE,測試者需要準備 WAV 檔案並填寫音訊路徑和輸出目錄。對研究團隊及需要低延遲數字人互動的開發者而言,項目較適合作為研究原型或客製化系統的起點,而非即裝即用的成品。
項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 多模態模型, 模型訓練, Qwen, NVIDIA, Audio, 3D, 語音, Dataset 數據集

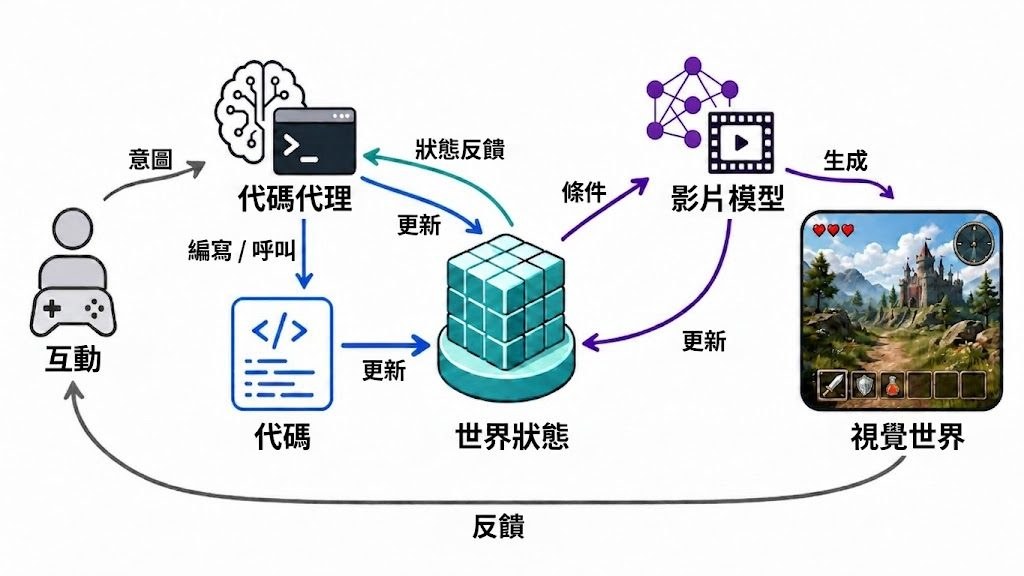
Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

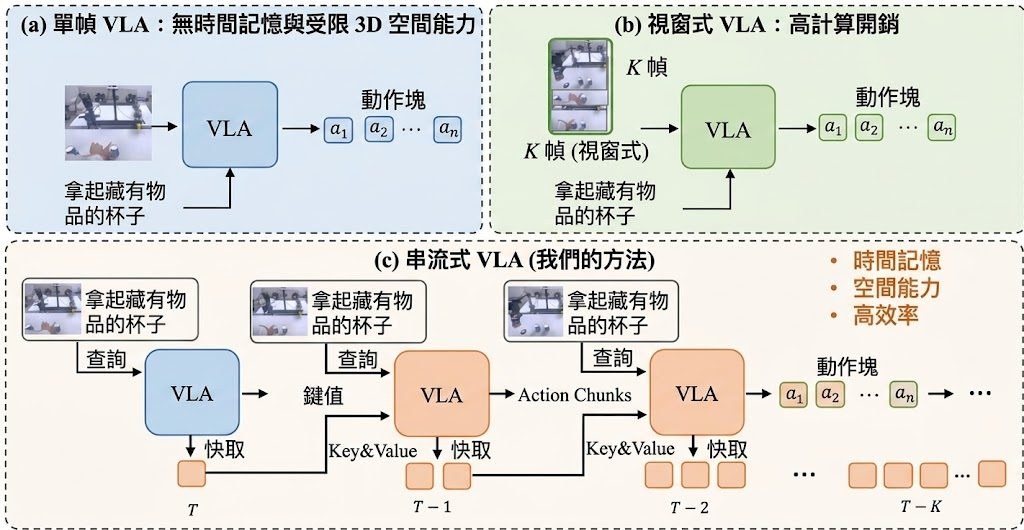
StreamPI 機械人模型的記憶系統

StreamPI 為單幀 Vision-Language-Action 模型加入記憶與幾何線索,並將多幀推理的延遲增幅壓至較低水平。

Overview of the StreamPI architecture and streaming inference workflow

機械人執行抓取、插入等連續任務時,只看當前畫面容易失去物件位置變化;StreamPI 將每組視覺觀察與語言指令視為一個時序單元,屬於為 Vision-Language-Action (VLA) 模型加入串流時序推理能力的框架,針對的正是單幀 π₀.₅ 無法保留歷史觀察的限制。

它沒有額外加入模型參數,而是把多組 token 接在同一序列,再用 block-wise attention mask 控制資訊流。每個單元內採用雙向注意力,讓視覺與語言充分融合;單元之間採用因果注意力,配合 KV cache 保留過去內容,避免每次重新處理完整歷史。重複放入語言指令亦可令任務目標在視覺內容增加後保持清晰。

  • 以預訓練單幀模型延伸至單幀或多幀推理
  • 不增加參數,支援彈性上下文長度
  • 以 random-interval sampling 配合 temporal masking,模擬非固定觀察時間
  • KV cache 適合串流推理及非同步機械人控制
  • RTX 4090 由一幀增至五幀,平均延遲只由 94.4 ms 升至 103.6 ms

訓練時加入隨機幀間隔,讓模型接觸不同觀察節奏;研究資料亦提到每三幀取樣可令動作更快、更平順。這比固定時間同步的訓練更貼近真實機械人環境,但效果仍取決於感測器頻率、控制週期及任務本身,不能只以幀數推斷所有場景都會改善。

項目建基於 openpi,並提供 JAX multi-node distributed training 的額外支援;README 同時列出 real-robot 任務及示範影片。現有資料未提供完整安裝流程、可直接下載的模型權重或測試指令,官方項目頁只表示程式碼及權重預定於 2026 年 8 月 30 日公開,因此目前較適合機械人研究團隊參考其架構和評測方向,而非當作即時可用的套件。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 香港, Dataset 數據集

VGI-Bench 揭示影片模型推理仍未可靠

影片生成模型不只要畫面合理,還要令事件按正確過程演變。VGI-Bench以27項任務測試這種能力,最高分只有51%。

Repository image for hexuan21/VGI-Bench

當影片生成模型要處理空間關係、時間變化、物理操作或結構謎題時,畫面好看並不代表推理正確。VGI-Bench屬於影片模型視覺推理評測基準,實際處理的是如何檢查模型能否生成符合條件、而且過程連貫的影片,而非只交出一個合理的最後畫面。

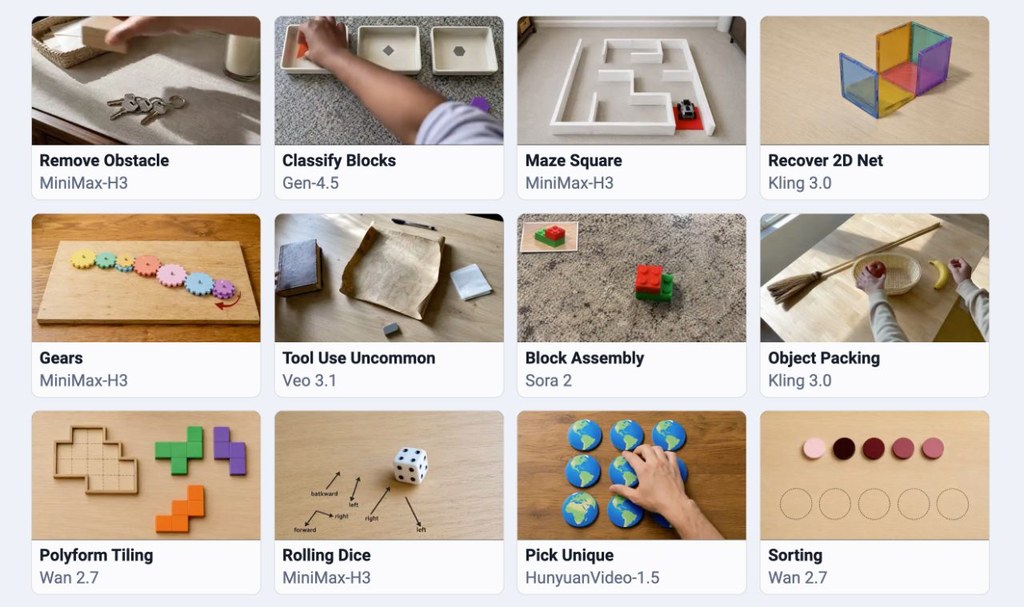
VGI-Bench包含27項任務及810個測試實例,按任務領域和 skill tags 分成兩層分類,並設有 easy、mid、hard 三個難度級別。測試輸入盡量貼近現時影片模型熟悉的視覺先驗,同時要求輸出反映有效的 evolving process;評分採用 rubric score × completeness score,兼顧答案是否正確及是否完成要求。

結果反映模型能力仍有明顯缺口:Seedance 2.0以51.0%取得最高總分,在 Visual Organization、Spatiotemporal 和 Physical Manipulation 領域領先;MiniMax-H3則以50.6%在 Structured Puzzles 領先。Sora 2、Gen-4.5、Wan 2.7及Veo 3.1等模型亦被納入比較,方便分辨影片品質與視覺推理能力之間的差距。

  • 生成畫面合理,不等於推理過程正確
  • 覆蓋視覺組織、時空推理、結構謎題及物理操作
  • 最高總分只有51.0%,可靠性仍不足
  • 分析涵蓋輸出失敗模式及輸入條件敏感度
  • 去噪後期主要修整早期假設,未必能修正推理錯誤

研究團隊亦檢查 synthetic fine-tuning 的性能轉移邊界,並從 internal denoising 角度分析模型如何修正答案。結果指向有限的 self-correction:後續步驟多數是在完善早期假設,而不是重新推翻錯誤推理。這個基準較適合影片模型研究團隊、模型供應商及需要比較生成式視覺推理能力的評測項目;GitHub資料提供 project page 及 Hugging Face Data & Res 連結,但所給資料沒有列出安裝步驟或完整測試流程,不能直接假定可下載後即時重現。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型訓練, Robotic, Dataset 數據集, MiniMax, Skill 技能

GigaBrain-0.7 讓機械人跨場景理解並執行任務

由家居整理到工業操作,GigaBrain-0.7嘗試令機械人適應更多身體形態與工作環境。

GigaBrain-0 Overview

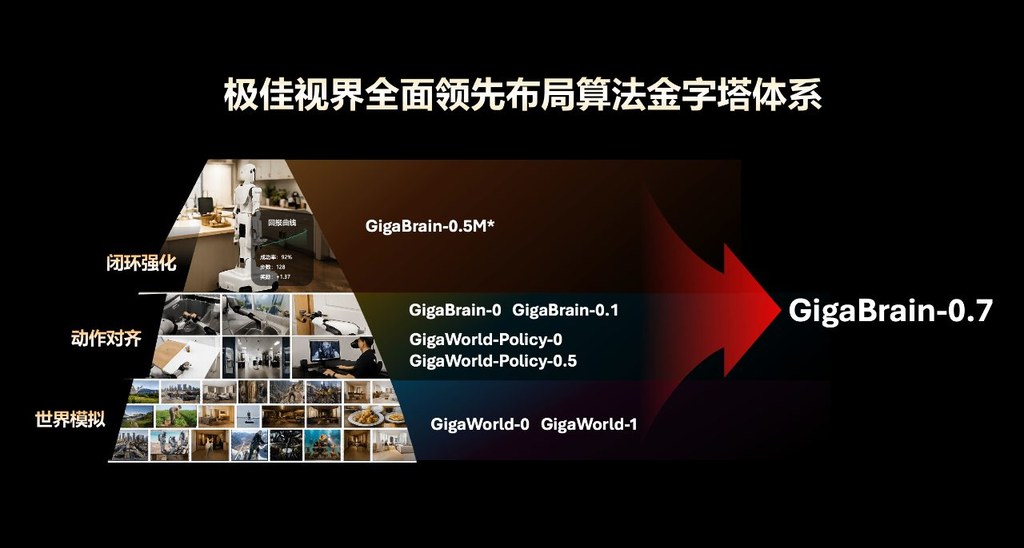
由家居整理到工業操作,機械人要面對的不只是看懂畫面,還要理解指令、預測下一步並控制不同硬件。GigaBrain-0.7 屬於 Vision-language-action (VLA) embodied foundation model,透過統一 understanding、prediction 與 action,處理跨任務及跨機械人形態的泛化問題。

項目以 three-system architecture 組織模型能力,並把預訓練資料擴展至超過 37,000 小時的異質 embodied data,再以 one-stage alignment training 同時優化 vision-language understanding 和 multi-embodiment action generation。相比 GigaBrain-0 系列及包括 π 0.5 在內的先進模型,開發團隊聲稱它在 foundation zero-shot capabilities、language-conditioned instruction following 及 post-training task success rates 均有明顯提升。

GigaBrain-0.7 已提供程式碼、模型和 sample data,模型及資料亦連接至 Hugging Face;但 VLM evaluation code、RoboColiseum、RoboTwin2.0 和 EBench benchmark code 仍列在待辦清單。這代表項目適合研究團隊先重現流程及測試資料管線,未必已具備完整、即插即用的標準化評測環境。

讀者可從以下幾點理解其價值與取捨:
– 支援多種機械人形態,目標是提升跨硬件泛化能力。
– Maker H01 及主流機械人平台涵蓋家居和工業場景。
– 大規模異質資料有助擴闊任務範圍,但亦提高訓練及硬件需求。
– 開放程式碼、模型與樣本資料,方便研究及二次開發。

對機械人研究、具身智能及需要跨平台控制的團隊,GigaBrain-0.7提供了較完整的模型、資料與訓練實作入口;商業落地仍需自行驗證安全性、硬件兼容性、延遲及長時間任務穩定度。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, Dataset 數據集

OraRL:標註即 Rollout,統一多模態模型強化學習

OraRL 把影片標註轉成可靠的正向 rollout,令同一模型兼顧定位、分割、追蹤、問答與空間理解。

Animated OraRL method preview

面對一段長影片,模型要同時回答內容問題、找出時間片段、定位畫面區域,往往要在多套任務方法之間取捨。OraRL 是一個用於統一影片多模態模型(video MLLMs)強化學習的研究項目,將原本只用來評分答案的標註,序列化成模型可直接學習的 oracle rollout。

它的核心做法是把一條標註答案加入同一提示的 policy samples,再只用 policy rewards 計算 on-policy baseline,避免準確標註扭曲模型原本的相對比較;annotation-policy reward gap 則用於方向性修正,最後以 sign-balanced pruning 篩選更新訊號。這個安排保留探索,同時不需要 chain-of-thought supervision 或額外解碼。

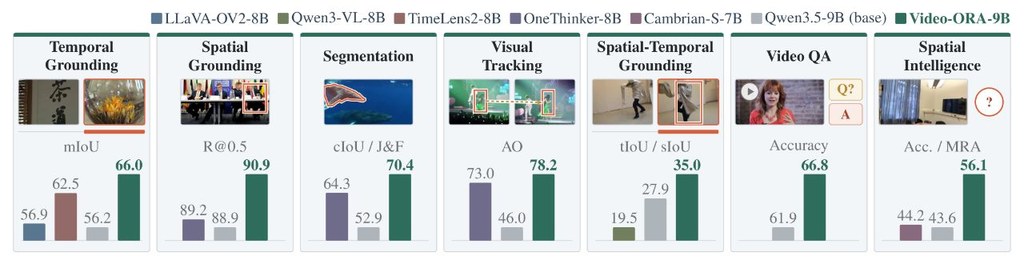
同一套更新規則覆蓋 temporal grounding、spatial grounding、segmentation、tracking、spatial-temporal grounding、video QA 及 spatial intelligence,Video-ORA-9B 則以一個模型處理七類影片理解任務。4B 設定的更新時間由每步 92.5 秒降至 62.4 秒,速度提升 1.48 倍,單張 GPU 峰值記憶體亦由 62.4 GB 降至 50.9 GB。

推理部分提供較實用的取捨參考:H20 以 vLLM 和 BF16 載入時,4B 及 9B 分別佔 8.6 GiB 和 17.6 GiB;十分鐘、每秒兩幀的影片採用 answer-only decoding 後,總延遲由 29.03 秒降至 24.30 秒。儲存庫列出 Environment、Training 及 Evaluation 文件,但提供的資料未包含完整安裝步驟或可直接下載模型的細節,較適合研究團隊按文件檢查環境後測試。

  • 訓練方法:標註同時作為正向 rollout 和任務有效的學習目標。
  • 涵蓋範圍:一套 RL recipe 支援七類影片感知任務。
  • 效率改善:4B 更新速度提升 1.48 倍,記憶體需求下降。
  • 推理優化:支援影片快取、一次解碼重用及 answer-only decoding。
  • 適合情境:需要統一處理影片定位、追蹤、分割、問答和空間推理的研究或工程團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Video, 影像處理, 框架, Dataset 數據集

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

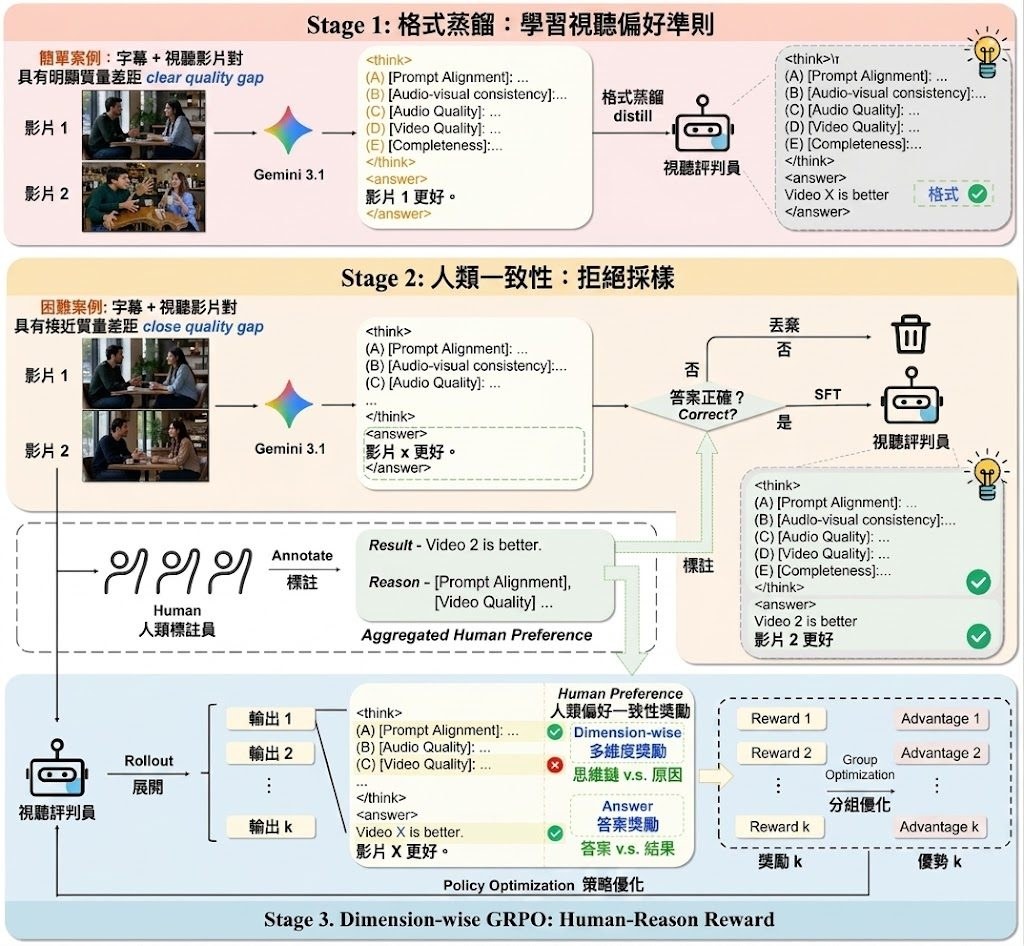
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

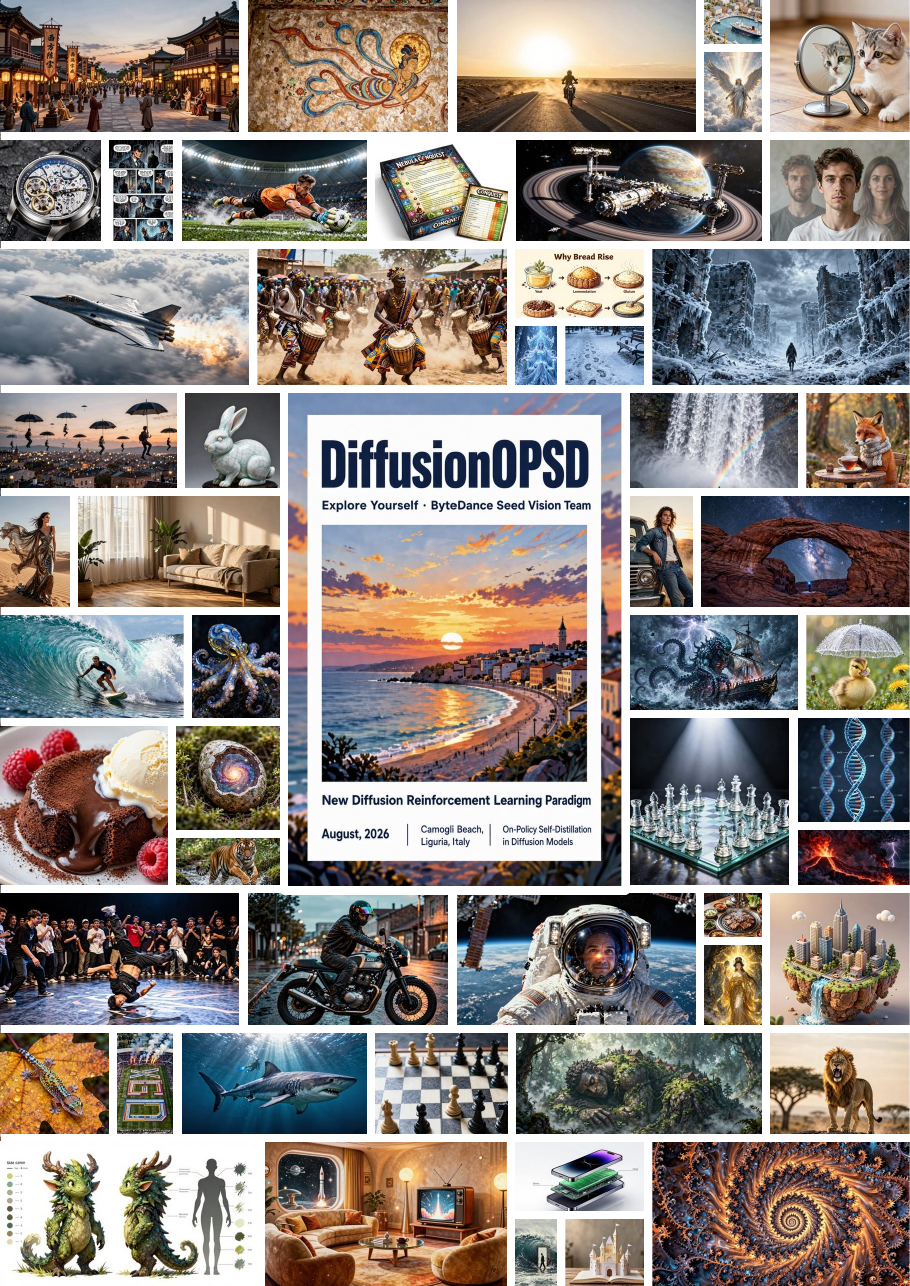
DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

RiboSpan 把長篇 RNA 納入 10K 上下文模型

長篇 mRNA 不再需要截斷處理,RiboSpan 以單核苷酸解析度同時理解完整轉錄本。

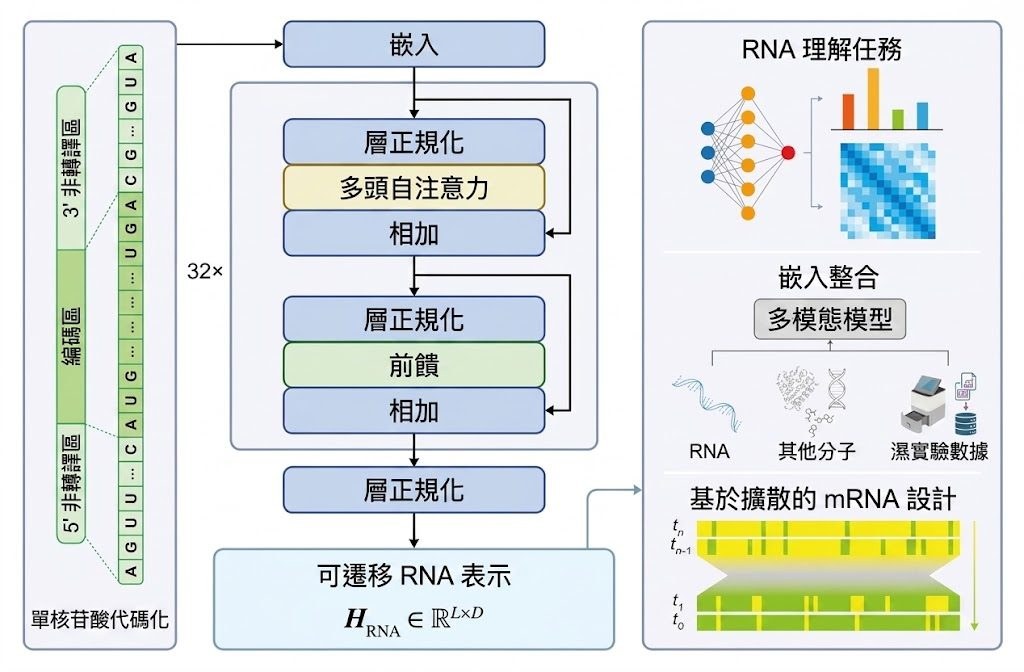
RiboSpan architecture

長篇 mRNA 過往容易因約 1K 的上下文限制而被截斷,令 5′ UTR、CDS 和 3′ UTR 無法放在同一個模型視野內。RiboSpan 是一個 RNA foundation model,實際處理的是完整長鏈 RNA 的聯合表示與下游建模問題。

項目採用 1.61B 參數的雙向 Transformer,每層都使用 dense self-attention,並以每個核苷酸一個 token 的方式保留位置對齊資訊。RiboSpan-10K 原生以最多 10,240 nt 的長度預訓練,不依賴推理階段延長上下文;訓練資料包括 6,760 萬條 RNA 序列,合共 857 億個核苷酸,來源涵蓋 RNAcentral、Ensembl 和 Ensembl Genomes。

  • 單核苷酸 tokenization,保留高解析度序列位置
  • Bidirectional Transformer 可同時讀取上游、下游及遠距離資訊
  • RiboSpan-10K 原生支援 10,240 nt 長上下文
  • 不加 task-specific head 或 fine-tuning,frozen representation 在評測中達到 state-of-the-art,長 RNA 尤其突出
  • 以 40% masking 繼續預訓練,可提升高比例遮罩下的重建能力,同時保留 15% masked language modeling(MLM)訓練建立的 backbone 表示

研究者可從 Hugging Face 載入預訓練 RIBOSPAN checkpoint,再以 Python 整合序列表示、重建或其他 RNA 分析流程;checkpoint 會自動下載並快取,亦可改用本地路徑。模型規模和 dense attention 帶來較高的記憶體及運算成本,長度超過 10,240 nt 的轉錄本仍需另行切分或設計處理策略。

RiboSpan 適合研究 RNA 功能、長轉錄本表示和生物資訊模型的團隊,尤其方便先固定 backbone、再測試下游任務的人員。相較只處理約 1K 上下文的 dense RNA encoder,它保留完整轉錄本關係;代價是 1.61B 參數令本地推理和微調門檻更高,而模型權重亦採用非商業授權,商業項目需要先核對限制。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Python

PhysCaP 讓機械人用互動摸清物件物理特性

當視覺無法分辨重量或軟硬,PhysCaP會主動安排互動,讓機械人用更少動作完成操作任務。

Og image

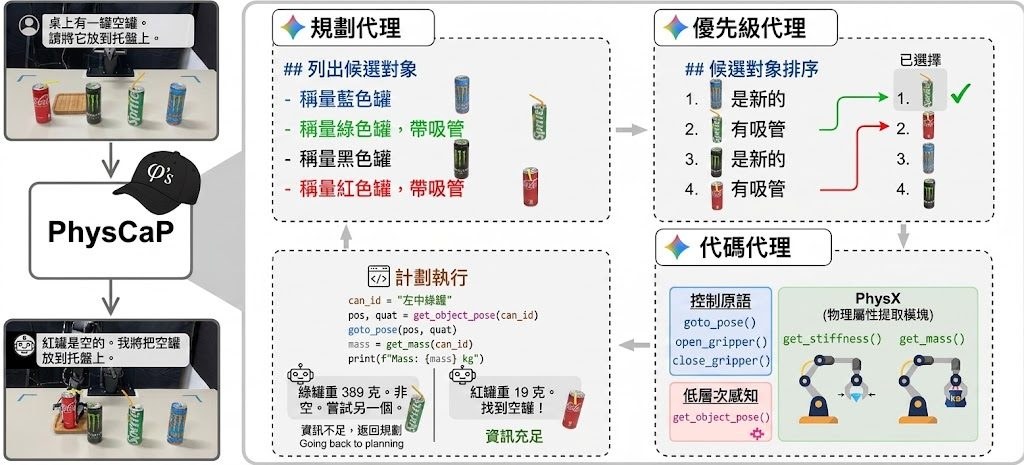
由國立台灣大學、NVIDIA Research、Google DeepMind 及國立陽明交通大學研究人員組成的團隊,推出 PhysCaP,將物理資訊探索加入 Code-as-Policy 機械人代理。

當機械人只靠相機無法分辨哪罐是空的、哪個牛油果已熟,PhysCaP會主動安排提起、夾取等互動,從動作反應推斷隱藏的重量與硬度。這個 physics-informed Code-as-Policy agents 項目,針對被動視覺不足時的機械人操作問題加入主動感知能力。

PhysCaP以雙代理探索框架配合可執行程式碼。Planner先判斷視覺資訊是否足夠,Prioritizer再按預期 information gain 排序互動,過濾不合理或重複的動作,最後呼叫 PhysX(physical property extraction modules)中的 get_mass 和 get_stiffness。

  • 透過 joint-torque 差異及 end-effector Jacobian 估算物件質量
  • 根據 gripper displacement 和 normalized motor effort 分類硬度
  • 無需額外感測硬件,直接利用 robot proprioception
  • 涵蓋找藍色方塊、辨認空罐和挑選熟牛油果
  • 模擬與真實任務中,部分結果達到 9/10 成功率

測試亦包括 LIBERO Empty Can 模擬環境。研究結果指,這種按資訊價值選擇互動的方式,在多項 benchmark 中較被動方法和直接進行互動的方法取得更高任務成功率,同時減少互動次數及執行時間;不過,推斷質量和硬度仍取決於固定提舉軌跡、重複測量及機械人本身的 proprioception。

項目主頁

Categories: Agentic, 模型訓練, Google, NVIDIA, World-Action Model, Robotic, 框架, Dataset 數據集

Page 20 of 38
1 … 18 19 20 21 22 … 38