VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

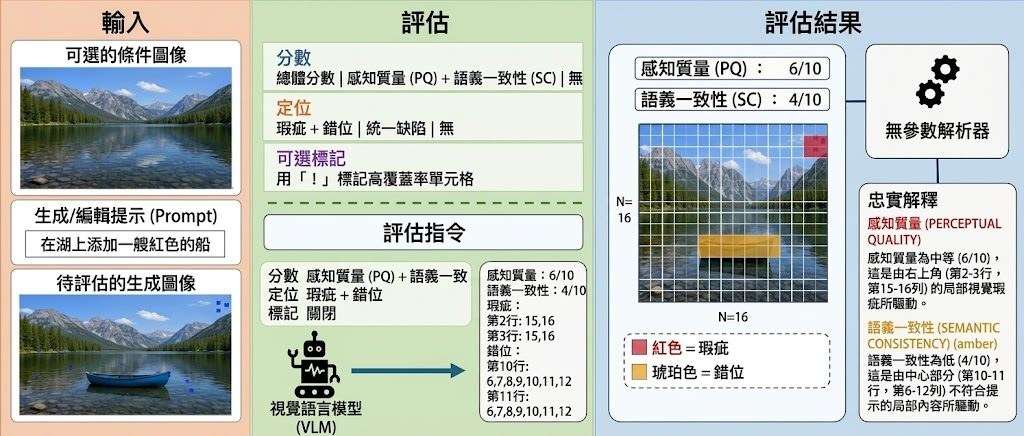
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

WorldSonus 為影片補上可互動立體聲音

WorldSonus 將影片動態、文字指令和立體聲音同步起來,讓世界模型生成的畫面不再只有無聲場景。

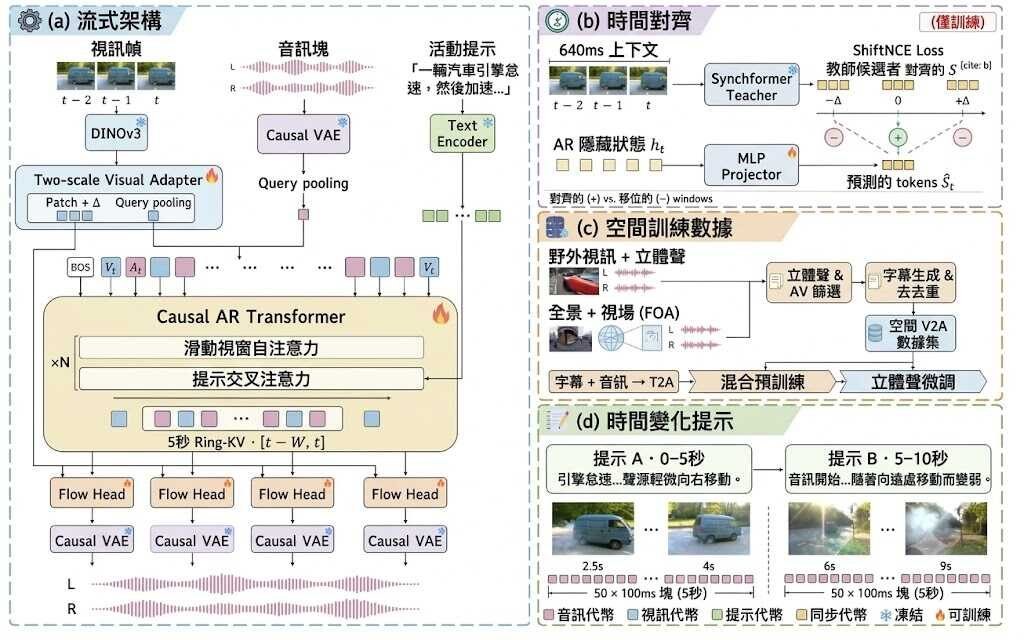
WorldSonus architecture

影片中的腳步、流水和列車聲可以隨畫面變化,甚至在生成途中接受新的文字指令。WorldSonus 是一個影片轉音訊模型,處理世界模型和互動影片缺少同步聲音的問題,並以每 100 毫秒一段的方式生成 48 kHz 立體聲。

它採用 streaming causal autoregressive diffusion 架構,讓影片畫面經過兩種時間尺度的視覺 token 後,交由 AR transformer 和 rectified-flow head 生成音訊。生成模型、audio decoder、normalization statistics,以及凍結的 DINOv3 和 T5Gemma 2 視覺/文字編碼器分工合作;文字提示可在 chunk 邊界更新,同時保留聲音連續性。

• 支援離線生成和 streaming generation,兩者使用同一條三幀生成路徑
• Visual temporal differences、Ring-KV 歷史狀態和 causal decoder convolution states 會跨 chunk 保留
• 可用影片加提示詞控制聲音,也可只用影片作條件
• 輸出為 stereo 48 kHz 音訊,片段長度會按 100 毫秒 chunk 向下取整

研究結果給出的 real-time factor (RTF) 是 0.41,並在開放領域 video-to-audio benchmark 中達到或超越部分雙向模型的聲學質素和空間對齊表現。不過參考實作沒有承諾固定延遲,模型和編碼器亦要在串流開始前載入,不能直接把 RTF 當成使用者必然取得的端到端延遲。

測試需要 Python 3.10 或以上、支援 CUDA 的 GPU、FFmpeg 和 ffprobe,GPU 驅動程式要預先安裝;設定程序會安裝 CUDA 12.4 的 PyTorch wheels。模型權重和編碼器可從 Hugging Face 下載,適合研究世界模型、影片生成、互動模擬或需要空間聲音的內容製作團隊,但硬件要求和上游模型的授權/存取條件仍需先核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, AI productions, 模型, 世界模型, NVIDIA, Gemini, Video, Audio, 提示詞, 香港, Python, Dataset 數據集

GUI-HARVEST:不改模型,讓 GUI Agent 自動進化

GUI-HARVEST 讓 GUI agent 從重複操作失敗中修改執行 harness,在不更新模型權重下提升任務表現。

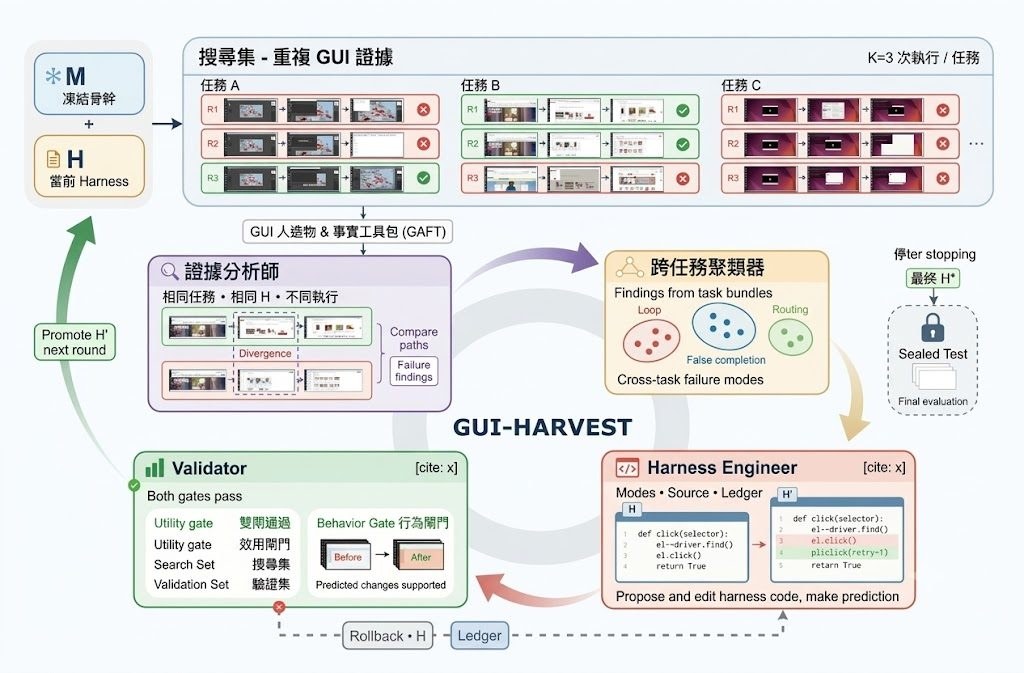
GUI-HARVEST overview

當 GUI agent 反覆在相似操作中失敗,問題未必出在模型權重,也可能是提示詞、記憶、工具介面或復原流程。GUI-HARVEST 屬於自動化 harness 演化工具,會讀取 GUI rollout,找出跨任務重複出現的行為故障,再把修正寫回 harness 原始碼。

它固定 GUI-capable model、整理失敗證據,Harness Engineer 提出帶有明確預測的修改,Validator 再按分數和行為閘門決定保留或回滾。

和 LoRA 或重新訓練模型相比,GUI-HARVEST 不需要更新模型權重,代價是改進依賴可執行 harness 的品質,以及 Search、Validation 和 Test 分割是否設計得可靠。每個候選修改都要同時滿足 ΔSearch ≥ 0、ΔValidation ≥ 0、至少一項提升、行為預測通過,以及 L0/L1 檢查;Test suite 會在優化停止後才開放一次。

測試需要另外安裝 OSWorld 和 seed harness,例如 Agent S3,再以固定 seed 按 domain 分層建立 80 個 Search、80 個 Validation 和 201 個 sealed Test 任務。項目適合研究 GUI agents、維護長流程自動化工具,或需要比較不同 backbone harness 的團隊;OSWorld-Verified 結果顯示,六個 backbone 和三種步數預算的比較中,GUI-HARVEST 均取得最高分,Qwen3-VL-32B 在 15 steps 提升 12.33 個百分點,Gemini 3.1 Pro 在 100 steps 達到 79.14%。

  • 凍結模型權重,集中改善可執行 harness
  • 從 screenshots 和 action traces 提取重複故障
  • 以 Search、Validation 和 sealed Test 控制改動風險
  • 支援固定不同模型與步數預算作比較

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 提示詞, 工具, Dataset 數據集

HelixWorld 即時生成互動視聽世界

輸入一張圖片和提示詞,再用方向指令探索場景,HelixWorld 會同步更新畫面與空間聲音。預覽版已提供瀏覽器示範及離線推理程式碼,但硬件門檻不低。

HelixWorld — Sound and vision, born together

轉身時,聲音方向也會跟着視角改變,這是 HelixWorld 與一般先生成畫面、再配上音軌的做法不同之處。它是 Noiz AI 開發的即時互動視聽世界模型,讓使用者從一張圖片和提示詞出發,以方向指令在生成場景中移動,並同步產生影像與聲音。

瀏覽器示範適合先感受互動效果;想離線測試,則可使用已公開的 Preview v1 推理程式碼和預覽模型。它目前支援 Linux、Python 3.11 和 CUDA 12.x,建議使用配備 80 GB VRAM 的 NVIDIA GPU;BF16 單卡測試約需 70 GB VRAM,對個人電腦使用者而言是明顯門檻。

操作時可輸入前進、轉向或停止等動作,並設定第一人稱視角及生成影格數;提示詞亦可分別描述影片、音訊或視聽內容。輸出會整理成 MP4,適合研究人員、互動內容創作者及想探索空間音效生成的團隊測試,但目前公開資訊未提供性能評測數據,亦未公開完整模型與訓練資料。

  • 畫面和聲音會隨鏡頭移動同步更新,空間聲場跟隨視點改變。
  • 可先用瀏覽器示範體驗,也可在符合硬件條件的 Linux 系統離線推理。
  • 預覽版已開放,完整模型、訓練資訊及報告仍待公開。

HelixWorld 展示了視聽生成從固定片段走向可操控場景的一種做法;不過,現階段的高顯示記憶體需求和有限評測資訊,令它較適合研究與原型測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, Video, Image, Audio, 提示詞, Content Creator, Linux, Python

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

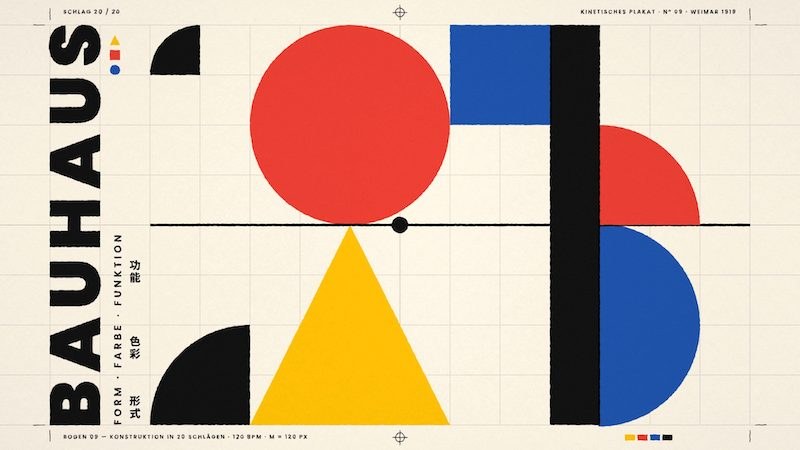
The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

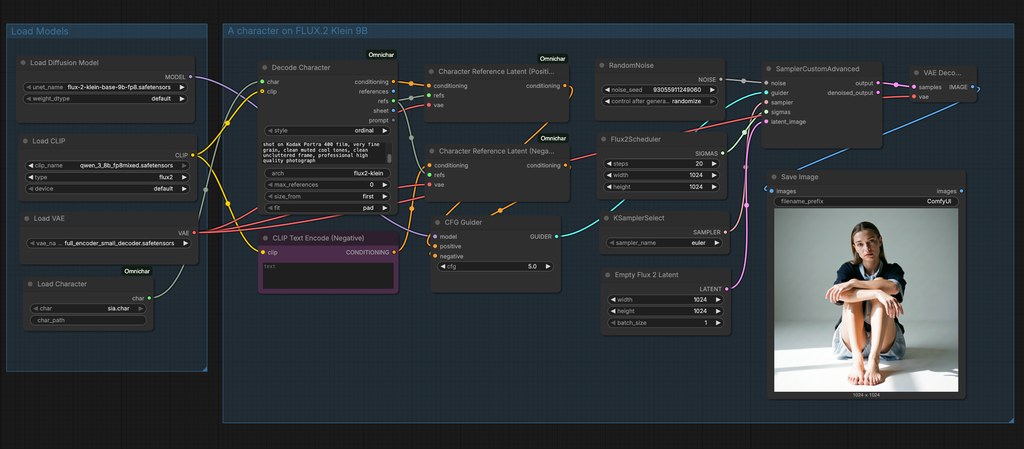
Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

Diffusion Controller:讓模型更準確聽懂提示詞

Diffusion Controller以輕量控制網絡改善提示詞對齊,同時保留原有影像質素與生成穩定性。

Og image

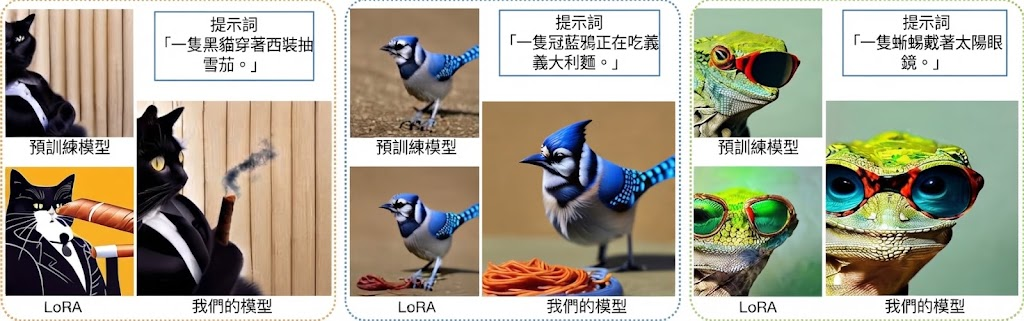
當影像模型明白你要一隻「戴太陽眼鏡的蜥蜴」,卻只生成蜥蜴,或勉強加入眼鏡後令面部變形,問題往往不在畫面是否逼真,而在提示詞要求與生成結果之間難以取得平衡。Google Research提出的 Diffusion Controller,正是針對這種提示詞對齊與影像質素互相牽制的情況而設計的輕量「steering damper」網絡。

Diffusion Controller可以接到包括 access-restricted、closed-source 模型在內的現有影像生成模型,無需改動基礎模型的核心結構,便能在生成過程中施加更精準的控制。它將原本由隨機噪聲逐步還原成影像的 denoising process,重新理解為一個連續、平滑的 control problem,讓控制訊號不必只在個別步驟中硬性修正結果。

  • 改善文字提示與生成影像之間的 prompt alignment
  • 以輕量 add-on network 控制現有模型,兼容 access-restricted、closed-source 模型
  • 在提升指令符合度的同時,維持 baseline stability 和原有影像質素
  • 將 inference-time guidance 與模型微調放入同一套分析框架
  • white-box 版本在所述測試中取得相對 baseline model 的 90% 勝率

過往做法通常分成兩條路線:一類是在 inference time 使用 classifier-free diffusion guidance,調整文字提示對生成過程的影響;另一類則透過 parameter-efficient adapters,例如 LoRA、reward-weighted regressions 或 policy gradients,對模型行為進行較重的微調。Diffusion Controller嘗試以統一的數學語言連接這些控制方式,減少工程師靠反覆試驗,在使用者偏好、提示詞要求和影像質素之間摸索的需要。

Google Research表示,Diffusion Controller的輕量版本表現優於用於配合人類偏好的業界標準方法;完全解鎖、可直接修改模型內部權重的 white-box 版本,則相對 baseline model 取得 90% 勝率。這些結果反映項目適合需要精準遵循文字描述、同時不希望破壞原有生成穩定性的影像工作流,但提供的內容未包括下載連結、安裝步驟或完整使用流程,讀者仍需等待論文或官方程式碼資料作進一步驗證。

項目主頁 · Paper

Categories: Google, Gemini, Image, 影像處理, 提示詞, 框架

阿里 WanPE 用 397B 參數重寫電影級提示詞

阿里 Wan Team 推出 397B 參數嘅電影級提示詞增強模型 WanPE,專門幫影片生成模型把簡單描述擴寫成導演級腳本。

Wan logo

用文字寫出導演水準嘅提示詞係一道高牆。普通用戶多數只會輸入「一個人喺森林行」,但頂級模型需要更細緻嘅鏡頭語言、動作編排同節奏控制,先至能夠生成高質素嘅 30 秒成片。阿里 Wan Team 推出嘅 WanPE,正正瞄準呢個痛點:佢會將用戶輸入嘅簡短描述,自動擴寫成包含鏡頭運動、燈光變化、動作節奏嘅電影級分鏡腳本,再交俾下游影片模型執行。

WanPE 採用「Video-grounded reverse construction」做法,先從真實影片反向建構出鏡頭規劃,再學習點樣由提示詞出發重建同樣嘅結構,比起由前向改寫提示詞更能保留導演意圖。同時,佢透過 Semantic-Consistency GRPO(SC-GRPO)訓練方法,確保長鏡頭、多分鏡之間嘅語意唔會走樣。整個模型以約 105 萬條真實影片訓練而成,參數量達到 397B。

沒有 WanPE

使用 WanPE 之後

團隊構建咗人類標註嘅 WanPEval 測試集,覆蓋 5 至 30 秒唔同時長同意圖粒度,並用約 11,000 組盲測配對評分做對比。當配搭 Wan3.0 影片生成器時,WanPE-397B 喺 5 至 15 秒影片將人類偏好分數提升 10.7 至 18.8 分;喺 30 秒嘅長片場景,偏好分數更大幅躍升 50.9 分。喺 5 至 15 秒組別,佢領先所有受測嘅商業方案;30 秒組別則與 Seedance 2.5 保持競爭水平。

對內容創作者、短影片團隊或者想做 AI 廣告片嘅人嚟講,呢類自動「導演助手」能夠省卻大量分鏡草稿時間;對開發者而言,佢亦可作為外掛增強模組,套用到 LTX-2.5、MiniMax-H3 等其他生成器身上做格式適配。

重點摘要

  • 397B 參數專職寫分鏡:WanPE 將用戶簡短提示擴寫為導演級電影腳本,再交俾下游影片模型執行
  • 逆向建構 + SC-GRPO:從真實影片反向學習鏡頭規劃,並透過強化學習保持長片語意一致
  • WanPEval 評測:人類標註、5 至 30 秒覆蓋、約 11,000 組盲測配對評分
  • 30 秒長片偏好激升:搭配 Wan3.0 時,人類偏好分數提升 50.9 分
  • 可遷移:經格式適配後,可應用於 LTX-2.5、MiniMax-H3 等其他生成器

項目主頁 · Paper

Categories: 南京大學, 清華大學, 阿里巴巴, AI productions, 模型, 模型訓練, Video, 提示詞, Content Creator, LTX, 中國, Dataset 數據集, MiniMax

Page 3 of 6
1 2 3 4 5 6