Envs-aware-Information-Retrieval:RAG 檢索不應一招走天涯

這項研究指出,不同檢索器需要不同改寫策略。把 retrieval 當成同一種工具呼叫,效果未必最好。

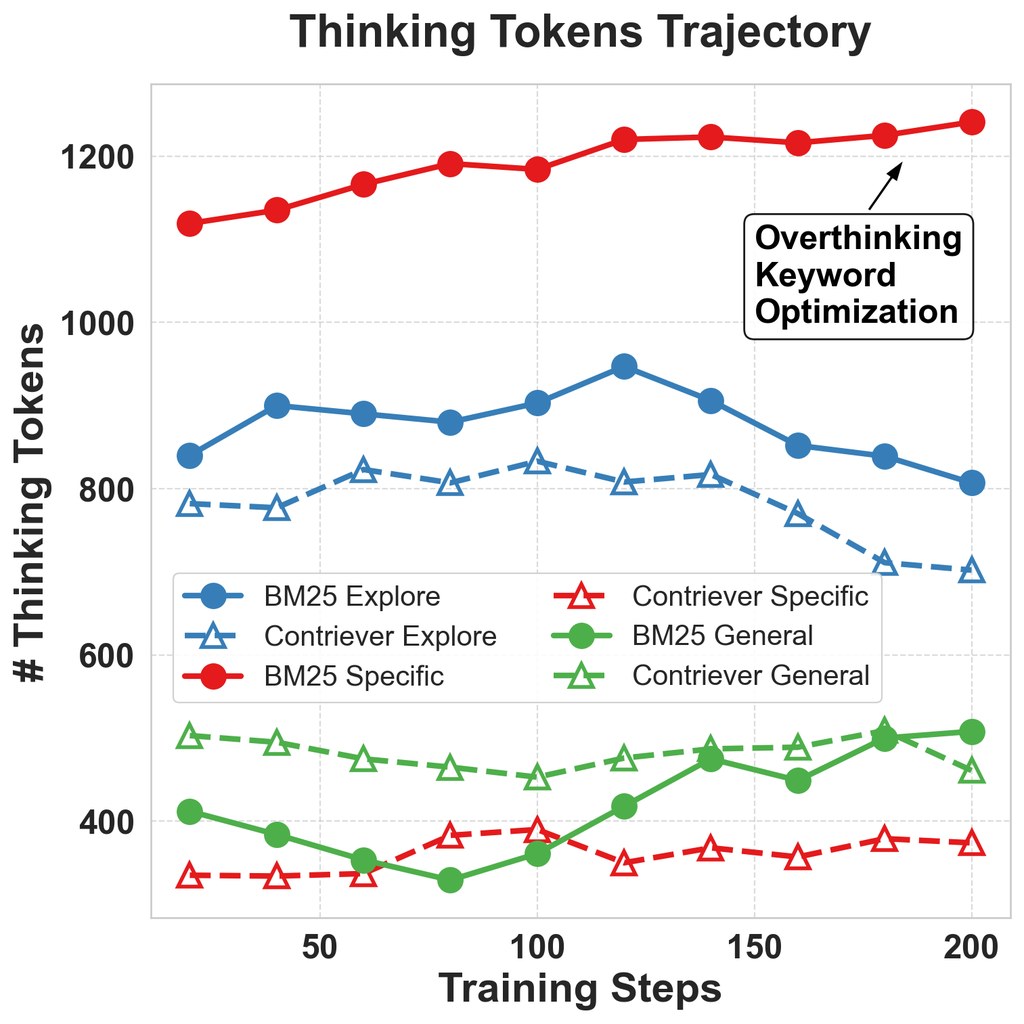
Thinking token length dynamics during GRPO training

不少 Retrieval-augmented generation 都把 retrieval 視為通用步驟:先改寫問題,再交給任何檢索器處理。這項論文反對這種 fixed generic tool-call 範式,認為限制在於查詢寫法會受檢索環境影響,同一句問題交給 BM25、Contriever、all-MiniLM-L6-v2 或 Qwen3-Embedding,最佳表達方式可以完全不同,因此提出 Environment-aware Information Retrieval 這個設定,專門研究 LLM 如何因應 retriever 改寫查詢。

項目本質上是研究型框架與實驗資源,用來解決「RAG 查詢改寫是否應按檢索器調整」這個問題。作者用 reinforcement learning(RL)訓練 query rewriter,並以 nDCG@10 當 reward;重點不只是答對與否,而是觀察模型會否學到不同 retriever 對應的語言風格。

不同檢索器之間的策略難以轉移,主要不是 search intent 變了,而是查詢的 structural 或 stylistic 形式不對。例子很清楚,BM25 偏好精簡 keyword-style queries,Contriever 則更受 document-like、statement-style rewrites 幫助;作者亦加入 retriever-specific human guidance 改善 RL 探索,並用 branching rollout 穩定 multi-turn retrieval 訓練中的 credit assignment。

如果你想測試這個項目,做法是挑同一批問題,分別接到 BM25 與 embedding-based retriever,比較原始問題、改寫後查詢,以及 nDCG@10 變化。做 RAG pipeline、query rewriting、search quality tuning 的人會特別啱用;對一般應用團隊來說,這份研究也提醒了一點:不要假設一套 prompt 或 rewrite policy 可以通吃所有 retrieval backend。

  • 這是研究型項目,核心在 retriever-aware query rewriting,而非一般聊天應用
  • 保留的相關模型與檢索器包括 BM25、Contriever、all-MiniLM-L6-v2、Qwen3-Embedding
  • 主要 technical claim 是不同 retriever 需要不同查詢風格,策略轉移性偏低
  • 訓練以 RL 進行,並用 nDCG@10 衡量檢索品質
  • branching rollout 與 retriever-specific human guidance 是方法上的兩個關鍵補強

整體來看,這不是靠更大模型硬推效果,而是重新檢視「查詢應怎樣配合檢索器」這個常被忽略的步驟。若後續公開更多 benchmark 細節與可重現結果,這個方向有機會成為 RAG 調校中的實用基線,而不只是論文中的觀察。

GitHub: https://github.com/LCO-Embedding/Envs-aware-Information-Retrieval

項目: https://huggingface.co/LCO-Embedding

Categories: 開源, 阿里巴巴, Agentic, RAG, Embedding, 模型, 模型訓練, Qwen, 提示詞, 框架, 工具

system-prompts-and-models-of-ai-tools:拆解 AI 工具幕後設定的熱門資料庫

這個專案整理多款 AI 工具的系統提示與模型資訊,方便研究產品設計方向。對開發者、研究者和內容工作者都有參考價值。

Latitude Logo

如果你一直好奇不同 AI 工具背後是怎樣被「設定」出來,這個 GitHub 專案正正提供了一個集中參考點。它主要收集各類 AI 產品的系統提示與所用模型資料,讓人可以從實際例子觀察這些工具如何定義角色、限制回應方式,以及安排功能邏輯。

對一般讀者來說,上手方式不算複雜:直接按工具名稱瀏覽內容,對比不同產品的寫法與模型選擇即可。即使你不寫程式,也可以把它當成一份 AI 產品觀察筆記,了解一個聊天機械人或助理服務背後,原來有不少隱藏規則在控制輸出表現。

這個專案最有價值的地方,在於它把分散、難找、而且經常變動的資料集中整理,節省搜尋時間。它同時提醒了一個現實問題:不少 AI 產品的內部設定一旦外洩,就可能暴露產品策略、安全風險,甚至提示設計上的弱點。

  • 集中收錄多款 AI 工具的系統提示與模型線索
  • 適合做產品研究、提示工程參考及競品觀察
  • 可用來比較不同工具的語氣、限制與任務設計
  • 亦反映 AI 產品在保安與資料外洩上的風險

從儲存庫名稱可見,內容焦點不只在提示文字,亦包括模型資訊;相關例子大致圍繞各類 AI tools 使用的模型配置,但具體覆蓋名單可能會持續更新。若你是開發者、研究 AI 產品的人、內容團隊,甚至單純想更懂 AI 回應為何有某種風格,這個專案都值得收藏,但閱讀時仍要保持審慎,因為部分資料的時效性與來源背景可能需要自行核實。

網址: https://github.com/x1xhlol/system-prompts-and-models-of-ai-tools

Categories: 開源, 提示詞

SCOPE:複雜圖片生成,點樣更少走樣?

SCOPE用結構化方法追蹤圖片要求,重點唔係盲目重生,而係逐項補救。對多條件生成特別有參考價值。

Repository image for nopnor/SCOPE

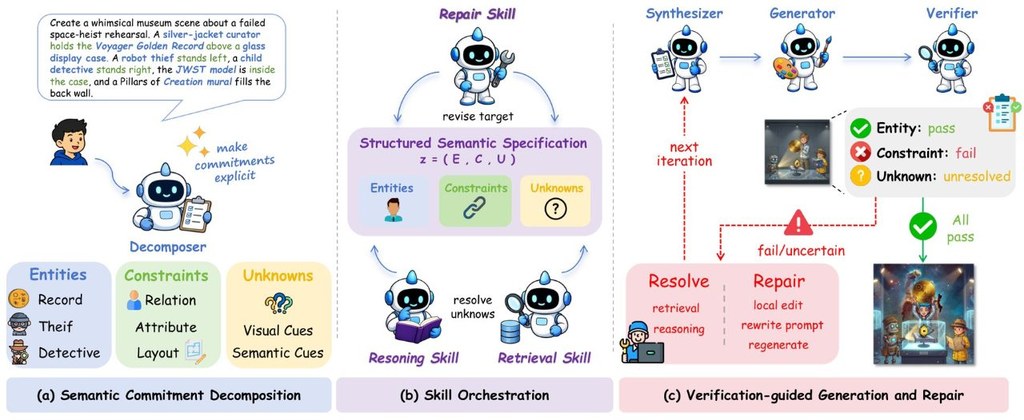
SCOPE 係一個面向複雜圖片生成嘅研究型框架,核心做法唔係單靠一次過輸入長提示詞,而係先將要求拆成可追蹤嘅「語義承諾」,例如人物、物件、關係、限制同未確定資訊。之後每個步驟都圍繞同一份結構化規格運作,減少中途遺漏要求嘅情況。

實際使用上,呢個專案比較似一套流程引擎,而唔係即開即用嘅圖片 App。使用者需要準備 Python 3.10+、設定運行環境,並按需要接駁圖片生成、驗證同搜尋等後端服務;如果想跑完整代理式工作流程,亦需要 Codex CLI。

佢最值得留意嘅創新,在於將「生成失敗咗邊一項」具體化。SCOPE 唔係見結果唔理想就整張圖重來,而係透過驗證同修補階段,集中處理未解決或違反咗嘅承諾,令後續動作更有方向,對多角色、多約束、知識密集型提示尤其重要。

  • 以結構化規格保存提示要求,而唔係只靠一段文字
  • 將檢索、推理、生成、驗證、修補串成可追蹤流程
  • 適合研究同評測複雜圖片生成效果
  • 內含配置範例、CLI 工具同 Gen-Arena 評估相關實用程式

如果你係研究人員、工程團隊,或者正測試高要求圖像任務,SCOPE 會比一般單步生成流程更有分析價值。相反,若你只係想快速出圖,呢個專案門檻會較高,因為它重點係流程控制、可驗證性同評估,而唔係簡化操作介面。

整體來講,SCOPE 展示咗一個幾清晰嘅方向:當提示變得愈來愈複雜,單靠模型「自己理解」未必足夠,最好有一套能夠持續記錄、檢查同修正要求嘅機制。以官方資料所見,佢亦配合 Gen-Arena 呢類基準做評估,令成效唔只停留喺示範圖片層面。

Source: https://github.com/nopnor/SCOPE

Categories: 開源, 香港理工大學, Gemini, 影像處理, 提示詞, 框架

Claude 4 令人驚訝的提示規則

使用 Claude 4 和許多其他進階推理模型(例如 03、Gemini 2.5 Pro 等)需要一種新型的提示詞技巧,這與舊模型的提示方式完全不同,甚至有時是矛盾的。這些技巧很多是從 Anthropic 的一篇部落格文章中擷取,直接來自創造這些模型的研究團隊的建議。

使用 Claude 4 和許多其他進階推理模型(例如 03、Gemini 2.5 Pro 等)需要一種新型的提示詞技巧,這與舊模型的提示方式完全不同,甚至有時是矛盾的。這些技巧很多是從 Anthropic 的一篇部落格文章中擷取,直接來自創造這些模型的研究團隊的建議。

Claude 4's Surprising Prompt Rules Nobody Told You
Categories: 提示詞

Page 6 of 6
1 … 4 5 6