ShotVerse2.0:讓影片生成更有電影感

從文字生成影片時,角色衣着、場景和鏡頭動作往往難以同時維持一致。FAPL 訓練多模態語言模型理解影片生成所需的時間線索,並支援分項控制。

FAPL training framework

文字生成影片時,模型不只要描寫眼前一幕,還要推斷未提供的時間變化,並在角色、場景、動作和鏡頭之間維持一致。FAPL(Factor-Aware Predictive Learning,因素感知預測學習)是一套訓練方法,旨在讓多模態大型語言模型(Multimodal Large Language Model,MLLM)的表示真正參與影片生成,而非被解碼器繞過。

它以 UniVideo 的 13B Video DiT 為基礎,不改動模型架構,而是分三階段訓練:先令 DiT 以 MLLM 潛在表示作為內容條件,再透過成對的因素編輯資料,教模型只改指定內容、保留其他因素;最後固定 DiT,訓練 MLLM 與連接器,讓只有文字或文字加完整影片的輸入都能對應同一影片目標。這讓方法同時處理文字推斷影片細節,以及按因素選擇性控制的需求。
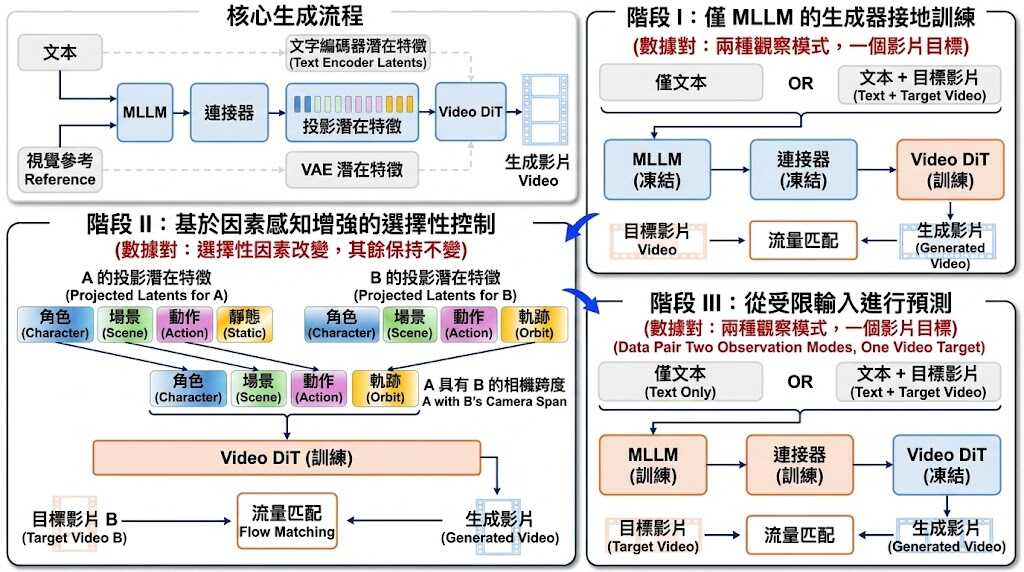
研究報告的評測中,FAPL 把 Motion Order 由 48% 提升至 61%,∩-Acc 由 42% 提升至 58%,FaceSim-Arc 則由 0.451 升至 0.523。展示案例亦呈現角色衣着和外觀較能維持一致;不過,這些數字來自指定評測,不能直接視為所有提示詞或影片情境下的保證。

目前較適合研究影片生成、希望改善多因素控制的團隊參考。GitHub 資料標示程式碼、模型權重及 CineFactor-10K 評測提示仍待發布,因此暫未能按儲存庫提供的資料安裝或重現訓練;現階段可先閱讀論文及項目網頁了解方法與示例。

  • 以 MLLM 潛在表示作為影片生成的內容條件。
  • 分開訓練內容 grounding、因素控制與有限輸入預測。
  • 可針對角色、場景、動作或鏡頭變更,同時保留其他因素。
  • 在所列評測中,動作順序、因素準確度與人臉相似度均有提升。
  • 程式碼、權重和評測提示尚未發布,現階段無法依實驗。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Video, 提示詞, 香港, 庫

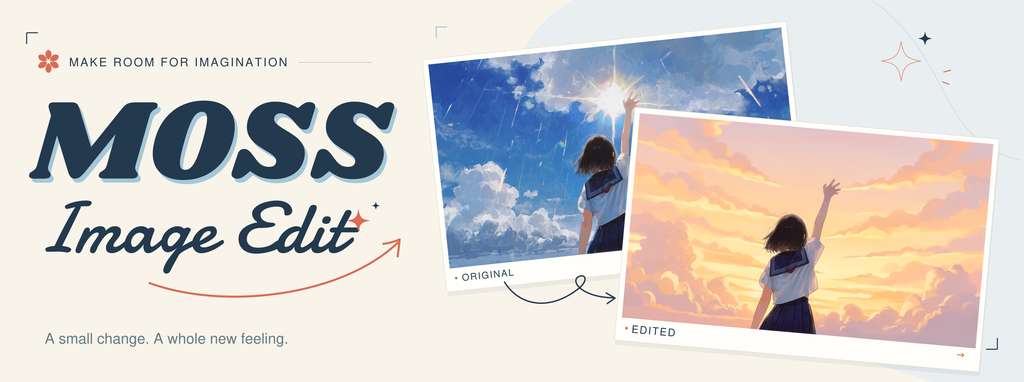
MOSS Image Edit:一句指令改圖兼支援四圖參考

把人物改成指定穿搭、表情或場景,MOSS Image Edit 透過 LoRA 串連文字與參考圖,並在 ComfyUI 重用參考資訊。

MOSS Image Edit — 用文字编辑图像

要替相片換衫、改正面表情,或將人物移到另一個場景,不一定要由人手逐項遮罩修改。MOSS Image Edit 是一個面向 MOSS-Image 的圖像編輯 LoRA,接收原圖、自然語言指令及最多四張參考圖,負責把服飾、顏色、光照、季節和畫風等要求轉成編輯結果。

發布內容只有 LoRA 權重及配置,必須配搭 MOSS-Image-Base 或 MOSS-Image-SFT,兩者擇一即可。團隊另備獨立 ComfyUI 節點與單圖、多圖工作流;下載底模和 LoRA、按指南擺放模型,再把工作流拖入 ComfyUI 即可測試,亦可調整輸出尺寸、隨機種子和採樣參數。

多圖模式不是單純追加條件:參考圖之間可互相參照,文字與目標圖則可讀取全部資訊,並要在指令內交代每張圖的用途。適合合併人物、服飾及場景參考,但最多四張圖的限制,也意味著複雜構圖仍需反覆測試提示詞與配置。

架構以 text、ref、target 三類 token 組成共享 MOSS Transformer;參考圖固定在無噪聲時間,文字及目標圖則隨去噪時間變化。參考分支只計算一次並快取各層 K/V,之後逐步重用,CFG 的正、負條件亦可共用同一份快取,減少重複運算。

  • 支援單圖指令式編輯
  • 最多連接四張參考圖
  • 可配搭 Base 或 SFT 底模
  • 提供 ComfyUI 單圖及多圖工作流
  • 沒有公開量化評測或推論供應商整合資料

內容團隊、做商品視覺或社交媒體配圖的人,會較容易感受到其價值。它目前更像是 MOSS-Image 生態中的可調編輯模組,而非一開即用的獨立模型;正式採用前仍應以自身相片、指令及輸出尺寸測試一致性、資源需求與授權條件。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, Image, 影像處理, 提示詞, LoRA

Google Harness² 讓 Agent 自我改良執行系統

Harness² 能在模型不變下,按任務改進提示詞、工具與技能,並將經驗沿用至後續任務。

Harness²

Agent 的落差往往不只來自模型能力,提示詞、工具配置、記憶和任務編排同樣影響結果。Google Research 開源的 Harness²,便是一個處理這層「執行系統」的研究框架:它固定模型權重,先按眼前任務調整 harness,再把成果與經驗帶到下一項任務。

它的核心是兩層遞迴。Task-level recursion 透過 Propose–Probe–Compose,先提出修改、在相同任務測試效果,再整合有效部分;Harnessing-level recursion 則把已採用的 harness 與有證據支持的經驗寫入持久 improvement harness,協助後續改進。這種取捨是把資源由重新訓練模型,轉向持續優化模型周邊配置。

  • 模型權重固定,主要改進 prompts、tools、memory、skills 與 orchestration。
  • 不依賴標準答案,以同一任務不同執行結果的行為差異作為回饋。
  • 支援 parallel、sequential recursion,以及 OpenCode、Codex executors。
  • 可配合 JobBench、LAB、WorkBuddy-Bench 測試。

在四種 model–harness 組合中,Harness² 為 GLM-5 與 Gemini 3.5 Flash 的基礎 harness 帶來提升:WorkBuddy-Bench 最高增加 11.5 分,JobBench 增加 4.5 分,LAB partial pass rate 增加 11.8 個百分點;提高 task-level recursion budget 還可繼續增加結果。不過,資料涵蓋三個專業 benchmark,尚不足以證明所有工具和模型組合都能受惠,而且每輪提出、測試及整合會增加執行成本。

需要多工具、複雜編排或持續接力的 Agent 團隊,較能感受到這種架構的價值;維護者可用 JobBench 流程建立環境,再按自身 executor 與評估基準測試。研究人員亦可沿用遞迴設計,但應核對額外呼叫、錯誤傳播及 improvement harness 累積錯誤等問題。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, Gemini, 提示詞, 框架, 工具, Dataset 數據集, Skill 技能

SCOPE 讓文字提示詞按語意學習

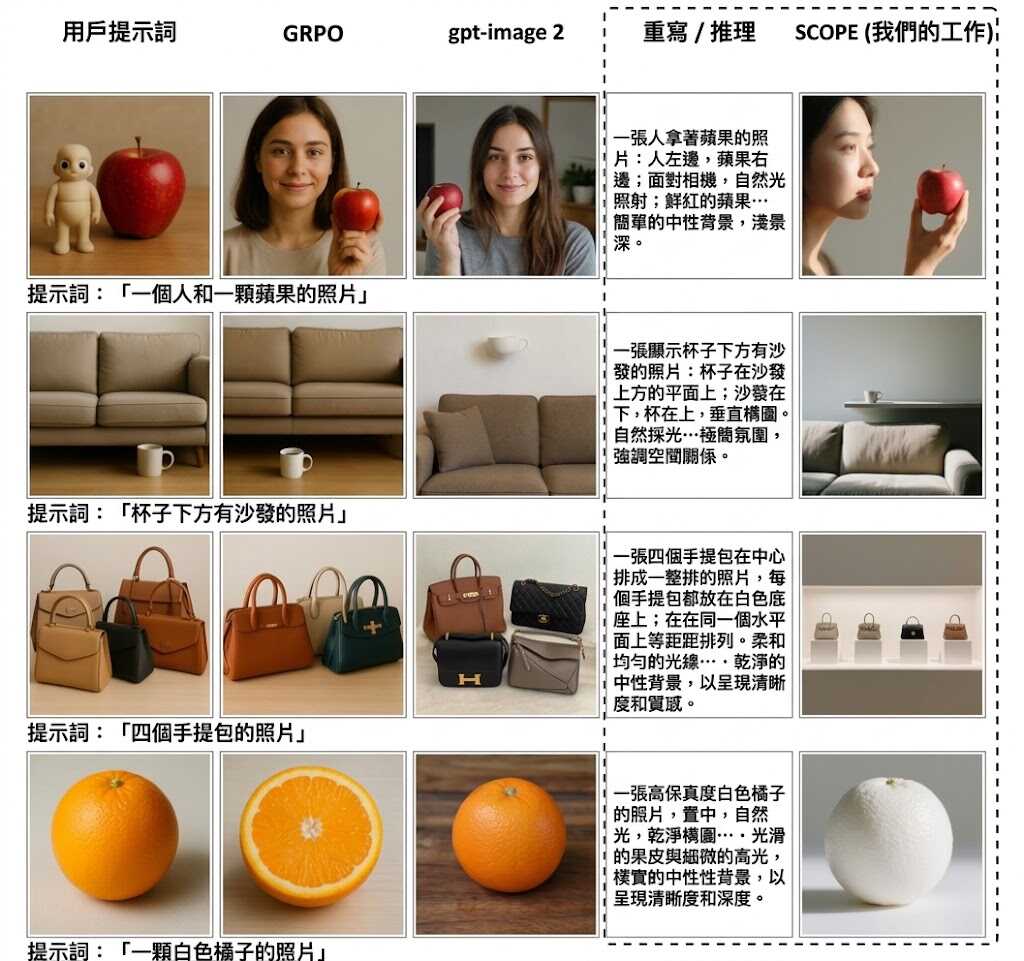
文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

Uniform token GRPO versus SCOPE span credit.

當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。

SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

VIS-Ground 讓互動影片真正記住前文與要求

觀眾暫停影片後提出要求,VIS-Ground 會把來源、已播內容與指令整理成可驗證的生成約束。

VIS-Ground teaser

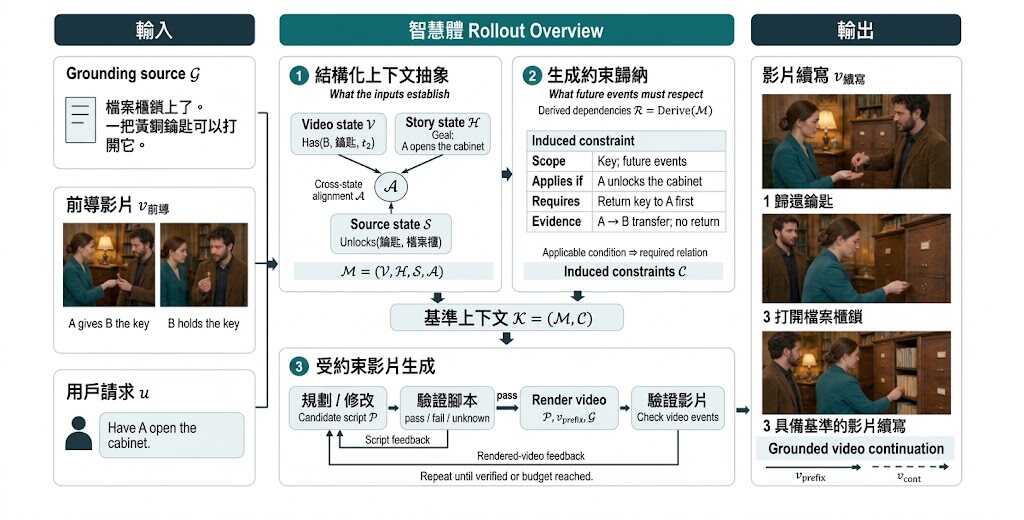
觀眾要求「用船運藥,而且不要弄濕」時,系統不能只理解一句新指令,還要記得橋已斷、目的地是祖母家,以及故事原本交代的背景。VIS-Ground 屬於互動影片生成研究框架,處理的正是來源資料、影片前段與觀眾介入之間容易互相牴觸的依賴關係。

它先以 Structured Context Abstraction 對齊 grounding source、已渲染的 video prefix 和 viewer request,再以 Generation Constraints Induction 抽取對下一段影片真正有關的條件,最後經過 plan、verify、revise、render 循環,檢查成片是否同時符合劇情連貫、知識來源和觀眾要求。這比單純把新提示詞交給影片生成器更重視前文約束,但代價是流程更複雜,也需要額外驗證。

  • 以可執行 constraint model 連接文字來源、影片內容與互動指令
  • VIS-Bench 包含 250 個 sources、1,004 個 viewer interventions 和 2,008 個 instances
  • 評估涵蓋 source faithfulness、story continuity、interaction fulfillment 及 joint score
  • 在 Omni-1.1-Flash、Veo 3.1 和 MiniMax-H3 三個 video backbones 均取得最高 composite score

Composite score 為 Omni-1.1-Flash 84.2、Veo 3.1 84.6、MiniMax-H3 78.8,較各自最強 baseline 高 12.3、15.3 和 3.4 分;提升主要集中在 story continuity。這些結果反映方法能跨越不同影片生成 backbone 工作,但資料只涵蓋 1,004 個互動介入,未足以代表所有敘事類型。

適合研究互動敘事、可控影片生成和多模態代理的團隊,用來測試「觀眾改變故事後,生成結果能否守住既有事實與新限制」。GitHub 目前只列出代碼、VIS-Bench 資料和評估腳本預告在 2026 年 12 月 15 日前釋出,因此暫時缺乏可按步驟安裝及本地測試的完整資訊。

項目主頁 · GitHub

Categories: 開源, AI productions, 多模態模型, Video, 提示詞, 框架, Dataset 數據集, MiniMax

Video-RSI:不改模型權重,讓影片代理自行進化

Video-RSI 透過改寫提示詞、工具、記憶與執行邏輯,提升影片理解代理的準確度及取樣效率。

Video-RSI framework: Solver execution, active video investigation, and cost-aware harness evolution.

影片理解代理遇到答錯問題時,未必需要重新訓練模型。Video-RSI 是一個開源框架,讓代理重新檢視影片,補充視覺、字幕及 OCR 證據,再把失敗原因轉化為可重用的程式修改;模型權重則保持不變。

項目由 Solver 和 Editor 配合:Solver 執行影片問答,Editor 調查失敗案例,並演化 prompts、tools、memory 及 execution logic。相比只調整模型參數,這種做法把改善集中在可執行 harness,較適合需要快速反覆修正工作流程的研究團隊。

  • 透過額外視覺、transcript 及 OCR 證據分析錯誤
  • 以 accuracy 和 visual-frame cost 共同篩選修訂版本
  • 提供 Initial harness、final harness、inference 及 evolution framework
  • 預設支援 DeepSeek-V4-Pro 和 Qwen3.6-Plus 等 OpenAI-compatible service 模型

評測會在私有 Gate set 以答案準確度及視覺影格處理成本配對選擇版本。項目資料所述結果指向更佳的 accuracy–efficiency trade-off:演化後 harness 在維持競爭力準確度的同時,處理較少影格,但未有公開具體分數或基準逐項差距。

要測試項目,需要 Linux、Python 3.12、兼容 API 服務,以及本地 RapidOCR 3.9.2 PP-OCRv6 small detection and recognition models;影片輸入採 JSONL,包含問題、選項、片長及絕對路徑,也可載入 faster-whisper large-v3 產生的 transcript。需要留意,允許 provider calls 會使用付費模型 API,因此成本控制和本地 OCR 準備是部署前的重要取捨。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Qwen, DeepSeek, API, Video, 提示詞, 框架, 工具, Linux, Python

用 5 百萬次人類投票煉成的文生圖獎勵機制,公開給開源社群

Arena.ai 提出一套文生圖模型的後訓練方法,把人類偏好分數加上自動評分量尺,結果讓 FLUX.2-dev 與 Ideogram 4 同時衝上排行榜高位。你可以把它理解成幫文生圖模型「補課」的兩條評分線。

Og image

文生圖模型越來越強,但要靠後訓練再往上推,卻卡在同一個難題:到底要拿什麼訊號當作優化目標。Arena.ai 這項工作直接把答案拆成兩條互相補位的獎勵線,再把他們公開給社群參考。

第一條線來自 Text-to-Image Arena 上大約 500 萬組真實人類對決投票,用 Bradley–Terry 目標訓練出一個偏好獎勵模型,負責衡量視覺品質、構圖、美感這些廣義的好看與否。這個偏好模型在 MMRB2 基準上比其他獎勵模型表現更好,而且訓練資料越多,後訓練成果也越好。

第二條線則對應一個偏好資料看不到的問題:圖片可以極漂亮,卻把提示詞裡的物件寫漏、多塞東西,或者走偏要求的風格。Arena.ai 用視覺語言模型自動產生一組評分量尺,針對提示詞忠實度、相關約束、以及常見的獎勵漏洞行為打分,把這些規則式分數一起混入優化目標。

比起 Flow-GRPO 或 DiffusionNFT 這類只靠單一獎勵訊號的後訓練方法,這套組合給人的差別感在於:美感與合規不再互搶資源。經過他們的後訓練食譜,FLUX.2-dev 在 Arena 即時文生圖排行榜上多了 69 分,Ideogram 4 更拿到 1224 分,超越 2026 年 9 月 4 日之前所有公開上架的開源模型。

項目主頁 · Paper

Categories: 開源, 模型訓練, Image, txt2img, 提示詞, 教學, Dataset 數據集, 強化學習

SuperNav 讓多模態模型指揮機械狗導航

由多模態模型處理找物件、按次序到訪及高層次指令,SuperNav 把導航變成可觀察、可評估的代理工作流。

SuperNav

當指令由「找出籃球」延伸至「先找打印機,再找垃圾桶」,SuperNav 以 Agentic Navigation System 的形式處理場景理解、路線行動與任務進度。項目實際解決的是機械人面對不同場景和非固定指令時,難以只靠預設導航流程完成工作的問題。

系統由預訓練多模態模型 (multimodal model) 作決策,再透過工具、task-progress tracking 和 context management 將決定轉成移動行動,不需要為導航專門微調模型。Codex、OpenCode 或 Kimi 都可作為代理執行端,任務、工具與 Skills 則透過實驗設定組合,彈性高於寫死單一路線,但結果仍會受模型判斷及工具能力影響。

作者提供 agent runtime、導航工具、Skills、實驗配方及評估工具,支援 Habitat-GS 和 AI2-THOR。測試時可先在模擬環境執行單物件、多物件和 demand-driven navigation,再查看 RGB 觀察、軌跡、tool calls、提示詞、工具結果及原生記錄;儲存庫目前沒有真實機械人驅動程式,Unitree Go2 的示範主要來自研究項目展示。

研究結果指出,SuperNav 在單物件、多物件及需求導向導航的成功率高於所比較的基線,並展示 Unitree Go2 實體部署。可留意的限制是,資料只交代高於評估基線,未提供足夠細節讓讀者單靠儲存庫重現所有真實機械人測試。

  • 適合場景: 室內找物件、依次到訪多個目標,以及較高層次的整理要求
  • 可觀察性: 即時查看 RGB 影像、軌跡和工具呼叫,完成後再檢查記錄
  • 模型關係: 多模態模型負責決策,SuperNav 負責工具協調、進度追蹤與導航執行
  • 測試範圍: Habitat-GS、AI2-THOR,並有 Unitree Go2 示範

研究團隊、具身 AI 開發者和需要比較導航代理的人,會較容易從這個開源項目受益;一般使用者則要先準備相應模型服務、模擬環境和實驗設定,不能把儲存庫直接當成已包裝完成的機械人應用。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 多模態模型, 模型訓練, Image, 提示詞, 工具, 庫, Kimi, Skill 技能

Page 2 of 6
1 2 3 4 … 6