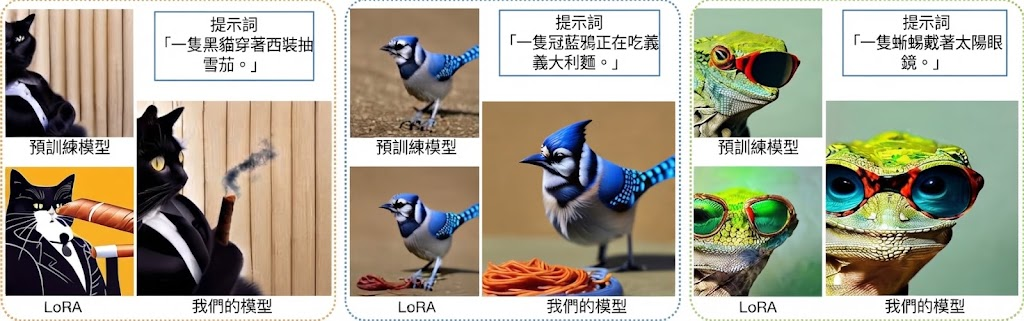
當影像模型明白你要一隻「戴太陽眼鏡的蜥蜴」,卻只生成蜥蜴,或勉強加入眼鏡後令面部變形,問題往往不在畫面是否逼真,而在提示詞要求與生成結果之間難以取得平衡。Google Research提出的 Diffusion Controller,正是針對這種提示詞對齊與影像質素互相牽制的情況而設計的輕量「steering damper」網絡。
Diffusion Controller可以接到包括 access-restricted、closed-source 模型在內的現有影像生成模型,無需改動基礎模型的核心結構,便能在生成過程中施加更精準的控制。它將原本由隨機噪聲逐步還原成影像的 denoising process,重新理解為一個連續、平滑的 control problem,讓控制訊號不必只在個別步驟中硬性修正結果。
- 改善文字提示與生成影像之間的 prompt alignment
- 以輕量 add-on network 控制現有模型,兼容 access-restricted、closed-source 模型
- 在提升指令符合度的同時,維持 baseline stability 和原有影像質素
- 將 inference-time guidance 與模型微調放入同一套分析框架
- white-box 版本在所述測試中取得相對 baseline model 的 90% 勝率
過往做法通常分成兩條路線:一類是在 inference time 使用 classifier-free diffusion guidance,調整文字提示對生成過程的影響;另一類則透過 parameter-efficient adapters,例如 LoRA、reward-weighted regressions 或 policy gradients,對模型行為進行較重的微調。Diffusion Controller嘗試以統一的數學語言連接這些控制方式,減少工程師靠反覆試驗,在使用者偏好、提示詞要求和影像質素之間摸索的需要。
Google Research表示,Diffusion Controller的輕量版本表現優於用於配合人類偏好的業界標準方法;完全解鎖、可直接修改模型內部權重的 white-box 版本,則相對 baseline model 取得 90% 勝率。這些結果反映項目適合需要精準遵循文字描述、同時不希望破壞原有生成穩定性的影像工作流,但提供的內容未包括下載連結、安裝步驟或完整使用流程,讀者仍需等待論文或官方程式碼資料作進一步驗證。