GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。
項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

ExpActivator:讓 GUI 代理學懂何時啟用個人經驗

ExpActivator 不再把所有相關歷史硬塞進每一步,而是按畫面、時間與情境判斷哪些經驗真正適用。

當個人 GUI 代理執行多步任務時,相關歷史未必適合每一個畫面;ExpActivator 把這個取捨轉化成經驗啟用問題。它屬於免訓練的個人 GUI 代理框架,處理歷史操作何時應該介入當前決策,以及何時應該保持沉默。

逐步啟用會把新畫面放入凍結 GUI backbone 的 latent space,尋找相近的歷史狀態,再把對應動作交給 policy 作參考,代理可以採用、修改或拒絕。任務級啟用則只會在時間和情境都支持時提出重複意圖,否則選擇 abstain;相比把整段檢索歷史附加到 context,歷史不再被視為每一步都有效。

PersonalAlign 評估涵蓋 775 個個人化執行 episodes、7,915 個 actions,以及 215 個正面和 100 個負面 proactive suggestion states,測試 Qwen3-VL-8B、MAI-UI-8B、Qwen3.5-9B 和 GUI-Owl-1.5-8B。以 Qwen3-VL-8B 為例,ExpActivator 的開首步驟成功率為 70.06%,後續步驟為 26.67%,高於無歷史的 28.26%和 18.43%;研究頁亦報告平均軌跡步驟成功率提升約 28%,proactive suggestion 的 MCC 約為最強基線的 2.3 倍。

適合研究個人化 GUI 代理、重複工作流程和主動建議的團隊測試。項目不會訓練模型或預測參數,PersonalAlign 提供安裝及執行流程,但需另取 PersonalAlign 的 Fingertip20k;記憶應採用每位使用者按時間排列的前 80%,避免與執行測試 episodes 重疊。

  • 按畫面逐步啟用歷史動作,而非只按任務檢索
  • 按時間與情境判斷是否提出主動建議
  • 凍結 backbone,無需重新訓練模型
  • 同時測試個人化執行與 proactive suggestion
  • 依賴外部 Fingertip20k 歷史資料及多個 GUI backbone

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 庫, UI/UX

InstantFusion 讓不同影像模型接力生成

InstantFusion 把不同 diffusion models 接到共同 latent space,令模型可以中途交接、加速生成,亦能混合不同偏好。

InstantFusion — A Shared Latent Interface for Image Generators

當一張圖的生成工作需要在 Qwen-Image、FLUX.1 或 SD3 之間切換,InstantFusion 讓去噪軌跡可以在中途交接。這個開源研究項目屬於影像模型工具,處理的是不同 diffusion models latent space 不相容,難以直接接續生成的問題。

核心是 Latent Alignment Encoder(LAE):模型專屬的 encoder 和 decoder 先把各自 latent 映射到 shared latent space,再以重建、cross-reconstruction、latent alignment 及 denoising-velocity alignment loss 保留圖像資訊和去噪動態。模型本身維持 frozen,LAE 負責建立彼此之間的轉換接口。

完成對齊後,生成軌跡可以交由另一個模型繼續處理,帶來三種用途:
– 不同步數預算的模型接力,嘗試縮短生成時間
– 結合針對不同偏好優化的模型
– 在 shared latent space 進行 cross-model OPD,以模型 A 的 velocity field v 蒸餾模型 B

LAE 重建測試涵蓋 Qwen-Image、FLUX.1 和 SD3,並以 100 張圖片計算 mean SSIM;介面驗證亦顯示,單次 latent round trip 能保留較高 fidelity,但反覆轉換會累積 reconstruction error。這意味着模型接力有實用價值,但不適合無限制地來回切換。

儲存庫包括 LAE training、OPD training 和 LAE-based model handoff inference,適合研究 heterogeneous image generators、模型融合或生成加速的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 上海人工智慧實驗室, 模型, 模型訓練, Qwen, Stable Diffusion, Image, 影像模型, 香港, 工具, 庫

VisionWeave 讓多模態模型按畫面分配細節

VisionWeave 按內容保留重要視覺細節,減少冗餘視覺 tokens,兼顧長影片理解效率與任務質素。

VisionWeave logo

長影片、圖表和文字密集畫面不需要每個位置都用同樣精細度處理。VisionWeave 屬於多模態模型(MLLMs)效率優化項目,讓模型按視覺內容決定保留細節或壓縮表示,處理視覺 tokens 過多所造成的成本與延遲問題。

VisionWeave 不是固定比例刪減 tokens,而是把 fine-grained 與 coarse-grained representations 編織起來,讓重要區域保留較多資訊、背景使用較緊湊的表示。項目針對 dense Qwen3.5 提供影像及影片 inference,評測則涵蓋 Qwen3.8-27B 與 Qwen3.5-4B,並比較 FastV、VisionZip 等固定預算方法。

Qwen3.8-27B 在八項 benchmark 平均節省 43.0% visual tokens,同時保留 98.9% 原生模型表現。於 SGLang、兩張 A100-80GB 和 BF16、TP=2 條件下,LongVideoBench throughput 由每分鐘 0.90 個請求升至 2.07 個,平均 TTFT 亦由 169.90 秒降至 77.54 秒。

  • 按畫面內容自動調節視覺表示粒度
  • 適合長影片、自然場景、圖表及文字密集影像
  • 在多項任務與不同輸入解析度下衡量效率與質素取捨
  • README 提供的 checkpoint 需另行取得,完整安裝流程在目前資料中未交代

研究團隊同時提供 image/video inference,但儲存庫資訊未列出下載連結、硬件最低要求或完整測試步驟,因此較適合作為研究評估和 SGLang serving 實驗起點。對需要處理長影片、多張影像或高解析度輸入的模型團隊,VisionWeave 提供了比固定 token 預算更靈活的壓縮方向;代價是要配合指定 Qwen 模型與額外 checkpoint,未必能直接套用到其他架構。

項目主頁 · GitHub

Categories: 開源, 多模態模型, Qwen, Video, Image, 庫, Dataset 數據集

StereoBind 讓生成聲音跟隨畫面移動

StereoBind 不只同步影片與聲音,還嘗試讓聲音方向跟隨畫面中的發聲物體移動,為沉浸式生成補上空間感。

StereoBind logo

當畫面中的車輛、人物或物件移動,聲音不應只在時間上同步,還要讓聽者感覺聲源位置一同改變。StereoBind 屬於聯合影片與音訊生成模型的研究項目,處理的正是立體聲與可見聲源之間的動態空間對應問題,面向 AR/VR、互動遊戲及沉浸式內容製作較有價值。

StereoBind 在預訓練的 joint audio-video generator 上加入視覺來源的 motion tracks,將畫面中的移動軌跡傳給音訊生成流程。Simple Summary Tokens 壓縮來源內容與動態資訊;Spatial Track Encoder(STE)編碼每個時間點的標準化 2D 位置;ResidualTrackRoPE 則把相對軌跡變化加入 temporal attention,令模型同時理解聲源所在位置及移動方向。

  • 以軌跡連接視覺來源與 stereo audio
  • StereoWorld-29K 提供附帶 motion tracks 的立體聲影音資料
  • StereoWorldBench 用來量度聲音是否跟隨可見聲源
  • 目標是改善空間對齊,同時保留整體影音品質

StereoWorld-29K 不只是訓練資料,亦包含由真實影片及軌跡控制合成場景整理而成的幾何監督;StereoWorldBench 則針對聲音與畫面來源在時間上的空間一致性作評估。項目資料稱實驗能大幅改善立體聲生成的空間對齊,但目前提供的資訊未列出具體分數、基準模型或延遲數據,因此未能判斷它在不同場景的實際優勢幅度。

GitHub 儲存庫目前仍屬公開發布前狀態,inference code、training code、設定檔、checkpoints、StereoWorld-29K 及評估套件尚未提供,亦沒有可照做的安裝流程。研究團隊、影音生成模型開發者,以及需要聲音方向隨畫面移動的 AR/VR 和遊戲製作流程,可以先把它理解成一套待公開的 trajectory-conditioned 聯合生成框架;現階段較適合閱讀研究概念及等待後續資源,而不是立即部署。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Video, World-Action Model, Audio, 框架, 庫, Dataset 數據集

ProgramGym:程式重製代理訓練

由可驗證環境到持續開發流程,ProgramGym 把程式重製代理的訓練推向長流程任務。

ProgramGym logo

要令 coding agent 重建一個未公開實作的程式,單靠規格並不足夠,還要探索參考執行檔、推斷行為、設計架構,再反覆修正。ProgramGym 屬於面向程式重製代理的訓練環境與工作流程項目,透過 Program-Env 和 Program-Agent 處理測試環境難以大量建立、長時間開發容易失去脈絡兩個問題。

Program-Env 會由真實 repository 建立參考 executable 和 runtime sandbox,再以驗證回饋逐步產生 behavioral tests;Program-Agent 則把分析、實作和 review 分開處理,利用持續保存的交接紀錄與 revision checkpoints,讓代理可以延續多輪工作,而不是每次重新理解整個程式。

項目目前提供 ProgramGym-1648 dataset,涵蓋 Go、C++、Rust 和 C,共 1,648 個可驗證任務,其中 Go 有 818 個。資料集適合用來訓練或比較 coding agents,尤其是需要黑盒探索、跨多個修訂階段,以及重視行為相容性的工作情境。

• Program-Env 負責建立 executable、sandbox 和行為測試
• Program-Agent 分拆分析、實作與 review 流程
• 任務涵蓋四種系統程式語言及八個領域
• Qwen3.8-27B 基準分數由 34.87% 提升至 42.84%
• 配合 Program-Agent 後,分數提升至 55.71% 或 56.25%

測試結果顯示,Qwen3.8-27B 配合 Program-Agent 達 55.71%,Qwen3.8-27B-SFT 則達 56.25%,較各自基準明顯提升,但仍低於 Claude Opus 4.8 的 70.9% 和 GPT-5.6 Sol 的 69.9%。GitHub 儲存庫主要是資訊中心,提供論文、項目網站及 Hugging Face 資源連結;原始資料沒有交代完整安裝或本地執行步驟,使用者需要先按相關資源了解取得方式。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, Vibe Coding, 庫, 編程, Dataset 數據集

[技術文章] HARNESSSQL 讓 SQL 代理在真實資料庫中學習

SQL 代理不再只需一次生成查詢,而是在可執行資料庫內探索、修正錯誤並完成任務。

Hero image preview

面對陌生資料庫,SQL 代理往往要先查看 schema、檢查欄位和值,再執行試探查詢、分析錯誤,最後修訂並提交 SQL。HARNESSSQL(Harness-Native Training for SQL Agents in Realistic Database Environments)是一套面向這類互動流程的後訓練框架,針對模型訓練只學習「問題直接對應查詢」、但推理時才加入執行工具的落差作出修正。

傳統 Text-to-SQL 通常把資料庫視為靜態提示內容,難以涵蓋長時間、多回合的探索。HARNESSSQL 建立隔離且可執行的資料庫環境,配合隱藏的 execution oracles,讓教師模型直接在目標 SQL harness 內完成互動,並只保留經驗證的操作軌跡進行 full-sequence SFT,之後再以 execution reward 進行 RL。

項目的核心做法包括:
• 將 schema 檢查、工具呼叫、查詢執行及錯誤修正納入訓練流程
• 以 sandbox 控制資料庫狀態,保存結果與錯誤回饋
• 只使用可驗證的成功軌跡,減少錯誤示範干擾
• 讓模型適應 Spider 2.0-SQLite 的互動式任務

在 Spider 2.0-SQLite 上,Qwen3-8B 的 execution accuracy 由 15.5% 升至 45.2%,Qwen3-14B 則由 22.2% 升至 54.8%;訓練所得能力亦能轉移至 BIRD-Interact 和 LiveSQLBench。結果反映,資料庫代理要處理複雜工作流,訓練階段同步保留執行 harness,比只在推理階段補上工具更能縮小訓練與使用環境的差距。

Paper

Categories: 開源, 香港科技大學, 清華大學, Agentic, 模型, 模型訓練, Qwen, 微軟, 框架, 香港, 工具, 庫, 強化學習

WeKnora 把企業知識庫變成可問、可做、可追溯的 AI

WeKnora 將 RAG、Agent 與 Wiki 放進同一個知識庫,兼顧企業資料整合、任務執行和私有化部署。

WeKnora: find the answers, and put knowledge to work. Tencent

不只可以問文件內容,WeKnora 會幫你用 AI 操作工具、整理 Wiki,並保留已確認的偏好與事實。WeKnora 是一個開源 LLM 知識框架,處理企業文件理解、語意檢索與多步推理;RAG、Agent 和 Wiki 共用同一套知識庫,減少資料分散造成的落差。

RAG 會結合語意及關鍵字檢索,回答附上原文引用;Agent 可搜尋網頁、呼叫 MCP 工具、執行技能,並在沙箱中處理檔案。Wiki 則把文件整理成互相連結的頁面與知識圖譜,支援編輯、差異比較和版本回滾,適合需要持續維護內部知識的團隊。

  • 支援 PDF、Word、圖片、Excel、XMind 等十多種格式
  • 可同步飛書、Confluence、GitLab、Notion、語雀、RSS 等來源
  • 透過企業微信、飛書、Slack、Telegram、MCP Server 或 API 提供服務
  • 具備多空間 RBAC、審計日誌、任務佇列及 Langfuse 追蹤

模型、向量資料庫及儲存後端都可以替換,內置 29 家模型供應商,包括 OpenAI、DeepSeek、Qwen、Gemini、MiniMax、LiteLLM 和 Ollama。v0.8.2 加入本機瀏覽器操作、MCP Server、對話分叉與回滾,令知識庫不再只負責回答問題,也能參與任務流程。

Docker、Kubernetes、Helm、Lite 單機版及桌面應用都在支援範圍內,資料可以留在本地或私有雲。對重視資料留存、內部協作和可追溯性的企業,這套整合度具備明確吸引力。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, RAG, MCP, Qwen, OpenAI, DeepSeek, Gemini, Image, 框架, KnowledgeGraph, Ollama, 庫, Anthropic, MiniMax, Skill 技能

OneSearch-VL:多模體視覺 deep research agent

由單張相片到影片片段,OneSearch-VL 會找出視覺線索、搜尋外部資料,再把證據串成可核對的答案。

OneSearch-VL

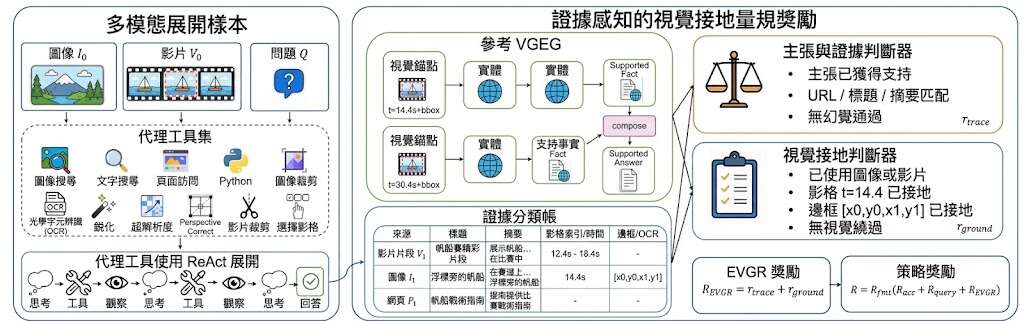
由一張相片、相片集合到影片片段,OneSearch-VL 會先定位視覺線索,再檢索外部知識,將相關證據組合成答案。它屬於多模態 deep research agent,處理的是影像內容理解與資料查證之間難以銜接的工作。

核心是 Visually Grounded Evidence Graph(VGEG),把視覺錨點、來源支持的事實和產生答案所需的操作連在一起。VGEG 亦支援資料建立及驗證;Evidence-aware Visual-Grounded Rubric reward(EVGR)則在強化學習中監督證據是否可追溯,以及答案有沒有真正對應影像內容。

項目提供 OneSearch-MI-Bench 和 OneSearch-Video-Bench,分別面向多圖及影片研究能力。輸入資料未列出具體分數或模型名稱,因此不能把它描述成已全面勝過其他視覺研究方案;它較適合用作研究原型、訓練資料管線和 agentic workflow 的基礎。

OneSearch-VL 包含 Agentic SFT、Agentic RL、推理及評估相關目錄,並標示 Python 3.11+;先準備模型、資料集和外部工具,再執行訓練或評估流程。對需要查核圖片來源、比較多張圖片,或從影片整理證據的研究團隊,這種統一處理方式較容易整合到既有工作流,但部署成本和工具依賴仍要自行確認。

• 同時支援單圖、多圖集合及影片
• 以 VGEG 統一視覺線索與外部證據
• EVGR 強調證據可追溯及視覺對齊
• 提供多圖與影片專用 benchmark
• 支援 SFT、RL、推理和評估流程

GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Video, Image, 工具, Python, 庫, Dataset 數據集, 強化學習

VibeEdit:以畫布指令精準指定影像編輯位置

圈選、畫線或拖動就能指定修圖位置,VibeEdit 以空間標記處理相似物件難以辨認的問題。

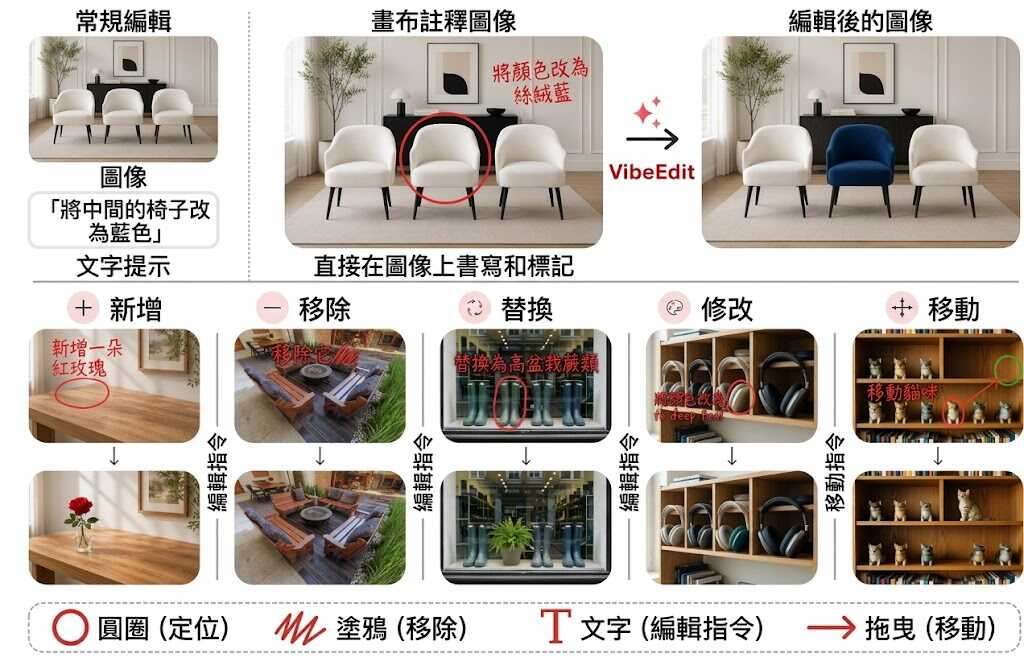
VibeEdit enables image editing with canvas instructions, including circles, scribbles, short notes and drag gestures.

圈選物件、畫幾筆線,或在圖片上拖動指定位置,再補上一句短註記,便能要求模型新增、移除、替換、改變屬性或移動內容。VibeEdit 屬於影像編輯模型,處理的是文字提示難以準確指出相似物件和局部區域的問題。

它採用 Qwen-Image-Edit,以 layer-decoupled conditioning 分開編碼原圖與 canvas instruction,再配合 region-weighted supervised fine-tuning,以及 rubric-guided reinforcement learning(RL)改善局部修改、指令完成度和未編輯區域的保留。訓練資料包含 155 萬組 source–target edit pairs、物件遮罩和結構化編輯描述,畫布指令則由這些資料生成。

  • 支援新增、移除、替換、屬性修改及移動物件
  • 不要求獨立文字提示,空間標記直接表達目標位置
  • 以 419 個人工整理案例測試相似物件選取能力
  • VLM(Vision-Language Model)評分為 79.9,outside-region PSNR 為 32.8 dB
  • 對比 FireRed 的 67.4 分及 24.0 dB,局部編輯和區域保留均較佳

對需要精準修圖的設計、內容製作和研究團隊,畫布指令比長篇描述更容易表達「改哪一件」;但模型仍屬研究項目,程式碼標示為 Coming soon,暫時不能按儲存庫直接安裝或自行重現。評測規模亦只有 419 個案例,結果未必涵蓋所有圖片類型和複雜編輯情境。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 庫, 強化學習

Page 6 of 17
1 … 4 5 6 7 8 … 17