MobileForge:手機 GUI Agent 訓練新路線

MobileForge 想解決手機 GUI Agent 太依賴人工標註的老問題。它把真實 App 互動變成訓練資料與回饋流程。

MobileForge Logo

MobileForge 是一個用來調整 mobile GUI agents 的研究型訓練框架。它主要解決手機操作代理往往要靠人工寫任務、示範或獎勵標籤,成本高又難快速轉去新 App 的問題。

常用做法 human-written tasks、demonstrations 或 reward labels 去訓練,作者認為這種固定範式有兩個限制:生成的任務未必貼近目標 App,rollout 只得到稀疏成敗訊號,也很難轉成可重用的步驟級學習訊號。MobileForge 的處理方式是把目標 App 的真實互動交給 MobileGym,先做探索、抽取 executable curricula,再用 HiFPO 把 hints、hierarchical trajectory feedback 和 step-level GRPO training 串成一個不用任務標註的調整流程。

這個取向不是單靠更大模型硬推成績,而是重新整理資料來源與訓練單位:任務來自 target-app interaction,回饋不只看最後成功與否,還會拆成 outcome labels、process feedback 和 corrective hints。代價也很明顯,整個流程依賴真實 Android app 互動環境,部署與測試較像研究實驗管線,而不是裝好即用的消費級工具。

根據項目較合理的理解方式是:先取用作者釋出的 codebase、HuggingFace models、datasets 與 benchmark results,再在 Android 任務環境重跑 exploration、rollout、training、evaluation 幾個部分。它較適合做 mobile agent 研究、行動自動化、GUI policy optimization 的團隊,也適合想比較 annotation-free adaptation 與傳統人工標註流程差異的人。

  • 類型定位:研究型框架,核心是 annotation-free adaptation
  • 方法骨幹:MobileGym 負責探索與任務生成,HiFPO 負責回饋轉訓練訊號
  • 已公開模型:GUI-Owl-1.5-8B、Qwen3-VL-8B 的 MobileForge 版本
  • 結果重點:GUI-Owl-1.5-8B 在 AndroidWorld 達到 67.24% Pass@1、77.59% Pass@3;MobileWorld 為 41.03% SR
  • 取捨:減少人工標註依賴,但需要較完整的互動環境與實驗流程支持

MobileForge 同時展示 in-domain AndroidWorld adaptation 與 out-of-domain MobileWorld GUI-only generalization,表示它不只是在單一資料分佈內調參。對想建立可遷移手機代理能力的團隊來說,這個項目提供的價值不只是模型 checkpoint,還包括一套如何把真實 App 操作痕跡轉成訓練循環的具體方法。

GitHub: https://github.com/kwai/MobileForge

項目主頁: https://mobile-forge.github.io/

Model: https://huggingface.co/collections/lgy0404/mobileforge-models
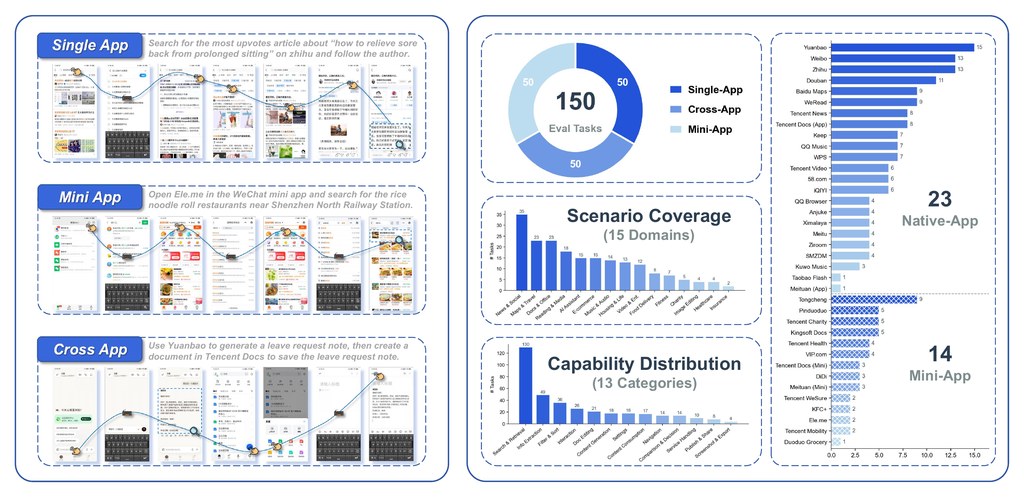
Categories: 開源, 清華大學, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 工具, Dataset 數據集

PhoneBuddy:訓練手機代理的雙路徑做法

PhoneBuddy 是訓練開放式手機代理的研究項目,重點在結合真實 App 與模擬環境。它想解決手機代理難以同時兼顧真實性與可擴展訓練的問題。

PhoneBuddy logo

PhoneBuddy 是一個開放式 phone-use agent 訓練研究項目,也是面向手機操作代理的模型訓練配方。它主要解決的問題,是讓代理不只會看畫面點擊與輸入,還能同時從真實手機執行回饋與可重設、可驗證的模擬環境中持續改進。

現有 mobile agents 常被當成 GUI controller 來訓練或評測:看螢幕、點擊、輸入、滑動,再重複下一步。PhoneBuddy 指出,單靠真實 App reinforcement learning(RL)雖然更貼近真機,但成本高、難重設、驗證麻煩;只靠 PhoneWorld 風格的 mock-app RL 又較易擴展,卻未必完全反映真實手機情境,所以它採用 real-app RL 加 mock-app RL 的混合路線。

這個取向的重點,不是單純把資料加多,而是把兩種訊號分工:真實執行提供 realism,模擬環境提供 resettable 與 verifier-backed tasks。根據公開頁面,PhoneBuddy-4B 在 Real+Mock RL 後,AndroidWorld 成功率達 83.2%,比只做 real-app RL 平均高 5.0;不過 cross-app 任務只有 18.0,反映跨 App 長流程仍是明顯短板。

現階段較適合把它理解成研究原型加公開模型,而不是完整可即裝即用產品。公開資訊顯示已有 Hugging Face 模型,包括 PhoneBuddy-4B、PhoneBuddy-4B-RealApp 與 PhoneBuddy-0.8B;但 code release、evaluation documentation 仍在補,dataset 亦未公開,所以目前較合理的測試方式,是先比較不同 checkpoint 的能力定位,再配合 PhoneWorld、PhoneHarness、PhonePrivacy、PhoneSafety 這條研究線一併理解。

  • 核心差異:把 real-app RL 的真實性,與 mock-app RL 的可驗證擴展性結合
  • 已公開模型:PhoneBuddy-4B、PhoneBuddy-4B-RealApp、PhoneBuddy-0.8B
  • 公開成績:AndroidWorld 83.2%,平均比 real-app RL only 高 5.0
  • 主要限制:cross-app 表現偏低,資料集未公開,程式與評測文件仍未齊備
  • 較適合人群:研究 Computer-use agents(CUAs)/手機代理、做 agent training、benchmark 或安全與私隱分析的團隊

想了解「手機代理怎樣訓練得更像真機、又不至於每次都要真人手動重置環境」,PhoneBuddy 的判斷相當清晰:真實世界負責可信度,模擬世界負責規模。它未必已經提供完整部署流程,但作為 open phone-use agents 的訓練方向,取捨、限制和下一步研究空間都表達得很明確。

GitHub: https://github.com/PhoneBuddyAI/phonebuddy

項目主頁: https://phonebuddyai.github.io/

項目: https://huggingface.co/PhoneBuddyAI/PhoneBuddy-4B

Categories: 開源, 香港中文大學, 騰訊, Agentic, 模型, 模型訓練, Qwen, OpenAI, Gemini, 香港, 安全, 中國, Dataset 數據集

BioMatrix 把生物序列與 3D 結構放進同一模型

BioMatrix 嘗試用同一個模型同時理解分子、蛋白質、3D結構與文字。它的重點不只是多模態,而是連生成方式都統一起來。

BioMatrix

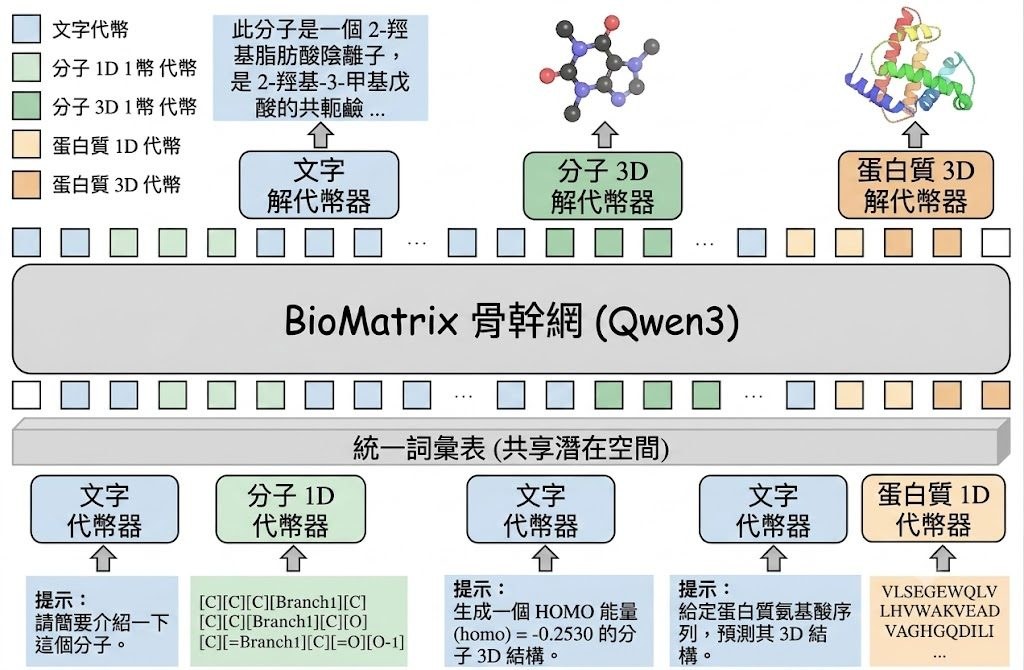
BioMatrix 是一個多模態 foundation model,建立在單一 decoder-only 架構之上。它要解決的問題,是把 molecules、proteins、1D sequences、3D structures 與自然語言放進同一套生成流程,令模型不只可讀取不同資料,也可用同一個 next-token prediction 目標處理與輸出它們。

現有 biological foundation models 通常分成兩類:一類可在共享目標下融合多模態,但多數只集中單一 entity type;另一類雖然覆蓋 molecules 與 proteins,卻常常欠缺顯式 structural modeling,或者依賴 adapter-based designs、external encoders、projection adapters 與 modality-specific output heads。BioMatrix 的取向很鮮明:直接把 SMILES、SELFIES、分子 3D、蛋白質序列、蛋白質 3D 同自然語言映射到 shared discrete token space,將「可讀」與「可生成」統一。

技術上,這個項目最值得留意的是 unified tokenization scheme。分子 3D 用改良版 MolStructTok,蛋白質 3D 用 GCP-VQVAE,並以 description-based embedding initialization 把新增 token 先對齊到 pretrained Qwen3 embedding space,再做 continual pretraining;這種做法比起後加模態接頭更完整,但訓練成本亦明顯更高,官方資料提到曾用 64 張 NVIDIA H100 GPUs 配合 LLaMA-Factory 訓練。

從 GitHub 與 Hugging Face 現有資訊看,這個項目較適合當作模型下載與研究評測基線使用,目前可找到 BioMatrix-1.7B-Base、BioMatrix-4B-Base、1.7B-SFT、4B-SFT 等版本。若你想測試,較合理的理解方式是先用已發佈模型做推理或任務比較,再按需要研究其 tokenizer,例如 MolStructTok 與 GCP-VQVAE;完整重訓對一般團隊門檻很高。

  • 模型定位:多模態 biological foundation model,不是單一分子模型或單一蛋白質模型
  • 核心差異:把 sequences、structures、language 放入同一 shared discrete vocabulary,而非靠外掛式模態模組拼接
  • 相關模型:Qwen3 1.7B、Qwen3 4B、BioMatrix-1.7B-Base、BioMatrix-4B-Base、BioMatrix-1.7B-SFT、BioMatrix-4B-SFT
  • 數據與訓練:涵蓋 text、PubChem、MolTextNet、UniRef50、RCSB PDB、UniProt/Swiss-Prot、AFDB 及 cross-entity interleaved data
  • 表現指標:論文稱 instruction tuning 後涵蓋 80 個 tasks、6 個類別,當中 77 個 tasks 達到 state-of-the-art 或具競爭力

這個項目最受惠的會是做 drug discovery、protein engineering、生物資訊研究,或者想把文字問答、分子表示與結構生成放進同一工作流的團隊。它的野心很大,優勢是統一表示與任務泛化,限制則是部署與訓練門檻高,而且論文聲稱的廣泛表現仍要看你手上的任務是否屬於那 80 個測試範圍。

GitHub: https://github.com/QizhiPei/BioMatrix

項目主頁: https://huggingface.co/collections/QizhiPei/biomatrix

Paper: https://arxiv.org/pdf/2606.22138

Categories: 開源, 上海人工智慧實驗室, Embedding, 模型, 多模態模型, 模型訓練, Qwen, Medical醫學, 3D, 中國

MemSlides 把簡報生成變成可記憶代理

MemSlides不是一次過出投影片,而是把簡報寫作當成可持續修改的流程。它用分層記憶處理個人化與多輪修訂。

MemSlides hierarchical memory and localized revision overview

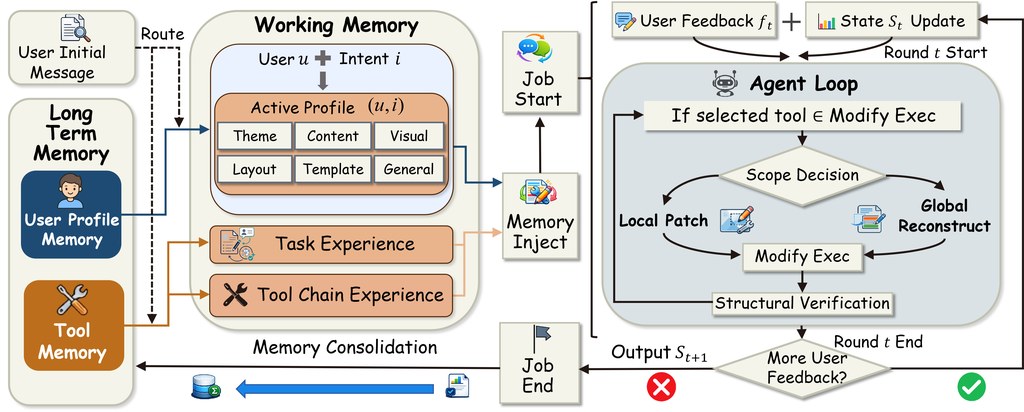
不少簡報生成工具仍然走 one-shot source-to-slides conversion:丟一份材料進去,整份投影片一次生成,之後每次修改又大範圍重做。MemSlides 把問題改寫成 stateful authoring process,核心不是單次輸出,而是記住你是誰、這一輪想改甚麼,以及過往哪些工具操作較可靠。

這是一個 Agent Framework,目標是解決 personalized slide generation 與 multi-turn local revision 兩個常見痛點。它把記憶拆成 user profile memory、working memory、tool memory:前者保存跨工作重覆出現的偏好,中段記住當前簡報的限制與暫時要求,後者則保留工具鏈執行經驗,方便之後做相似修改時少走彎路。

跟同類做法相比,最需要留意的是它不主張每次收到新意見就重生整副 deck,而是做 scoped slide-local revision,只更新受影響的最小區域。這種取向的好處是修改更穩定,較易保留原本好的內容;代價是整體品質會依賴記憶管理與局部編輯判斷是否準確。

從倉庫資訊看,這個項目較適合研究 presentation agents、企業內部簡報自動化,或要反覆為不同角色產出版本的團隊。倉庫亦提供 Docker Hub、網站、示範影片與論文連結,理解方式可先看 demo,再決定用容器部署還是按 Python 3.11 與 Node 20 的環境自行搭建;不過公開資訊未見完整量化基準,現階段較像研究型框架,而非已標準化的產品方案。

  • 把簡報生成由一次性輸出改成有狀態的寫作流程
  • 分層記憶是重點:user profile memory、working memory、tool memory
  • 修改時傾向局部修補,不是整份重生成
  • 適合需要 persona-aware 內容、反覆修訂、多人協作的情境
  • 相關元素包括 presentation agents、multi-turn revision、localized editing、tool-chain execution

GitHub: https://github.com/huohua325/Memslides

項目主頁: https://memslides.github.io/

Categories: 開源, 清華大學, Agentic, 框架, 工具, IDE, Python NLP, Python, 庫

PerceptionDLM:多區域圖像描述加速方案

PerceptionDLM 把多個區域描述改成並行生成,重點不是只追準確度,而是連速度一齊納入比較。

icon

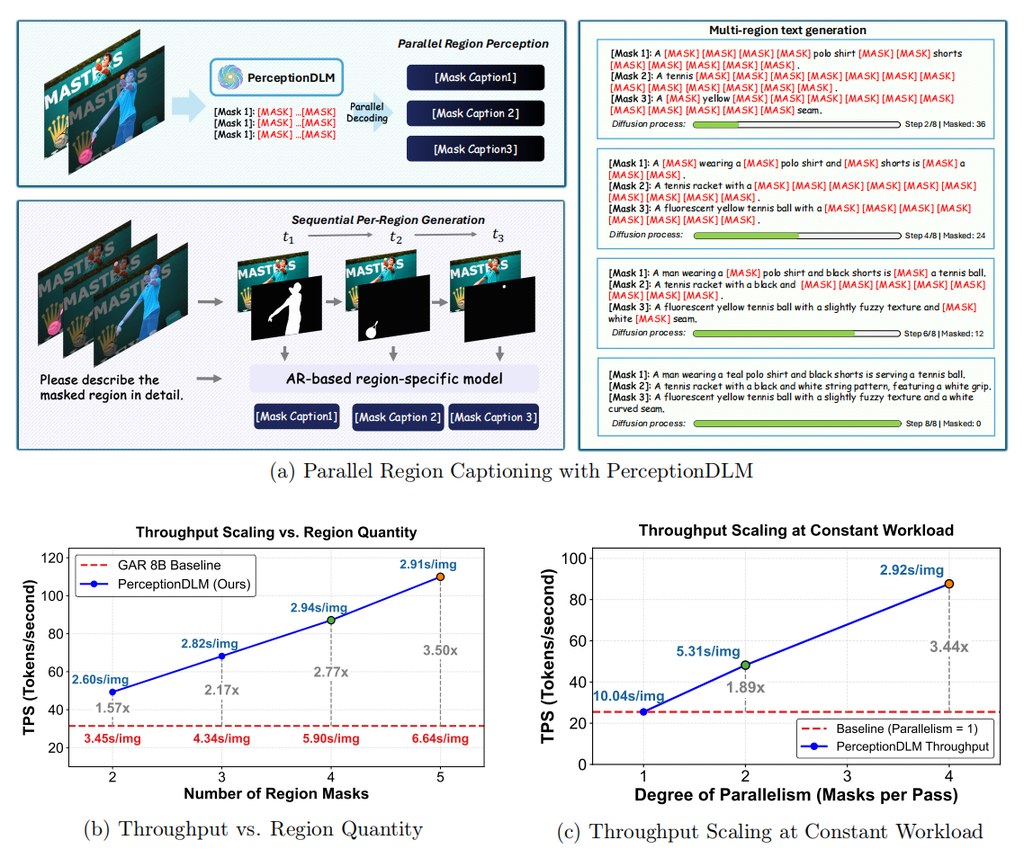
現時不少 Multimodal Large Language Models (MLLMs) 做區域描述時,仍然依賴 autoregressive (AR) 逐段生成:一張圖有幾多個 mask,就要逐個區域慢慢解讀。PerceptionDLM 提出的方向很明確,改用 Multimodal Diffusion Language Model,同一輪 denoising process 內同時輸出多個區域描述,目標是解決多區域感知在延遲上隨數量線性上升的問題。

這是一個偏向模型加基準測試的開源項目:核心是 PerceptionDLM 與 PerceptionDLM-Base,另加 ParaDLC-Bench、PerceptionDLM-Data 和 Bee / Honey 系列訓練資料配方。作者點名批評舊範式主要卡在 autoregressive region captioning,因此加入 efficient prompting 與 structured attention masking,讓平行生成不只停留在概念,而是落到 sequence level 同 token level。

從公開資料看,這個項目較適合以 Hugging Face 已釋出的模型、資料集與 evaluation suite 來理解和測試;想重現結果的人,亦可沿住訓練資料配方、Training 與 Evaluation 流程部署。對一般開發團隊而言,最有參考價值的不是安裝細節,而是它示範了 diffusion VLM 怎樣處理「多區域同時描述」這種以往較少由 DLM 承擔的任務。

  • 單次 denoising pass 可同時描述多個 masked regions,官方稱在密集多區域情境可有最高 3.4× throughput speedup
  • PerceptionDLM-Base 據稱在 16 個 multimodal benchmarks 之中,15 個勝過 LLaDA-V
  • ParaDLC-Bench 不只看 caption quality,也把 inference efficiency 一併納入
  • 已公開 code、model weights、training data recipe、evaluation suite,重現門檻比只放論文低

它較適合做視覺理解、圖像標註、自動資料整理,或者需要一次看多個區域的研究團隊。限制也很清楚:目前公開資訊主力強調 benchmark 與吞吐提升,對一般產品場景的記憶體需求、延遲分佈與部署成本仍要再看實測;相關模型則包括 PerceptionDLM、PerceptionDLM-Base,以及其 backbone LLaDA-8B-Instruct,對比對象則有 LLaDA-V。

GitHub: https://github.com/MSALab-PKU/PerceptionDLM

項目主頁: https://msalab-pku.github.io/projects/PerceptionDLM/index.html

項目: https://huggingface.co/collections/MSALab/perceptiondlm-model-zoo

Categories: 開源, 北京大學, 字節跳動, 模型, 視覺模型, 多模態模型, 模型訓練, Stable Diffusion, 提示詞, Dataset 數據集

Holo-World 把天氣與鏡頭控制放進影片生成

Holo-World嘗試用一張圖生成可控影片,同時處理鏡頭、物件移動與天氣變化。它瞄準的是世界模型裡最難兼顧的一致性問題。

Repository image for XiangchenYin/Holo-World

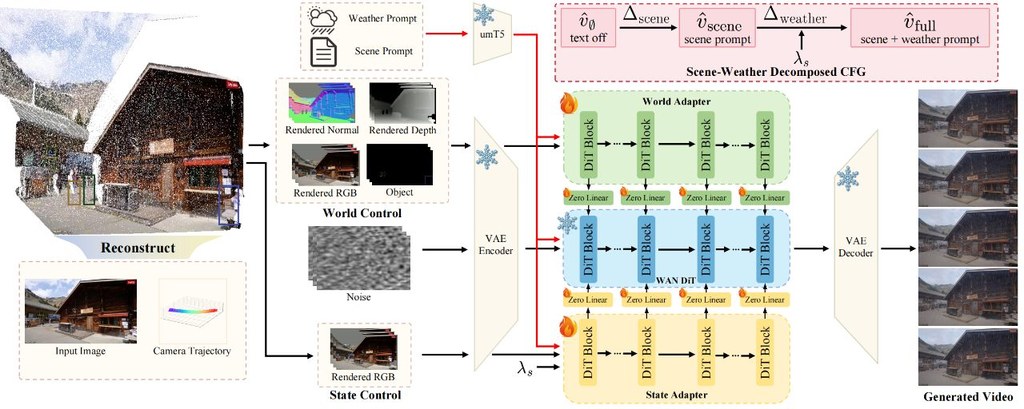
Holo-World 是一個Video World Model項目,目標不是單純把靜態圖片變成短片,而是由單張首幀出發,按照指定的鏡頭路徑、物件動態與天氣指令生成影片,盡量保留原本場景結構。對一般讀者來說,可把它理解成「你先給一個世界起點,再要求系統改變拍攝方式與天氣,但不要連場景骨架都改走」。

它和常見影片編輯做法的分別,在於不少方法要先有來源影片,甚至依賴已經包含未來結構的重建場景;Holo-World 則強調 first-frame-anchored source-to-state 設定,只由一張圖開始。這種取向更靈活,但難度也高,因為模型要自己補出後續畫面,同時維持鏡頭控制、物件位置和天氣效果不互相打架。

這個項目核心包含 HoloStateData、Unified Scene Adapter 與 Scene-Weather Decomposed CFG。前者是為相機、物件、天氣建立統一監督樣本的資料集;後兩者則把「場景保持」與「天氣轉換」分開處理,目的是減少下雨、下雪、起霧時把整個場景細節一併沖散的情況。論文與項目頁提到,量化與視覺結果都顯示它在 weather-state generation 上優於 video-to-video weather editing baselines,但目前倉庫內容仍偏研究展示,未見完整安裝與推理流程,較適合先當作研究方向理解。

  • 可由單張圖片出發,而非必須先提供完整來源影片
  • 同時控制 camera、object、weather,比單一條件生成更完整
  • 重點取捨在於維持場景結構一致,同時讓天氣效果夠明顯
  • 較適合研究 world model、可控影片生成、合成場景模擬的團隊

如果你關心自動駕駛模擬、生成式影片控制,或想研究世界模型如何把幾種控制訊號整合,這個項目很有參考價值。相關模型與組件可留意 Holo-World 本身,以及資料集 HoloStateData;從現有資料判斷,它現階段更像研究型模型與方法展示,未必是即裝即用的生產工具。

GitHub: https://github.com/XiangchenYin/Holo-World

項目: https://xiangchenyin.github.io/Holo-World/

Categories: 開源, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 工具, 庫, 中國

VisualClaw:會進化的視覺代理

VisualClaw 不只是接駁模型的工具,還把記憶、技能與影片處理串成可持續改良的代理系統。

VisualClaw icon

現時不少 vision-language agents 主要靠固定提示、整段影片送入模型,或者一次性工具調用去完成任務;作者認為這種 fixed scaffold 容易令延遲、成本同提示長度一齊上升,而且部署後幾乎唔會自己累積經驗。VisualClaw 因而提出一個 modular multimodal agent system,夾在 Claude Code、Codex、OpenClaw 同上游 LLM providers 之間,加入 retrieved memory、skill bank、self-evolution、video processing 同 evaluation hooks。

這個項目屬於框架兼工具型基建,重點唔係再訓練一個新模型,而係幫 Computer-use agents、tool-using vision-language agents 更有效處理影片、工作空間同多輪任務。配套的 VisualClawArena 則是獨立 benchmark/data release,收錄 200 個 scenario,要求代理真正在 workspace 內用影片證據、文件、動態更新與 executable checks 解題,補回一般 video-QA benchmark 對工具使用情境測試不足的缺口。

把它當成 gateway proxy,用熟悉的 OpenAI 或 Anthropic 相容介面接到現有 agent workflow,再逐步打開 skills、memory、video cascade 等模組。對已經在用 Claude Code 或 Codex 的團隊,這種接法尤其實用,因為毋須由零重寫整個代理流程。

  • 核心結構清楚:gateway design 加上 pre/post hooks,方便在提示前後插入技能、記憶與評測。
  • 創新位具體:以 hybrid encoding 處理 streaming video,配合 cascaded gate、keyframe context、hot/cold top-k injection,目標是壓低成本而保留關鍵視覺證據。
  • 會累積經驗:self-evolution 會根據失敗回合與成功記憶更新 skill bank,唔係每次都由同一套靜態提示開始。
  • 評測唔只看答對:VisualClawArena 把多輪問題、影片、workspace 操作同評估輸出綁埋一齊,更接近真實代理任務。

在 4 個 video-QA benchmarks、2 個 VLMs(Gemini 3 Flash、GPT-5.2)上,VisualClaw 對 full-frame upload 的每題 API 成本平均可減 98%,相對 offline uniform 8 frame baseline 亦再降 25.9%,同時多數設定下準確率有提升。到 VisualClawArena,配合 Codex(GPT-5.5)與 Claude Code(Sonnet 4.6)等 backend,macro accuracy 分別提升 2.9% 同 3.2%;如果你關心的是可插拔代理基建、多模態工作流,或者想為 live vision 與影片任務加上可持續進化能力,這個項目比單純模型包裝器更有研究同落地價值。

GitHub: https://github.com/UCSC-VLAA/VisualClaw

項目: https://ucsc-vlaa.github.io/VisualClaw/

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, OpenAI, Gemini, API, Video, 框架, Vibe Coding, 工具, IDE, Mac, 編程, OpenClaw, Anthropic, Skill 技能

BadWorld:如何解決癱瘓視覺世界模型的未來推演

香港理工大學團隊提出無需標籤的對抗攻擊框架,揭露 Matrix-Game-2.0 與 Astra 等世界模型在單一擾動圖下即可能全面崩潰的結構性脆弱。

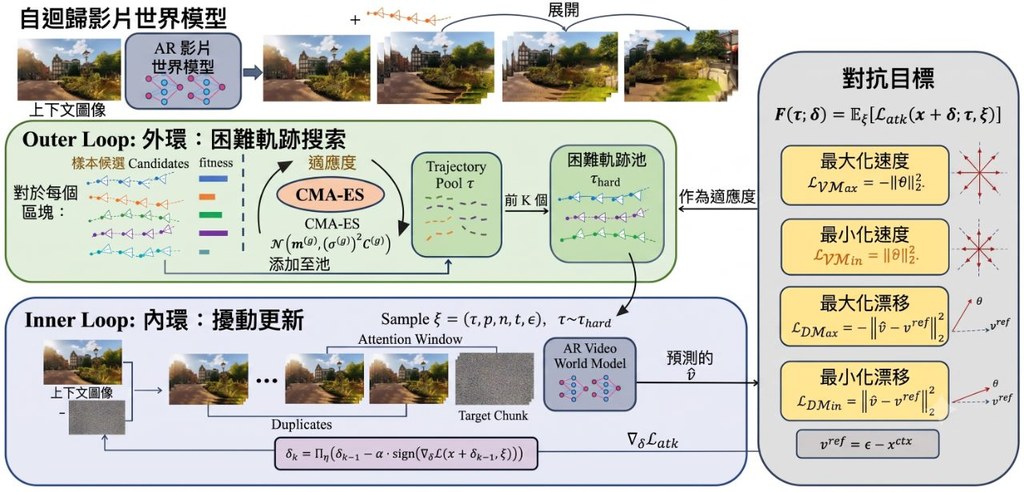
Chart

視覺世界模型(Visual World Models, VWMs)能從一張起始圖片,根據使用者動作序列合成出互動式的未來影片。現有做法多數沿用文字生成圖像或文字生成影片的對抗攻擊範式,但這類方法通常假設有固定的參考輸出或可取得的未來幀標籤。BadWorld 的作者指出,攻擊 VWMs 面對兩道根本限制:攻擊者根本拿不到真實的未來影片當作監督訊號,也無法預測使用者接下來會輸入什麼動作,因此傳統攻擊範式無法直接套用。

為此,團隊提出 BadWorld 框架,屬於一種安全研究工具,專門用來壓力測試自回歸式世界模型的時序穩健性。它繞過「需要未來監督」這道牆,採用自監督的速度擾動攻擊(self-supervised velocity attack),直接破壞模型早期的去噪動力學;同時,為了讓攻擊在未知動作下仍然有效,設計了軌跡自適應雙層優化(trajectory-adaptive bi-level optimization),主動挖掘困難的動作序列以鍛造「對動作無感」的擾動。

從測試結果來看,視覺上幾乎無法分辨的對抗圖片,能可靠觸發後續推演的災難性退化,出現去噪不完全、結構崩塌、控制訊號前後不一致等現象。這些發現對準備把世界模型應用於自動駕駛、機器人等安全關鍵場景的開發者是一記警鐘,同時也提供了一種可操作的隱私保護機制。

如果想自行驗證,可以針對 Matrix-Game-2.0 與 Astra 兩款開源世界模型測試。Matrix-Game-2.0 需約 32GB 顯示記憶體,Astra 則需 80GB,環境需要搭配 FlashAttention 與 NVIDIA Apex 等加速庫,並從 Hugging Face 下載預訓練權重。

  • 屬於安全研究工具,針對視覺世界模型做對抗壓力測試。
  • 突破傳統攻擊需「未來監督」的限制,採自監督速度擾動。
  • 透過軌跡自適應雙層優化,鍛造對未知動作仍有效的擾動。
  • 已在 Matrix-Game-2.0 與 Astra 上展示結構性崩潰。
  • 對自駕、機器人、遊戲模擬等安全關鍵部署具警示意義。

GitHub: https://github.com/LinghuiiShen/BadWorld

Paper: https://arxiv.org/pdf/2606.16519

Categories: 開源, 香港理工大學, 清華大學, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 框架, 香港, 工具, 庫, 安全, 深度學習

當 AI 程式助手遇上滿山數據:CoDA-Bench 想考甚麼?

中國人民大學團隊發表的 CoDA-Bench,把 AI 代理人丟進藏有數百檔案的 Linux 沙盒,測試牠們在真實數據密集場景下找檔案、寫代碼、做分析的綜合能力。

CoDA-Bench

現有針對 AI 程式代理(AI coding agents)的評測,大致分為兩類:一類專注於軟件工程任務(例如 SWE-Bench、Terminal-Bench),只考驗代碼本身;另一類專注於數據分析能力(例如 DS-1000、DA-Code、DataSciBench),卻把所需數據直接攤在桌面,等着代理去讀。中國人民大學數據實驗室團隊指出,這種把「代碼」與「數據」分開評估的範式,與真實開發場景脫節——現實中的工程師,往往要在堆滿雜亂檔案的環境中,自己摸索出哪些數據有用,再寫代碼處理它們。

為此他們提出 CoDA-Bench(Code and Data-intensive Benchmark),屬於 benchmark 類型的評測框架。它建構了一個基於 Kaggle 生態的 Linux 沙盒,每個任務環境平均包含約 980 個檔案,總共 1,009 道題目橫跨 31 個主題社區,要求代理先在語意相近的眾多檔案中大海撈針,再整合異質資料、撰寫分析代碼,產出最終答案。

團隊測試了多款頂尖代理後發現,即使表現最好的系統,成功率也只有 61.1%,暴露出現有模型在「數據發現」與「代碼執行」之間缺乏有效銜接。這個缺口正好為下一代研究指明方向:未來的代理不只要會寫代碼,更要懂得在雜亂的檔案系統中自行導航。

如果你從事 Agentic AI 研發、數據分析自動化,或想測試 LLM 在複雜環境中的推理與編程整合能力,這套開源 benchmark 提供了一個貼近現實的試金石。完整題目已釋出於 HuggingFace,評估則可透過 Docker 一鍵執行。

重點摘要:
– 修正舊範式:突破 SWE-Bench 與 DS-1000 把代碼與數據分開考的做法,統一在同一環境內評測。
– 真實規模沙盒:每題約 980 個檔案,模擬 Kaggle 上雜亂而龐大的真實數據環境。
– 雙重能力整合:同時考驗資料探索、檔案導航、跨格式整合與代碼生成四個面向。
– 成績慘淡:頂尖代理在完整題集上僅約 61.1% 成功率,顯示仍有明顯改進空間。
– 完整開源:包含 1,009 道題目、31 個社區數據(約 43 GB),以及 Docker 評測流程。

GitHub: https://github.com/ruc-datalab/CoDA-Bench

Paper: https://arxiv.org/pdf/2606.15300

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 框架, Vibe Coding, 軟件, Linux, 編程, 中國, Dataset 數據集

BRDFusion:物理與生成模型合體,城市街景逆向渲染新框架

結合物理渲染與生成式擴散模型,把城市影片拆解為幾何、材質與 HDR 光源,支援夜景模擬與物件插入等編輯應用。

logo

現有的城市場景逆向渲染方法長期面臨兩難:基於物理的渲染(physically-based rendering)雖然能嚴格遵守光學物理,但在重建與渲染階段容易產生雜訊與破圖;生成式模型(generative models,例如 DiffusionRenderer)能產出逼真影像,卻難以精準控制光源,例如車燈這類局部照明往往被忽略。BRDFusion 正是針對這個 trade-off 而設計的混合框架。

這個項目屬於研究型框架,目標是把多視角城市影片分解為幾何(法線、深度)、材質(albedo、roughness、metallic)與 HDR 環境光源,並支援新視角重照明、夜景模擬與動態物件插入等下游應用。具體做法上,它先用物理模型取得明確且一致的場景屬性,再借助生成式先驗(generative priors)緩解優化過程中的歧義;前向渲染時,物理模型負責可控渲染,生成模型則負責去噪與修補瑕疵。

測試方面,作者提供預處理資料集與預訓練權重,研究人員可直接下載並透過 tools/run_pipeline.py 跑推理與評估;硬體需求偏高,建議使用 NVIDIA RTX A6000,RTX 4090 在記憶體允許下可執行部分階段,但 Gen. Render 階段可能突破 24 GB 限制。資料集與評估影片亦同步發佈於 Hugging Face,方便重現結果。

這個項目的創新之處在於把「物理一致性」與「生成式品質」放在同一條管線中互補,而非二選一。對從事自動駕駛模擬、遊戲或影視場景重建的研究團隊而言,這是一個值得關注的方向。

重點摘要

  • 混合範式:物理渲染負責可控性,生成模型負責修補瑕疵,突破單一方法的極限。
  • 完整分解:輸出幾何、材質與 HDR 光源,支援新視角、夜景與物件插入。
  • 高硬體需求:建議 RTX A6000,4090 僅能跑部分階段。
  • 完整開源資源:程式碼、預訓練權重、資料集與評估影片均已公開。
  • 適用場景:自動駕駛模擬、城市數位孿生、影視級場景編輯。

GitHub: https://github.com/shigon255/BRDFusion

Categories: 開源, 清華大學, 模型, 視覺模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 影像處理, 框架, 工具, Meta, 深度學習

Page 13 of 20
1 … 11 12 13 14 15 … 20