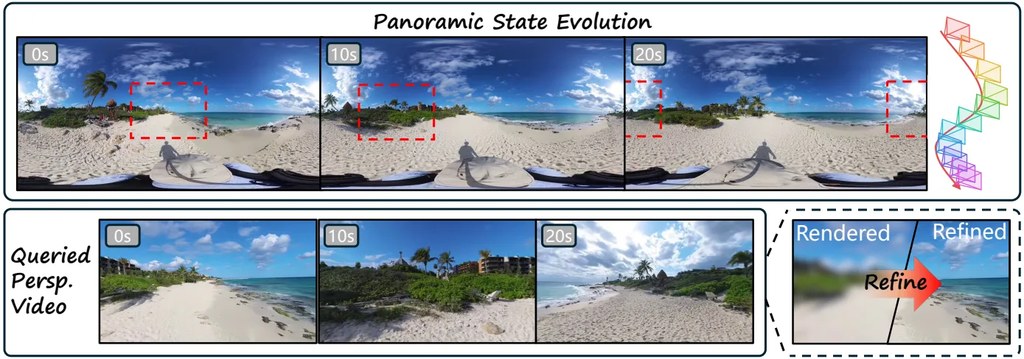
想由一張普通圖片,邊拉鏡頭邊即時生成高質影片,而又唔丟失 360° 場景記憶?AlayaVista 就係為呢個矛盾而設計——佢屬於世界模型(World Model)類研究原型,處理嘅係可控、可串流嘅影片生成問題。
核心做法分三步:先用一張透視圖估出完整 360° 全景先驗,模擬出 VR 風格嘅場景記憶;之後鏡頭控制訊號會驅動呢啲全景潛態持續演化,保持全局一致性;最後系統只渲染用戶當前視角所在嘅區域,並用潛態視口渲染與局部精煉做高保真合成。為咗兼顧速度與質素,佢採用 chunk-autoregressive 逐區塊自迴歸生成,配合少步蒸餾(few-step distillation),令串流過程唔使逐幀重頭計,全部運算力集中在真正需要輸出嘅視窗。
比起傳統逐幀擴散或全景一次性輸出嘅做法,呢種「全景當記憶、視口當輸出」嘅分工換嚟兩個明顯取捨:視窗畫面更銳利、代價係鏡頭一轉就要重新做視口對齊;同時間全景一致性同幀率都受惠於 chunk 邊界設計,對長鏡頭平移類場景特別友好。
幾個重點摘要:
- 全景記憶 + 局部渲染:以 360° 全景潛態維持場景上下文,鏡頭視口獨立精煉,避免整段重算。
- 鏡頭可控串流:支援 user-controlled camera 訊號輸入,邊互動邊生成適合遊戲引擎、VR 預覽或 cinematic pre-vis。
- 效率設計:chunk-autoregressive 加 few-step distillation,專注運算力於選定視窗。
- 仍屬研究階段:roadmap 列明推理代碼同預訓練權重尚未釋出,目前只可睇 paper 與 project page 嘅 demo。
呢類模型對做互動敘事、VR 內容預覽、遊戲關卡 walkthrough 嘅團隊最有直接參考價值,因為佢直接處理「鏡頭會行、背景要穩」呢個常見卡位。對純做離線一鍵出片嘅用家嚟講,呢類串流設計嘅優勢未必即刻見效,但對需要低延遲、長時序一致嘅創作流程,呢條技術路線值得留意。