3D HAMSTER 把機械臂規劃帶進真 3D

同樣是看圖加文字指令,3D HAMSTER唔再只畫2D路線,而是直接交出可落地的3D機械臂軌跡。對機械操作流程來講,呢個改動細節不多,影響卻很實際。

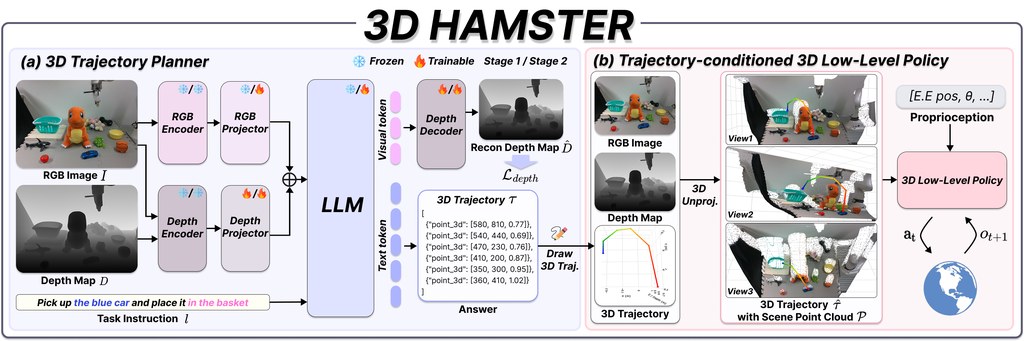
3D HAMSTER architecture: a depth-augmented VLM planner produces metric 3D waypoints that unproject into the point cloud

機械臂最怕規劃講得通,落到控制層卻對唔準空間位置。3D HAMSTER屬於 Vision-Language-Action 規劃模型/機械人研究項目,重點不是再產生螢幕上的 2D waypoint,而是根據單張 RGB 圖、metric depth map 同文字指令,直接輸出帶有深度的 3D end-effector trajectory,同時附上 gripper actions,格式亦整理成 JSON,方便接去後續控制流程。

它針對的矛盾很明確:不少 hierarchical Vision-Language-Action models 由高層 planner 先預測 2D 像素軌跡,再交給吃 point cloud 的低層 policy 執行。問題在於 2D waypoint 只會「借用」像素下方表面的深度,幾何上未必真是機械臂應走的位置。3D HAMSTER改成在 metric 3D 空間規劃,等高層輸出可以直接對接 point-cloud low-level policy,少了中間 2D 轉 3D 的失真。

模型骨幹用的是 Qwen3-VL-8B,再加上凍結的 LingBot-Depth geometry encoder,當中採用 DINOv2 ViT-L/14,並配合 dense depth-reconstruction objective 去強化深度感知。儲存庫目前提供的是 inference-only 版本,即是你可以安裝套件、下載 checkpoint 後直接跑推理或用 Gradio demo 測試;低層 point-cloud policy 屬於論文完整系統一部分,這個 GitHub 項目未有一併放出。

  • 直接輸出 [u, v, depth] waypoint,深度單位是米,較易接入真實機械臂流程
  • RGB-D + language instruction 路線,不靠多視角觀察
  • checkpoint 已包含 geometry encoder 權重,載入時毋須再額外抓模型
  • 項目偏向展示 planner 能力,不等於完整可部署的機械人控制堆疊

,它的定位很適合做研究驗證、機械操作規劃比較,或者拿來觀察 2D planner 與 3D planner 在幾何一致性上的差異。作者在項目頁面強調這種做法對語言、空間與視覺分佈轉移更穩健,但這個儲存庫未有完整公開訓練流程與低層控制模組,所以較適合把它理解為一個清楚展示方向的 3D-native planner,而不是即裝即用的全套機械人方案。
項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Gemini, VLA, Robotic, 3D, Dataset 數據集

CGGS 把文字直接變成第一身 3D 場景

想由文字生成可自由觀看的第一身 3D 場景,CGGS處理得比一般全景路線更穩。它重點不是只做靚圖,而是連視角一致性與幾何結構都一併補強。

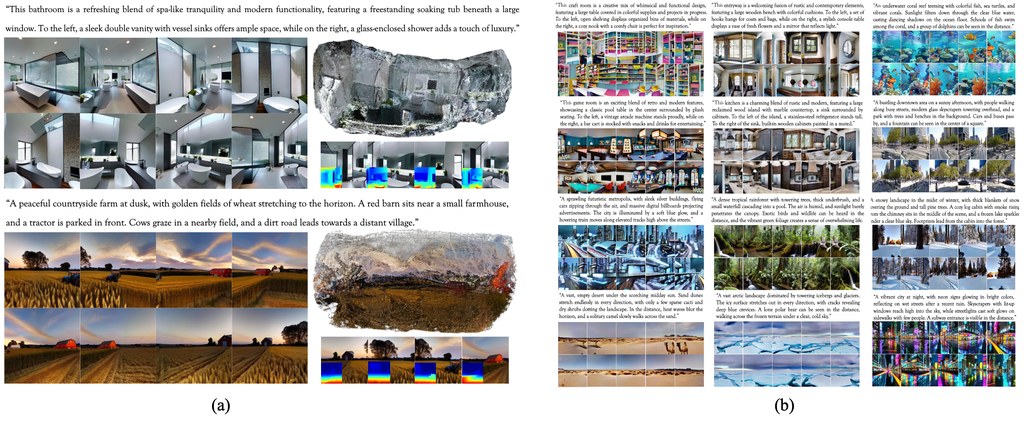
teaser

最值得留意的地方,在於 CGGS 沒有沿用單純全景生成再重建的路線,而是直接針對第一身視角 3D 場景去處理視角不連續、幾何變形和文字細節流失。它屬於一個文字轉 3D 的框架,目標是把文字描述變成可渲染的 ego-centric 場景,而不只是產出幾張彼此關係鬆散的圖片。

現有做法常見問題,是多視角之間重疊不足,或者 equirectangular projection 容易在上下邊界拉扯變形;DreamScene360 一類方法也會出現結構扭曲。CGGS 的取向是先用 MV-LDM 生成更一致的多視角 2D 內容,再配合 optical flow、point-track correspondence、深度估計與 3D Gaussian optimization,把粗略 layout 逐步修到可用的 3D Gaussian Splatting(3DGS)場景。

它的流程大致可理解為三段:Ego-centric Generator 負責貼近文字的多視角內容,Layout Decorator 由影像關係推回 dense point clouds,Geometric Refiner 再用 Mutual Information Depth Loss(MID)和 hierarchical optimization 修正幾何與畫質。部署和測試層面,儲存庫已提供實作,並可透過 prompt 檔、視角水平視野 --fov 與垂直軸旋轉角 --deg 控制生成條件,較適合研究、實驗室或要評估 text-to-3D 工作流的人。

  • 走的是 ego-centric 3D scene generation,不是單純全景貼圖
  • 核心差異在 MV-LDM 一致性訓練,加上 3D Gaussian 幾何優化
  • 提供可調視角參數,能用文字檔批量測試不同場景
  • 適合做 3D 內容生成、novel view synthesis 與方法比較

效能數字也有說服力。README 列出的結果中,CGGS 在 CLIP Score 26.253、Q-Align 0.839、PSNR 37.345、SSIM 0.977、LPIPS 0.0193 取得最佳表現,代表它不只文字對齊較好,重建品質與新視角渲染穩定度也更高;不過這仍然是研究型項目,離通用內容製作工具還有一段距離,較大的價值在於它清楚示範了如何把多視角生成與幾何重建更緊密地接起來。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 3D, 中國, Dataset 數據集

SenseNova-Vision 把視覺任務收進同一模型

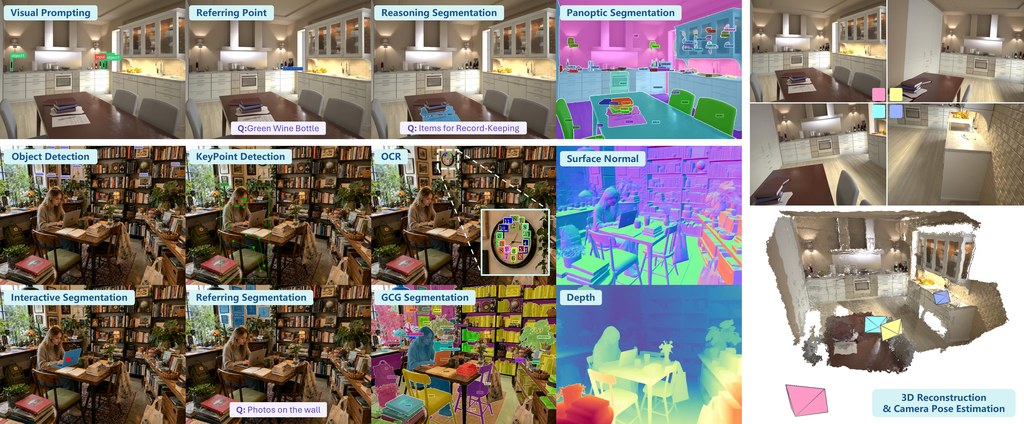
同一個模型同時處理框、點、OCR、分割同深度圖,SenseNova-Vision想解決的正是視覺流程太分散的老問題。你可以把它理解成一個用生成方式統一多種電腦視覺輸出的模型項目。

SenseNova-Vision handles diverse vision tasks in a unified model

做視覺項目最麻煩的,往往不是單一任務做不到,而是偵測、OCR、分割、深度估計同多視角幾何各有各套輸出格式。SenseNova-Vision把這些工作收斂到 unified multimodal model(UMM)的生成介面之內,屬於多模態模型項目,重點是用自然語言指令加可選視覺提示,統一處理結構化理解與密集預測。

它的取向幾明確:不再為每類視覺任務各自設計頭部與輸出器,而是把 boxes、points、OCR strings、keypoints、camera parameters 交由文字生成,把 segmentation masks、depth maps、surface normals、multi-view point maps 交由影像生成,亦支援文字加影像混合回應。這種做法的好處是工作流一致,代價則是推理解碼與評測轉換要做得夠穩,否則通用性未必等於每一項都最強。

目前公開內容包括推理程式、模型權重 SenseNova-Vision-7B-MoT、資料集 SenseNova-Vision-Corpus-50M,以及可試用的 Demo。要理解它點樣測試,最直接是先用 Demo 看同一張圖在不同指令下可否輸出可解碼結果,再配合倉庫的 Evaluation Guide 對標準 benchmark 檢查文字、影像或混合輸出的還原能力。

  • 同一模型覆蓋 結構化視覺理解、分割、dense geometric prediction 與 multi-view visual geometry
  • 輸出形式統一:文字、影像、混合文字影像都可作為回應
  • 已公開資源完整:inference code、SenseNova-Vision-7B-MoT、SenseNova-Vision-Corpus-50M、Demo
  • 適合場景明確:研究團隊、視覺產品原型、要整合多任務流程的工程工作

這個項目最適合不想為每個任務維護一套模型堆疊的團隊,尤其是同時要做偵測、文字辨識、分割與幾何估計的組合型流程。現有資料指出它在多類視覺任務上有不錯結果,但倉庫摘要未列出完整數字;現階段更值得留意的,是它用可解碼生成格式統一 benchmark 輸出的能力,這比單看某一項分數更能反映其定位。

GitHub · 模型

Categories: 開源, 模型, 多模態模型, Image, 影像處理, 香港, Dataset 數據集

MuseBench 用藝術理解考驗 MLLMs

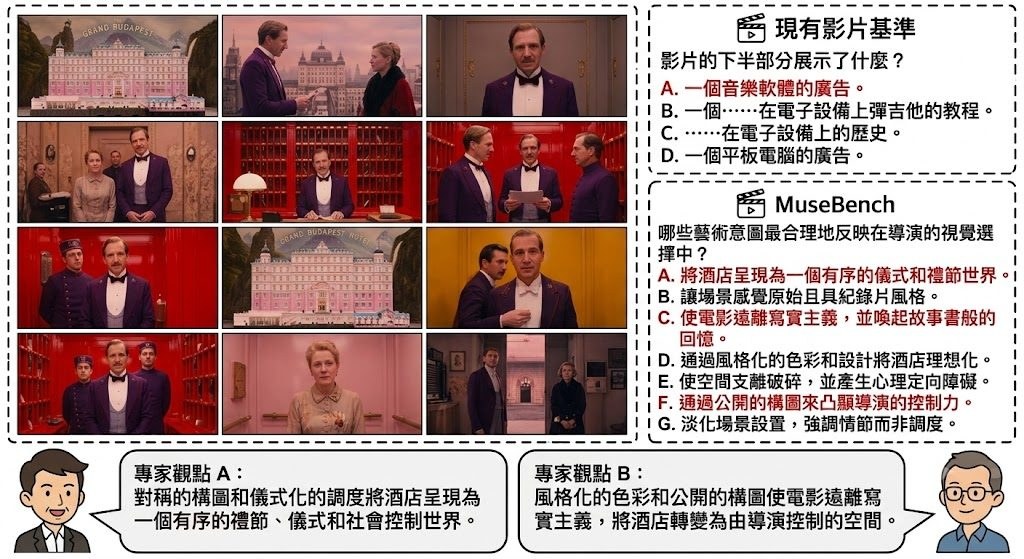
MuseBench唔係測模型見到咩,而係追問點解作品要咁表達。呢套 benchmark 把多模態理解拉到藝術語境,難度明顯高過一般視聽問答。

Repository image for musebench/musebench-code

見到畫面、聽到聲音,未必等於真係明白作品想點講。MuseBench 把焦點放到 artistic intent,專門測 multimodal large language models(MLLMs)能否由視聽證據推斷創作選擇背後的意思;它屬於 benchmark/數據集型項目,處理的是現有評測多數只停留在 perceptual recognition,未能反映藝術理解深度的問題。

現有做法常用一般視覺問答或影片理解題,模型只要辨認物件、情節或表面事件就有機會得分;作者認為這種 fixed paradigm 忽略 stylistic vocabulary、cultural priors 同 grounded audiovisual inference,所以改用 narrator-removed video clip,並配合可選 audio transcript,迫使模型直接由鏡頭、聲音、節奏與敘事線索作判斷。題目覆蓋 Cinematic Arts、Static Visual Arts、Stage Performing Arts 同 Game Arts,合共 4,016 條問答。

同類 benchmark 多數著重「睇到乜」,MuseBench 則更在意「點解要咁呈現」。它亦唔只用單一選擇題,仲有 single-select 同 multi-select 兩種格式,並加入 Chance-Adjusted Accuracy(CAA)處理選項數量不同帶來的偏差,令比較 28 個 MLLMs 時較公平。

  • 涵蓋 4 個藝術領域、11 個細分類,題材比一般影片 QA 更闊
  • 評測 28 個 MLLMs,包含 proprietary、open source 同 video-specific 路線
  • 最佳模型準確率 48.29%,明顯低於 human expert 的 87.18%
  • 已整合 VLMEvalKit,方便把新模型接入同一套流程測試

部署同測試理解上,這個 code repository 主要唔係提供訓練模型,而是把 MuseBench 接到 VLMEvalKit 的評測流程,較適合研究團隊、模型評估人員、做 video understanding 或多模態推理的項目直接比較新舊模型。已公開的結果提到 Claude-4.6-Opus、Qwen-3.5-Plus、Doubao-Seed、GPT-5.4、Gemini-3.1-Pro、Grok-4.1 等都測過,分數整體仍與專家有大段距離;換句話說,這個項目最有價值的地方,在於它清楚指出現時 MLLMs 在藝術判讀仍未算接近可靠。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, 字節跳動, 多模態模型, Qwen, OpenAI, Gemini, Video, Audio, 香港, Anthropic, Dataset 數據集

SIEVE 點樣揀出更值錢的機械人示範數據

示範數據愈多,未必代表 VLA 訓練效果愈好。SIEVE 想做的,是先拆開動作結構,再挑出更值得保留的片段與軌跡。

Repository image for ChangtiWu/SIEVE

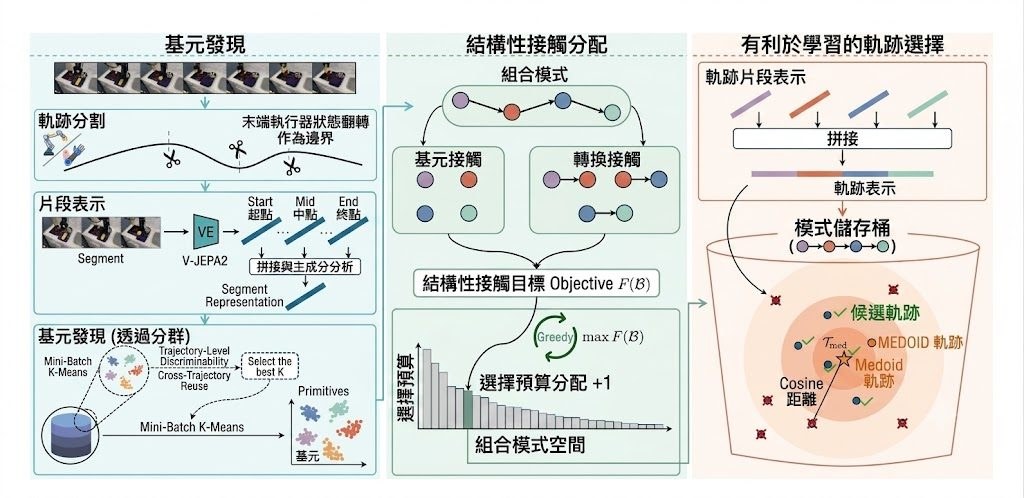
機械人示範資料最常見的問題,不是數量不夠,而是重複、嘈雜,甚至長段任務其實只是不斷重演相似動作。SIEVE 屬於一個面向 imitation learning 的資料篩選工具,同時帶有研究方法性質,重點不是逐條 trajectory 粗略評分,也不是只看 state-action,而是把長任務拆成可重用的 visuo-motor primitives 與 transition interfaces,再決定哪些 episode 更值得留下來訓練 VLA 模型。

它批評的舊範式相當明確:現有 data selection 方法多數只在 trajectory level 或 state-action level 做判斷,因而忽略長時序行為內部可重用的結構。SIEVE 的做法是先用 end-effector pose 與控制訊號做 segmentation,再抽取 V-JEPA 特徵、用 PCA 壓到預設 256 維、以 MiniBatchKMeans 找出 primitive pattern,之後按 cluster-sequence pattern 做兩階段 episode selection,最後可以匯出回 LeRobot 格式,方便直接接回原本訓練流程。

這種取向的好處,在於它不是單純挑「最好」或「最乾淨」的示範,而是優先保留結構覆蓋度與可重用性。論文提供的訊息亦相當直接:SIEVE 在多個 datasets、benchmarks 與 VLA models 上,都比競爭性的 baseline 更穩定,甚至在只用 50% demonstrations 和 50% training steps 的情況下,表現可以超過 full-data training。當然,這也代表它較適合已有一定規模示範資料、並且願意先跑一輪離線整理流程的團隊,而不是追求即插即用的小型腳本。

  • 以 LeRobot v2 資料根目錄作輸入,支援單一或多個 dataset
  • 流程由 segmentation、feature extraction、dimensionality reduction、clustering、selection 組成
  • 特徵抽取依賴 V-JEPA,輸出中間結果到 Zarr,再匯出選中的 LeRobot episodes
  • 核心差異是按 reusable structure 揀數據,不是只按整條 trajectory 或逐步 state-action 打分

部署理解上,這個項目更像一條可重複執行的離線資料處理 pipeline,而不是一個直接提供推理服務的套件。適合用來整理大型 robot demonstration corpus、為 VLA imitation learning 減少冗餘訓練樣本;相關模型與技術脈絡包括 Vision-Language-Action (VLA) models、V-JEPA,以及輸出端相容的 LeRobot。

GitHub · Paper

Categories: 開源, 香港科技大學, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, 影像處理, Robotic, 香港, 中國, Dataset 數據集

SkillOpt-Lite:幫 coding agent 自我改良

想令 coding agent 越跑越準,呢個項目用聊天指令就可以反覆試錯、驗證同回滾。它不是再訓練模型,而是直接改進 skill 與 agent 流程。

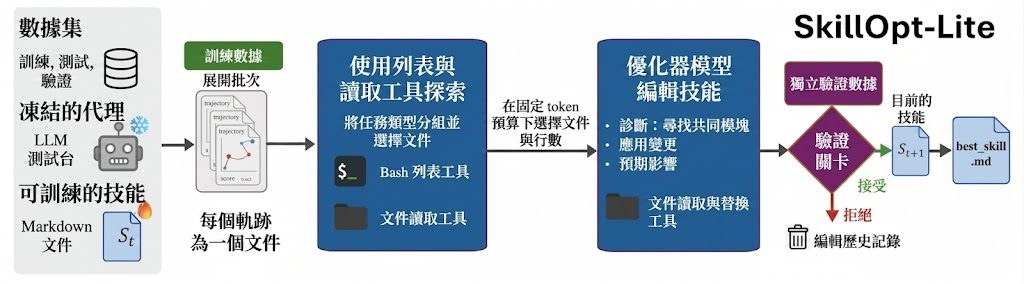
SkillOptLite / HarnessOpt pipeline

不少人用 coding agent 時,卡位不在模型本身,而在 prompt、skill 文件同執行流程點樣一路修正。SkillOpt-Lite 連同 HarnessOpt 就是針對這個位置而來的 Agentic 工具:把評測、修改、驗證同回滾包成兩個 slash command,讓 coding agent 在對話環境內自動迭代改善。

它反對一種常見範式:每次表現不好,就手動改 prompt、重跑少量樣本,再憑感覺決定有沒有進步。作者改用 looped improvements 配合 validation-gated rollback,先跑一批 scored rollouts,將失敗樣本交回 coding agent 修補,再用 val split 決定保留還是還原;焦點不是 fine-tuning,也不是增加 inference-time overhead,而是把現有 agent workflow 系統化地優化。

部署理解上,這個項目不是叫你在 shell 逐步砌環境,而是把 repo 資料夾直接開進支援 .github/prompts/*.prompt.md 的 coding agent,例如 VS Code Copilot Chat、Codex CLI、Claude Code。環境安裝、驗證、資料下載由 agent 協助處理;現成 benchmark 包括 LiveMath、SpreadsheetBench、ALFWorld、DocVQA、OfficeQA 同 SearchQA,亦支援帶入自家 repo 與資料格式。

  • SkillOpt-Lite 只改 skill.md,適合先驗證 prompt/skill 層面的改善
  • HarnessOpt 連 agent harness 一起改,包括 rollout、react-agent、executor 等程式部分
  • 以 val gate 決定保留或回滾,比單看一次 train 結果更穩陣
  • 官方重點是「no fine-tuning, no inference-time overhead」,取向明顯偏向低成本迭代

跟同類做法相比,它的差異不在於推出新模型,而是把「由 agent 自己根據失敗紀錄修補自己」做成可重覆流程。公開內容提到在 6 個 benchmarks 有結果,亦展示過 GPT-5.4-nano 配合 HarnessOpt 可超過較高階模型配標準 harness 的情況;不過現時較依賴 coding agent 工作流,最適合做 agent 評測、提示工程、內部工具自動化的團隊,而不是單純想下載一個模型即用的人。相關模型與目標例子則包括 GPT-5.4-nano、GPT-5.5,以及各種可讀取 prompt 檔的 coding agents。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Vibe Coding, 編程, Dataset 數據集, Skill 技能

AlayaWorld 想做可玩式長時影片世界

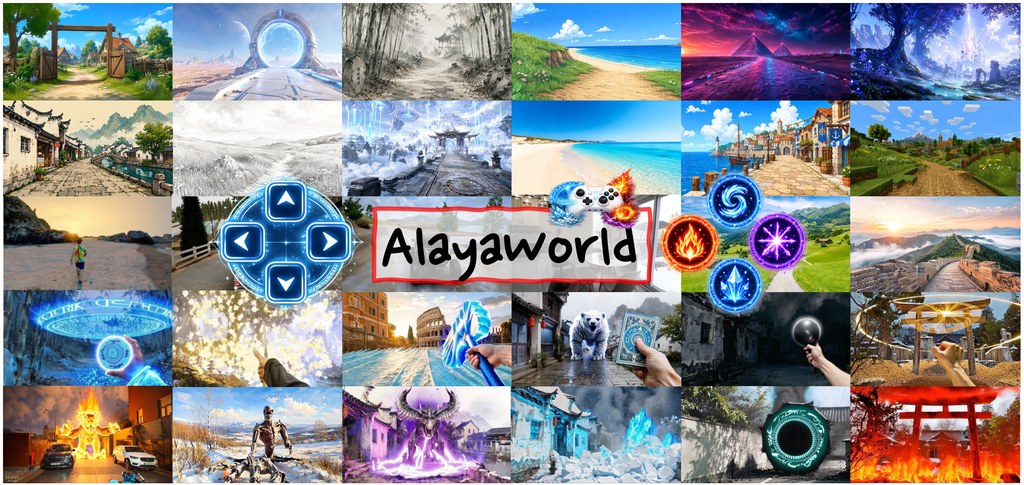
它唔止係生成影片,重點係讓鏡頭可即時移動、途中改提示,場景仍盡量記得之前發生過乜。AlayaWorld瞄準的,是更接近「可探索」而唔只係「可觀看」的世界模型。

fig1 AlayaWorld

一段生成影片能否變成可探索空間,關鍵唔係畫面靚唔靚,而係鏡頭轉向、路徑改變、甚至中途加入新事件之後,個世界仲認唔認得自己。AlayaWorld屬於world model 研究項目,目標係處理長時間影片生成入面最麻煩的幾件事:互動控制、記憶一致性,同埋長序列愈滾愈走樣的問題。

而家不少影片生成做法偏向一次過出片,畫面可以吸引,但未必承受到持續探索;鏡頭一郁、提示一改,前後場景就容易斷裂。AlayaWorld明確反對呢種偏靜態範式,改用 interactive autoregressive world model 路線,把 3D cache、frame-history embedding,同 chunk-level prompt switching 組合起來,嘗試同時保住空間記憶、時間連續性,同中途插入事件的能力。

它最有辨識度的地方有幾個:一方面用 rendered 3D cache 配合輕量 AdaLN camera modulation,令 6-DoF 鏡頭控制更貼地;另一方面又用壓縮後的歷史影格表示,幫手維持 revisited places 的辨識度。為咗減少長時間 rollout 累積錯誤,團隊亦加入 drifted histories 訓練同 error bank,把已出現的瑕疵重新注入記憶與目標,避免失真一路放大。

  • 支援 real-time camera control,同時可在片段邊界切換 prompt
  • 以 3D cache 加 frame-history embedding 處理空間與時間記憶
  • 透過 few-step DMD distillation 爭取即時生成效率
  • 官方展示指向 720p、24 FPS、60s+ long-horizon、15B parameters
  • 目前公開的是 technical report、示範頁與影片,code 與 weights 尚未釋出

現階段較適合把它理解成研究原型,而唔係可立即部署的開源工具。想測試的人,暫時只能先睇 demo 同 technical report,重點觀察鏡頭移動、風格切換、事件插入後的連貫度;等 inference code 同 pretrained weights 釋出後,先有條件判斷佢喺內容製作、互動敘事、遊戲原型或世界模型研究工作流入面,究竟可以走到幾實用。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, 世界模型, 3D, Dataset 數據集

Light-Omni 想把長影片 Agent 變得更快

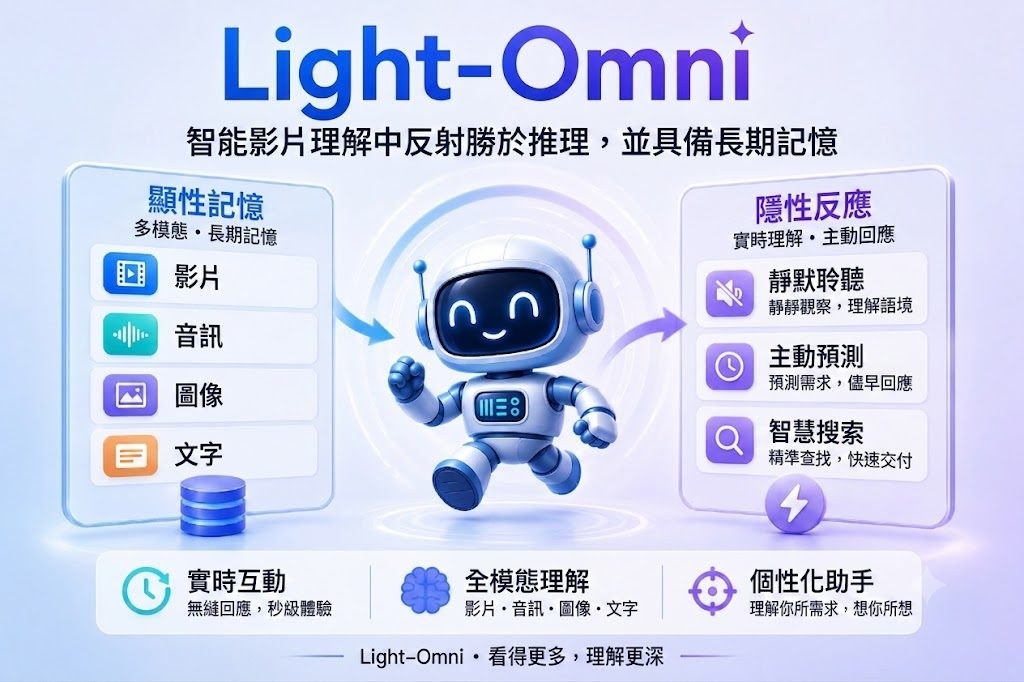
面對長影片互動,Light-Omni唔再靠一輪輪搜尋同推理。它把記憶、檢索同回應壓縮成較輕量流程,重點放在速度同連續互動。

Light-Omni

長影片互動最易卡住的位,不是模型看不懂,而是每次都要重新搜尋線索、反覆推理,回應自然會慢。Light-Omni把這件事改寫成一個Agentic video understanding研究項目:用長期多模態記憶處理視覺、語音與文字串流,目標是讓代理在連續對話中更快決定要直接回答、提取記憶,還是補足證據。

現有做法常採用作者所說的 detective-style iterative reasoning,一邊規劃、一邊搜尋、一邊聚合證據;好處是步驟清楚,代價是延遲高、計算開銷大。Light-Omni提出 reflexive video understanding,核心不是拉長 reasoning loop,而是以單次 forward pass 產生全域脈絡與 retrieval embeddings,再配合 Generation AdapterMemory AdapterReaction Adapter 三個模組,分別負責回應、長期記憶整理,以及預測何時檢索。

這個取向的價值很直接:它不是追求最繁複的推理鏈,而是優先解決互動代理在長影片場景的反應速度。項目建基於 Qwen2.5-Omni,示範則用 Qwen3-Omni-30B-A3B-Instruct;記憶設計包含 identity profiles、semantic memory、episodic memory,並加入 sleep-time memory consolidation,把較長時段的觀察壓成緊湊全域狀態,同時保留近期細節。

  • 相比 M3-Agent,平均準確率提升 2.4%
  • 速度達 12.1x,加強長影片互動的即時性
  • GPU 記憶體效率提升 2.6x,較適合資源有限的部署
  • 倉庫附有 eval.py、Flask/Socket.IO demo、Hugging Face 模型與訓練資料

想驗證這個項目,現時可沿三條路理解:先看 web demo 感受反應方式,再用倉庫內的 eval.py 配合 logs/ 檢查長影片 benchmark 結果,最後參考 thirdparty/ 內已修補的 transformersms-swift 組件做訓練或推理環境配置。較受用的讀者會是做多模態代理、長影片理解、記憶檢索,或者需要低延遲互動系統的研究團隊;它仍屬研究原型,效能數字主要來自項目提供的 benchmark 與示範,部署前仍要按自己的影片長度、硬件條件與任務形式再核實。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, Embedding, 模型, 多模態模型, Video, Dataset 數據集

PaperPilot:把文獻搜尋變成可修改流程

找相關研究唔一定只靠一條關鍵字。PaperPilot把文獻搜尋拆成可檢查、可改寫的流程,令多輪互動真係會改變搜尋策略。

PaperPilot logo

做研究時,最麻煩往往唔係「搵唔到論文」,而係第一輪結果未必貼近你真正想追嘅方向。PaperPilot屬於開源框架,同時亦帶有已訓練代理模型,用 workflow induction 處理多輪學術文獻搜尋:它會圍繞 anchor paper 同查詢,先建立一個 typed DAG,再用澄清問題同後續回應去改動搜尋流程本身,而唔係只係喺原句後面再加條件。

呢個定位同一般固定 pipeline,或者只靠語言模型隱式推理嘅搜尋代理,好唔一樣。作者認為舊範式嘅問題,在於搜尋策略難以控制、難以檢查,亦唔容易根據人嘅偏好逐步修正;PaperPilot就把 keyword search、citation expansion、filtering、scoring、reranking、evidence extraction 組成可執行流程,每一步改動都可以保留,令結果更可追溯。

公開資料已經提供 live demo,亦有 FastAPI 後端、Streamlit 介面、evaluation scripts 同 tests,可理解成一套可部署、可觀察、可重跑嘅研究工具鏈。不過 initial release 未包含 web/ React front-end,同 training_infra/ 亦未完整開放;README 片段亦未見完整安裝流程,現階段較適合先用 demo、閱讀論文,再按儲存庫結構自行部署 backend 與本地介面。

  • 多輪互動唔止改 query,仲會直接編輯 typed DAG workflow
  • 約 50 個 typed operators,覆蓋檢索、集合操作、排序同證據抽取
  • 每次執行會保存流程、逐輪修改、時間與成本,方便重現結果
  • PaperPilot-9B 以 workflow imitation 加 preference optimization 訓練而成
  • 指標上較 base Qwen3.5-9B toolset agent 提升 Hit@5、MRR、nDCG@10,並把 workflow execution errors 由 9.5% 降到 0%

相關模型方面,核心比較對象係 base Qwen3.5-9B toolset agent,而實作後端就標明支援 OpenAI、Together、Anthropic 同 OpenAI-compatible endpoint。呢種設計對研究員、需要做系統性文獻整理嘅學生,或者想把檢索流程納入團隊知識管理嘅人都幾有價值;取捨在於它追求可控與可審核,流程會比單次對話搜尋更重,亦更依賴使用者願意逐輪提供清晰反饋。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, API, Dataset 數據集

SaMer 壓縮視覺檢索成本

想保留圖像檢索的細節判斷,又不想被海量 visual tokens 拖慢,SaMer正正處理這個矛盾。它用較聰明的合併方式壓縮 token,同時盡量守住檢索準確度。

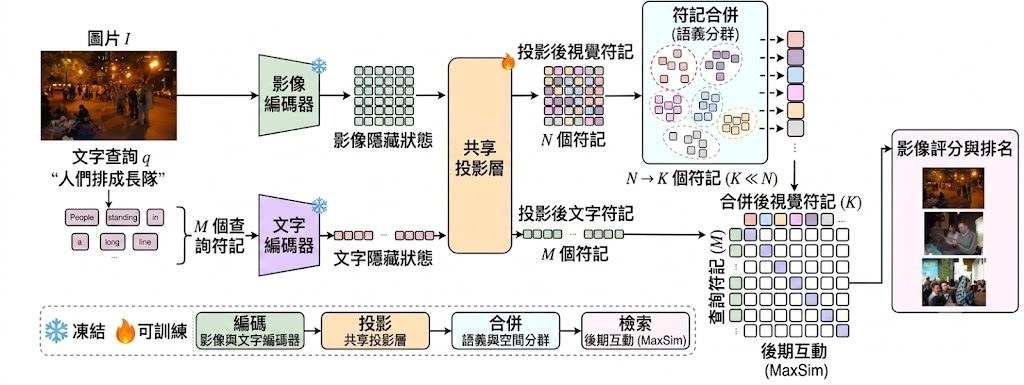
SaMer overview

圖文檢索做得細緻,往往要保留大量 image-side tokens,但儲存與比對成本也會跟住升。SaMer屬於開源框架/研究原型,針對 ColPali-style multi-vector retrievers 的 token 壓縮問題而來,重點不是單純刪減,而是盡量保住之後查詢仍可能用得着的 object-level evidence。

現有壓縮做法多數偏向 pruning、pooling,或者只按 feature 合併,代價是物件與區域證據容易被混在一起,令 MaxSim late interaction 原本可選取的細節訊號流失。SaMer的取向明確:保留原本 MaxSim retrieval objective,不改 late-interaction 介面,只在 image side 做 object-aware merge,修正「壓縮後證據變鈍」這個問題。

它的方法有三個關鍵步驟:先用 feature similarity 加 spatial proximity 做 Feature-Spatial Merging,再在訓練階段利用 Flickr30k-Entities 的框標註加入 Object-Aware Assignment,避免不同實例被錯誤合併,最後採用 Projection-Only Adaptation,只訓練 shared projection layer,vision encoder 同 language backbone 都維持 frozen。到 inference 時就不再依賴 bbox,這點令部署比一些需要 detector 或額外 grounding loss 的做法簡潔。

  • 以 ColPali-style multi-vector retrieval 為核心場景,重點是減 storage 與 scoring 成本
  • K=64 時可移除超過 93% image-side tokens,ColPali 儲存量下降 16.09×
  • 在 Flickr30K 與 MSCOCO,README 與項目頁指出 R@1 有提升
  • 相關模型權重包括 vidore/colpali-v1.3-hf,另有 Hugging Face 的 SaMer models 集合

測試與重現路線算清楚:資料要先準備 Flickr30k-Entities,之後訓練 adapter、建立 compressed retrieval cache,再做 inference。原始資料列出 Python 3.10+、CUDA-enabled PyTorch,以及單 GPU/多 GPU 腳本流程,但 evaluation 章節在提供內容中未完整展開,所以更細的 benchmark 設定與完整數字仍要以論文與項目頁為準。

這類做法最適合需要多向量圖文檢索、又在意記憶體與延遲的團隊,例如做 large-scale image retrieval、phrase-level grounding,或者要把 ColPali 類系統壓到較可部署規模的研究與工程項目。它的取捨亦很清晰:不是追求最少 token,而是用較低成本保留日後查詢仍有機會選中的視覺證據。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, Qwen, NVIDIA, Image, Python, Dataset 數據集

Page 39 of 92
1 37 38 39 40 41 92