discrete_diffusion_RRG:離散擴散模型點樣寫胸肺 X 光報告

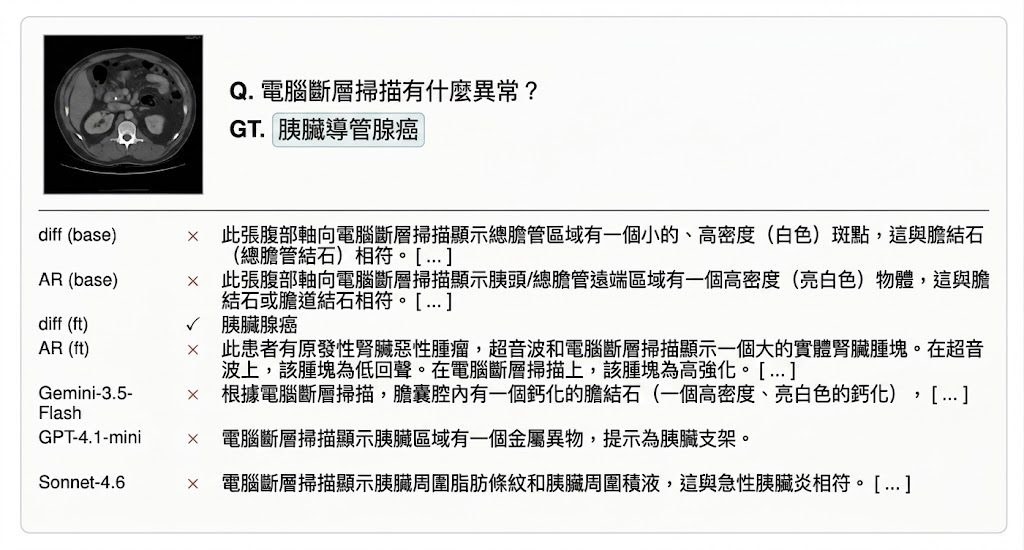
這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。

Repository image for mxvp/discrete_diffusion_RRG

這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。

項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。

部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。

效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。

  • 類型上,它較接近研究原型加評測程式碼,不是即裝即用的臨床軟件。
  • 主要資料來源包括 VQA-RAD、SLAKE、VQA-Med 與 MIMIC-CXR。
  • 相關模型包括 DiffusionGemma-26B、Gemma-4-26B,並以 LoRA 方式微調。
  • any-order infill 是最有辨識度的能力,適合先固定部分報告內容,再由模型補全其餘位置。
  • 適合需要比較生成範式、研究 radiology report drafting,或想驗證 discrete diffusion 在醫療場景表現的團隊。
項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, Google, Gemini, API, Image, Medical醫學, Dataset 數據集

MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

MrFlow framework

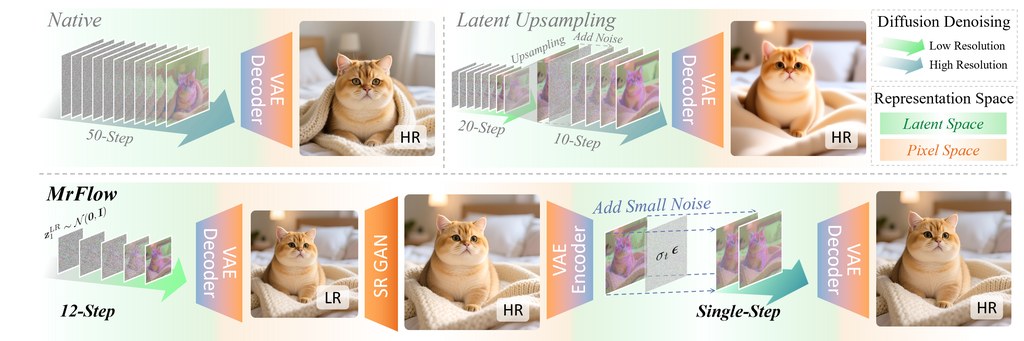
MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。

GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

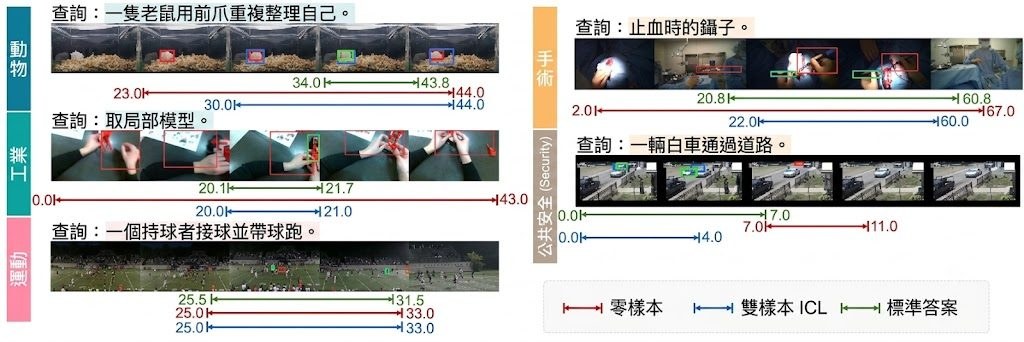
AnyGroundBench 點出影片定位模型盲點

AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。

Repository image for rinost081/AnyGroundBench

AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。

現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。

這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。

項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。

  • 類型屬於 benchmark / 資料集,目的是測量 VLMs 的 specialized-domain video grounding 能力
  • 舊範式以 zero-shot general benchmark 為主,新設計改為檢查 domain adaptation 與 In-Context Learning(ICL)是否真的有效
  • 評測涵蓋 temporal、spatial、spatio-temporal 三層,較容易看出模型究竟是看錯時間、找錯位置,還是兩邊都失準
  • 已評測 15 個 state-of-the-art VLMs,結果指出現有模型在 specialized domains 的 zero-shot 與 ICL 表現都不穩定

建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, Video, 安全, Dataset 數據集

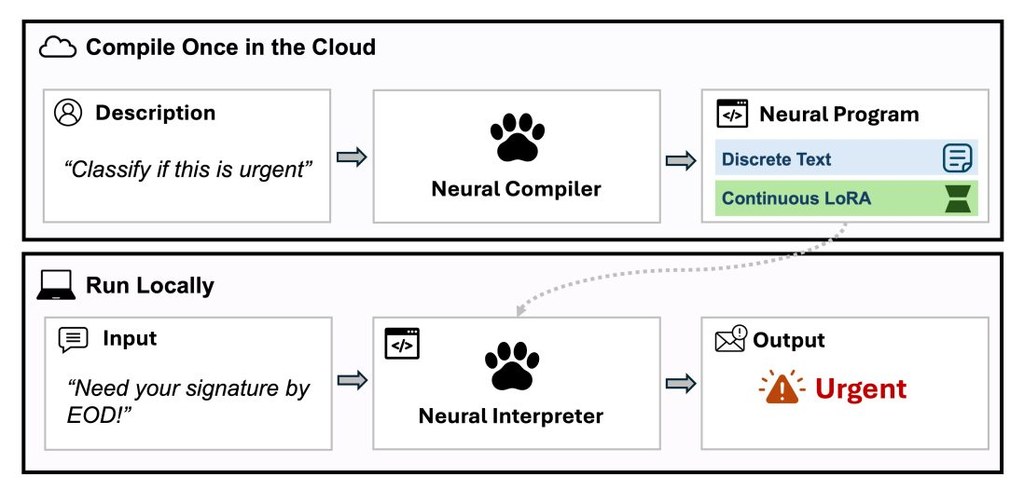
PAW:把英文編譯成本地函數

PAW(programasweights-python) 不是一般 LLM 封裝,而是把文字需求變成可離線執行的小型神經函數。它瞄準規則難寫、又不想長期依賴 API 的文字處理工作。

Repository image for programasweights/programasweights-python

PAW(programasweights-python)是一個 Python 工具兼研究原型,屬於把「自然語言」規格編譯成小型神經函數的項目。它要解決的是一類很難用正則表達式或硬編碼規則寫穩定的工作,例如修復壞掉的 JSON、模糊搜尋、分類、抽取欄位,以及把文字意圖對應到正確操作。

現有做法通常有兩條路:一條是手寫規則,遇到錯字、格式飄移同邊界情況就容易失準;另一條是把每次輸入都送去 LLM API,換來較高彈性,但會帶來網絡依賴、成本同重現性問題。Program-as-Weights(PAW)提出的做法,是先用一個 compiler 把英文描述編譯成可重用的神經程式,之後每次呼叫都在本機執行,定位由「每次都問模型」改成「先造好工具再反覆用」。

安裝路線相當直接:Python 端可透過套件取得預編譯函數,亦可自行 compile;瀏覽器端則有 @programasweights/web,但只限用 paw-4b-gpt2 這條較細的 runtime。部署取捨也寫得清楚,paw-4b-qwen3-0.6b 準確度較高,程式體積約 22 MB,本地推理約 0.05 至 0.5 秒;paw-4b-gpt2 準確度較低,但程式只有約 5 MB,支援 WebAssembly,較適合前端或輕量分發。

項目的技術定位:作者把這類問題稱為 fuzzy-function programming,並釋出 FuzzyBench 這個 10M examples 數據集,用 4B compiler 為 frozen interpreter 產生 parameter-efficient adapters。文中指出,0.6B Qwen3 interpreter 執行 PAW 程式時,效果可接近直接 prompting Qwen3-32B,同時把推理記憶體壓到約五十分之一,並在 MacBook M3 達到 30 tokens/s;這些數字有助理解它不是單純包裝模型,而是在成本、可重用性與離線能力之間重新分配。

  • 核心價值:把一次性的自然語言需求,轉成可重複呼叫的本地函數
  • 適合情境:日誌分流、格式修復、文字分類、資料抽取、意圖路由
  • 主要取捨:比直接調用大型 API 更可控、可離線,但編譯器與 runtime 選型會影響準確度與體積
  • 相關模型:paw-4b-qwen3-0.6b、paw-4b-gpt2,論文亦以 Qwen3-32B 作對照
  • 受益團隊:重視本地執行、穩定輸出、低成本重複推理的開發團隊會較易受惠

這個項目最適合放在「規則太脆弱、API 又太重」的中間地帶。它未必取代通用 LLM,但對一批固定任務而言,先編譯、後離線執行的方式更像真正可落地的工程工具。

項目主頁 · GitHub · Paper

Categories: 開源, Qwen, API, Python, 編程, Dataset 數據集

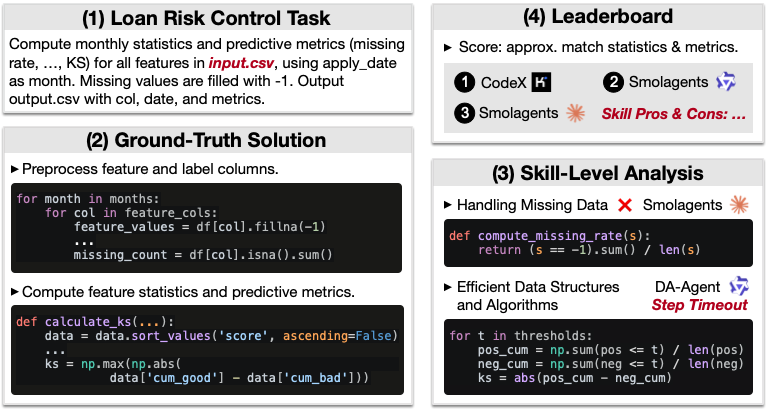
AgenticDataBench:數據代理基準點樣睇

這是一個評測 data agents 的 benchmark。它用真實任務同技能標註,檢查模型是否真係識做數據工作。

example

AgenticDataBench 是一個用來評測 data agents 的 benchmark,而唔係直接幫人做分析的模型或應用。它要解決的是:LLM-based data agents 能否穩定完成 data science workflow,並且用可比較、可重現的方式量度表現。

現有做法多數只用零散任務、單一資料集,或者只看最終答案,較難知道代理究竟卡在哪個步驟。這個項目改用 344 個任務、15 個領域,再配合細緻的 skill labels 同 ground-truth,將問題拆成可重用的 data science skills,例如缺失值處理一類操作模式,令評測唔只得總分,仲可以見到技能層面的強弱。

部署同理解方式都幾直接:資料集可由 HuggingFace 下載後放入 testbed/datasets/,任務、gold 標註同結果目錄已經分開,另外保留咗 98 個 private test tasks 維持 leaderboard 的可信度。README 亦提到需要設定 API keys,反映它主要係一個開放測試台,方便用不同 agent harness 跑同一批任務,而唔係單機即開即用的終端工具。

同類 benchmark 相比,它的取向唔係追求最少題目下的快速排行,而係強調真實性、技能覆蓋率同冗餘控制。項目一方面收錄真實 B2B fintech use cases,另一方面用 skill-aligned hierarchical clustering 同系統化生成流程補足缺少真實任務的領域,這種做法的代價是建置與維護較重,但換來更完整的比較基線。

  • 覆蓋 15 個領域,包含真實 B2B fintech 任務
  • 提供 tasks、ground-truth、skills 同 results 結構化內容
  • 支援比較不同 agent harness,如 Smolagents、DA-Agent、Claude Code、CodeX
  • 已列出 Qwen3.5-397B-A17B、Kimi-K2.5、Claude Sonnet 4.6 的初步實驗

這個項目最適合做 data agent 研發、模型選型同內部驗證的團隊,也適合研究人員用來檢查代理在哪類 data skills 失分。性能資訊目前以 leaderboard 結果為主,重點不只是 accuracy,仲包括 skill-level insight;相關模型至少包括 Qwen3.5-397B-A17B、Kimi-K2.5 同 Claude Sonnet 4.6。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, Agentic, Qwen, API, Anthropic, Dataset 數據集, Skill 技能

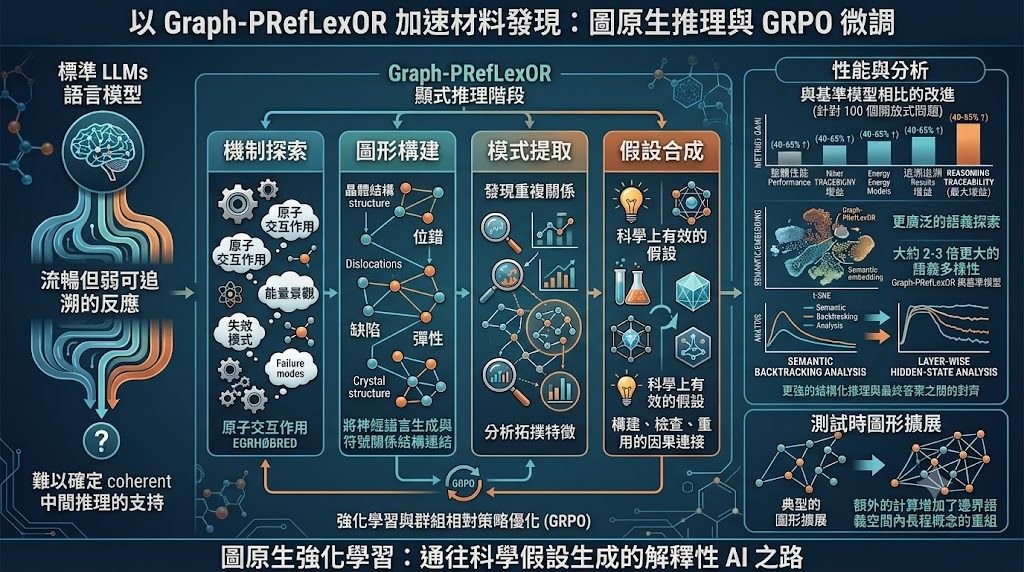
Graph-GRPO:教模型先畫知識圖再作答

這是一個訓練語言模型的開源項目,重點是先整理知識圖,再輸出答案。它想改善純文字推理難以追蹤思路的問題。

Repository image for lamm-mit/graph-preflexor-grpo

這是一個用來訓練語言模型的推理項目,核心屬於模型訓練流程兼研究原型。它要解決的問題,是模型回答問題時往往只輸出文字結論,推理結構難以檢查;Graph-GRPO 先要求模型把概念、關係與規律整理成 knowledge graph,再整合成答案。

現有做法多數依賴 chain-of-thought 或一般文字式 reasoning,把中間思路寫成自然語言。作者認為這種範式雖然靈活,但節點、因果、約束與抽象規律不易固定表示,因此提出 graph-native 的訓練方式:先用 ORPO(Odds Ratio Preference Optimization)或 SFT(Supervised Fine-Tuning)學格式,再用 Graph-GRPO 做強化學習,直接獎勵正確性、格式完整度與 graph utility。

項目的設計相當明確:節點類型限制為 entity、attribute、process、event、outcome、law、claim,關係亦只保留 12 種 verbs,並用 Pydantic 做結構化解析與 schema validation。這種取向的好處是輸出較易驗證,甚至能自動修補無效 graph;代價是表達自由度較低,未必適合非常開放、需要細膩語氣或鬆散聯想的回應。

部署與理解方式也算清楚,整個流程分成資料生成、run_orpo_graph 或 SFT 訓練,再進入 run_grpo_graph 強化階段,並以 LoRA 疊加在基礎模型上。README 亦提到可透過 OpenAI-compatible endpoint 驅動 ideation engine,把多輪生成的 graph_json 累積成可擴展知識圖,用於創意探索、問題延伸與比較不同前沿模型的表現。

  • 適合想研究可追蹤推理、結構化回答與可驗證中間步驟的團隊
  • 已釋出相關模型,基礎模型包括 Qwen-8B 與 Llama-3.2-3B-Instruct
  • 獎勵設計公開列出 correctness、format、graph utility 三部分權重
  • 亮點不在單純答得快,而在於把 reasoning 過程轉成可檢查的 graph object

在目前提供的內容中的性能不算完整,較明確的是訓練路徑、輸出結構與後續 ideation 用途,而 supporting context 另提到這條路線也延伸到 scientific hypothesis generation。整體來看,這個項目較適合研究型開發者、做 Agentic workflow 的團隊,以及想把 LLM 回答過程由黑盒文字轉成結構化證據鏈的人使用。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型訓練, Qwen, OpenAI, API, KnowledgeGraph, LLaMa, Anthropic, Meta, Dataset 數據集

PerceptionRubrics 點出多模態評測盲點

呢個項目用更貼近人類觀感的方式,重新檢查多模態模型有無看錯重點。它唔係再鬥平均分,而係追查關鍵事實有無答錯。

Performance Comparison

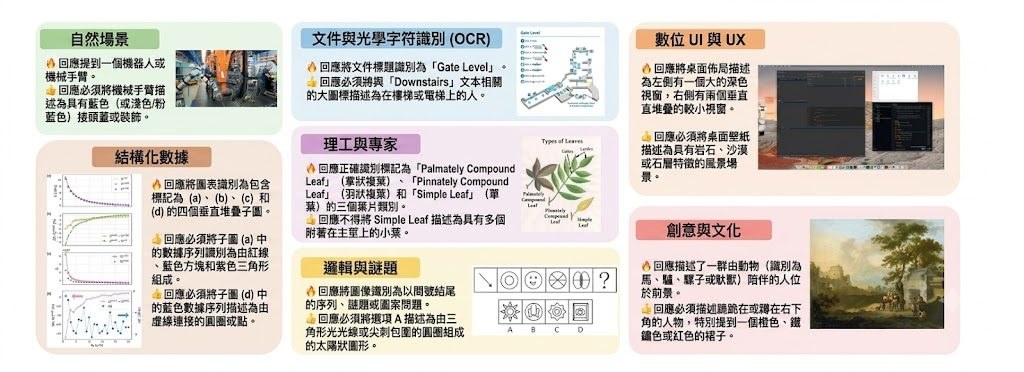
PerceptionRubrics 是一個多模態評測框架兼資料集,主力檢查 Multimodal Large Language Models 是否真正看清圖片內容,而唔係只係在傳統 benchmark 拿到高分。它要解決的問題很直接:現有 caption 評測常用 holistic semantic matching 或平均分,容易把嚴重錯誤沖淡,但人類閱讀結果時,關鍵事實一錯,整體輸出已經未必可信。

作者把舊有範式拆開重做,改用 atomic auditing,把每張圖分解成可核實的細項,再分成 Must-Right 與 Easy-Wrong 兩條 rubric 流。Must-Right 針對必要事實,Easy-Wrong 針對模型常見的細節遺漏、幻覺或誤判;再配合 gated scoring,只要必要視覺事實出錯,就會被明顯扣分,而唔係被其他小分數平均掩蓋。

資料規模方面,項目提供 1,038 張 information-dense images,同超過 10,000 條 instance-specific rubrics,來源是用 Circular Peer-Review 建立的 Golden Captions,再蒸餾成評測規則。覆蓋範圍包括 natural scenes、OCR documents、GUIs、charts、STEM、logic puzzles 同 creative/cultural images,明顯偏向高資訊密度、容易出現感知失真的場景。

測試方式不算複雜:這個 GitHub 儲存庫主要提供 evaluation code 和 data,較適合研究團隊、模型開發者,或者需要比較多個 MLLMs 表現的人,把模型輸出的 captions 對照 rubric 計分。它不是部署給終端用家的應用程式,而是拿來驗證模型在圖像理解任務到底穩不穩;使用前亦要接受一點,這類更嚴格的評分會令模型成績比傳統 leaderboard 更難看,但診斷價值更高。

  • 核心取向是由 holistic semantic matching 轉向 atomic auditing
  • Must-Right 與 Easy-Wrong 直接對應關鍵事實與常犯細錯
  • gated scoring 強調「關鍵錯一項就要反映出來」
  • 資料集中在 GUIs、文件、圖表等高密度視覺任務
  • 適合用來比較 20+ 主流 MLLMs 的感知可靠性,而唔只係比較平均分

項目指出模型經常能辨認零碎元素,卻未能同時滿足多個關鍵視覺約束,尤其在 GUIs、documents 同 structured charts 更明顯。README 與 supporting context 亦提到曾評測 20+ 主流 MLLMs,包括 GPT-5.5;不過這個儲存庫重點仍然是評測框架本身,而唔係推出新模型,所以較值得留意的是它怎樣暴露 perception brittleness,而不是單一排行榜名次。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 多模態模型, Qwen, OpenAI, DeepSeek, Gemini, Dataset 數據集

Higgs TTS 3:4B 多語語音生成模型

這是一個主打對話語音生成的 4B TTS 模型,支援 100+ 語言與 zero-shot voice cloning。並提供清楚架構與限制,但未見 GGUF 量化檔。

Og image

這是一個文字轉語音模型 Higgs TTS 3 4B;暫沒有標明它是基於哪個 base model 微調而成。它主要用來把模型回應轉成更接近對話風格的語音,而不只是朗讀文字,並支援 zero-shot voice cloning、情緒、語氣、停頓同 sound effects 控制。

模型核心是約 4B 參數的 autoregressive decoder,規格包括 36 layers、hidden size 2560,以及 GQA 32/8。音訊端先由 Higgs Tokenizer 編碼成 8 個 codebooks、25 fps 的 audio tokens,再透過 delay pattern、multi-codebook fused embedding 同 multi-codebook fused head 處理,最後還原成 24 kHz waveform;這種設計重點在於同時建模文字與音訊 token,讓語音表達更連續。

訓練序列長度為 8,192 tokens,對長句、多輪語音回應會有幫助。語言覆蓋超過 100 種,並提到 102 種語言做到單位數 WER/CER,其中 85 種達到低於 5 的水準,代表它不只追求可讀性,亦重視跨語言穩定度。

  • 定位清楚:偏向 voice chat 與 expressive conversational speech,而非單純 TTS 朗讀器。
  • 控制能力完整:可直接控制 emotion、style、prosody、pauses 與 sound effects。
  • 多語能力強:支援 100+ 語言,102 種語言有公開 WER/CER 描述。
  • 授權限制明確:只開放 research and non-commercial use,商業用途需另取授權。

模型未提供 GGUF 格式、量化級別、檔案大小、mmproj、llama.cpp、Ollama 或 LM Studio 支援資訊,也未見 v2 檔名變更、chat template 注意事項與 MTP draft speculation 相關內容;這些多數屬於 LLM 或多模態推理頁面常見資訊,並非此 TTS 頁面的重點。使用上更值得留意的是授權條款與風險限制,包括未經同意的 voice cloning、冒充、詐騙、選舉誤導與生物識別監控都被禁止。

項目主頁 · 模型

Categories: 開源, 文字轉語音, 模型, Audio, Clone, 語音

ABot-M0 用 600 萬軌跡訓練機械人操作

ABot-M0 是面向機械人操作的 VLA foundation model,結合大型資料與新動作學習方法。它重點解決機械人資料分散、控制不穩定和跨任務泛化問題。

ABot-M0 model overview

這是一個面向機械人操作的 Vision-Language-Action(VLA)foundation model,名為 ABot-M0。它主要用來讓機械人根據視覺與指令完成操作任務,並處理資料分散、動作表示不一致,以及控制模型訓練效率偏低的問題。

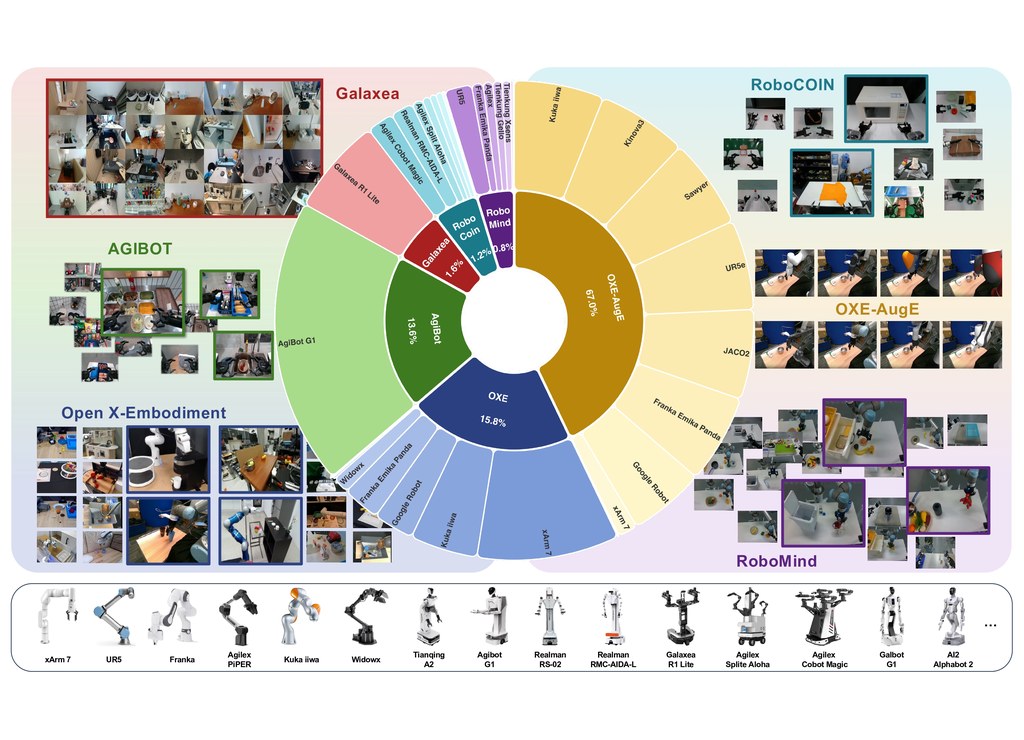
ABot-M0 的基礎來自 UniACT-dataset。這個資料集整合 6 個公開資料來源,包含 OXE、OXE-AugE 與 AgiBot-Beta,合共超過 600 萬條 trajectories、9,500 小時以上互動資料,並覆蓋 20 多種機械人形態;資料亦經過清理、標準化與統一,將動作轉成 end-effector 座標系中的 delta actions,旋轉則採用較穩定的 rotation vector 表示。

它和常見 diffusion 式控制方法的主要差異,在於採用 Action Manifold Learning(AML)。一般 diffusion model 多數學習預測 noise,ABot-M0 則直接做 Direct Action Prediction(a-prediction),輸出乾淨的動作序列;這種做法把學習重點由「擬合噪聲」轉成「投影到可行動作流形」,理論上更有效率,也更有助提升解碼速度與 policy stability。

另一個實用方向是模組化 3D perception。ABot-M0 支援 plug-and-play 模組去加強 3D 空間理解,對涉及精準位置、姿態與複雜操作步驟的任務會更有幫助;同時,它亦用「pad-to-dual」策略統一 single-arm 與 dual-arm 任務,令同一模型可覆蓋更廣的操作場景。

  • 整合超過 600 萬條 trajectories,資料規模相當大
  • 以 UniACT-dataset 統一不同來源與不同機械人表示方式
  • 採用 Action Manifold Learning(AML),直接預測動作而非噪聲
  • 支援 plug-and-play 3D perception 模組,提升複雜任務精度
  • 適合關注 robotic manipulation、VLA 與通用機械人控制的讀者

現有資料重點放在方法設計與資料規模,具體基準分數與完整比較結果在這份內容中未完全展開。即使如此,ABot-M0 已清楚展示一條很具代表性的路線:先用大規模統一資料打底,再用更貼近可行動作結構的學習方式,提升機械人操作模型的泛化與穩定性。

項目主頁

Categories: 開源, 模型, 視覺模型, 多模態模型, VLA, Robotic, 3D, Dataset 數據集

Hermes MoA 協作提升答案質素

MoA 讓多個 LLM 平行作答,再交由一個模型整合。它適合較複雜的問題,但成本和延遲都會增加。

Hero image preview

這是 Hermes MoA(Mixture of Agents,混合代理)架構。它的主要用途是讓多個 Large Language Models 同時回答同一條問題,再由一個聚合者整合各自較強的部分,輸出單一答案。

MoA 的重點不在於訓練一個新模型,而是把多個現有模型疊成一個協作流程。文件指出它依靠多樣性、互補性與聚合三個機制運作:不同模型會走出不同推理路徑,彼此可以補足盲點,最後再由較強的模型統整結果。這種做法和只用單一模型相比,目標是提升複雜任務的回答質素。

在 Hermes Agent 內,這個項目提供三種落地方式:shell 腳本、delegate_task 與 Kanban。Shell 版本最直接,做法是先把多個 proposer 的回覆收集起來,再交給 aggregator 讀取並重寫成最終答案,較適合快速驗證流程;另外兩種方式則較適合需要更穩定管理的工作流。

文件亦清楚交代取捨。MoA 的成本大約是 N+1 倍,延遲通常接近最慢 proposer 再加 aggregator 的時間,所以不適合簡單問答;但對需要比較、整合、推理的任務會更有價值。頁面同時提到在 AlpacaEval 2.0 可帶來約 65% lift,而 proposer 數量以 3 至 5 個作為較理想的平衡點。

  • 核心流程是平行提議者 + 單一聚合者
  • 主要價值在於結合不同模型的長處
  • Hermes Agent 支援 shell、delegate_task、Kanban 三種實作
  • 成本與延遲明顯上升,較適合複雜任務
  • 示例有 anthropic/claude-sonnet-4、openai/gpt-4o、google/gemini-2.5-pro、deepseek/deepseek-chat

適合想在現有 LLM 工作流上疊加協作機制的人閱讀,尤其是需要提升答案穩定性、綜合能力或多角度分析的場景。它不是單一模型的介紹,而是一種可直接套用在 Hermes Agent 的編排方法。

項目主頁

Categories: Agentic, Google, OpenAI, DeepSeek, Gemini, 框架, Anthropic, Dataset 數據集

Page 79 of 183
1 … 77 78 79 80 81 … 183