Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

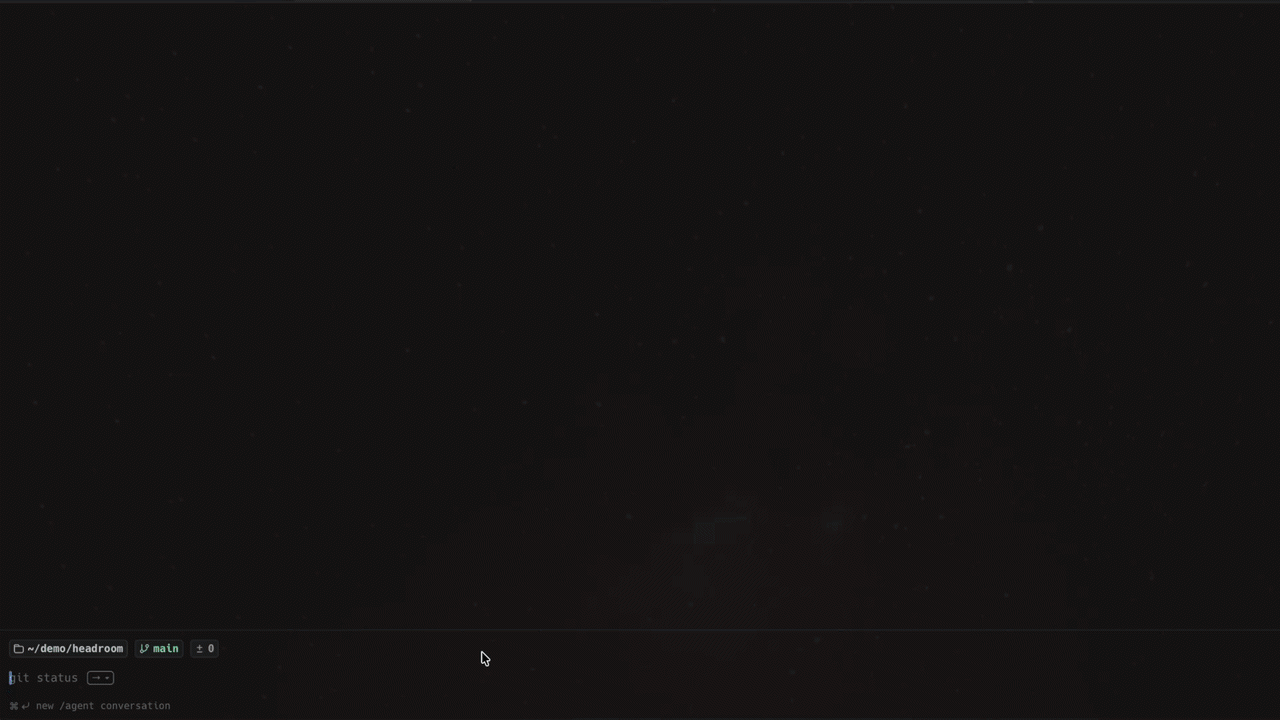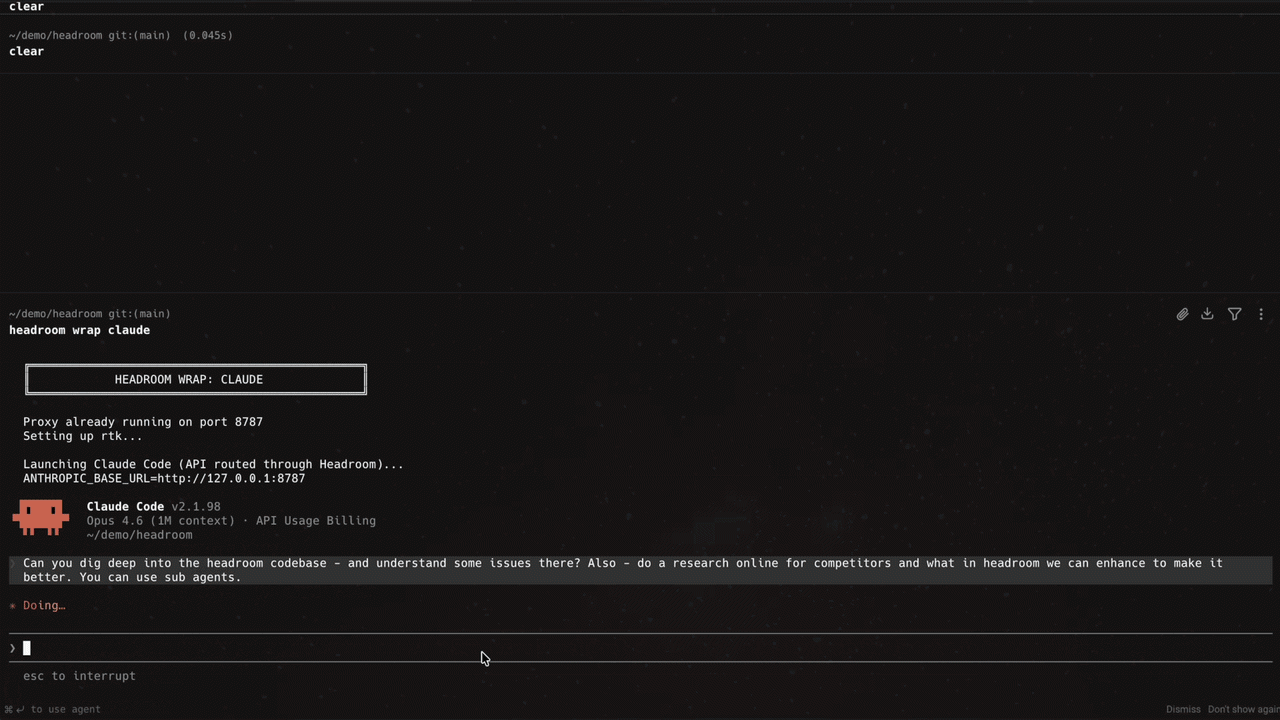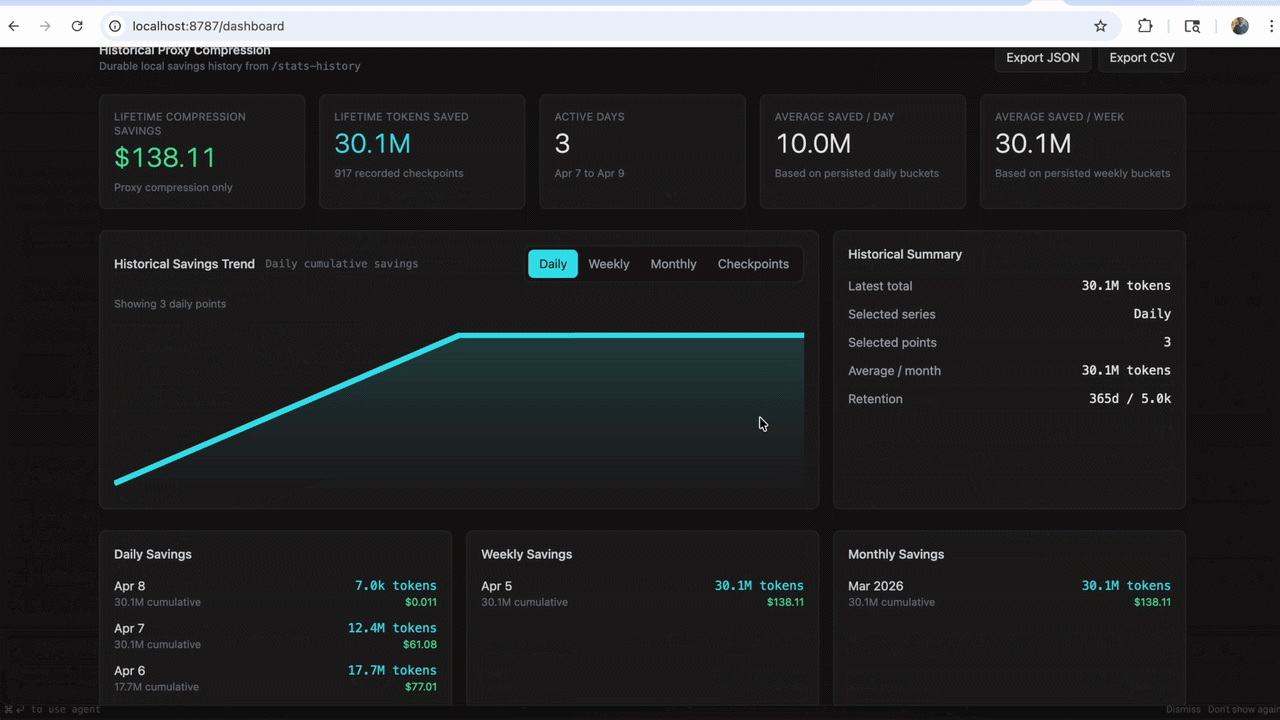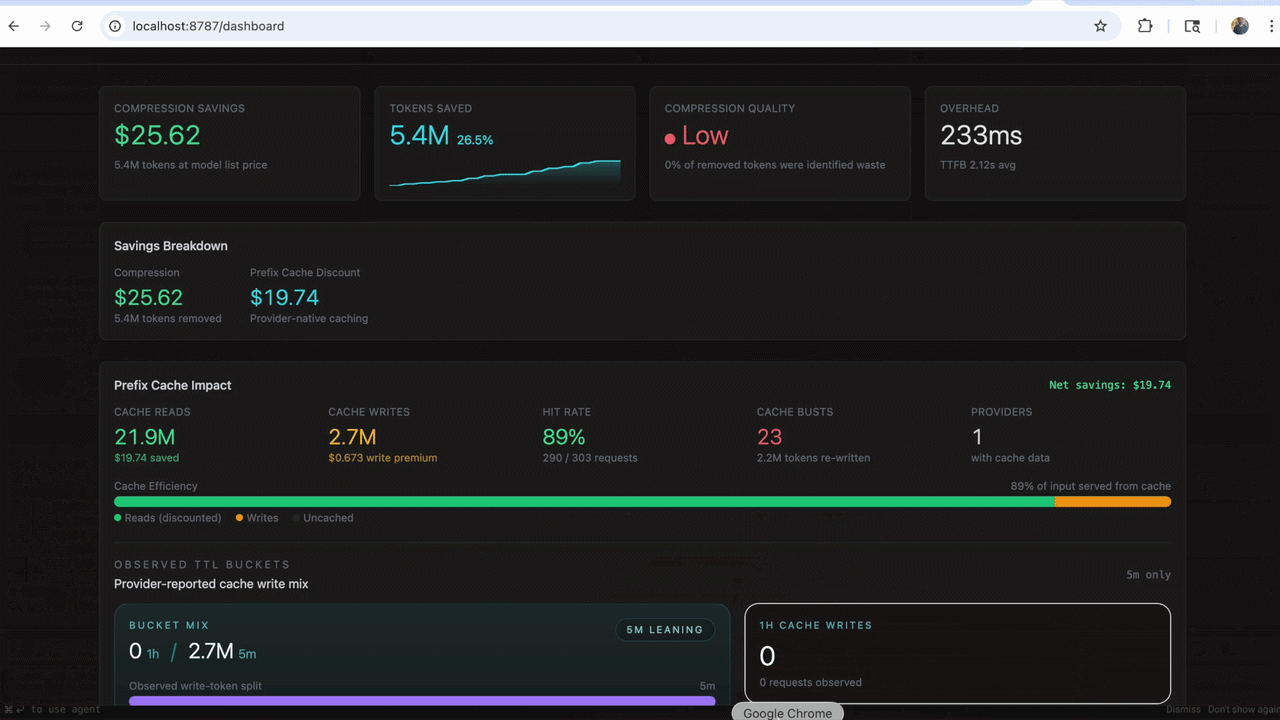
Headroom in action

Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。
GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, 庫, 編程, Anthropic

OpenMontage:AI 代理拍片流程

OpenMontage 想把 AI coding assistant 變成自動化影片製作流程。它重點不只生圖做片,亦會搜集真實動態素材再完成剪輯。

影片製作最花時間的,往往不是按下生成按鈕,而是串接研究、腳本、素材、配音與剪接。OpenMontage Studio 是一個由 AI agents 驅動的創意工作空間,處理影片、圖片、音訊、動畫與 3D 內容,亦可從既有素材開始完成單一任務。

它把製作拆成 8 個階段及 1 個審批關卡:Brief、Research、Script、Scene Plan、The Gate、Narration、Music、Compose 與 Render。系統會先整理受眾、时长、語氣與訊息,再研究產品畫面、參考影片及競爭對手,繼而產出附旁白與 B-roll 指示的劇本。The Gate 會列出將使用的素材、模型、旁白及音樂,待確認或修改後才繼續製作。

  • 研究與定位資料會寫入 decision log,保留決策依據。
  • 場景可混合採用現有素材、素材庫、Stock 素材或生成內容。
  • 旁白可按句子加入修改意見,不必重寫整篇內容。
  • 音樂可按氣氛、每分鐘拍數及能量配對,亦可另行生成。
  • 製作可在 OpenMontage Studio、Claude Code 或 ChatGPT Codex 進行。

這種做法適合已有品牌資料、產品錄影或商品素材的團隊,可由一個構思直接建立完整短片,也可只處理配音、音訊清理或視覺生成。代價是製作仍需經過 The Gate 審批,AI 的研究、定位與場景選擇亦不代表最終成品必然準確;創作者仍要核對品牌訊息、素材授權及輸出質素。

GitHub

Categories: 開源, Agentic, 微軟, Video, Image, txt2img, Content Creator, IDE, Anthropic

AgentOdyssey:用文字遊戲測試 AI Agent

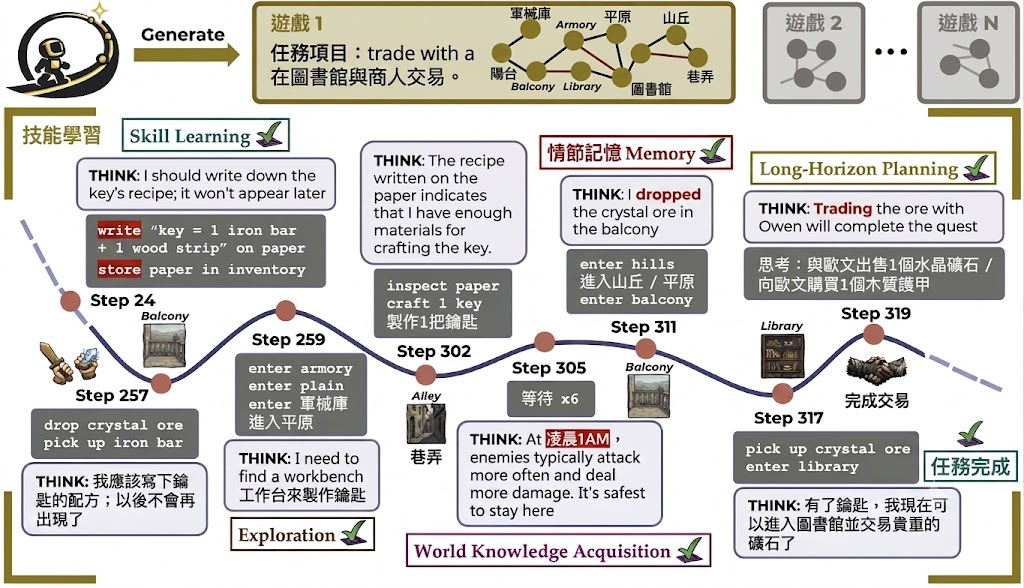
AgentOdyssey 把文字冒險遊戲變成 AI agent 測試場。重點不只看過關,亦會拆開記憶、探索與長程規劃能力。

AgentOdyssey 是一個用來生成文字遊戲並評測 agent 的開源框架。它主要用來檢查 test-time continual learning agents 能否在互動過程中一邊推理、一邊學新知識,而不只是做一次性答題。

現有不少評測仍沿用「測試時不學習」這種固定範式,任務短、回合少,較難看出 agent 會否忘記事情、會否累積世界知識,或者能否處理長步數目標。AgentOdyssey 的做法是程序化產生 open-ended long-horizon text games,把探索、episodic memory、world knowledge acquisition、skill learning 與 long-horizon planning 放進同一個連續環境內一起觀察。

部署理解上,這個項目已提供 PyPI package、文件與互動示範,也可用 HumanAgent 直接進入遊戲,再換成不同 LLM-based agents 做比較。它的 unified agent interface 依賴繼承式類別來共享 prompt 結構,新增 agent 的門檻相對低,對研究團隊做公平對照尤其重要。

  • 可程序化生成全新世界、角色與劇情,唔係只跑固定題庫
  • 評分不只看遊戲進度,亦會拆開觀察記憶、探索、行動多樣性與成本
  • 支援多種 agent paradigms,比較時較容易控制提示格式差異
  • 結果重點很清楚:更強 base models 通常更好,但頂尖 agent 仍明顯落後人類

這個項目較適合做 agent 研究、benchmark 建立、記憶模組測試,或者長流程任務設計;一般內容生成或聊天機械人團隊未必會直接受惠。已公開的重點結果亦指出 short-term memory 對多種 agent paradigms 都有幫助,反映這個框架不只是出分工具,也能用來找出 agent 失效的位置與改良方向。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Skill 技能

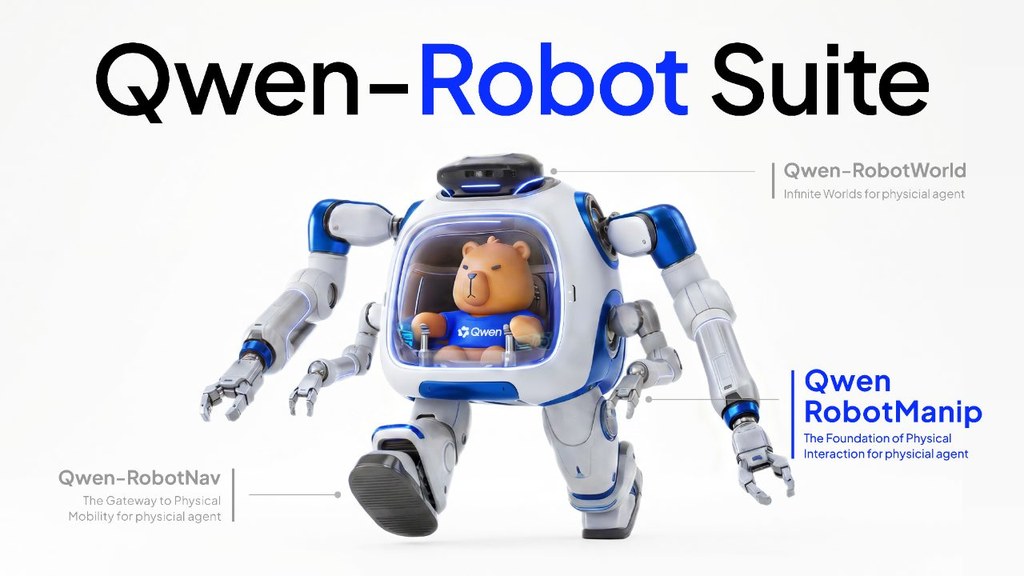
Qwen-RobotManip 如何把機械臂訓練推向通用化

這是一個面向機械人操作的 Vision-Language-Action 基礎模型。它嘗試用統一對齊與大規模資料訓練,提升跨場景與跨機械平台泛化能力。

Og image

這是一個機械人操作模型,名為 Qwen-RobotManip,屬於建基於 Qwen-VL 的 Vision-Language-Action foundation model。它主要處理機械臂操作資料分散、昂貴而且難以統一訓練的問題,目標是讓模型在未見過的任務、場景與機械平台上仍能保持可用表現。

它的核心做法,是把操作學習中的表徵、動作與行為三個層面放進同一套 alignment framework。研究團隊同時建立 human-to-robot synthesis pipeline,將第一身手部示範影片轉成 15 個平台可用的 robot trajectories,再配合多來源資料整理流程,整合真實機械人、合成資料與人類示範影片,形成約 38,100 小時 pretraining corpus。

和常見只集中單一機械平台、單一資料來源,或偏重分佈內表現的做法相比,Qwen-RobotManip 更著重 genuine generalization。評估上亦沒有停留在一般 benchmark,而是加入多個 OOD 設定,包括 RoboCasa365、LIBERO-Plus、EBench、RoboTwin-Clean2Rand、RoboTwin-IF 與 RoboTwin-XE,用來檢查指令跟隨、擾動穩健性、錯誤恢復,以及 cross-embodiment knowledge transfer。

重點可整理為:
– 建基於 Qwen-VL,面向 robotic manipulation 的通用基礎模型
– 以 unified alignment framework 整合 heterogeneous manipulation data
– 使用 human-to-robot synthesis pipeline,覆蓋 15 個機械平台
– 只依靠 open-source robotic manipulation datasets 與 human demonstration videos,未提及私有資料收集
– 在多個 OOD 評測中優於過往 state-of-the-art models,包括 π0.5,並在 RoboChallenge 排名第一

這個項目較適合關注 robotic manipulation、VLA、跨機械平台遷移與機械人資料擴展流程的人閱讀。現有資料顯示,它不單是再加大訓練規模,而是先解決資料對齊問題,令擴充規模之後的訓練信號不會互相衝突,這也是它能在真實機械平台驗證泛化能力的關鍵。

項目主頁 · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, 框架

MemoBench 點樣測世界模型記憶力

MemoBench專門檢查世界生成模型會否在物件離鏡後再出現時「記錯樣」。它用V-D-R流程,把畫質、一致性與語意判斷拆開量度。

Repository image for MemoBench-Team/MemoBench

MemoBench 是一個 benchmark,屬於用來評測 world generation models 的數據集加評測工具組。它主要檢查模型在鏡頭移開再回來之後,能否把同一個物件的外觀、位置與狀態準確重建,而不是只生成一段看似流暢的影片。

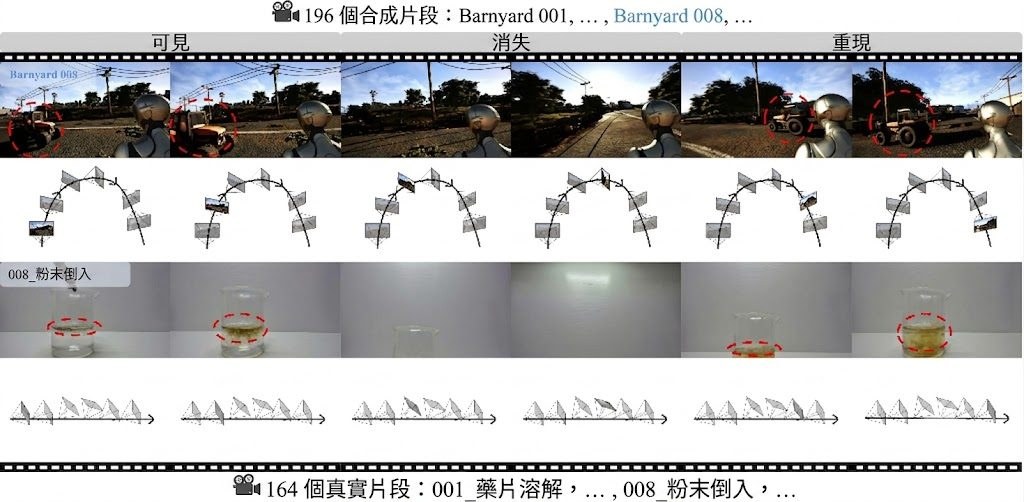
現有影片生成或世界模型評測,很多時集中在畫質、動作流暢度,或者短時間一致性;作者認為這類範式未必能測到 visual memory。MemoBench 因此用 V-D-R (Visible → Disappeared → Reappear) 結構重組任務:先見到目標物件,再讓它離開視野,最後要求模型在重返視野時保持物件永久性與幾何一致性,這比單看首尾畫面更接近真正的記憶測試。

資料部分有 360 段片,分成 196 段 synthetic 與 164 段 real-world clips,並提供 V-D-R 邊界、GT camera poses、目標物件文字描述、VQA question banks 等配套。部署思路相當清楚:環境以 Linux、Python 3.11、CUDA GPU 為主,評測流程分成自動指標、Object Revisit Score (ORS),以及 VQA 三步,輸入格式是逐格 PNG 圖片;camera controllability 會用到 MapAnything,ORS 會用到 SAM-3。

它和同類 benchmark 的差異,不在於片段數量特別大,而在於把「物件消失後再出現」設成核心壓力測試,並同時覆蓋 synthetic 與真實場景。14 項指標亦不是只量畫面好不好看,還會看 temporal consistency、geometric fidelity、object permanence、camera controllability,以及 VQA-based reasoning,取向明顯偏向診斷模型缺口,而不是只做單一排行榜。

  • 適合比較 不同 world generation models 在長時序記憶上的穩定度
  • 測試材料完整,包含 phase 邊界、相機姿態、文字提示與 VQA 題庫
  • 評測角度較細,把低階畫質與高階語意一致性分開量度
  • 部署門檻不算低,需要 Linux、CUDA GPU,亦依賴 MapAnything 與 SAM-3

相關模型方面,官方內容提到已基準測試 8 個模型,但這份儲存庫摘要未列出完整名稱,因此較穩妥的理解是:MemoBench 重點不是提供新模型,而是提供一套可重覆的記憶一致性測試基準。對研究 world modeling、影片生成、camera-controlled generation 的團隊尤其有參考價值,因為它能幫你分辨模型是「畫得靚」,還是真正記得之前見過什麼。

項目主頁 · GitHub · Paper

Categories: Google, NVIDIA, Image, 框架, Linux, Python

PRA:像素級自回歸生圖的新路線

PRA 是一個 PyTorch 影像生成研究項目,主打 pixel-space autoregressive 生成。它嘗試用較細模型規模,換到更低 FID 表現。

result

PRA 是一個以 PyTorch 實作的影像生成研究項目,屬於 class-conditional pixel-space autoregressive image generation 模型與訓練框架。它要解決的問題,是直接在像素空間逐步生成圖片時,單步誤差大、而且 teacher-forced training 與推理流程不一致,令誤差一路累積。

現有 pixel-space continuous-token autoregressive 做法,多數直接預測高維像素 patch,或用 x-prediction、input noise injection 減輕誤差,但改善有限;exact rollout training 雖然更貼近推理,代價又太高。PRA 的取向是加入 Parallel Rollout Approximation (PRA):先生成低維 intermediate states,再經 pixel decoder 映射回 pixel-space tokens,同時用近似推理時的 pixel-feedback 方式保留平行訓練效率。

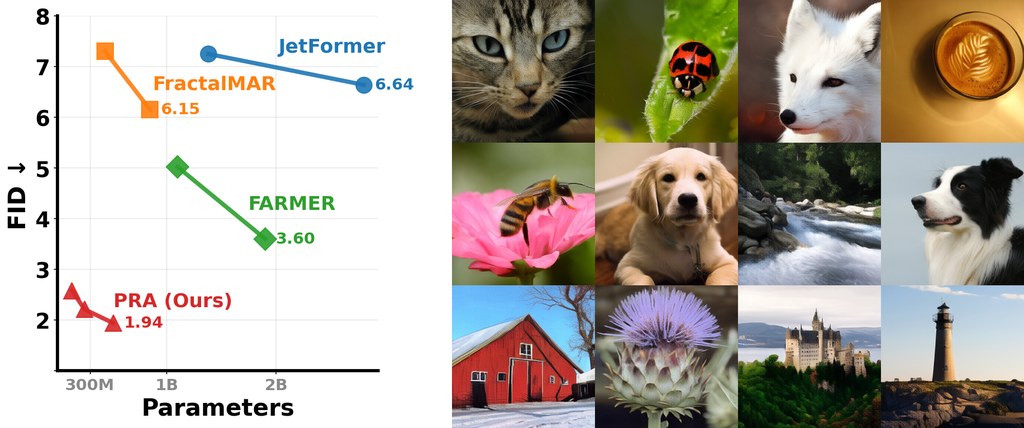
這個設計的重點,不是單純追求更大模型,而是重新處理「訓練見到的輸入」與「生成時真正收到的回饋」之間的落差。論文資料顯示,它在 ImageNet-1K 256×256 的 class-conditional 生成上,PRA-S 135M 參數已做到 FID 2.58,優於先前 billion-scale pixel-space AR 的 3.60;PRA-L 511M 進一步到 1.94,定位很清楚,就是衝着 pixel-space AR 的 SOTA 而來。

部署理解上,儲存庫已提供 environment.yml、requirements.txt、預訓練權重與 sample_ddp.py,代表作者預設你會用多卡分散式抽樣與評測。評估指標包括 FID、Inception Score、precision、recall,另有 ImageNet classification probing accuracy 作為生成以外的補充觀察,表示作者也在測試表徵能力,而不只看出圖漂亮與否。

  • 項目類型:研究原型兼模型實作,集中展示 PRA 訓練與取樣流程
  • 相關模型:PRA-S、PRA-B、PRA-L,參數量約 135M、250M、511M
  • 主要差異:不用離散 tokenizer,維持 pixel-in、pixel-out AR 介面
  • 較適合情境:研究 pixel-space AR、比較生成指標、重現 ImageNet 類條件生圖結果
  • 需要留意:目前公開內容偏向研究重現,不是即裝即用的終端應用工具

受益最大的,會是做影像生成研究的團隊、想比較 autoregressive 與 diffusion 路線的人,以及要研究像素空間建模取捨的學術項目。對一般開發者來說,這個項目較像高水準實驗平台;有現成 checkpoint 和評測流程是優點,但 CUDA、PyTorch 與 FlashAttention 相容性仍需自行處理。

GitHub · Paper

Categories: 北京大學, 模型訓練, Image, 影像模型, Python

MultiHashFormer:用雜湊重寫語言模型詞表

這個項目把語言模型的詞表問題改寫成 hash signature 生成。重點不只省參數,還想讓擴充詞彙時維持固定模型體積。

Repository image for HUIYINXUE/MHF

MultiHashFormer 是一個生成式語言模型研究項目,同時提供 Qwen3 相關實作、訓練腳本與詞彙擴充流程。它要解決的是傳統 embedding matrix 會隨 vocabulary size 線性膨脹,令模型難以用固定參數量吸收更多詞彙、語種或新領域內容。

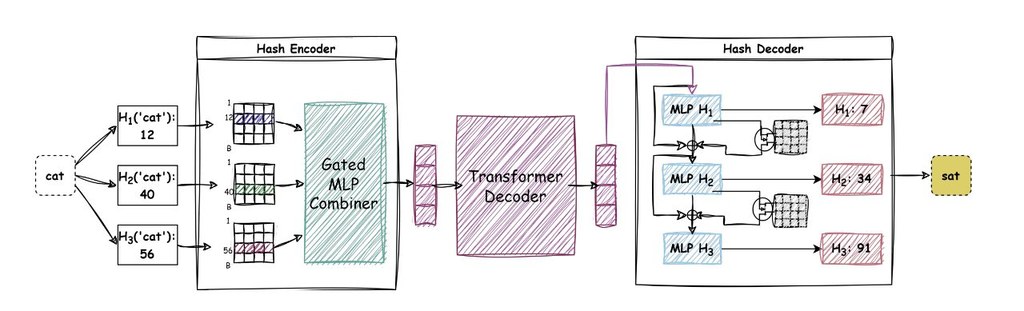
現有 hash-based 做法多數採用 many-to-one mappings,把多個 token 壓到同一個 hash index,這在 encoder-only 模型尚可運作,但放到 causal LMs 就會出現解碼歧義:模型預測到共享 index,未必能準確還原原來那個 token。MultiHashFormer 的做法是為每個 token 建立 unique hash signature,用多個獨立 hash functions 產生一串離散 hash IDs,再交由 Hash Encoder 壓成 latent vector,最後由 Hash Decoder 生成下一個 token 的 hash signature。

這個設計的取向很明確:它不是單純縮小 embedding,而是重組「token 如何表示、如何生成」這條路徑,目標是在保持參數 footprint 固定的前提下,仍可做 autoregression。來源資料亦顯示作者把它放到 100M、1B、3B 規模,並提供 standard 與 MHF 兩組訓練腳本,方便直接對照 baseline,不過 README 未完整列出所有 benchmark 數字,閱讀時應以論文結果為準。

部署理解上,這個項目比較接近研究代碼而非即裝即用產品:preprocessing 內有英文預訓練資料處理腳本,training 內分 standard 與 MHF 訓練流程,vocab_expansion 則涵蓋 tokenizer 訓練、資料準備、continual pretraining 與 expanded_tokenizer。依賴包括 transformers、flash_attn、tokenizers、lm_eval 與 mmh3,代表它面向的是已有 Python 深度學習環境、想重現論文或測試詞彙擴充的人。

  • 項目類型:研究原型兼模型訓練代碼,核心是 hash-based autoregressive language modeling。
  • 主要差異:不再用 many-to-one hashing 直接代表 token,而是生成可還原的 unique hash signature。
  • 適合情境:比較標準 Transformer 與 MHF、研究 vocabulary expansion、測試固定參數量下的多語詞表延展。
  • 相關模型:Qwen3 標準版、qwen3_ori、qwen3_hashformer,以及 100M/1B/3B 多個 HuggingFace checkpoints。

整體來看,這個項目的價值在於它不只提出一個更省參數的表示法,還試圖修補 hash 方法長期無法自然用於生成式模型的缺口。對研究語言模型架構、詞表擴展與參數效率的團隊來說,它比一般「換個 tokenizer」更值得細看,因為連輸入表示與下一 token 生成機制都一併改寫了。

GitHub · Paper

Categories: Embedding, 模型訓練, Qwen, Python, 語音

ConvFill:即時語音代理的雙模型方案

ConvFill 用本地小模型先開口,再由雲端大模型補上答案。它想解決語音代理常見的「快但唔夠準,準但唔夠快」拉扯。

Teaser

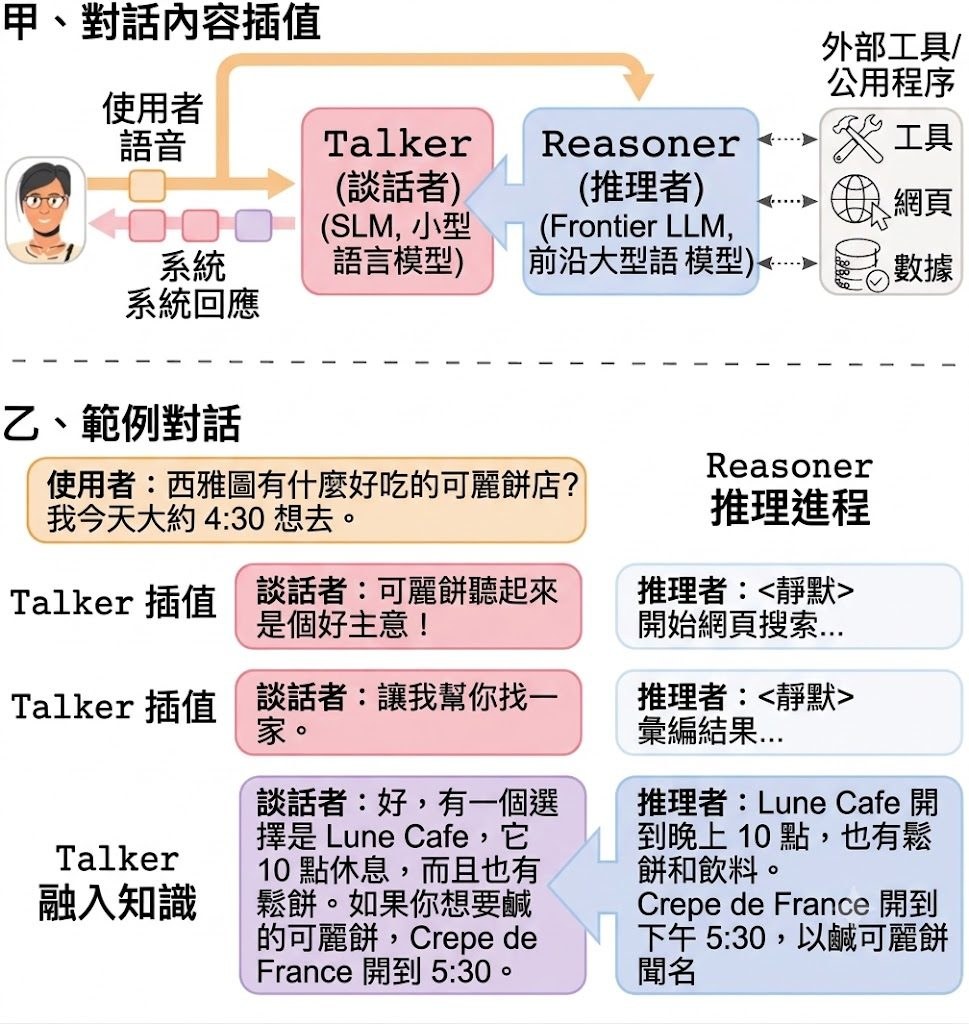
ConvFill 是一個用來建立語音代理的開源系統與研究原型。能夠實現即時回應和準確回答——這兩個目標通常難以兼顧。它將本地運行的小型快速語言模型與在後台進行繁重推理的大型雲端模型相結合,使代理能夠立即開始對話,並在資訊可用時自動填充合理的答案。此程式碼庫包含完整的系統、一個即時語音演示、七個即用型模型以及訓練您自己的模型所需的一切資源。

現有做法通常要麼直接等大型模型完整生成,回應較慢;要麼改用較小模型追求低延遲,但複雜查詢、文件搜尋同工具調用能力會明顯下降。ConvFill 提出 conversational infill 這個新任務,將 Talker 與 Reasoner 分工:Talker 先即時說話,Reasoner 在背景處理慢工序,再把精簡知識流式交回 Talker 融入回答。

ConvFill 不是單純做語音介面,而是重新安排推理時序。Talker 可用 135M 到 1.7B 參數的小模型,在手提電腦或手機本地運行;Reasoner 則可接 Claude、GPT 或 Gemini。儲存庫已提供 live voice demo、七個現成模型,以及訓練自家 Talker 所需內容,理解上可視為「本地即時對話層 + 雲端能力層」的組合。

  • 內置七個已微調 Talker,涵蓋 Qwen、Llama、Gemma、SmolLM 家族
  • 配套 ConvFill dataset,含 290,571 個經驗證訓練樣本,覆蓋六個領域
  • Reasoner 可替換為 Claude、OpenAI 或 Gemini,毋須為更換 Reasoner 重新訓練
  • 論文指出系統可維持 millisecond-level time-to-first-response,準確度與對應 frontier Reasoner 的差距縮至 6.3% 內

受益最明顯的,會是想做客服、助理、查詢式語音介面或需要邊說邊找資料的團隊。它未必適合完全離線、又要求深度推理的場景,因為關鍵能力仍依賴雲端 Reasoner;但對希望保留本地回應速度,同時接入大模型能力的項目,這套設計比單模型方案更有工程上的彈性。

GitHub · Paper

Categories: 開源, 模型, Qwen, OpenAI, Gemini, LLaMa, 語音, Anthropic, 蘋果, Dataset 數據集

微軟用殘差強化學習補強機械人 VLA

這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。

Og image

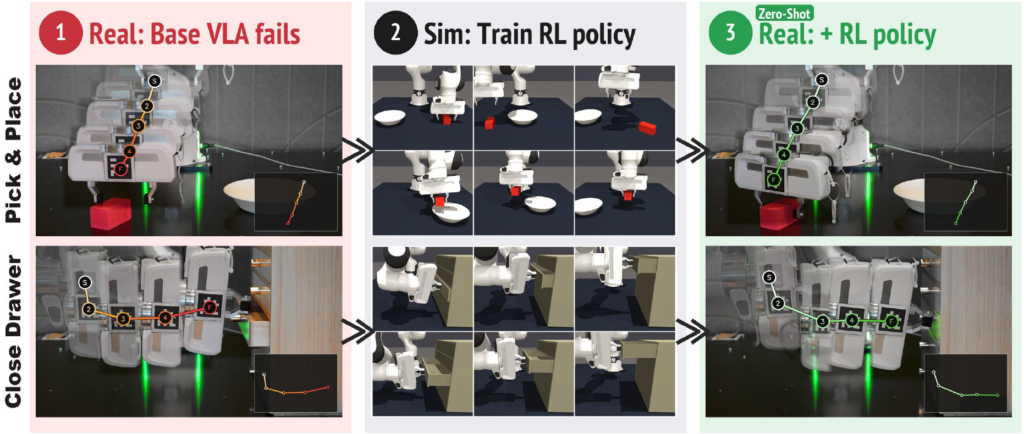
這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。

核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。

這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。

  • 保留 frozen base VLA,不用重訓整個模型
  • residual policy 以物件中心狀態為主,減少依賴影像對齊
  • 目標是 zero-shot sim-to-real enhancement
  • 適合需要精準抓取、放置或接觸操作的機械人工作流

這類方法較適合關注 VLA、Robotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。

項目主頁 · Paper

Categories: Agentic, AI productions, 視覺模型, 多模態模型, 微軟, Image, VLA, Robotic, 框架, 編程, 安全

AgentChord:多代理系統優化框架解析

AgentChord 用 GBC 追蹤多代理系統入面邊個步驟出錯。它不止幫你搭建流程,亦著重後續優化與觀察。

logo

AgentChord 是一個用來建立、執行同優化 multi-agent systems (MAS) 的開源框架。它想解決的不只是「點樣串起多個代理」,而是多代理流程出錯時,究竟應該由哪個代理、哪一步互動負責。

現有做法多數靠 coarse-grained feedback,例如只看整體任務成功與否,之後再回頭調 prompt 或改流程;作者認為這種範式難以做 fine-grained credit assignment,所以提出 Gradient-Based Connections (GBC),將 MAS 視為 computational graph,並用 token level 的梯度連接權重追蹤下游結果受哪些代理輸出影響。AgentChord 就是這套方法的實作框架,重點不是單純編排代理,而是讓優化有可追蹤依據。

從現有資料來看,這個項目部署思路算清楚:先準備 Astral UV、設定 LiteLLM 的 .env,再用 examples 內的示例理解環境、模型與 agent system 的組合方式。它支援用 ModelConfig 設定本地或 API 模型,例如 LlamaModel、openai/gpt-4o-mini,亦可加入 quantization、generation 參數,以及 connection_strategy、gradient_strategy 這類同 GBC 直接相關的設定。

同類框架很多集中在代理角色分工、工具調用或工作流編排,AgentChord 的取向明顯更偏研究與優化:一方面接上 WandB 監察過程,另一方面用 GBC 視覺化連接與 attribution。代價是它未必是最輕量的 MAS 起步工具,較適合想比較不同代理結構、提示設計與責任歸因效果的研究團隊,而不是只求快速做一個對話流程。

內容指出,GBC 在 MultiWOZ 與 τ-bench 上帶來比強力 single-agent 與 multi-agent baselines 更好的表現,而且 attribution quality 愈高,後續 optimization effectiveness 亦愈好。

你需要先定義環境,再逐步組裝 BaseAgentSystem、GBCAgent、ParallelBlock 等元件。

  • 項目類型:偏研究導向的 MAS 框架,核心在於 GBC 優化與責任歸因
  • 主要差異:不是只做代理編排,而是把多代理互動建成可反向追蹤的圖結構
  • 可配模型:透過 LiteLLM 連接多種 API 模型,亦可配置本地 LlamaModel
  • 較受用情境:多代理實驗、prompt 優化、流程診斷、學術評測
  • 限制:README 提供的是框架級指引,完整 benchmark 重現與細節仍要結合論文理解

相關模型方面,已明確出現的包括 LlamaModel 與 openai/gpt-4o-mini;框架本身經 LiteLLM 設計,理論上重點在於兼容多供應商模型,而不是綁定單一模型家族。整體來看,AgentChord 最有價值的地方,在於它把「多代理為何失敗」這個通常很模糊的問題,盡量變成可以分析、視覺化同優化的工程問題。

GitHub · Paper

Categories: Agentic, API, 框架

Page 80 of 183
1 … 78 79 80 81 82 … 183