觀眾要求「用船運藥,而且不要弄濕」時,系統不能只理解一句新指令,還要記得橋已斷、目的地是祖母家,以及故事原本交代的背景。VIS-Ground 屬於互動影片生成研究框架,處理的正是來源資料、影片前段與觀眾介入之間容易互相牴觸的依賴關係。
它先以 Structured Context Abstraction 對齊 grounding source、已渲染的 video prefix 和 viewer request,再以 Generation Constraints Induction 抽取對下一段影片真正有關的條件,最後經過 plan、verify、revise、render 循環,檢查成片是否同時符合劇情連貫、知識來源和觀眾要求。這比單純把新提示詞交給影片生成器更重視前文約束,但代價是流程更複雜,也需要額外驗證。
- 以可執行 constraint model 連接文字來源、影片內容與互動指令
- VIS-Bench 包含 250 個 sources、1,004 個 viewer interventions 和 2,008 個 instances
- 評估涵蓋 source faithfulness、story continuity、interaction fulfillment 及 joint score
- 在 Omni-1.1-Flash、Veo 3.1 和 MiniMax-H3 三個 video backbones 均取得最高 composite score
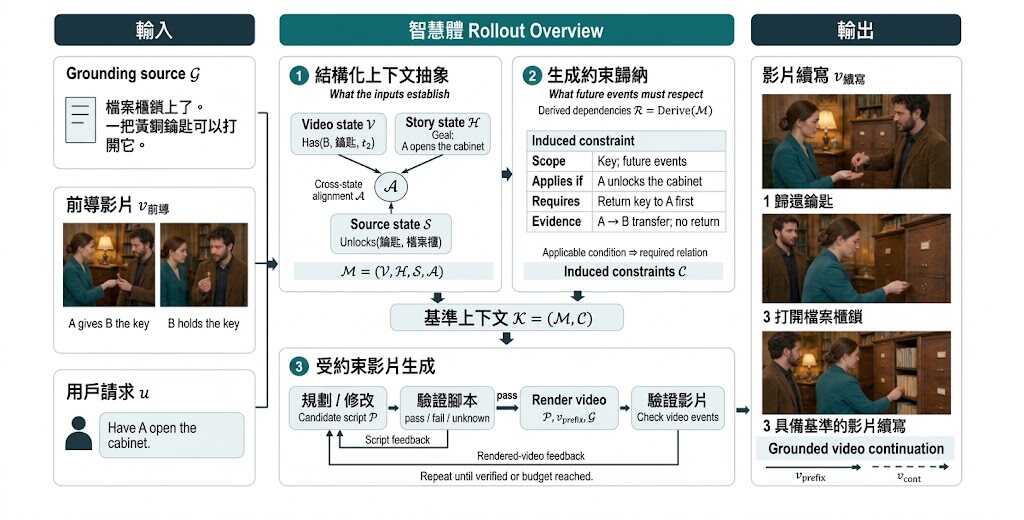
Composite score 為 Omni-1.1-Flash 84.2、Veo 3.1 84.6、MiniMax-H3 78.8,較各自最強 baseline 高 12.3、15.3 和 3.4 分;提升主要集中在 story continuity。這些結果反映方法能跨越不同影片生成 backbone 工作,但資料只涵蓋 1,004 個互動介入,未足以代表所有敘事類型。
適合研究互動敘事、可控影片生成和多模態代理的團隊,用來測試「觀眾改變故事後,生成結果能否守住既有事實與新限制」。GitHub 目前只列出代碼、VIS-Bench 資料和評估腳本預告在 2026 年 12 月 15 日前釋出,因此暫時缺乏可按步驟安裝及本地測試的完整資訊。