VIABench 視覺模型如何協助失明應用

不少影片模型識描述畫面,未必識幫人做決定。VIABench 把測試搬到視障人士日常片段,重點睇模型能否提供真正有用的協助。

VIABench cover

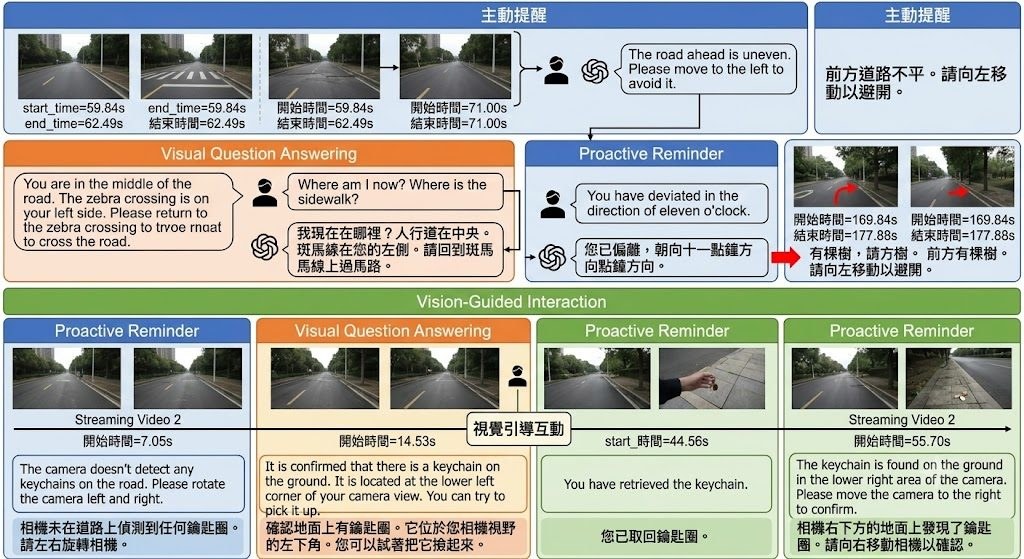
講到視覺模型,很多測試仍然停留在「見到乜、答到乜」;VIABench 把焦點轉去更貼身的助盲情境,直接檢查多模態大型語言模型可否在日常片段中作出提醒、回答環境問題,甚至按目標提供引導。它屬於Dataset 數據集兼評測基準,處理的是視障協助場景長期缺乏貼地測試標準這個問題。

VIABench 不再只量度被動理解,而是把影片 Multimodal Large Language Models 與真實任務綁在一起。資料來自盲人錄製或分享的第一身影片,包含 761 段影片、46.9 小時內容,以及 14,526 筆人工整理標註,圍繞 Proactive Reminder、Visual Question Answering、Vision-Guided Interaction 三類任務,測試模型會否在合適時間講合適內容。

和常見視覺問答基準相比,VIABench 的分野在於它重視「協助能力」多過一般描述能力。這意味模型不單要看懂畫面,還要判斷何時提醒、如何回應環境細節,以及怎樣支援使用者完成目標;取捨是任務更接近真實世界,但評測難度也更高,單靠表面語意對齊未必夠。

  • 核心價值在於測試影片 MLLMs 能否提供可行協助,而非只做畫面解說
  • 任務覆蓋主動提醒、視覺問答、互動引導三種助盲場景
  • 數據來自真實第一身影片,場景代表性比通用影片基準更強

較適合關注無障礙 AI、assistive technology、video MLLMs 評測的研究團隊,也適合想比較不同模型在真實互動場景表現的人。現有資料已足夠理解它作為基準的定位;使用前較合理的做法,是先查閱論文與 Hugging Face 資料集頁面,再確認支援哪些相關模型與評測設定。

GitHub

Categories: 開源, 南京大學, 視覺模型, 多模態模型, Video, Dataset 數據集

VideoChat3 一個睇得耐又睇得準的影片模型

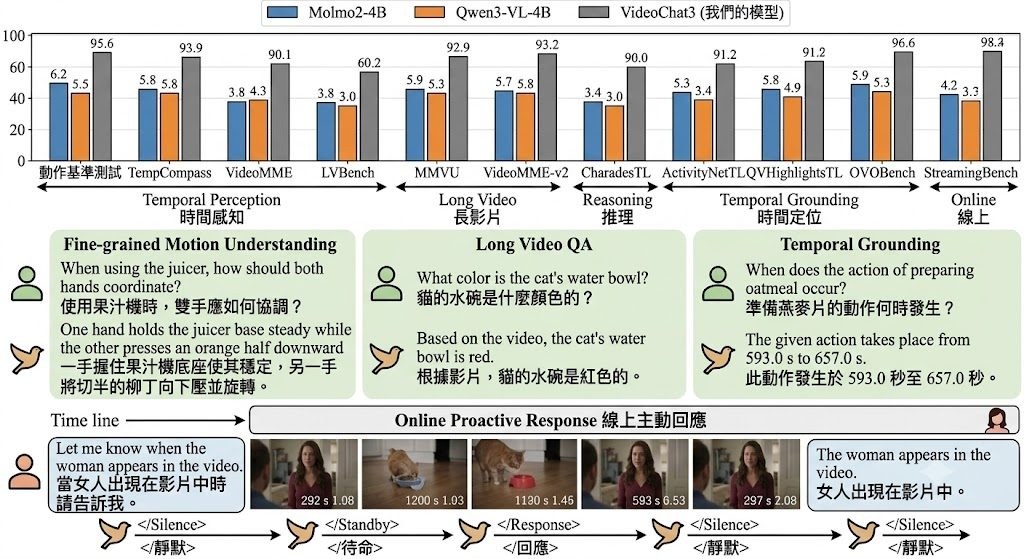
要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

Wan Streamer v0.3:讓 AI 學懂「世界不變,只有事件在流動」

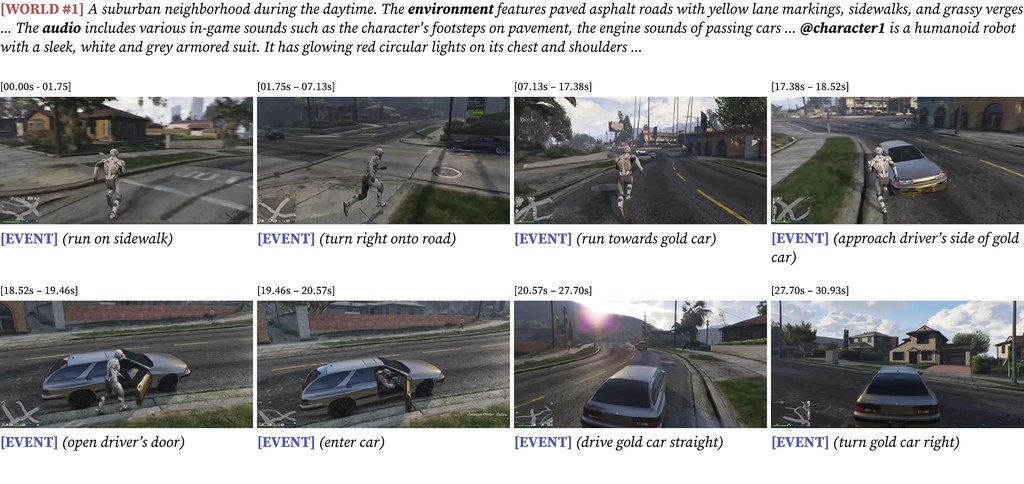
Wan Streamer v0.3 把影片拆成「持續存在的世界」和「持續發生的事件」,讓即時音視頻對話支援自由動作描述,延遲仍維持約 200ms。你可以把它理解成:一個會記得場景、然後跟著時間線即興演下去的 AI 對手。

A robot navigates a suburban neighborhood and drives a car through a sequence of events

玩過 AI 影片對話工具的人都會發現一個矛盾:模型可以跟你聊天,但一旦想做動作,畫面就容易卡頓、失憶,甚至換了一張臉。Wan Streamer v0.3 想解決的就是這個問題——它把影片分成兩件事來學,一件是「世界設定」(場景、角色、畫風、聲音這些要長期保持一致的東西),另一件是「事件流」(說話、動作、鏡頭移動、環境變化這些隨時間發生的事)。

這個拆法聽起來抽象,但對使用者來說,最直接的差別就是角色終於可以做自然語言描述的動作了。你打開鏡頭,模型會一邊跟你說話,一邊伸手拿起眼前的物件、轉向聲音來源、或者露出驚訝的表情,而且動作和對嘴的時序是學出來的,不是後製對齊的。延遲仍然維持在約 200 毫秒,解析度 640×368、幀率 25fps,即時互動不會被打斷。

從工作流角度看,這個版本最大的價值是把普通影片變成訓練素材:先建立世界,再沿時間軸學接下來會發生什麼。同一套能力日後可以遷移到漫遊探索、機器人控制等場景,而這次發佈聚焦在即時音視頻對話。

重點摘要:

  • 拆解式學習:將「持續世界」與「事件流」分開建模,避免長對話中場景漂移
  • 自由動作描述:支援用自然語言寫出動作(如拿取物件、轉向、變換姿勢),並與對話同步渲染
  • 即時互動規格:640×368、25fps、約 200ms 模型側延遲,支援全雙工音視頻
  • 普通影片即訓練素材:不需特殊標註,現成影片就能用於學習時間軸上的因果事件
  • 可遷移架構:同一套預訓練能力可延伸至具身導航、漫遊等場景

對於做數位人、虛擬主播、互動敘事或即時陪聊的團隊,這個方向值得留意;對於只是想試試看的個人,現有 demo 已經足夠展示「角色真的在過日子,而不只是在回話」的差異。

項目主頁

Categories: 多模態模型, 世界模型, 模型訓練, Video, Audio, Robotic, 語音, Skill 技能

KeyFrame-Compass:關鍵幀尺度評測

想知道影片生成有沒有跟住關鍵畫面,KeyFrame-Compass 就把這個矛盾拆開量度。它同時看畫面有沒有到位、順序有沒有跟足,還會檢查整體影片質感。

KeyFrame-Compass benchmark domains and examples

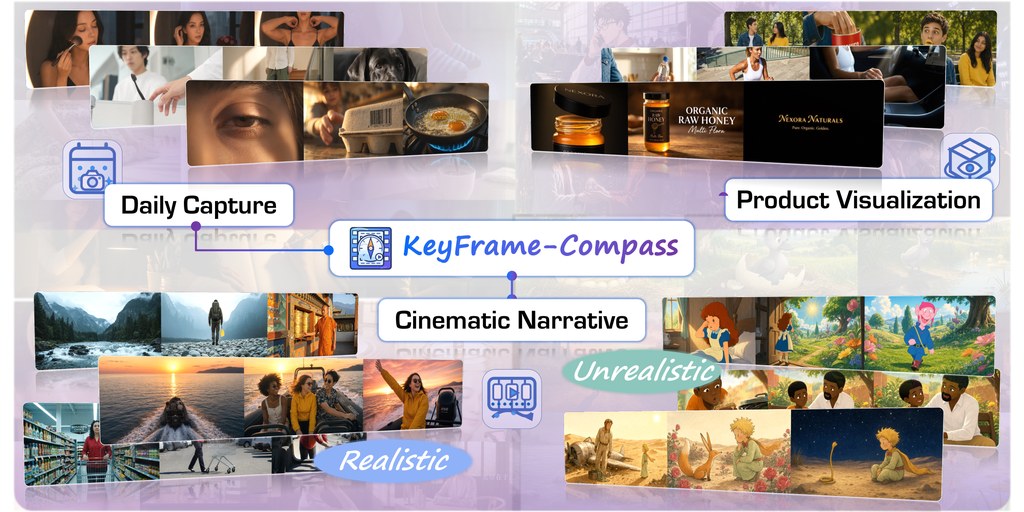
KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。

這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。

官方提供 386 個案例,涵蓋三個應用領域,亦分有 multi-shot 同 one-take 片段,配合四種 keyframe 密度。安裝上需要 Linux、Conda 或 Mamba、NVIDIA GPU,同埋可用的 VLM API;倉庫亦提供 envsassetsall 三種設定模式,方便只建環境、只拉資產,或者一次過做完整驗證。

  • 把影片生成的「跟畫面」同「成片質感」分開量度,結果較容易解讀
  • 支援不同 keyframe 密度,較適合比較模型對控制力的穩定度
  • 適合做影片生成模型、研究原型或產品 demo 的質量驗證
  • 需要 GPU 同外部 VLM API,部署門檻唔算低
  • 相關模型類別可歸到 Video、視覺模型、多模態模型、模型、工具

GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Gemini, API, Video, 工具, Linux

MultiRef-Compass:多模態影片不再各自為政

做多模態影片生成,最難往往唔係出片,而係點樣公平比較結果。MultiRef-Compass 把文字、影像參考同音訊參考放入同一套評測流程。

MultiRef-Compass overview

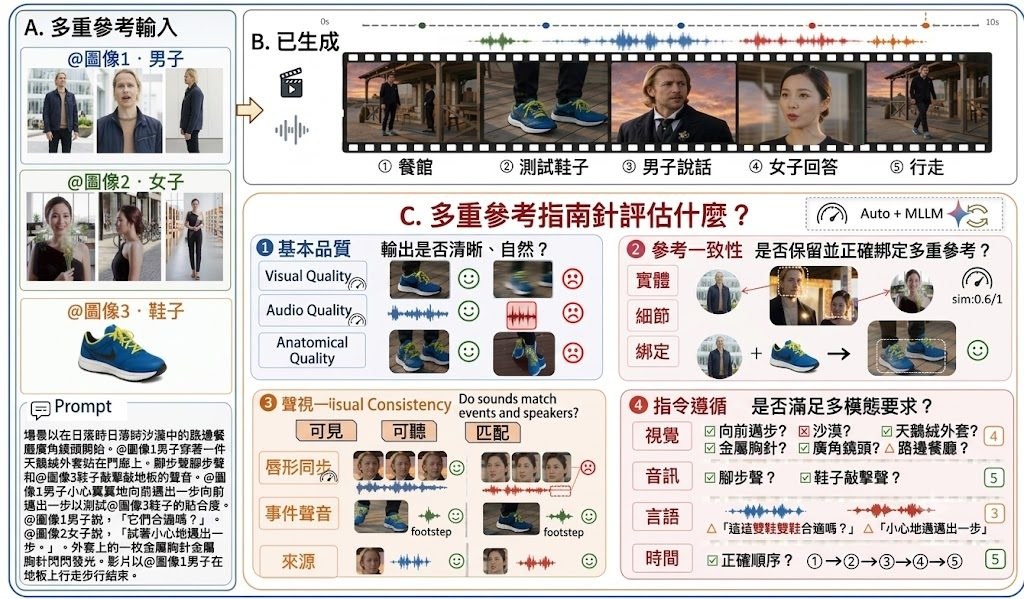
同一段生成影片,畫面可能順眼、聲畫卻唔對位;角色外觀接近參考圖,指令跟從又未必準。MultiRef-Compass 抓住呢種常見落差,定位成一個開源評測工具包,處理 multi-reference multimodal video generation 的比較問題,重點唔係逐條片人手睇,而係用可重現的方法把不同模型放到同一把尺上量度。

它的取向相當明確:偏向研究比較,而唔係臨時檢查作品。項目用固定的 CSV 輸入欄位,接收文字、視覺參考、音訊參考同生成影片,再輸出 per_sample.csvmodel_summary.csvranking.mddetails.json。這種設計的好處,是團隊可以用同一批樣本反覆測不同模型;代價是流程較講究資料整理,較適合已有實驗管線的人。

跟只看單一分數的做法相比,MultiRef-Compass 把結果拆成四組共 14 個公開指標,包括 Basic Quality、Entity Fidelity、Audio-Video Consistency 同 Instruction Following。它同時混合 classical media-analysis pipelines、learned quality models、speaker embeddings,以及 multimodal language model judges,所以看到的不只是整體高低,仲會知道問題出在 anatomy、reference fidelity、voice timbre similarity,定係 temporal order。

  • 用統一 schema 比較不同影片生成模型,較容易做橫向排名
  • 保留 sample-level diagnosis,同時支援 model-level ranking
  • 支援 text、visual-reference、audio-reference 三種條件一齊評測
  • 著重公開 metric taxonomy,同類研究較易重現結果

現有資訊未見到完整安裝細節,但理解方式已很清楚:先準備符合欄位要求的 CSV manifest,再按指標群組跑評測後端。受益最大的,會是做多模態影片生成、聲畫對齊、角色一致性與指令跟從研究的團隊。相關能力圍繞 Visual Quality、Audio Quality、Entity Fidelity、Speech-Lip Synchronization、Voice Timbre Similarity 等指標展開;它未必幫你直接提升模型質素,卻能先把模型到底差在哪一環講清楚。

GitHub · 模型

Categories: 開源, Embedding, 多模態模型, 視頻模型, Video, Audio, 語音

Self-in-Space 補上無人機空間理解盲點

無人機睇得見環境,未必真正理解自己點樣移動。Self-in-Space把評測、數據同模型放埋一齊,專門拆解呢個落差。

Teaser

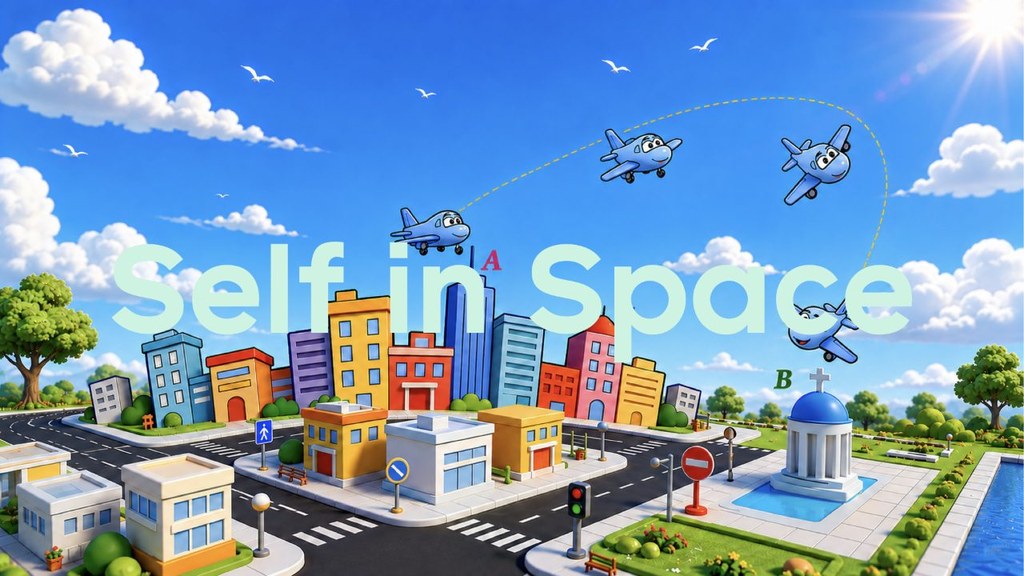
講無人機視覺理解,很多方法集中在環境辨識或任務完成,但較少正面處理飛行器本身的狀態感知。Self-in-Space屬於研究型基準測試、訓練數據集與模型組合項目,核心是把 UAV 的 spatial cognition 與 self-awareness 分開檢查,看看模型是否不只「見到空間」,亦知道自己在場景中如何移動。

作者明確批評現有 UAV-oriented MLLMs 普遍偏向 environment-centered、task-oriented 範式:重視周圍有什麼,較少處理自身運動如何影響理解。為此,他們提出 SIS-Bench、SIS-Motion-54K 與 SIS-Motion,重新把 aerial understanding 拆成 perception、memory、reasoning 三層,再同時覆蓋空間與自我兩條軸線,令問題定義比一般影片問答 benchmark 更貼近 embodied UAV 場景。

SIS-Bench 包含 1,646 段真實 UAV 影片與 4,856 組 QA,覆蓋 13 個任務;團隊用它測試 26 個 video MLLMs,包括 6 個 proprietary models 與 20 個 open-source models。結果指出兩個穩定現象:模型對 self 的建模弱過 space,而且能力會由 perception 走到 memory、再到 reasoning 時逐步下跌,這個診斷比單看整體分數更有參考價值。

  • 結合 benchmark、training dataset 與 motion-aware model,不是單一模型發佈
  • 直接針對 UAV embodied intelligence 的 self-awareness 缺口
  • 評測設計有清楚分層,方便看出模型在哪一段開始失準
  • SIS-Motion 嘗試用 motion-aware representation 改善 aerial video understanding
  • 已公開 SIS-Bench 與 SIS-Motion-54K,可在 Hugging Face 或 ModelScope 了解內容

這項目的受眾很清楚:做 UAV 視覺、aerial video understanding、embodied AI、video MLLMs 評測的人,都會較容易用得着。現階段它更像研究與比較基礎設施,而不是即裝即用產品;想部署測試,較合理做法是先從 SIS-Bench 驗證現有模型在 self-awareness 與 spatial reasoning 的表現,再看 SIS-Motion 是否能為下游 UAV navigation tasks 帶來可轉移的增益。相關模型與資源以 SIS-Motion、SIS-Bench、SIS-Motion-54K 為主,並且對照了多個 video MLLMs 的表現。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 字節跳動, 多模態模型, 模型訓練, Qwen, Gemini, Video, Dataset 數據集

GigaWorld-Policy-0.5 推向機械人即時反應

機械人要邊看邊動,卡位往往不在「會不會做」,而在「能不能夠即時做」。GigaWorld-Policy-0.5嘗試用更輕量的推理路徑,保留世界模型訓練收益,同時壓低本地延遲。

機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。

它延續 action-centered 的路線,再加入 Mixture-of-Transformers 架構,將視覺建模與動作生成分成不同 expert。咁樣做的取捨很清楚:訓練期間仍然利用未來場景演化強化動作學習,推理時則走較輕的 action-only pathway,提升即時控制效率。資料提到,它在本地 RTX 4090 上可做到 85ms inference latency,目標就是支援更接近即時的部署。

另一個值得留意的位置,是它不只改模型結構,亦加入 agent-based AutoResearch pipeline 來搜尋訓練配置。這種做法主要是減少手動調 hyperparameter 的時間,讓實驗設定更有系統地被篩選。對做 Robotic、世界模型或策略學習的人來說,這比單純追求更高指標更實用,因為整個訓練流程的效率同樣影響迭代速度。

  • 保留 future visual dynamics 的訓練收益,但推理時只輸出動作
  • 用 Mixture-of-Transformers 分開 visual expert 與 action expert,降低活躍計算量
  • 以 mixed Action-Conditioned World Modeling(AC-WM)和 WAM 訓練,加強視覺與動作的耦合
  • 引入 agent-based AutoResearch pipeline,提升訓練配置搜尋效率
  • 已公開論文、程式碼與模型,方便研究用途跟進

整體來看,GigaWorld-Policy-0.5處理的是世界模型常見的速度與控制落地矛盾:訓練想要看得多、學得深,部署又要夠快。現有資料顯示,它把重心放在更有效率的 action-centered WAM 路線,適合關注即時機械人控制、閉環部署與本地推理表現的人。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, Video, Robotic, 框架, 編程

[技術文章] Xiaomi-Robotics-U0 小米用世界模型打通機械人

同一個模型兼顧場景生成、影像編輯同機械人操作資料合成,重點唔只係畫面靚,而係多視角一致同可直接餵去訓練策略。

smileybones small

當世界模型式的影像與影片生成能力要落到機械人場景,難題唔止係出圖或出片,而係同一個場景喺多個視角下都要合理,物件幾何要一致,仲要符合唔同 robot embodiment 嘅操作限制。

Xiaomi-Robotics-U0 屬於 world foundation model 路線,針對的正是這類 embodied synthesis 工作:一邊保留大型 image and video generation model 已學到的視覺知識,一邊補上機械人資料需要的可控性與一致性。

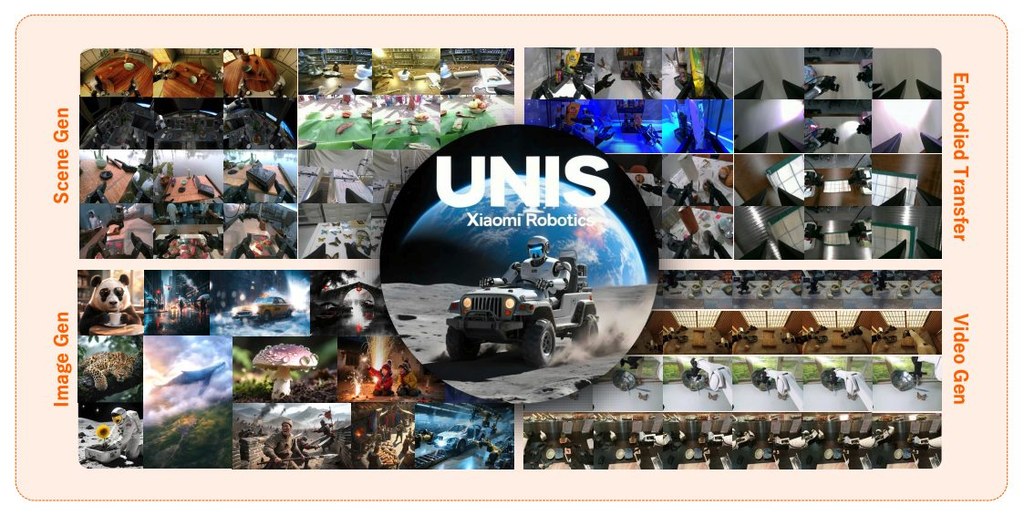
常見做法通常係用有限的機械人資料去微調 foundation model,但作者認為呢種範式容易犧牲大規模預訓練帶來的泛化能力。Xiaomi-Robotics-U0 改用 unified embodied synthesis 設計,把 text-to-image generation、image editing、embodied scene generation、embodied transfer 同 embodied video generation 放入同一個 38-billion-parameter multimodal autoregressive model 聯合優化,將 embodied generation 視為 foundation image and video generation 的延伸,而唔係另一條割裂的任務線。

呢個項目最有用的地方,在於它不只生成好看的資料,而是生成可拿來支援機械人學習的資料。文中提到它首次支援跨多種 robot embodiments 的高品質 multi-view scene generation,亦加入 structured、controllable embodied transfer,做細緻編輯時仍可保留 multi-view consistency 同 interaction dynamics,對要做模擬資料擴增、場景改寫、操作軌跡配套生成的工作流幫助較大。

  • 聯合處理多種任務,減少每個場景各自做模型適配的割裂流程
  • 核心差異在於保住 pre-trained world foundation model 的泛化,同時加入 embodied constraints
  • 支援 multi-view scene generation 與 embodied transfer,重點放在幾何一致性與互動連貫性
  • 生成結果可作為 scalable data engine,服務後續 policy training

效能上,Xiaomi-Robotics-U0 在 single-step 與 sequential generation 任務都做到 state-of-the-art,human evaluations 中於 embodied scene generation 同 transfer 超過 GPT-Image-2.0,embodied video generation 在 World Arena 排名第一。更實際的指標來自真實操作任務:它把 π 0.5 \pi_{0.5} 在 out-of-distribution 情況下的 success rate 由 36.9% 提升到 63.2%,說明這類 world model 不只是內容生成工具,亦開始成為 embodied intelligence 的資料引擎。

文中亦提到完整流程涵蓋 dataset curation、unified annotation pipeline、single-step training、sequential training,以及配合 FlashAR 與 vLLM Integration 的 inference 設計。整體訊息很清楚:作者想證明 foundation world models 可以同時扮演 embodied world models 與合成資料基建,讓機械人訓練不再只依賴昂貴而稀缺的真人示範。

Paper

Categories: 模型, 多模態模型, 視頻模型, 世界模型, 模型訓練, Video, Image, 影像模型, txt2img, Robotic, 軟件, Dataset 數據集, 小米-Xiaomi

Motion4Motion:免訓練跨物種動作轉移

想將人的動作套到熊貓、鵝,甚至家具身上,Motion4Motion 提供一種毋須骨架與額外訓練的做法。它把重點放在畫面中的運動流,而唔係角色骨骼。

Og image

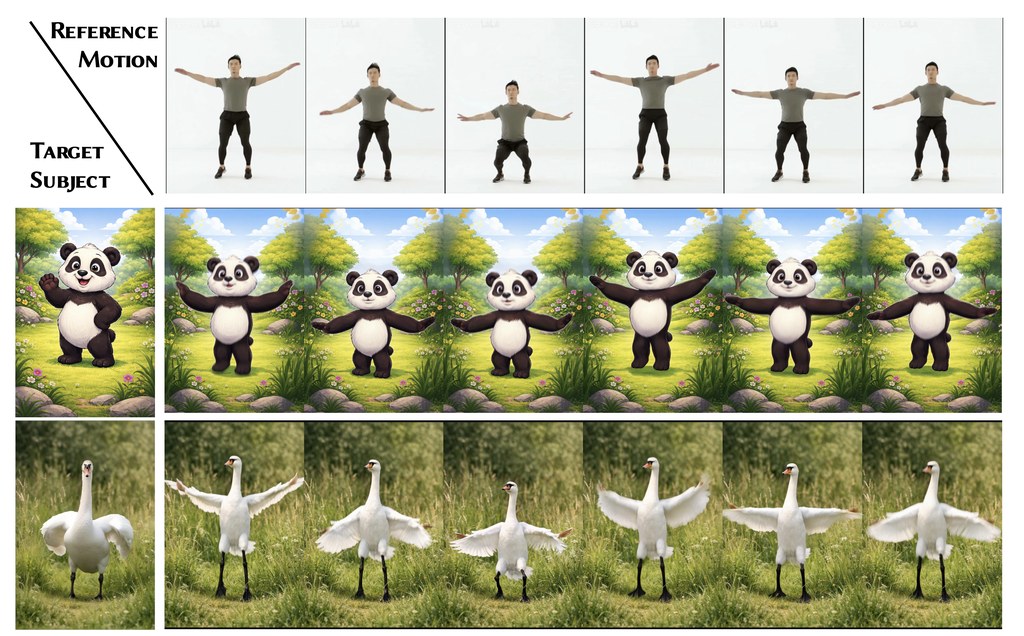
當角色外形差很遠,傳統動作轉移最易卡在骨架對唔上:人、鵝、熊貓根本冇共同骨骼模板,結果常見問題包括動作僵硬、身份漂移,或者腳步滑動。Motion4Motion 屬於影像生成/視頻模型方向的研究,直接避開骨架表示,改為從來源影片抽取密集 motion flow,再把動作帶到另一個目標主體身上。

呢個項目的可取之處,在於 training-free。它唔需要為跨物種或跨拓撲角色另行訓練模型,而係建基於凍結的 Diffusion Transformer(WAN-T2V)做兩階段推理:先找出來源影片主體的運動軌跡,再用 TransPE(Transferring Positional Encoding)把重定向後的位置信息注入注意力過程,令目標外觀跟住動起來。

重點可以整理成幾項:
– 毋須 skeleton,較易處理 human → panda、human → goose 呢類外形差異大嘅轉移
– 毋須額外訓練,推理時完成動作遷移,部署門檻較低
– 用 pixel-level motion flow 取代骨架驅動,減少骨架對齊失效帶來的限制
– 建基於預訓練視頻 diffusion transformer,保留生成式模型對外觀細節的表達能力

它會先用 Grounded SAM-2 在來源首幀取樣主體錨點,再靠 diffusion features 建立來源與目標之間的對應,並以 point tracker 追蹤時間上的軌跡。之後在去噪階段重用目標主體的 K/V,配合來自重定向 motion flow 的 RoPE 位置編碼,令 self-attention 按新動作重組畫面。

現有資料指出,Motion4Motion 在多組實驗與應用展示中勝過強基線,亦示範到跨物種轉移,甚至可出現「教枱行路」呢類非典型案例。適合留意角色動畫、視頻生成、動作重定向工作流嘅讀者;不過目前簡介主要集中在研究展示,具體穩定性與邊界情況仍要等更完整實驗細節支持。

項目主頁

Categories: 香港科技大學, 清華大學, 模型訓練, Video, 框架, 教學

PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

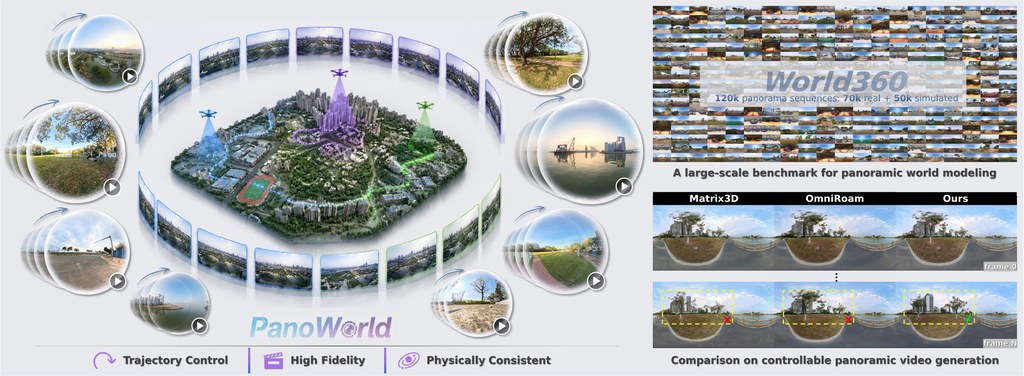
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC)Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。
項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

Page 13 of 21
1 11 12 13 14 15 21