DuET 鋼琴演奏轉譜新模型:音符與幀並行編碼

DuET 把鋼琴演奏 MIDI 轉成結構化樂譜,靠音符與幀雙編碼加上節拍監督,音訊輸入可經 Transkun v2 串接。

DuET architecture

鋼琴演奏轉譜(Performance-to-Score Transcription)一直有個難題:演奏帶有彈性速度、踏板與力度,傳統音訊轉譜方案往往把節奏「拉直」,忽略了 rubato 與呼吸。DuET 採用 Note–Frame 雙編碼結構,音符分支處理離散音高與時值,幀分支處理節奏細節,雙方透過雙向交叉注意力交換資訊,譯碼器輪流從兩個表示預測譜面屬性,目標是兼顧音高準確度與演奏的時序彈性。

節拍與強拍(beat 與 downbeat)做聯合監督,模型在學習譜面結構的同時也理解小節脈絡,這對 rubato 段落特別有幫助。位置編碼方面用上 TimeRoPE(相對演奏時間)與 TPRoPE(音程關係),讓模型對時間偏移與音高距離有更好的歸納能力。輸出涵蓋 MusicXML、聆聽用 MIDI 與結構化音符預測,方便樂譜軟體直接開檔。

輸入端支援 MIDI 直入;若要吃音訊,需要加裝音訊前端,流程是 Transkun v2 先把鋼琴錄音轉成 MIDI,再交給 DuET 處理。預訓練權重放在 Hugging Face(Wayne42/DuET),模型約 0.1B 參數,授權為 CC BY-NC 4.0,學術與非商業用途可直接取用。

對音樂技術研究者、數位音樂學(Digital Musicology)團隊、開發自動評分或伴奏系統的人來說,這類保留演奏細節的轉譜工具比純音訊轉譜更貼近真實場景;鋼琴老師想把學生錄音整理成樂譜、作曲人要做編曲分析,也都能直接受惠。Demo 已上架 Hugging Face Spaces,可先試效果再決定是否部署。

重點摘要:

  • 雙編碼設計:Note encoder 與 Frame encoder 經雙向交叉注意力融合,兼顧音準與節奏彈性
  • 節拍聯合監督:beat 與 downbeat 同時學習,有助處理 rubato
  • TimeRoPE + TPRoPE:相對時間與音程關係的位置編碼
  • 輸出齊全:MusicXML、聆聽 MIDI 與結構化音符預測,主流樂譜軟體可開
  • 權重與 Demo:Hugging Face 提供 Wayne42/DuET 權重與 Spaces Demo,CC BY-NC 4.0 授權
GitHub · 模型

Categories: 開源, 模型, 模型訓練, Audio, 工具, 音樂

yomado:給 Agent一個虛擬螢幕

yomado 讓 Agent 在虛擬螢幕操作 Blender、Marvelous Designer 等桌面程式,毋須為每款應用另接 MCP。實體屏幕可以保留給自己的工作。

yomado night-window icon

需要代理透過截圖、滑鼠和鍵盤操作 Blender 或 Marvelous Designer 時,桌面程式仍要有圖形桌面和顯示畫面。yomado 是一款 Mac 虛擬顯示器工具,讓代理使用獨立工作屏幕,毋須為每款應用另接 MCP;代理負責觀察和操作,yomado 則提供顯示空間。

它會按桌面排列顯示實體與虛擬屏幕,並在屏幕示意圖中標出應用程式。你可以拖曳圖示移動視窗,也可以手動移動;功能表按顯示器分組,並支援個別關閉視窗。隨附的 yomado skill 可引導 Codex 建立工作屏幕、移入指定視窗、確認畫面可見,並在任務完成後移回視窗。

  • 可為不同代理建立各自的虛擬屏幕,將工作視窗分開管理。
  • 可從 Finder 將正在執行的 .app 拖入,移動該應用的一般視窗。
  • 虛擬屏幕存在期間,程式會要求系統和圖形桌面保持喚醒。
  • 目前版本為實驗版,使用 macOS 14 或以上的 Apple Silicon Mac,並使用 macOS 私有 API。

這做法補足顯示空間,而非代理本身的視覺理解或操作能力;截圖、判斷和輸入仍由 Codex 或其他代理工具處理。對需要代理操作可視化介面、又想讓自己的實體屏幕保持原有工作的 Mac 使用者,分屏管理有實用價值。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, Google, API, Video, 工具, Mac, 蘋果, Skill 技能

WorldCast 預測並生成世界狀態

WorldCast 把視覺生成拉到多步推演:模型要交代世界如何逐步變化,而不只是交出一張合理終局圖。

(a) The four-level capability tree of visual generation. (b) The WorldCast benchmark and overall results.

當任務要求模型根據觀察、物件參照和操作示範,預測一個過程接下來會怎樣發展,單張圖片的合理性已經不夠。WorldCast 屬於視覺生成基準測試,實際處理的是多模態模型如何理解不同參照在何時生效,並生成一連串有因果關係的世界狀態。

它把能力分成 L1 至 L4:由靜態 text-to-image,推進至編輯、主體參照和 text-to-video,再進入複雜限制、物理合理性及把現實情境轉化為行動。WorldCast 聚焦較少被量度的 L3、L4,涵蓋 320 個人工設計案例、1,352 個視覺狀態及 8 類任務,並同時測試 unified systems、multi-reference image models 和 video models。

• 評分把 grid、interleaved 和 video 輸出視為有次序的狀態序列
• 參照內容可以是觀察狀態、目標、規則、物料特性或示範程序
• 12 個代表性模型接受同一套評估協議及 Judge rubrics
• GPT-Image-2.5 System 取得 72.8 分,反映前沿模型已出現早期世界狀態預測能力

可從 Hugging Face Dataset 取得資料測試,配合項目提供的 evaluation toolkit 和 Evaluation Guide 重現評分;模型亦可輸出逐格圖像、交錯圖像或影片。結果差距會在較高層次任務擴大,interleaved generation 對圖像模型有幫助,但評測仍集中於人工設計案例,未等同於真實環境中的長期規劃能力。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 視頻模型, Video, Image, txt2img, Dataset 數據集

InfoVis 簡報生成與編輯能力整合到 9B 模型

InfoVis 讓同一個模型處理簡報生成、素材參考、模板控制與局部編輯,開源評測已接近 Nano-Banana-2。

overview

製作簡報圖像時,你可以用文字生成整頁投影片,也可以提供風格參考、內容素材或原有投影片作修改。InfoVis 屬於開源影像模型項目,集中處理文字轉投影片、模板條件生成、多圖像內容生成,以及按指令編輯投影片四類工作,減少不同模型之間切換所帶來的流程斷裂。

模型以 FLUX.2-klein-base-9B 為基礎,經過 slide-native continual pretraining、四任務混合 continual pretraining,再進行 task-specific SFT,最後把不同分支合併成單一模型。這種做法換來較完整的任務覆蓋,但同一模型要同時兼顧文字準確度、版面美感、內容對齊和精準編輯,效果仍會受提示內容及輸入素材質素影響。

VisSlideBench 收錄 1,527 個人工篩選案例,分別檢查內容忠實度、指令遵循、美感、語義一致性和簡報質素等指標。InfoVis 整體得分 7.94,略低於專有的 Nano-Banana-2(7.99),但在所有 11 項指標均領先受評開源模型;相較原始 FLUX.2-klein-base-9B,專門訓練帶來 1.6 分整體提升,美感仍是它與專有模型之間較明顯的差距。

項目提供 Hugging Face Space 的線上示範,再按需要下載模型權重、程式碼、InfoVis-Data 和 VisSlideBench 作本地研究或評估。這個項目較適合需要大量製作簡報草稿、產品提案、教學投影片的設計及內容團隊;本地執行 9B 模型則要自行準備相容的圖像生成環境,儲存庫資料未列出統一的硬件要求。

  • 四合一工作流:文字生成、模板控制、多圖像接地生成及指令式編輯由同一模型處理。
  • 專用訓練資料:提供超過 13M continual-pretraining records 及 1.9M SFT records。
  • 可驗證評測:VisSlideBench 同時公開資料集及評估程式碼。
  • 主要取捨:開源模型中表現突出,但整體仍稍低於 Nano-Banana-2,美感差距較大。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Google, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 教學, 庫, 中國, 蘋果, Dataset 數據集

SCOPE 讓文字提示詞按語意學習

文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

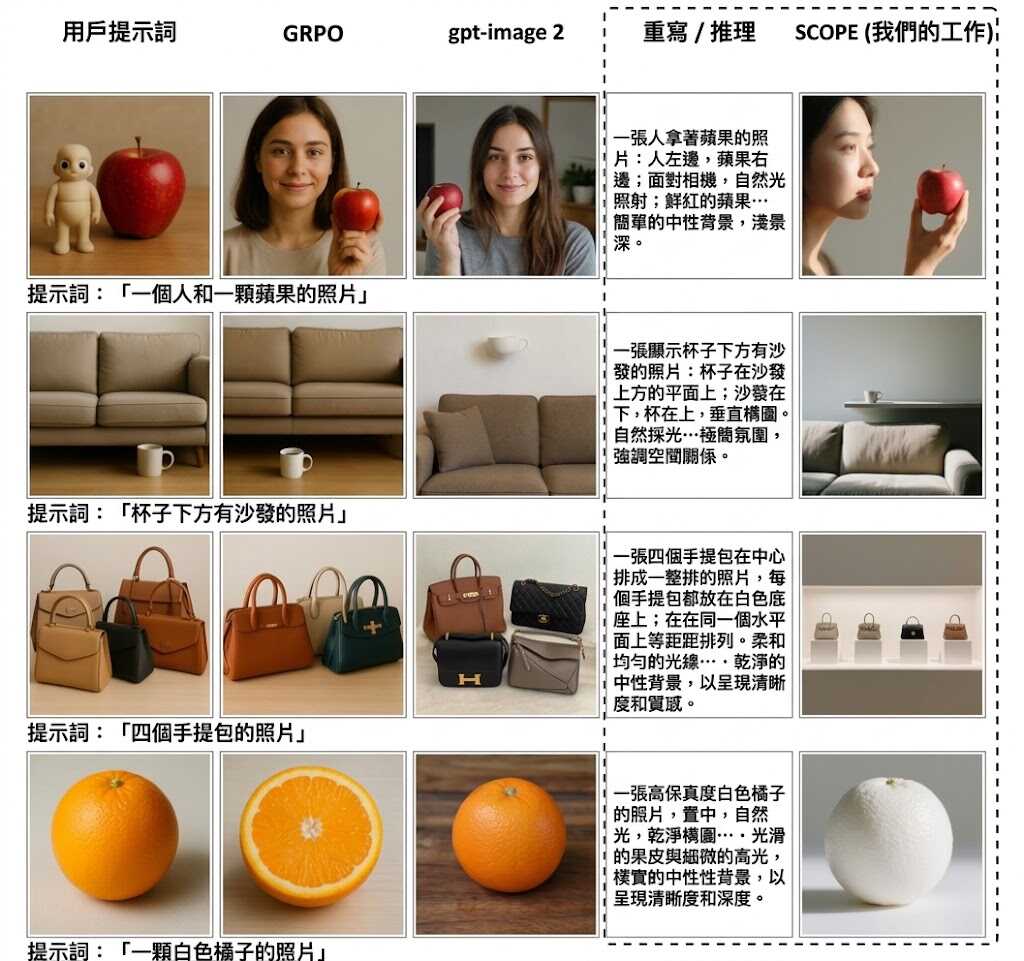
Uniform token GRPO versus SCOPE span credit.

當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。

SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

SimVTA 為自動駕駛補上替代路線的視覺訓練

SimVTA 用模擬器生成不同駕駛路線的未來畫面,讓模型不只學習紀錄中的單一路徑。

From logged futures to candidate-matched supervision

自動駕駛模型需要判斷轉線、直行等替代路線,但行車紀錄通常只保留當時真正採取的路徑,其他選擇缺乏對應影像。SimVTA 屬於 driving world action model 的 post-training framework,處理的正是軌跡規劃與未來視覺監督不匹配的問題。

項目會在以 3D Gaussian Splatting(3DGS)重建的真實場景中,為候選軌跡渲染相配的未來影片,再以 Group Relative Policy Optimization(GRPO)優化軌跡,並加入 flow-matching video loss 更新共享表示。高回報候選之中,系統會優先挑選誤差較大的未來,減少有限渲染資源被低價值樣本消耗。

相較只依賴 logged trajectories 的訓練方式,SimVTA 補上了替代行動的視覺訊號;代價是需要 3D 場景重建與模擬渲染,訓練流程較複雜。推理階段則直接預測軌跡,不需再次呼叫模擬器,較適合納入自動駕駛規劃流程。

  • NAVSIM v1:PDMS 由初始化模型的 86.2 提升至 91.3
  • NAVSIM v2:取得 88.2 EPDMS
  • HUGSIM 閉環測試:平均 HD-Score 為 38.8
  • 消融結果支持共享表示更新及高誤差樣本優先策略

研究團隊包括 OpenDriveLab at HKU、Shanghai Innovation Institute、Li Auto、Tongji University 與 Tsinghua University。這個項目較適合研究自動駕駛、world action model 或模擬訓練的團隊;目前儲存庫仍標示 code 和 checkpoints 尚待發布,因此未能當作即裝即用的工具測試,重現結果仍需等待相關資源。

項目主頁 · GitHub

Categories: 開源, 香港大學, 清華大學, AI productions, 模型, 模型訓練, Video, Image, World-Action Model, 框架, 香港, 工具, 3D, 庫, 自動駕駛

DeltaStreamer 讓串流影片可以回看再作答

影片播放過後仍可追查關鍵細節,DeltaStreamer 以記憶、規劃和視覺回放串起串流理解流程。

DeltaStreamer

影片一路播放,問題卻可能在關鍵畫面消失後才出現;DeltaStreamer 屬於 agentic framework,處理串流影片理解中「記住甚麼、何時回查」的難題。它以 change-aware memory 保存變化,再配合 query-driven planning 和 targeted visual replay,讓系統按問題重新檢查相關片段,而不是只依賴當時留下的文字描述。

對直播問答、影片監察和互動助手而言,這個流程比單純累積長篇摘要更適合處理後來才提出的問題。項目亦提供 AI-Tongdan 作為應用例子,支援持續觀察、上下文問答和彈幕建議;不過它是框架,不是獨立的新基礎模型,所用模型與推理配置仍要按儲存庫內容自行核對。

OVO-Bench 中,DeltaStreamer 的 overall score 為 66.07,Real-Time、Backward 及 Forward 分數分別為 72.23、67.72 和 58.25。它高於列出的全開源 online MLLMs 與 video agents 多個結果,但仍低於 Gemini 3 Flash 的 64.02 嗎? [sic]

項目主頁 · GitHub

Categories: 開源, 字節跳動, Agentic, AI productions, 模型, 多模態模型, Qwen, Video, 框架, 庫

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

ORBIA 測試世界模型當鏡頭回頭後場景是否仍在

影片流暢,不代表場景能保持一致。ORBIA 讓鏡頭離開再折返,檢查世界模型有沒有「忘記」剛生成的內容。

ORBIA overview

鏡頭繞一圈後,同一件物件應該仍在原位。ORBIA 這套互動影片世界模型基準測試,透過探索與重訪場景,檢查生成畫面能否構成一致的 3D 世界,而不只看影片是否漂亮。

測試輸入包括圖片、場景描述及鏡頭軌跡,並以已對齊的彩色與深度影像(Red Green Blue–Depth,RGB-D)及標註物件作參照,比單一整體影像分數更能定位場景改變的位置。

  • 輸入保留(input preservation):原有場景與地標是否保留。
  • 生成內容持續性(generated-content persistence):重訪時,新生成內容是否一致。
  • 3D 自洽性(3D self-consistency):不同視角能否支持同一個 3D 重建。

儲存庫提供評估程式、模型適配器及資料建構流程,供研究團隊接入模型測試。720 個案例涵蓋六種軌跡,包含 22 秒及一分鐘版本;長版本安排三次重訪,能檢查較長時間的場景記憶。

項目已評估 27 個模型,但所提供資料沒有具體排名或分數。它適合補強世界模型的驗證流程,不能單憑測試規模判斷哪個模型更可靠。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, Image, 3D, 庫, Dataset 數據集

[技術文章] TextVerifier 補上中文生成文字的結構缺口

生成中文字,常見會多一劃或少一筆;TextVerifier 專門找出這類 OCR 容易漏掉的錯誤。

Hero image preview

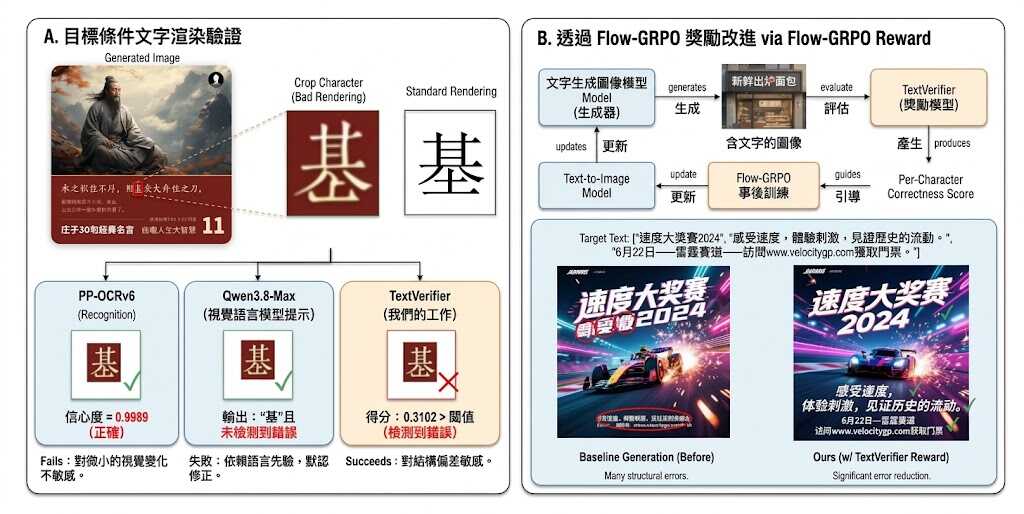
生成圖片中的中文句子看似正確,單一字元卻可能多一劃、少一筆或部件變形,令出版、教育等不能出錯的場景無法採用。TextVerifier 把問題定義為有目標條件的文字渲染驗證:給定指定字元與圖片裁剪區,判斷兩者是否真正一致。

現有做法通常重用 OCR 或一般 vision-language models(VLM)評分。這些模型以辨認內容為目標,會刻意忽略字型、模糊和結構變化;中文錯字往往仍能被讀成原本字元,反而令最關鍵的筆畫及部件錯誤被放過。TextVerifier 改用字元的 Ideographic Description Sequence(IDS)作為文字端輸入,讓模型比較目標字的結構,而不只辨認符號。

訓練資料包括 1,270 萬組 crop–IDS 配對,以及從文字區域 inpainting 模型訓練過程抽取的「同字不同質素」hard pairs。團隊亦建立 TEXTRENDERBENCH-ZH,逐字標註位置、身份與正確性,涵蓋 7,358 個生成中文字元。

• TextVerifier F1 為 0.844,高於 OCR confidence 的 0.526、一般 VLM 的 0.329 及 TextPecker 的 0.590。
• 驗證單位由整段文字下沉至單一字元,能捕捉局部筆畫與部件錯誤。
• 分數可用作 Flow-GRPO post-training 的 per-character reward,協助生成模型減少渲染錯誤。
• 適合需要逐字校驗的海報、教材、出版物及其他中文圖像生成工作流。

結果顯示,文字辨認和文字正確性驗證並不是同一項能力。TextVerifier 目前聚焦中文字符結構,對需要零錯誤輸出的場景更有針對性,但其成效仍取決於生成模型、字體風格及圖片品質。

Paper

Categories: 北京大學, 阿里巴巴, Image, 中國, Dataset 數據集

Page 7 of 55
1 … 5 6 7 8 9 … 55