TextRIRO:修改文字內容並保留原始風格

讓圖片中的文字換內容、留風格,但處理範圍限於裁切文字區域,項目暫時只是作為研究,因此生成解像度亦有限制。我仍為這研究有助 Diffusion Model 發展更多的應用

TextRIRO training, inference, STR-pretrained text encoder, and TextRIRO-3M construction pipeline

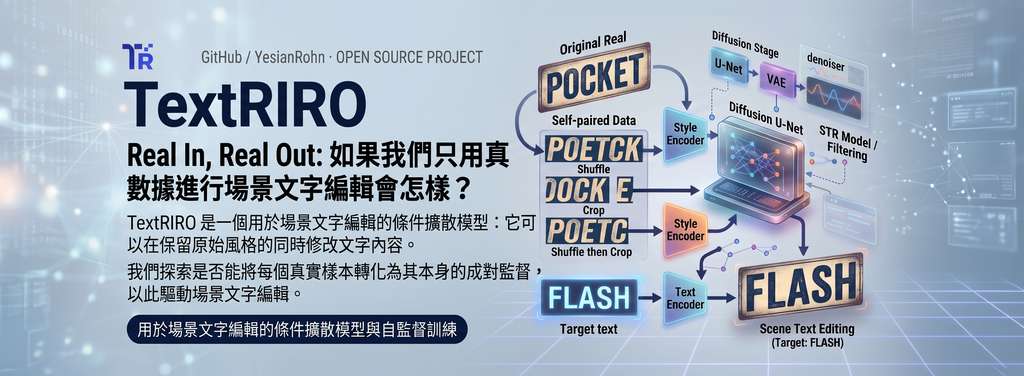
招牌或包裝上的字換了,仍希望保留原有外觀;TextRIRO 以條件擴散模型處理場景文字編輯(Scene Text Editing,STE),輸入裁切文字圖及替換內容,輸出改字後的圖像。

它以 Shuffle&Crop 打亂真實影像的文字語意,同時保留風格線索,讓每張圖形成自身的配對監督,毋須合成編輯前後配對或字元分割。多尺度風格編碼器配合以場景文字辨識(Scene Text Recognition,STR)預訓練的文字編碼器,分別提供外觀與字元條件。

「Real-only」只涵蓋編輯監督及文字編碼器預訓練。生成骨幹仍採用 Stable Diffusion(SD)1.5 的 U-Net 與 scheduler,以及 SD 2.1 的變分自編碼器(Variational Autoencoder,VAE)。

  • 可透過 Hugging Face Demo 試改文字。
  • 本地推理需 CUDA、模型權重及相關組件;儲存庫列出 Python 3.8/PyTorch 1.13 環境。
  • 生成解像度為 64 × 256,再還原來源尺寸,細節仍受限制。
  • RIROCommon 測試等長及變長改字;所附資訊未提供分數,不能判斷領先幅度。

文字辨識研究團隊亦可利用 TextRIRO-3M 的三百萬張長文字影像。這批資料由篩選後的編輯圖與原圖拼接而成,屬合成資料;完整照片改字流程,仍需另行處理文字區域裁切及回貼。

GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Stable Diffusion, Image, Python, 庫, Dataset 數據集

Spectral-Spatial-Interpretation(SSI ) 讓多光譜模型看清每個通道的作用

多光譜模型不只要知道哪個位置重要,還要分辨該位置由哪些通道推高或拉低分數。SSI 以 Shapley values 提供更細緻的解釋。

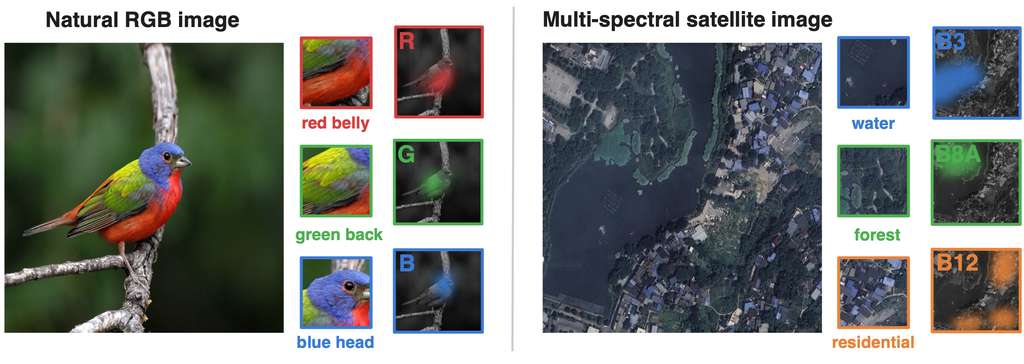
Figure 1: spatially varying channel relevance in RGB and multispectral images

面對多光譜影像,單一熱圖往往只說明哪裏重要,卻未能交代該位置的光譜通道如何影響結果。SSI(Spectral-Spatial Interpretation)屬於模型解釋工具,為每個空間 cell 和 channel 計算帶正負號的 attribution,拆解模型分數由哪個位置及哪個通道推動。

SSI 固定該 cell 以外的影像內容,只在 cell 內比較不同通道組合,再以 Shapley values 分配貢獻。所有通道貢獻會加總至該 cell 從遮罩狀態到原始狀態的分數變化,因此可分別彙整成 spatial map 或 spectral summary;正值代表推高分數,負值代表拉低分數。

項目提供獨立 NumPy 實作,支援 exact subset enumeration 和 sampled channel permutations,亦附有瀏覽器 Playground、Visual Atlas 及五分鐘互動教學。測試時可先用 Playground 觀察結果,再以 ssi.py 對自己的模型分數和遮罩 baseline 重現分析;通道數增加時,精確枚舉的成本亦會上升,抽樣排列是較可行的取捨。

與 Integrated Gradients (IG)、DeepSHAP、KernelSHAP 及 rank-1 RISE 比較,SSI 在三個資料集、兩種 masking baseline 下,三項指標的平均結果均居首;例如 mean-baseline HLS joint deletion 為 0.1545,KernelSHAP 為 0.2096。它較適合需要同時追蹤空間位置與光譜通道的遙感、農業或科學影像團隊,但要留意各 cell 的貢獻不一定能加總成整張影像相對 baseline 的總變化,因為 SSI 解釋的是條件式局部遊戲。

  • 同時回答「哪裏重要」與「哪個通道重要」
  • 保留正負貢獻,能分辨推高或壓低分數的因素
  • 支援精確計算及排列抽樣兩種方式
  • 可用 spatial map、spectral summary 和 deletion 指標檢查結果
  • 適合多光譜模型,但需留意計算成本及跨 cell 互動限制

項目主頁 · GitHub

Categories: 開源, 模型, Image, 影像處理, 教學, 工具

MOSS Image Edit:一句指令改圖兼支援四圖參考

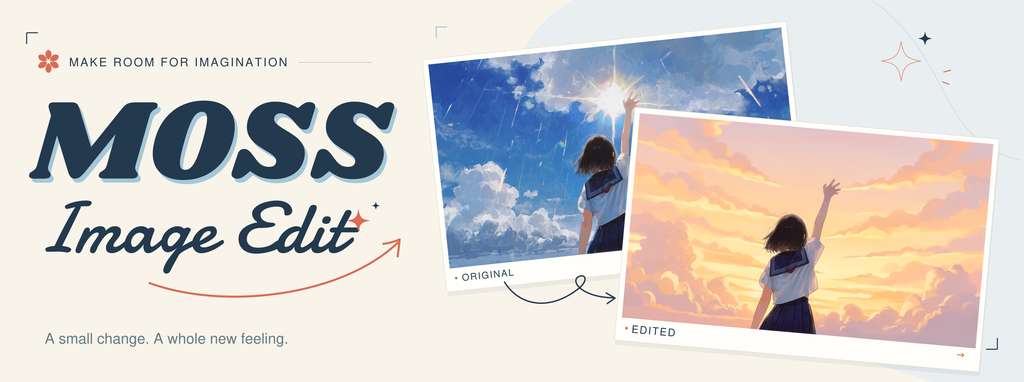
把人物改成指定穿搭、表情或場景,MOSS Image Edit 透過 LoRA 串連文字與參考圖,並在 ComfyUI 重用參考資訊。

MOSS Image Edit — 用文字编辑图像

要替相片換衫、改正面表情,或將人物移到另一個場景,不一定要由人手逐項遮罩修改。MOSS Image Edit 是一個面向 MOSS-Image 的圖像編輯 LoRA,接收原圖、自然語言指令及最多四張參考圖,負責把服飾、顏色、光照、季節和畫風等要求轉成編輯結果。

發布內容只有 LoRA 權重及配置,必須配搭 MOSS-Image-Base 或 MOSS-Image-SFT,兩者擇一即可。團隊另備獨立 ComfyUI 節點與單圖、多圖工作流;下載底模和 LoRA、按指南擺放模型,再把工作流拖入 ComfyUI 即可測試,亦可調整輸出尺寸、隨機種子和採樣參數。

多圖模式不是單純追加條件:參考圖之間可互相參照,文字與目標圖則可讀取全部資訊,並要在指令內交代每張圖的用途。適合合併人物、服飾及場景參考,但最多四張圖的限制,也意味著複雜構圖仍需反覆測試提示詞與配置。

架構以 text、ref、target 三類 token 組成共享 MOSS Transformer;參考圖固定在無噪聲時間,文字及目標圖則隨去噪時間變化。參考分支只計算一次並快取各層 K/V,之後逐步重用,CFG 的正、負條件亦可共用同一份快取,減少重複運算。

  • 支援單圖指令式編輯
  • 最多連接四張參考圖
  • 可配搭 Base 或 SFT 底模
  • 提供 ComfyUI 單圖及多圖工作流
  • 沒有公開量化評測或推論供應商整合資料

內容團隊、做商品視覺或社交媒體配圖的人,會較容易感受到其價值。它目前更像是 MOSS-Image 生態中的可調編輯模組,而非一開即用的獨立模型;正式採用前仍應以自身相片、指令及輸出尺寸測試一致性、資源需求與授權條件。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, Image, 影像處理, 提示詞, LoRA

RubatoCodec:深入神經音訊編碼 – 殘差向量量化(RVQ)與高保真重構架構

固定長度切分未必適合語音的每個片段;RubatoCodec 按訊號變化分配事件,並可逐段解碼,面向低位元率語音處理與串流生成。
RubatoCodec architecture

語音片段的資訊密度各有不同,若一律按固定長度切分,便難以按內容分配編碼資源。RubatoCodec 是神經語音編碼器,會把語音轉成帶有離散碼索引和持續時間的可變長事件,並支援逐段重建波形,適合需要控制碼率或串流輸出的語音系統。

它在 50 Hz 潛在表示上,參考多尺度潛在特徵差異和波形頻譜通量,累積分配事件;預設目標比例為 0.25,整段語音的事件數則按公式精確控制。這種做法毋須另設邊界預測器、邊界標籤或 rate loss,但仍需把事件持續時間一併納入編碼,不能只看碼索引的位元率。
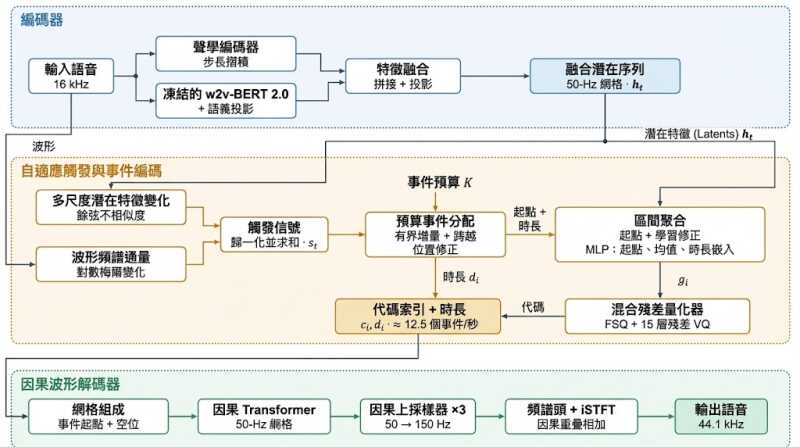
量化器採用 16 層混合式殘差結構:首層是接受語義監督的 FSQ,其後 15 層使用 DAC-style residual VQ。解碼時可選用 1 至 16 層的任意前綴深度,名義碼索引位元率約為 150 至 2,400 bit/s,另加持續時間資訊;模型以約每秒 12.5 個事件表示語音,輸入為 16 kHz,因果串流解碼器輸出 44.1 kHz。

每個事件代表約 80 毫秒音訊,在 H200 上解碼約需 11 毫秒,具備逐事件或分批解碼的條件。這是硬件與模型設定下的速度數據,不能直接當成其他設備上的延遲保證;現有資訊亦未提供足以比較音質取捨的具體評測結果。

研究人員、語音模型開發團隊,以及需要低碼率儲存或即時音訊處理的系統,可用公開模型和 Python API 載入語音、編碼,再按指定深度解碼。重點包括:
– 事件長度按語音訊號變化調整,整段事件數受目標比例控制。
– 支援逐事件或分批串流解碼。
– 可選不同量化器深度,在碼率與表示容量之間調整。
– 編碼資訊除離散碼索引外,亦包括事件持續時間。
– H200 上每事件約需 11 毫秒解碼,其他硬件表現未有提供。

基本使用範例(推論與重構流程)

專案通常遵循標準 PyTorch 神經編解碼介面,基本 Python 處理流程如下:

import torch
import torchaudio
from rubatocodec import RubatoCodec

# 1. 載入模型與權重
device = "cuda" if torch.cuda.is_available() else "cpu"
model = RubatoCodec.from_pretrained("third-intelligence/RubatoCodec").to(device)
model.eval()

# 2. 讀取並預處理音訊(重取樣至模型支援之採樣率)
waveform, sample_rate = torchaudio.load("input.wav")
if sample_rate != model.sample_rate:
    resampler = torchaudio.transforms.Resample(sample_rate, model.sample_rate)
    waveform = resampler(waveform)

waveform = waveform.unsqueeze(0).to(device)  # [Batch, Channels, Time]

# 3. 編碼:提取離散 Tokens (RVQ Codes)
with torch.no_grad():
    # tokens 形狀通常為 [Batch, Num_Quantizers, Frames]
    tokens = model.encode(waveform)

# 4. 解碼:由離散 Tokens 還原音訊波形
with torch.no_grad():
    reconstructed_waveform = model.decode(tokens)

# 5. 儲存重構音訊
torchaudio.save("reconstructed.wav", reconstructed_waveform.squeeze(0).cpu(), model.sample_rate)

GitHub · 模型
Categories: 開源, 模型, NVIDIA, API, Audio, Python, 語音, Dataset 數據集

PawCT:分拆四聲部合唱

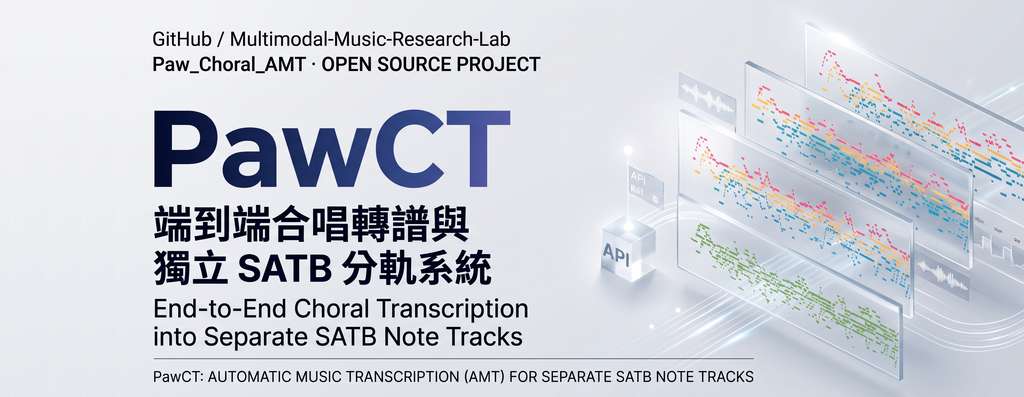
把合唱錄音轉成可分辨女高音、女低音、男高音與男低音的 MIDI 音符,有助排練和樂譜重建。PawCT 直接輸出四部聲線,並以 YouChorale 測試其分部能力。

Ground truth, PawCT, PagCT, and PagCT plus Post-VA piano rolls

要從整隊合唱錄音還原各聲部,難處不只是聽出音符,還要判斷每個音符屬於哪一部。PawCT 是一套合唱自動音樂轉錄(Automatic Music Transcription,AMT)研究模型,會把混合錄音轉成女高音、女低音、男高音與男低音(SATB)的獨立音符軌,適合用於排練準備、音樂教育和樂譜重建。

PawCT 亦提供 PagCT,先轉錄不分聲部的合併音符軌;另一個基線 Post-VA 則在第二階段,按符號音樂資料為音符分配聲部。PawCT 把聲部辨識納入端到端轉錄,並以共享編碼器配合 SATB 專屬的起音、延音結束及音框輸出頭;音域先驗(RP)和有序連續性先驗(OC)則在訓練損失中限制不合理音域與旋律走向,推理時毋須額外模組。

YouChorale 的 PagCT 的單軌音符 F1 為 0.382,高於 Yu et al. (2024) 的 0.237;SATB 平均音符 F1 則由 PagCT 加 Post-VA 的 0.175,升至 PawCT 加 RP 與 OC 的 0.225。

  • 想取得單一音符軌,可測試 PagCT;需要分開四部聲線,則應看 PawCT 的輸出。
  • 模型、訓練、評估、視覺化及釋出檢查程式碼均已納入儲存庫,另有線上示範與程式碼導覽可供參考。
  • YouChorale 的音訊、標註、MIDI 檔案及生成預測並未一併公開,因此仍有待完整重現。

對音樂研究者、合唱團排練者及開發音樂教育工具的團隊而言,PawCT 提供了直接檢視分部轉錄的研究起點;若只需合併音符,PagCT 的定位較簡單。現有公開內容較適合檢查方法與程式流程,重現比較實驗前則要先核對資料、評估協定和歷史設定是否齊備。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Audio, 工具, 庫, 語音, 音樂, Dataset 數據集

JCA 讓文字生成可重播的 3D 動作與影片

文字提示不只生成畫面,JCA 亦同步產生可重播的 3D 動作,並支援場景及關鍵影格控制。

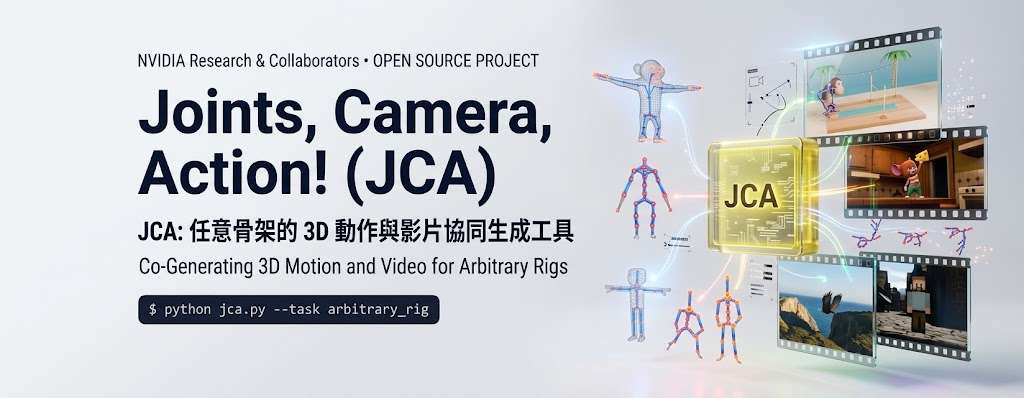
Paper overview: rigs and scene images, keyframes, video, or rig motion enter JCA to produce scene-aware animation, keyframe-controlled motion, recovered rig motion, or video.

文字生成影片時,動作通常只留在畫面裏,難以直接套用到指定的 3D 角色,或放回原有場景。NVIDIA Research 的 Joints, Camera, Action!(JCA)同步生成影片、3D 骨架動作與鏡頭資訊,讓動作可以重播,並對應到 3D 場景。

JCA 支援不同骨架結構,不限於人形角色。輸入圖片可令動作回應周邊環境,加入少量關鍵影格則可控制動作軌跡;模型亦支援由影片還原骨架動作,或由骨架動作生成影片,適合 3D 資產動畫、場景化影片製作和動作擷取。

  • 文字提示可生成同步的影片與 3D 動作。
  • 輸入圖片和關鍵影格可提供場景及動作控制。
  • 支援不同骨架結構,並可進行影片與動作之間的轉換。

模型以圖編碼器描述骨架,並讓獨立的動作模型與預訓練影片生成器透過少量 cross-attention layers 交換資訊。動作模型可先利用較易取得和擴增的純動作資料學習;它亦會定位影片中的關節,以推算鏡頭位置,協助把 3D 動作放回場景。

訓練資料接近 20 萬組配對,涵蓋人類與機械人影片,以及經整理、確保動作有效的 3D 資產場景影片。研究團隊表示,評估中 JCA 比以影片生成為先的流程更貼合文字描述,動作也能回應場景;原文沒有列出量化指標,效果幅度仍難以比較。

項目主頁

Categories: AI productions, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Image, World-Action Model, 教學, 3D, 動畫

DeepSeek Harness(DSH) 的「可視化插件市場」

把外掛搜尋、相容性核對和整理放進 DeepSeek Harness,並讓同一目錄接入 Discover。

dsh-market logo

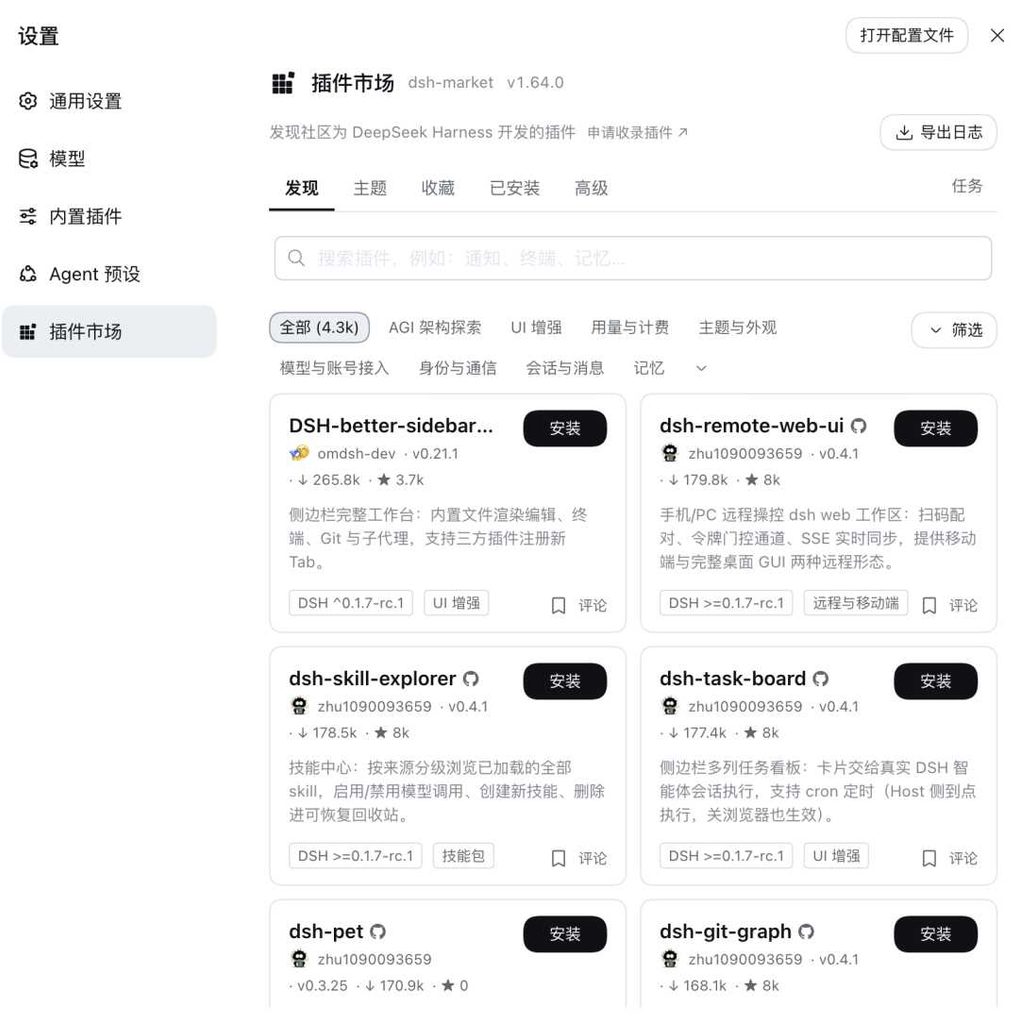
DeepSeek Harness 的 dsh-market 是外掛市集及目錄索引,簡單講,就似 VS Code 嘅 Extensions 頁面:你可以喺介面搜尋、安裝、更新同管理插件,唔使每次自己打指令。方便搜尋社群外掛、核對相容條件並一鍵安裝。

目錄有 4,200 多個項目,支援分類、星數、熱門/最新排序和雙語介紹。相容提示讀取 engines.dsh 或 lockstep @deepseek-ai/dsh-* peers;篩選器只隱藏已確認不匹配的項目,資料缺漏時仍會保留,避免誤判。

dsh 0.2.1 起可在 Discover 加入 npm 提供的 format-1 索引,較能配合主機 15 秒載入時限;GitHub Pages 複本在部分網絡可能超時。

  • 官方桌面版要透過應用程式內的 Settings → Plugins 安裝。
  • 討論串採用 GitHub Discussions 和 giscus;閱讀免登入,發文需 GitHub 帳戶,開啟時會連接 [redacted] 及 GitHub。
  • 收藏、主題及分組資料存於個人檔案的 state.json;群組可統一開關外掛。

需要 dsh web 0.1.0-rc.6 或以上版本,安裝後須重新啟動。

GitHub

Categories: 開源, Agentic, DeepSeek, Image

StreamingSwap 把影片換臉推向 20 FPS 即時串流

StreamingSwap 針對長片換臉的身份穩定與速度取捨,透過較短上下文支援單卡即時處理。

StreamingSwap

長時間影片換臉最難維持的不是單幀效果,而是身份一致、原有動作和畫面細節能否一路穩定。StreamingSwap 是一個參考圖像引導的影片換臉模型框架,處理把來源身份轉移到目標影片、同時保留目標人物屬性與動態的問題。

它分兩個階段改善速度與穩定性。Face-RoI Generation 只集中處理臉部區域,配合按噪聲程度調整身份與重建比重的 Joint Rec-ID Loss;其後以 Short-Context Rollout Training 使用模型生成的歷史畫面,減少串流生成中的誤差累積。這套方法針對換臉只改變身份、其他視覺內容大致不變的特性,補足單靠 flow-matching supervision 對身份差異不夠敏感的問題。

提供的結果包括:
– 單張 NVIDIA RTX 4090 達到 21.174 FPS 的端到端吞吐量
– 評估影片最長達 10 分鐘,並展示 19 分鐘、20 FPS 取樣的直播串流測試
– HumanFaceVid 包含 1,000 小時電影風格訓練資料,以及各 200 段短片和長片評估集
– 研究結果在身份轉移和視覺質素之間取得具競爭力的平衡,但資料建構程式和訓練資料仍標示為準備中

電影後期、直播特效和長片角色替換等情境,較能受惠於這種空間與時間上下文都較節省的做法;單卡 RTX 4090 的測試結果亦令即時串流更接近可行範圍。項目提供的是研究模型與展示資料,原始資訊未交代完整安裝指令、未有直接下載的模型權重或訓練資料,因此不宜當成已可隨意下載使用的成品。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 框架, Dataset 數據集

SWIFT 把擴散模型的訓練誤差轉成性能優勢

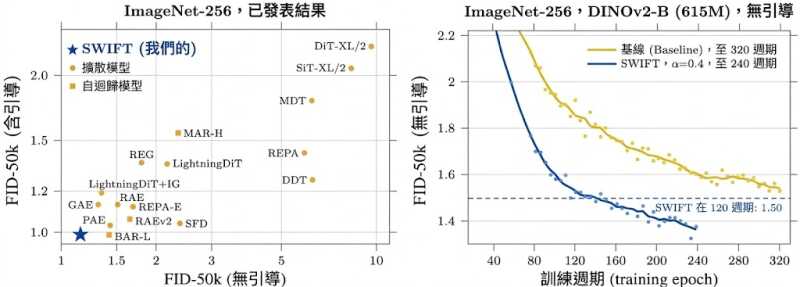
有限訓練令擴散模型偏離理想預測,SWIFT 從較弱模型找出偏差方向,再把訓練目標推向更準確的位置。ImageNet-256 上,它在不改採樣器的情況下取得具競爭力的 FID。

Og image

擴散模型訓練時間有限,預測結果往往未能到達理想的後驗平均值;SWIFT(Self-guided Weak-to-strong dIFfusion models via Target extrapolation)利用這種可預測的偏差,改善模型生成影像的能力。它適合關注影像生成品質、又希望保留原有推理流程的研究者與模型開發者。

SWIFT 先使用一個凍結的弱模型,估計目前模型會在哪個方向偏離理想預測,再把訓練目標沿相反方向外推。訓練時改變的只有預測目標,損失函數、權重、網絡架構及採樣器都維持不變;使用時無須更換原有採樣器。

在 ImageNet-256 評測中,SWIFT 不使用 guidance 時的 FID 為 1.15,使用 guidance 時為 0.99。研究亦在配對的 DINOv2-B 設定下比較訓練進度,SWIFT 在訓練過程中持續領先基準模型。

  • 以凍結的弱去噪模型估計訓練偏差方向。
  • 將乾淨樣本與弱模型預測之間的差距用來外推回歸目標。
  • 保留原有模型架構、損失設定及採樣器。
  • ImageNet-256 的 FID 為 1.15(無 guidance)及 0.99(有 guidance)。

這種方法針對的是有限訓練預算下的模型誤差,並非更改生成時的採樣流程。現有內容未提供完整安裝或使用步驟,採用 SWIFT 前仍需查閱論文及相關資源確認實作細節。

項目主頁

Categories: 南京大學, 阿里巴巴, 模型, 模型訓練, Image

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

Page 5 of 55
1 … 3 4 5 6 7 … 55