ComfyUI-MiniMaxH3-Contex-Loop:讓 MiniMax H3 多場景影片可重試續作

把多場景影片拆成可審核、可重試的製作流程,減少一次渲染失敗便要由頭再做的浪費。

MiniMax H3 Contex Loop v0.5 — scene plans that survive the render

多場景影片最麻煩的地方,往往不是生成單一鏡頭,而是其中一幕出錯後要重做整段流程。ComfyUI-MiniMaxH3-Contex-Loop 是一套開源 ComfyUI 工作流工具,利用一個可重用的 sampling body,按 scene Plan 逐幕生成 MiniMax H3 影片,並把已接受的片段從磁碟組合起來。

每個場景都可以獨立設定提示詞、seed、時間、圖片、動態影片及音訊參考;Review Gate 會讓使用者選擇批准、重試、reroll 或提早停止。candidate_count 亦可為單一場景生成多個候選,最後由使用者揀選指定 take,減少整條工作流反覆排隊的成本。

  • 支援中斷後 resume、partial assembly 及 atomic checkpoints
  • 可延續現有片段,處理 inpainting 和 two-ended bridges
  • Guide 與 protected AV-prefix transitions 有助維持畫面、動態及聲音連接
  • 支援 latent-to-PNG export,並可從已儲存資產恢復製作

v0.5 要求較新的 ComfyUI,包含原生 Add Guide for MiniMax H3。FFmpeg 放在 PATH 會較方便,沒有時可由 ComfyUI 內置 PyAV 處理 review 和 assembly,因此硬件、模型配置及渲染時間仍然是主要限制。倉庫目前以 main 作為支援的 0.5 發行線,已儲存的 0.4 workflows 和 checkpoints 仍然支援,較適合把生成流程分段管理的影片創作者及技術團隊。
GitHub

Categories: 開源, ComfyUI, AI productions, Video, Image, 框架, MiniMax

SparsePR 讓影片生成以稀疏注意力加速,毋須重新訓練

SparsePR 將稀疏注意力帶入四款影片模型,在維持生成質素的同時,把執行速度提升最多 2.61 倍。

Repository image for PardisTaghavi/SparsePR

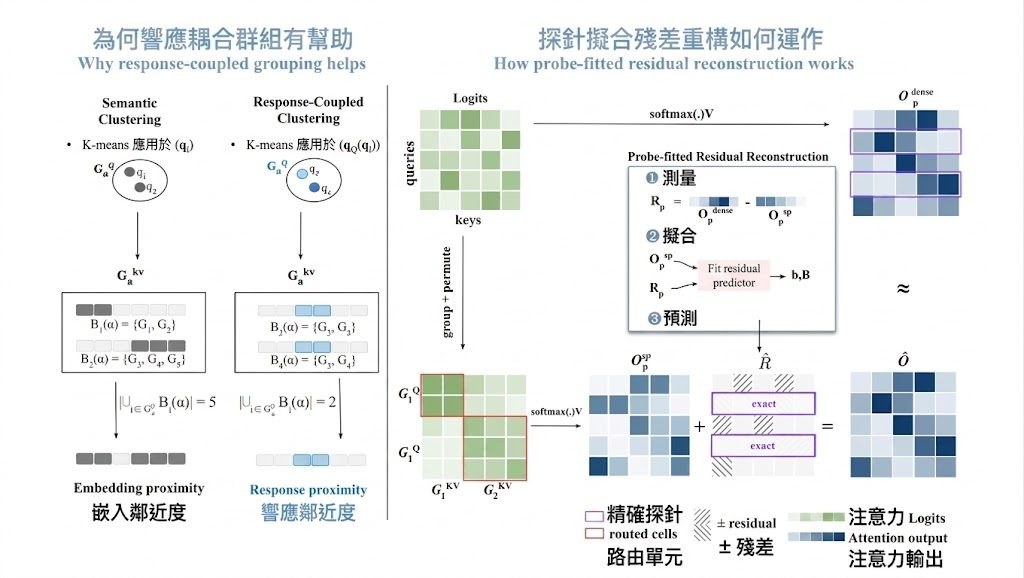
影片生成最吃資源的部分,往往不是提示詞或輸出格式,而是 Video Transformer 裏大量 Attention 計算。SparsePR 屬於 training-free sparse attention 參考實作,透過減少不必要的 query、key/value 互動,加速 HunyuanVideo-13B、Wan2.2-I2V-A14B、Cosmos-Predict2.5-14B 及 Cosmos3-Nano-16B,毋須額外訓練模型。

它沒有單純按注意力集中程度刪走區塊,而是以 Response-Coupled Partitioning 按目前回應分組,再用少量 exact probe rows 配合 Probe-Fitted Residual Reconstruction,補回稀疏計算遺漏的輸出。使用者可透過同一個介面,在 dense baseline 與 SparsePR 之間切換,直接比較影片質素、速度和顯存取捨。

  • 執行 pair density 約 21.9% 至 26.0%
  • 端到端速度提升約 1.48 至 2.61 倍
  • 涵蓋文字轉影片、圖像轉影片及 image-to-world 情境
  • 在 VBench 及 PBench 進行評估,部分 Cosmos-Predict2.5-14B 結果達 40.33 dB

項目要求 Linux,並建議使用 NVIDIA H100;HunyuanVideo、Wan2.2、Cosmos-Predict2.5 與 Cosmos3 需要分開的 CUDA 12.8 wheel 環境,原因是 Cosmos3 依賴較新的 Diffusers 和 Transformers。可選的 fused CUDA kernels 有助進一步執行,但安裝門檻明顯高於一般影片生成工具,模型 checkpoint 亦要從官方 Hugging Face 儲存庫取得。

SparsePR 適合研究影片生成效率、建立高端 GPU 推理基準,或需要在保留畫面質素下減少計算量的團隊。它目前仍是參考實作,支援模型和硬件環境較有限;對只有消費級 GPU、只想快速試玩影片生成的使用者,成本與環境配置可能抵銷加速帶來的好處。

項目主頁 · GitHub

Categories: 開源, 模型訓練, NVIDIA, Video, Image, 框架, Linux

InfinityEdit:支援多輪連續編輯嘅開源影片框架

InfinityEdit 將影片編輯變成連續接力,每個指令都在上一段結果上再延伸。它適合要處理長片段、持續畫面同多輪改動嘅場景。

Pianist source video thumbnail

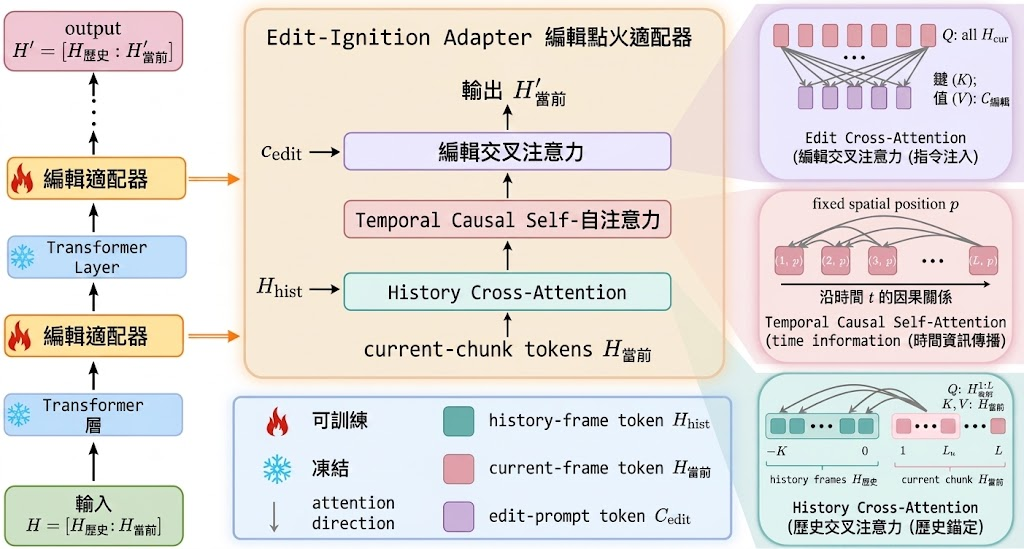
InfinityEdit 係一個影片編輯框架,核心問題唔係單次改一段短片,而係面對持續流入嘅影片,連續套用多個指令,令後一段自然接住前一段,仲要保住畫面連貫。對做長片生成、直播式視覺改寫,或者需要一路加指令一路修正畫面嘅工作流程,佢處理嘅正正就係「編輯唔可以只限喺固定片段內」呢個限制。

佢嘅做法係喺凍結嘅 video diffusion backbone 上面加一個輕量嘅 Edit-Ignition Adapter,令原本負責串流生成嘅模型多咗三層訊息路徑:歷史畫面引導、時間因果注意力,同埋編輯指令注入。生成時只會喺有新編輯指令到達嘅那一段啟動 adapter,之後嘅片段就交回原模型接力,記憶體負擔唔會一路膨脹。

項目提供訓練程式同多輪推理流程,安裝方法都幾直接,先建 Python 3.11 環境,再裝 requirements.txt,之後下載基座模型 Helios-Distilled。訓練分兩階段,第一階段學基本編輯能力,第二階段再針對低噪聲細節同時間權重做修正;推理則會輸出一串 source.mp4edit_1edit_2 之類嘅連續結果,方便睇到每次指令點樣疊落去。

同一般固定源片逐格改寫嘅方法相比,InfinityEdit 睇重嘅係「延續」而唔係「覆寫」。呢個取捨令佢更貼近長影片、持續鏡頭、反覆編修呢類工作,但亦意味住訓練資料要先做 VAE latent 同文字 embedding 預處理,流程比即插即用工具重少少。官方展示同評估都集中喺長片生成同多輪 sequential editing,顯示佢嘗試解決嘅唔係單次風格轉換,而係編輯累積後仍然保持穩定。

  • 支援多輪順序編輯,每次指令都建立喺上一段已編輯內容之上
  • 以凍結 backbone 配合輕量 adapter,改動集中,唔需要重寫整個生成模型
  • 適合長片生成、持續鏡頭改寫、分段式影片修正呢類場景
  • 訓練同推理都已經拆好流程,但前期資料預處理同模型下載仍然係必要步驟
  • 評估重點放喺長序列穩定性同編輯連貫性,而唔係單一片段嘅局部改動

對做影片生成、研究串流式編輯,或者想將文字指令一路疊加到同一條影片流嘅團隊,呢個項目提供咗一個較完整嘅技術路線。佢唔係追求一次過改到最盡,而係用較細嘅介入,令編輯可以一路接力落去,仲保持住原本生成器嘅長片能力。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Embedding, Video, 框架, Python

OpenChatCut:讓 Agent 編輯真正時間軸影片工具

將 AI 代理直接接入影片剪輯流程,讓文字指令可以落到可編輯的時間軸。它同時保留多軌音訊、字幕、轉場與特效,適合想把剪片交給代理協作的人。

OpenChatCut

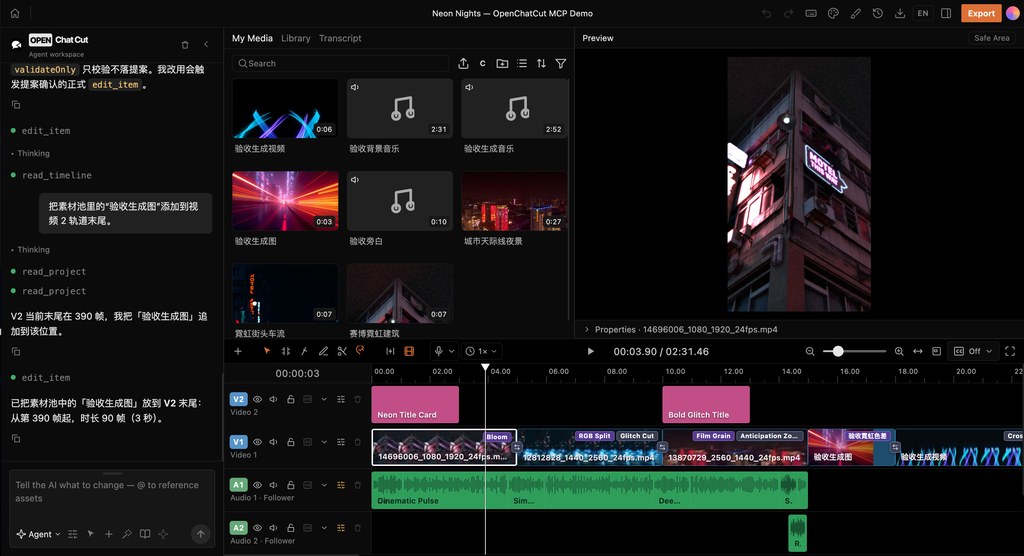
OpenChatCut 是一個本地優先的 AI 影片編輯工具,核心不是產生一段成品影片,而是把文字指令轉成可繼續修改的真實項目。AI agent 可以直接讀、改、匯出同一條時間軸,剪輯結果不會鎖死在單次生成裡。

它把代理工作流和傳統剪輯介面接在一起,支援多軌影片與音訊、轉場、特效、LUTs、縮放、關鍵幀、逐字稿剪輯、停頓處理、講者分離,以及連動字幕。換句話說,AI 不是只幫你寫文案,而是能進一步影響鏡頭切分、節奏和素材編排。

項目比較像一套框架加編輯器的結合,使用場景偏向需要反覆修正的影片工作,而不是一次過生成完就收工。它的取捨也很明顯:功能面走向完整時間軸與多代理共用工具,代價是整體更接近真正剪輯流程,學習成本自然高過單純的聊天式影片工具。

  • 支援 agent-native 工作流,內建 agent 和外部 MCP agents 共用同一組編輯工具
  • 保留 real timeline,方便逐格調整而不是只看輸出成品
  • 逐字稿驅動剪輯,適合訪談、Podcast、教學片段等內容
  • 可處理圖片、影片、語音、音樂、音效與線上媒體搜尋
  • README 標示為 active development,較適合願意接受快速迭代的人

從目前資料看,OpenChatCut 對內容團隊、獨立創作者、以及想把 AI 代理納入剪輯流程的人最有吸引力。它不是替你省掉所有剪輯工作,而是把最花時間的整理、切段和反覆修改,搬進一個仍可手動接手的項目裡。

GitHub

Categories: 開源, Agentic, AI productions, MCP, Video

VoxEMW:把 Mac 變成 1.3 秒回應的私人語音助手

VoxEMW 將語音處理放在 Apple Silicon Mac,手機只需透過瀏覽器或 iOS 客戶端對話,回應速度與音色克隆是最大賣點。

Repository image for emwstudio/VoxEMW

對住手機講完一句話,約 1.3 秒後便聽到固定角色用克隆聲線回答,VoxEMW 屬於開源語音助手項目,處理判停、轉寫、對話調度及語音合成,解決語音對話延遲高、角色聲線難以保持的問題。Mac 負責主要語音管線,只有 LLM 大腦經 DeepSeek API 上雲,日常成本相對可控。

整套流程由 Silero 加 SmartTurn 負責判斷何時真正講完,Qwen3-ASR-0.6B-hf 在 MPS 上轉寫,再由 DeepSeek v4-flash 產生回覆,Qwen3-TTS-1.7B-Base 以 MLX 6bit 執行零樣本音色克隆。參考聲音配合逐字台詞便可註冊角色,首段聲音約 0.5 秒生成;中途打斷時,已播放及已聽內容會寫回上下文,對話較不容易斷層。

一块 4090 跑通 AI 视频通话全栈:Qwen3.8-27B 本地部署,对话时延 2 秒

項目需要 Apple Silicon Mac 作本地伺服器,實測以 M5、16GB 記憶體可以流暢運行,模型及環境約需下載 4GB。瀏覽器可直接連接本機介面;iPhone 或 iPad 則要透過局域網 HTTPS/WSS 連線,並自行處理 TLS 證書、Xcode 簽署及免費帳戶七日側載限制。

• 回應最快 1.26 秒,中位數約 1.6 秒,實際速度仍受網絡及 API 影響
• VAD、STT、TTS 留在本機,DeepSeek API 按 token 收費
• 支援流式字幕、空回覆重試及語音中斷後續接
• 全屏星空會隨說話及聲波變化,增加角色互動感

相比全程雲端方案,VoxEMW 減少語音資料離開家中 Mac,但需要一部 Apple Silicon Mac 長期運行;相比完全離線方案,DeepSeek API 帶來額外費用及資料傳輸考慮。適合想建立固定聲線角色、研究低延遲語音管線,或有 Mac 作家庭伺服器的開發者,普通使用者則要先接受證書、模型環境及 API 金鑰設定等門檻。

GitHub

Categories: 開源, 文字轉語音, Qwen, DeepSeek, API, 框架, Mac, 語音, 蘋果

Comfyui-MMH3-UltimateUpscale:長片放大不再受顯存牽制

ComfyUI 新增單節點升頻方案,讓 MiniMax H3 長片在有限 VRAM 顯示卡上處理,同時保留原有音訊。

Repository image for bbaudio-2025/Comfyui-MMH3-UltimateUpscale

長片、高解像度加上有限 VRAM(Video Random Access Memory)通常意味著要大幅降低輸出要求,但 Comfyui-MMH3-UltimateUpscale 把 MiniMax H3 的 AV latent 放進單一 ComfyUI 節點處理,目標是完成升頻而不破壞音訊。它屬於 ComfyUI 自訂工具,實際解決的是標準升頻節點無法理解 H3 視訊與音訊巢狀 latent 結構的問題。

節點會先以 temporal chunking 把長片切成重疊時間區段,再按需要進行 latent upscale,之後以 spatial tiling 分割畫面,逐塊完成 diffusion sampling,最後分別進行 spatial stitching 和 temporal stitching。每次只處理一個 tile,峰值顯存取決於單塊大小,而不是整段影片的長度或完整輸出解像度,代價是切割、重疊與拼接會增加處理時間及流程複雜度。

升頻有兩條路線:MMH3 Latent Upscale with Model Params 會載入 minimax h3 latent upscaler 3d .safetensors checkpoint,以 H3 3D model-based upscaler 改善 latent;MMH3 Latent Upscale Params 則只用 nearest、bilinear、area 或 bicubic 插值,不需額外模型,較省資源但不會補回模型推斷的細節。兩者都保留 32-channel audio,音訊部分不會重新取樣。

  • 長片可用 temporal chunking 分段處理
  • 高解像度可用 spatial tiling 控制顯存峰值
  • 單一 MMH3 Ultimate Upscale 節點包辦整個流程
  • 3D 模型升頻與免模型插值可按硬件取捨
  • 輸入必須是已完成去噪的 MiniMax H3 AV latent

這個項目較適合已經用 MiniMax H3 產生影片、但顯示卡顯存不足以一次處理完整片段的 ComfyUI 使用者,也適合需要保留同步音訊的影片製作流程。測試時應由較短片段及較細 tile 開始,確認模型 checkpoint、H3 節點及拼接結果正常,再逐步增加時間分塊和輸出解像度;它降低的是顯存門檻,並不代表長片升頻可以即時完成。

GitHub

Categories: 開源, ComfyUI, Video, Audio, MiniMax

DeepSeek API 加入圖片理解,支援截圖與圖表分析

DeepSeek-v4-flash-vision-exp 可把圖片與文字放在同一個請求,處理截圖、圖片描述及圖表分析。

Og image

處理產品截圖、掃描文件或圖表時,DeepSeek API 現在可讓文字問題與圖片一併送出,由 deepseek-v4-flash-vision-exp 回應內容。這個視覺模型適合用於圖片描述、讀取截圖文字,以及分析圖表等需要結合視覺與語言的工作流。

API 採用 OpenAI-compatible Chat Completions 格式,請求中的 content 不再只是單一字串,而是由文字和圖片區塊組成;Responses API 亦支援以 input_image content parts 傳送圖片。開發者可按項目需要選擇圖片提交方式,文件列出三種方法,其中包括直接內嵌 Base64 圖片,以及提供公開可存取的 http(s) 圖片網址。

支援的圖片格式包括 JPEG、PNG、GIF 和 WebP。系統會按檔案實際內容判斷格式,而不是依賴檔名或宣告的 MIME type;使用 Base64 內嵌本地圖片較直接,但編碼後的資料會計入 48 MiB request body 上限。

  • 可同時分析文字與圖片
  • 適合讀取截圖文字及分析圖表
  • 支援 JPEG、PNG、GIF 和 WebP
  • 兼容 Chat Completions 與 Responses API
  • Base64 圖片會受 48 MiB 請求大小限制

需要把圖片理解接入現有 OpenAI SDK 或 API 工作流的開發者,可沿用熟悉的請求結構,再按圖片來源選擇內嵌資料或公開網址。圖片網址必須可供模型下載,並受 8192 字元長度限制。

項目主頁

Categories: Agentic, DeepSeek, API, Image

video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

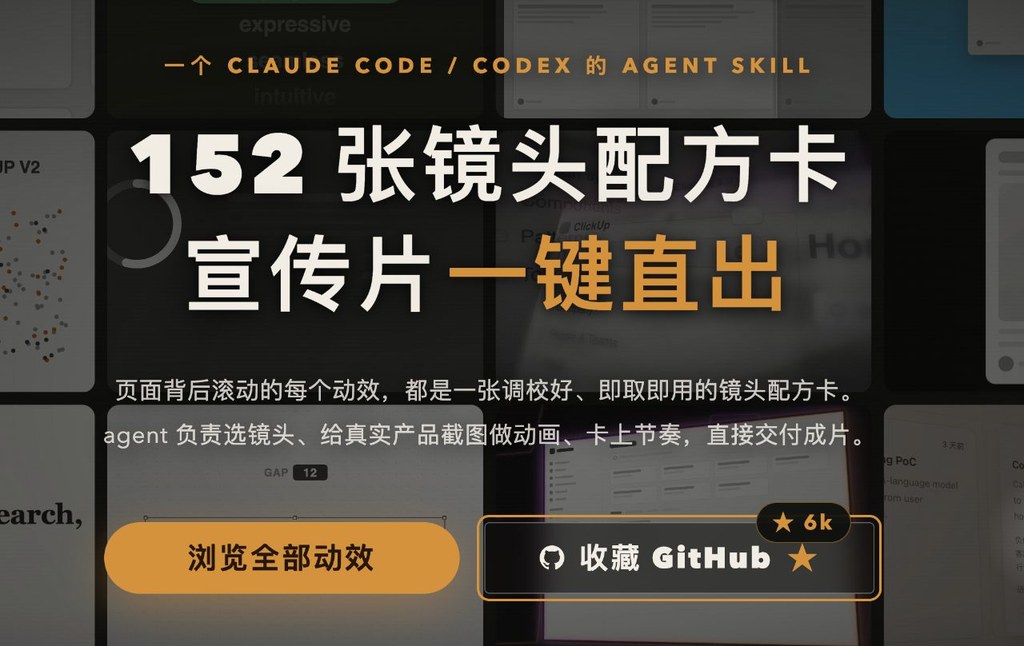
畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, Agentic, AI productions, OpenAI, Video, Anthropic, Dataset 數據集, Skill 技能

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layerlayer_pitchesstart_yawyaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

NAPE 簡化自監督音訊片段訓練

NAPE 以因果 Transformer 預測下一個音訊 patch embedding,省去解碼器與 tokenizer,探索更精簡的音訊表徵學習方法。

NAPE Architecture

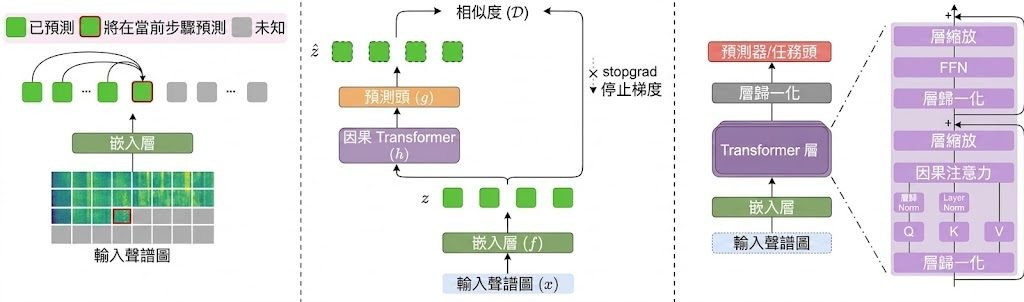
音訊模型要兼顧訓練成本、表徵能力與模型規模,往往需要加入多個輔助模組。NAPE(Next Audio Patch Embedding prediction)是一個自監督音訊表徵學習框架,將 log-mel spectrogram 切成 patch,再由因果 Transformer 根據前面的片段預測下一個 patch embedding。

NAPE 沒有 reconstruction decoder、acoustic tokenizer、student-teacher 架構或額外正則化損失。它依靠三個機制維持學習訊號:causal masking 隱藏未來位置、prediction shift 要求位置 t 預測 t+1,以及 stop-gradient 固定目標 embedding,避免模型退化成輸出相同向量。

二維 spectrogram 會按指定 scanning order 轉成一維序列,研究涵蓋 raster、diagonal、zigzag 和 time-major 四種排列;其中 raster、diagonal 及時間方向的排列較符合聲音事件的發展。模型在 AudioSet 預訓練,再於 AudioSet-2M、AudioSet-20K、ESC-50、Speech Commands V1/V2 和 IEMOCAP 進行微調或 linear probing,資料顯示它在多項任務取得 state-of-the-art fine-tuning 結果,並具備穩定的跨規模擴展能力,但原始資訊沒有提供各項具體分數。

要求系統有 Python 3.10、PyTorch 2.8.0 和 Transformers 4.56.2 的環境,並提供 requirements 檔及部分資料集處理程式;ESC-50、Speech Commands V1/V2 和 IEMOCAP 有下載腳本,AudioSet 則要自行處理涉及 YouTube 的下載流程。研究團隊亦列出程式碼及預訓練 checkpoint 的發布資訊,但 Hugging Face checkpoint 仍標示為待辦,不能把完整模型取得流程視為已經齊備。

  • 訓練訊號精簡:只用下一個 patch embedding 預測與 stop-gradient。
  • 適合音訊表徵:可支援語音指令、環境聲音及情緒辨識等任務。
  • 排列順序有影響:spectrogram 的線性化方式會改變模型看到的時間關係。
  • 測試門檻清楚:需要 AudioSet 或下游資料集,以及 W&B 追蹤實驗。
  • 限制在資料流程:AudioSet 不提供同等簡化的下載方式,checkpoint 取得狀態亦未完全明確。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, Audio, Python, 語音

Page 9 of 36
1 7 8 9 10 11 36