FocusGUI 自動揀對的訊息做 GUI 代理

南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

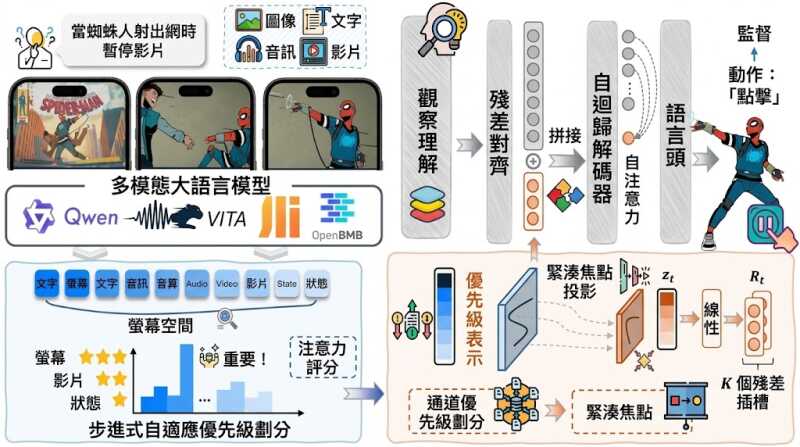
FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。
對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。
項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

Manga2Animate 雙智能把關分鏡,動漫不走樣

把漫畫直接餵進影片模型,角色與分鏡往往走樣。Manga2Animate 改走正規動畫流程:先寫腳本、再繪分鏡,最後才生成影片,由審核智能體把關忠實度。

想用 AI 把幾頁漫畫變成連貫動畫,最常撞到的兩個卡位是:純文字輸入會讓角色外貌與畫風消失,直接把分鏡頁送進影片模型又會誤判版面、講錯故事。Manga2Aniate 屬於多智能體框架,它把整條流程切成「預處理 → 腳本與分鏡優化 → 影片生成」三個階段,第二階段是關鍵差別所在:系統先生成動畫腳本,再產出視覺分鏡,兩者各由一個 creator agent 撰寫,並由對應的 reviewer agent 對照原始漫畫頁給意見,前後跑兩輪迭代才進入成片。

預處理階段用 Magi 偵測漫畫格並排出閱讀順序、抽取文字,再由 Character Description Creator 從角色參考圖歸納出識別特徵,避免後續鏡頭換角色就認不出來。這個雙層審核機制,是它和一般 I2V(image-to-video)套法最大的分水嶺。

對動漫改編從業者、影像敘事研究者,或想快速把作品原型化的獨立創作者,這套 pipeline 提供了比端到端模型更可控的中介層。論文與用戶研究都顯示,無論是角色一致性還是跨鏡頭連貫性,輸出都較接近既有方法優勝。

重點摘要

  • 三階段流程:Magi 切格+轉錄 → 腳本與分鏡兩輪迭代 → 片段式影片生成
  • 雙智能體架構:creator 撰寫、reviewer 對照原頁把關,腳本與分鏡各有獨立審核
  • 兩種生成模式:ref 模式以角色參考為主,i2v 模式則把分鏡切成首幀再生成
  • 開源後端齊全:程式碼、評測資料與模型設定皆公開,方便重現
  • 改善既有 I2V 套法常見的「角色走樣、敘事錯位」問題,在忠實度與一致性上有所提升

需要留意的是,目前公開的程式碼屬於研究框架性質,本地重現需要自行串接影片生成後端,權重未統一打包,下載及設定流程會比一般一鍵安裝的開源項目多幾道手續。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Image, 框架, Content Creator, 動畫

Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。

DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。

GitHub

Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

DeepInfer 開放 DeepSeek 離線推理核心

DeepInfer 把 DeepSeek 大規模服務的離線推理核心開源,涵蓋高效 kernels、並行排程與解碼加速,但未包括完整線上服務組件。

Prefill: non-cached input throughput vs. latency

對需要自行建立高效模型服務的團隊,DeepInfer 提供了一條更接近 DeepSeek 生產環境的技術路徑。這個框架負責離線推理,處理模型執行、批次排程與輸出生成;KV cache 系統、Prefill/Decode 分离及跨資料平行副本負載平衡則須另行整合。

  • 支援 DeepSeek-V4.1-Flash,涵蓋模型與 sampler runtime、FlashMLA、DeepGEMM、DeepEP 等最佳化 kernels。
  • 以 DSpark draft tokens 配合信心度排程驗證,減少解碼階段等待;預設最大 draft 長度為 5。
  • 支援 MoE EP、EPLB、Attention DP、balanced CP,以及 CPU 與裝置執行重疊的非同步批次排程。
  • 提供 SWA bounded replay、structured outputs、batch-invariant inference 與 deterministic sampling,方便控制成本和重現結果。

它與一般模型框架的分別,不在新增模型能力,而在於把 DeepSeek 線上服務累積的低延遲機制整理成可編譯的推理框架,代價是硬件與整合門檻較高。環境要求包括 Linux、Python 3.12、GCC 13 或以上;NVIDIA 路線使用 CUDA 13 及 SM100 GPU,另有 Huawei Ascend 950 NPU 版本,部分功能只支援 NVIDIA。

對吞吐量、推理成本和結果一致性敏感的 AI 平台團隊,DeepInfer 的價值較明顯。它提供 batch-invariant inference、regex、JSON schema 與 EBNF grammar 約束,但官方未提供吞吐量或延遲數據;公開內容亦未涵蓋完整部署指南與線上服務元件,較適合具備 GPU、NPU 及分散式系統經驗的團隊從源碼整合。

GitHub

Categories: 開源, 華為, 模型, NVIDIA, DeepSeek, 框架, 線上服務, Linux, Python

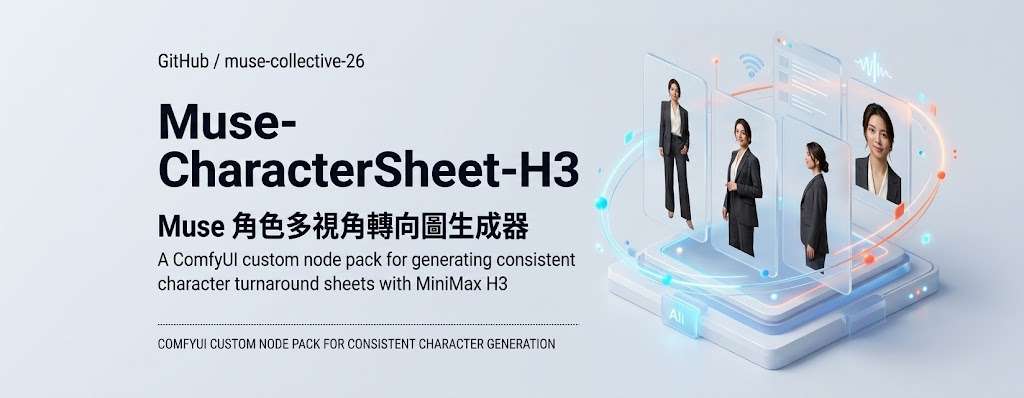
Muse-CharacterSheet-H3:MiniMax H3 角色表工作流

生成多角度、背景移除及排版一次完成,減少 ComfyUI 製作角色設定表的繁瑣步驟。

Repository image for muse-collective-26/Muse-CharacterSheet-H3

將五個角度的生成結果自動拼成一張角色設定表,Muse Character Sheet H3 這個 ComfyUI 工具組把 MiniMax H3 的多視角生成、文字儲存、影像轉換及背景處理連成一套工作流。對遊戲美術、角色設計與虛擬內容製作團隊而言,它省去逐格裁切、調整比例及手工排版,但仍需自行準備模型權重與合適的 ComfyUI 環境。

  • 提供 Standard 與 Enhanced 兩套工作流。
  • CHUNK/CUT 介面會把姿勢描述編譯成 H3 六段式 Reference-mode 提示格式。
  • Muse Character Sheet Compositor 可把 Close-up、Front、Left Profile、Right Profile、Back 五格自動並排。
  • Windows 安裝包已整合三個 Muse 工具節點,不需另下載獨立 utility ZIP。

Enhanced 版本在 H3 生成後加入 Qwen image refinement 與 DLSS enhancement;Standard 則以背景移除及選取畫面組成設定表,不依賴 DLSS,適合較簡單或未配置相關環境的流程。標準流程不再要求 WAS Node Suite 或原有 ComfyUI-RMBG 套件,但若其他工作流仍使用,就不應直接刪除。

背景移除輸出 IMAGE、MASK 與 MASK IMAGE;模型權重則另有使用條款。組合設定表支援 16:9、4:3、1:1、3:2 及 21:9,工具會按比例處理裁切,Close-up 佔完整寬度,其餘四個角度排列在側。

Windows 測試可下載完整 ZIP,將資料夾放入 custom_nodes,再執行 Install-Windows.bat;Git 必須在 PATH,模型則按清單另行下載。從前安裝過獨立工具資料夾的環境,應把備份移出 custom_nodes,避免同一節點重複註冊;安裝器不會自動刪除舊資料夾。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Image, 工具, MiniMax

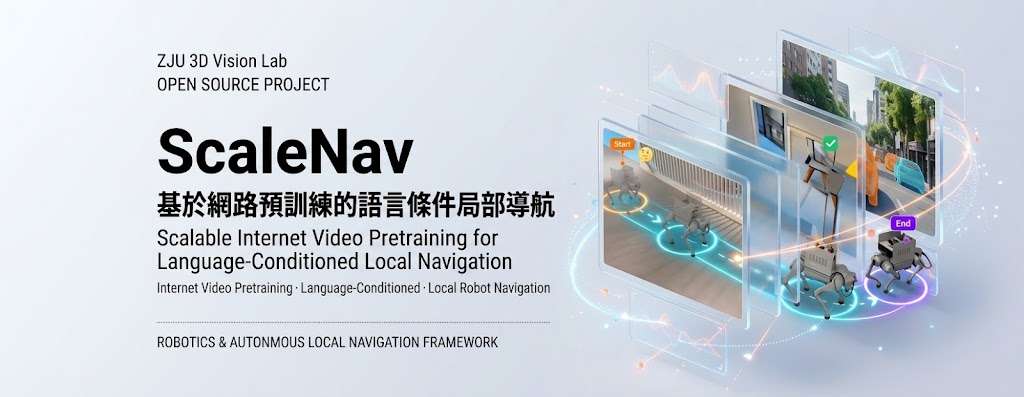
ScaleNav 把影片變成導航能力

ScaleNav 先從互聯網第一視角影片學習路徑規律,再轉成機器人動作,面對語言指定目標的局部導航。

ScaleNav navigation: real robot on the left, simulation on the right

網上第一視角影片 seldom 附帶機器人動作,但當中蘊藏大量「沿走廊前進、避開障礙、轉入目標房間」的視覺規律。ScaleNav 是一個研究型導航模型,試圖把這些 action-free 預訓練所得到的 navigation priors,轉移到有動作標籤的模擬軌跡,再用於 language-conditioned local navigation:按文字尋找初始畫面可見的目標並停下來。

模型屬共享式 Diffusion Transformer,會根據指令、目前 RGB 影像及記憶,共同預測未來 video latents 和 action chunks。流程分三階段:先從互聯網第一視角影片學習目標導向視覺動態,再進行 action alignment,最後 joint fine-tuning,同時保留影片回放並微調共享骨干與輸出頭。

ScaleNav 與同類做法的主要取捨,是毋須先收集大量完整機器人示範,便能借助互聯網影片建立導航先驗;代價是仍要依賴模擬軌跡、動作對齊及多階段訓練。官方模型約 10.02 GB,推論及評估建議使用支援 BF16 的 NVIDIA GPU、24 GB GPU 記憶體與 64 GB 系統記憶體,並按文件配置 Linux、Habitat-GS 和場景轉換工具。

結果涵蓋 HabitatGS-LN、Short-Horizon OVON 與真實四足機械人;公開資料列出 ScaleNav 在兩項模擬評估的成功率分別為 94.9% 及 86.5%,真實機械人則在 60 次試驗中錄得 83.3% 成功率。團隊亦整理 gallery 導航影片、軌跡、目標與結果,以及 summary.json 內的 SR、SPL 和逐任務成績,方便比較與重現。

  • 影片預訓練不必附帶逐格動作標籤
  • 同一模型處理影片動態與動作生成
  • 支援模擬環境及真實四足機械人
  • 提供模型、資料、評估結果與操作文件

這套方法較適合研究 embodied navigation、 robotics 與 VLA(Vision-Language-Action)的團隊;評估數字雖亮眼,仍須留意各方法採用不同設定,跨模型比較應同時核對 episode 數、場景及 fine-tuning 條件。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, VLA, Robotic, 工具, Linux

MT-Forcing:多輪改圖守住細節唔再走樣

連續改同一張圖時,主體、紋理與構圖往往會慢慢偏離;MT Forcing 以多輪訓練與教師引導改善這類累積錯誤。

MT Forcing teaser

連續要求「改杯色、加條紋、再調光線」時,圖片往往未到最後一輪已經失真。MT Forcing 是針對多輪圖像編輯的訓練框架,配合自迴歸擴散模型,減少每輪修改帶來的漂移。

方法把單輪 DMD(Distribution Matching Distillation)與 Teacher-Forcing Guidance 結合:學生模型逐步編輯自己生成的歷史,凍結的單輪教師則從原圖一次套用累積指示,提供分布層面的引導。參考真實編輯軌跡後,模型既要改善畫質,也要維持跨輪次內容關係。

  • 以自身多輪輸出作為訓練歷史
  • 引入單輪 DMD 改善視覺品質
  • 用 Teacher-Forcing Guidance 減少誤差累積
  • 展示最長十五輪及八輪編輯比較

官方程式碼要求 Python 3.11.13、NVIDIA CUDA GPU,以及指定 checkpoint、架構資源和擴充 U1.5 tokenizer;配置完成後,可在同一工作階段依序執行多個編輯提示。公開資料未交代完整硬件門檻、推理速度或標準化定量結果,因此較適合作為需要 NVIDIA GPU 的研究重現工具,而非直接比較成本已知的消費級服務。

它以 SenseNova-U1.5 作為相關基礎模型,並在多輪比較中加入 MT Forcing。對需要逐步修訂產品 concept、人物姿勢或場景細節的設計團隊,單輪教師可作品質參照。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 清華大學, 模型, 模型訓練, NVIDIA, Image, 影像模型, 框架, 工具, Python, Tokenize

Xiaomi-Lens-0 讓 4B 視覺模型標註出答案

這個 4B 多模態模型把文字回答與像素級定位放在同一套推理中,適合需要理解物件、指出位置及分割影像的場景。

Xiaomi-Lens-0 recorded outputs across six task domains

要讓模型回答「紅色杯子在哪裡」之餘,同時準確框出甚至分割杯子,傳統多模態模型往往要串接多個模型。Xiaomi-Lens-0 試圖把這兩步合而為一:它以 Qwen3.5-4B 為基礎,在生成文字的過程中解讀 <|mask|> token,再由輕量解碼器輸出對應區域,令文字答案與視覺定位可以同步產生。

這個 4B 多模態模型主要處理 Referring Expression Comprehension、Referring Expression Segmentation、多實例定位、Reasoning Segmentation、具身指令指代及細緻感知等六類任務。它既能以邊界框指出物件,亦能輸出像素遮罩,適合影像標註、搜尋、選取區域及具身操作前的人工檢查。

  • 以 4B 規模結合文字回答、邊界框與像素級遮罩
  • 支援六類定位及視覺推理場景
  • 可在 Hugging Face Spaces 試用,亦公開模型權重與 LensBench
  • 提供每個遮罩獨立輸出及熱力圖等推理設定

模型在八個 RefCOCO 系列分割上的平均 referring comprehension 提升 5.6 分,並在八個細粒度感知測試中取得較高分數;項目頁另列出 RefCOCO 驗證集 Prec@0.5 為 94.6。LensBench 包含 4,800 個 instruction-level 樣本,涵蓋 1,200 個配對單位及四個領域。

代價是輸出遮罩需要額外視覺解碼,而模型規模仍屬輕量,複雜推理和高解析影像表現應按測試結果判斷。研究團隊已提供線上示範、模型權重及程式碼,適合想試驗視覺 grounding 的模型開發者、影像工具團隊和具身智能研究人員。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, Qwen, Image, 影像處理, 工具, 小米-Xiaomi

MOSS-Image 支援 JSON 排版的 5B 文字生圖模型

MOSS-Image 推出的 5B 參數文字生圖模型,能夠直接在 prompt 內用 JSON 描述物件位置、標籤與邊界框,毋須額外 ControlNet 也能控制版面。

MOSS-Image

用文字生圖最常遇到的卡位,是 prompt 寫得再精準,模型依然把主體放錯位置或把文字渲染得歪七扭八。OpenMOSS 開源的 MOSS-Image 把這個矛盾寫進模型架構本身:除了自然語言 prompt,它同時接受結構化 JSON 輸入,裏面可以逐個列出物件的標籤、描述與 yxyx 格式邊界框,由模型原生處理版面配置,毋須借助外掛 ControlNet 或額外 inpainting 步驟。

對於做海報、漫畫分鏡或產品 mockup 的人來說,這種介面比「再抽幾次卡」來得直接。生成結果可以直接根據 JSON 編輯調整單一物件的位置或文字內容,方便反覆迭代。模型骨幹約 5B 參數,支援長達 4K token 的 prompt,文字渲染能力亦比同類開源模型紮實,並同時覆蓋動漫與寫實風格。

New top local AI image generator is here!

現階段提供 Base 與 SFT(curated-data 微調)兩個版本,權重以 Apache-2.0 釋出,部署上已有 SGLang、vLLM-Omni 與 ComfyUI 的 day-0 支援,配合 Python 及 Gradio 共用的 Diffusers pipeline,本地或雲端皆可即時跑起 demo。

重點摘要:

  • 原生版面控制:JSON prompt 直接描述物件、位置與邊界框,毋須外掛 ControlNet。
  • 5B 緊湊骨幹:兼顧生成效率與微調彈性,prompt 可長達 4K token。
  • 雙版本開源:Base 與 SFT 權重皆公開,Apache-2.0 授權。
  • 多元框架支援:SGLang、vLLM-Omni、ComfyUI 同日適配,並提供 Hugging Face Spaces 線上 demo。
  • 風格覆蓋廣:動漫與寫實風格並重,文字渲染品質為主打賣點之一。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, NVIDIA, Image, 框架, Python, 蘋果

KTP(Knowledge-Transfer-Probing) 統一多模態模型做知識轉移考核

清華與 Z.AI 團隊提出 KTP 評測協議,專門測試統一多模態模型從圖像生成學到的新知識能否透過純文字問答取出,逐步補上視覺與語言之間的知識流動缺口。

knowledge transfer probing

統一多模態模型(Unified Multimodal Models, UMMs)一邊做圖像生成、一邊做語言理解,但訓練時從圖像吸收的知識,一直難以量化究竟有多少真的能在純文字 QA 場景派上用場。Knowledge Transfer Probing(KTP)這個項目正正填補這個缺口:它設計了一套受控的評測協議,先以圖像生成訓練把新知識餵進模型,再以純文字問答檢驗模型能否取出。

團隊跨越七個知識類別(色彩、數量、形狀、相對空間、相對大小等),在三個 UMM 上觀察到一個關鍵現象:直接從視覺監督遷移到語言的知識,效果並不均勻,部分類別知識存取明顯偏弱。有趣的是,在部分實體上做 Textual Alignment 或 Interleaved Image-Text Alignment 對齊訓練後,模型在未對齊的其餘實體上同樣能改善知識存取,其中交錯式對齊的平均準確率比純文字對齊更高。

項目屬於研究型資料集與評測框架,隨倉庫釋出 KTP-Data(分為 train/ 與 eval/),訓練檔涵蓋文字生成圖像、文字對齊及交錯圖文對齊三類樣本,評估檔則提供文字可達性(QA 題目與參考答案)與視覺可達性(生成提示與屬性)。評分腳本只用 Python 標準庫,跑分結果會輸出 results.jsonl 與 summary.json,方便研究者直接替換自家模型回應做比較。

對正在訓練或微調 UMM 嘅團隊而言,KTP 提供一個可重現的基準去量度「圖像生成帶來多少純文字世界可用的知識」,同時指出交錯對齊是一條有實證支持的改進路徑。多模態模型研究者、訓練數據設計者,以及關心視覺-語言聯合表徵架構的人都會從中受益。

這個項目的限制同樣需要留意:KTP 目前只覆蓋七類視覺屬性,且只測試三個 UMM,並未涵蓋複雜語境或多輪推理,結論的普遍性仍有待擴充樣本驗證。

項目主頁 · GitHub

Categories: 開源, 清華大學, 模型, 多模態模型, 模型訓練, Image, 框架, Python, 庫, Dataset 數據集

Page 6 of 55
1 … 4 5 6 7 8 … 55