RhymeFlow:加快影片生成的新路線

RhymeFlow 針對影片生成太慢的老問題,提出免訓練加速方法。它不只追求更快,亦嘗試保住畫面連貫度。

Repository image for Simon-Dcs/RhymeFlow

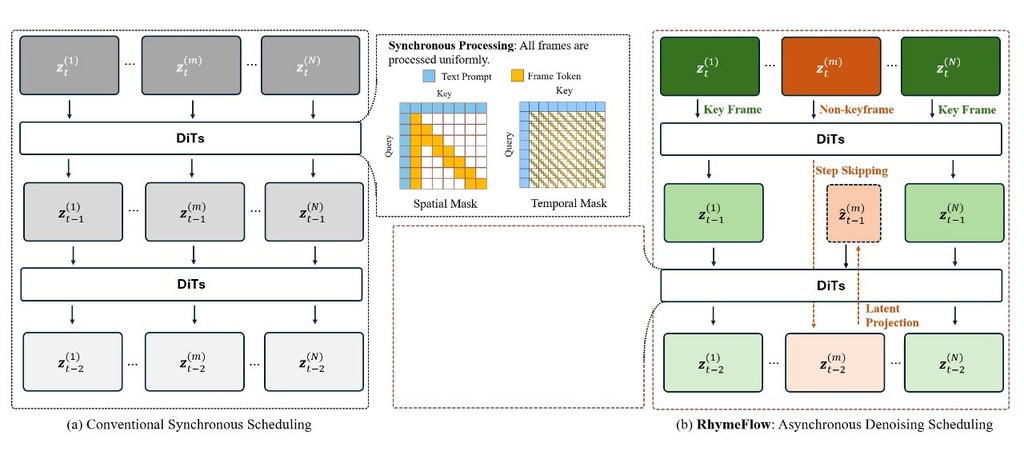
現時不少影片生成加速方法,主要仍沿用標準 diffusion pipeline:每一幀都要在所有 diffusion timesteps 完整做一次 dense denoising,再配合 sparse attention 或 KV-caching 減少單步計算。RhymeFlow 指出,這種固定範式忽略了相鄰影格內容與動作高度相關,令自然影片裡大量中間步驟其實屬於重複運算。

這是一個免訓練的影片生成加速框架,核心目標是替 DiT(Diffusion Transformers)影片模型減少推理延遲與運算成本。它將不同影格的 denoising trajectory 拆開處理:先找出主導語意變化的 keyframes,讓 keyframes 保持逐步去噪,非 keyframes 則逐步跳過部分步驟,再用 latent trajectory projection 補回時間一致性。

這個做法的創新,不在於單純把 attention 再稀疏化,而是直接挑戰「所有影格都要同步、密集去噪」的舊假設。論文描述,RhymeFlow 在現有 DiT-based video generation models 上,能同時取得更高 inference speed 與更好 visual quality;不過 GitHub 目前公開重點放在 Wan 2.1 adaptation,HunyuanVideo adaptation 仍在準備中。

如果你想試,較合理的切入點是把它當成 Wan 2.1 的加速實驗框架,比較 dense、svg、sap、rhyme、rhyme_sap 幾種方法輸出時間與畫面差異。環境要求偏高,文件列出 CUDA 12.4 / 12.8 與 PyTorch 2.5.1 / 2.6.0,亦牽涉 FlashInfer、flash-attn 和自訂 kernels,較適合已有 GPU 與 PyTorch 經驗的人。

  • 項目類型:training-free 影片生成加速框架,處理 DiT 影片模型推理太慢的問題
  • 方法重點:keyframes 做 dense denoising,非 keyframes 跳步處理,再用 latent trajectory projection 維持時序一致
  • 可比較方法:dense、svg、sap、rhyme、rhyme_sap
  • 相關模型:Wan 2.1 已有 adaptation,HunyuanVideo adaptation 尚未完整釋出
  • 適合場景:研究影片生成推理優化、比較不同加速策略、測試速度與畫質取捨

整體來看,RhymeFlow 的價值很明確:它不是改模型權重,也不是重新訓練,而是重排 denoising flow scheduling,從流程層面節省計算。對研究者與進階開發者而言,這類思路比單純堆硬件更有參考價值;對一般創作者來說,現階段門檻仍在部署與 GPU 環境。
GitHub: https://github.com/Simon-Dcs/RhymeFlow

Paper: https://arxiv.org/pdf/2606.06309

Categories: 開源, 清華大學, 騰訊, AI productions, 視頻模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, Python, 深度學習

[技術文章] KAIST 與 Qualcomm 重塑長影片 RAG 評測

這項研究先由 KAIST 與 Qualcomm AI Research 團隊提出新基準,再用新方法改善長影片 RAG 檢索。重點在於拆開評測檢索與生成,找出真正有效的證據片段。

Hero image preview

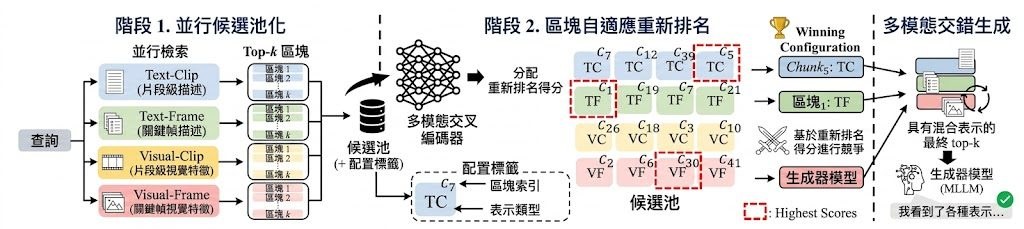
這項研究由 KAIST 與 Qualcomm AI Research、Qualcomm Korea 團隊合作提出,聚焦長時間第一身影片中的 Retrieval-augmented generation(RAG)。作者指出,現有 VideoRAG 常沿用「每條查詢只配一種 modality 與一種 temporal granularity」的固定範式,但長影片的證據片段差異很大,單一設定未必適合全部片段;加上不少既有 benchmark 的問題甚至不用看影片也能答中,令最終分數難以反映檢索是否真的做對。

因此,團隊提出 V-RAGBench,把資料整理成 ⟨query, evidence chunk, answer⟩ triplets,明確分開查詢、證據片段與答案。這種設計針對的是過去「只看最終回答正確率」的盲點,讓研究者可以更忠實地分開檢查 retrieval 與 generation,知道系統究竟是靠對的影片片段,還是靠語言偏見、常識或靜態線索作答。

方法上,作者再提出 CARVE。它不是替整條查詢預先選定一種設定,而是讓多個 retriever 以不同 modality 與 granularity 並行工作,再用 chunk-adaptive reranking 為每個 evidence chunk 挑出最合適的 winning configuration。之後,這些片段會連同各自勝出的設定一併送入 generator,形成 interleaved evidence,令檢索階段的片段級決策延續到生成階段。

對想使用這個項目的人來說,切入點很清楚:先用 V-RAGBench 測試自己的 VideoRAG 流程,分開看檢索與生成表現;若系統目前仍採用查詢級單一設定,可再比較 CARVE 這種片段級配置方式。這種思路較適合長影片問答、egocentric video 分析,以及需要從多模態證據中找出正確時間片段的 Agentic 系統。

  • V-RAGBench 以 evidence chunk 為核心,補足舊 benchmark 無法準確檢查檢索對錯的問題
  • CARVE 改為片段級選擇 configuration,不再假設一條查詢只需一套 modality/granularity
  • 作者指出 generator 最後接收的 chunks 會交錯來自多種 configuration,這是 query-level 方法做不到的
  • 論文稱 CARVE 勝過 8 個近期 VideoRAG baselines,顯示片段級決策在長影片檢索更有優勢

整體來看,這項工作不是單純再加一個 VideoRAG 方法,而是先批評舊有評測與建模範式,再用新 benchmark 和新 retrieval framing 一起修正問題。如果你關心的是長影片 RAG 到底應該取回什麼、以及取回後怎樣交給模型使用,這項研究提供了相當清晰的分析框架。

Paper: https://arxiv.org/pdf/2606.13141

Categories: Agentic, AI productions, RAG, 模型, 多模態模型, Video, 框架, 新聞, Dataset 數據集

MBench 專看長影片世界模型記憶力

MBench不是看單幀靚唔靚,而是追問模型能否記住離鏡後再出現的人與場景。它把長影片記憶拆成三條能力軸,令評測更貼近生成連續影片的難題。

Teaser

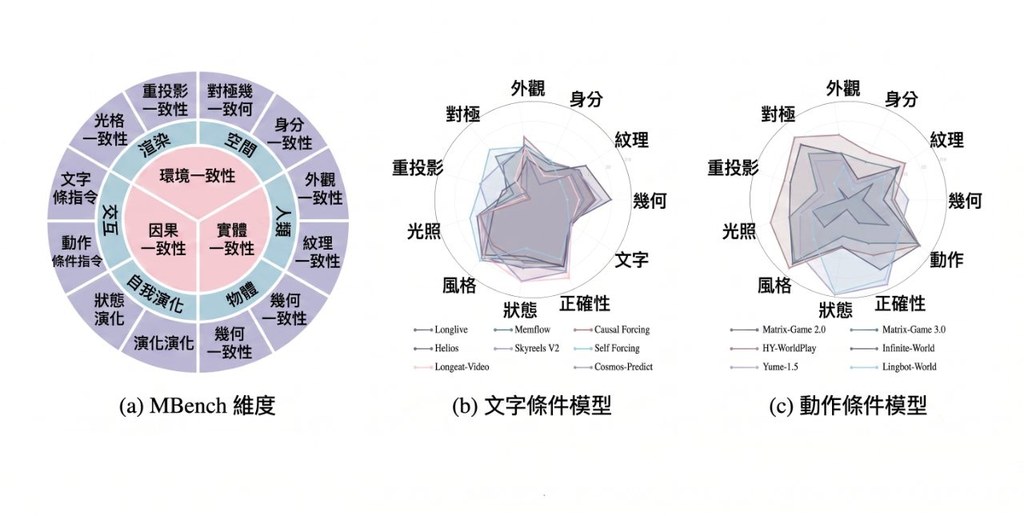
現時不少長影片評測,仍偏向單幀畫質或短距離 prompt following;畫面一旦切走、角色離鏡,很多模型便容易在回到同一情境時「失憶」。MBench 這個benchmark正是針對這個盲點而設,聚焦 long-video world models 的 memory capability,檢查模型能否在時間拉長後維持一致的世界狀態。

作者把問題拆成三個互相獨立但又彼此關連的方向:Entity Consistency、Environment Consistency、Causal Consistency。這種設計比籠統地給一個總分更有分析價值,因為你能看清模型究竟是忘記角色外觀、搞亂場景空間,還是未能延續畫面外仍在發生的物理過程;同時它再分成 MBench-A 與 MBench-T,分別對應 action-conditioned world models 與 text-segment-conditioned 長影片續寫模型。

如果你本身有影片生成或世界模型項目,這個儲存庫的用途很明確:先準備模型輸出,再用 mbench 這套 contract-driven、plugin-based CLI 跑完整評測流程。儲存庫已提供 12 個官方 metric implementation,亦整合 VLM trigger judge,代表它不只是論文概念,而是一套可落地比較不同模型表現的評測工具鏈。

  • 項目類型:這是一個 benchmark/評測工具鏈,用來量度長影片世界模型是否具備穩定記憶與時序一致性。
  • 創新位置:不是只看畫面質素,而是把「長時間記住世界」正式定義成三條 capability axes。
  • 適合場景:長影片生成、world model 研究、模型比較、內部驗證新版本退步與否。
  • 可讀性高:MBench-A 與 MBench-T 將不同條件設定分開,較容易知道模型失分原因。

從評論角度看,MBench 的價值在於它批評了舊有固定範式:只獎勵 single-frame quality 或 short-horizon prompt following,卻未有檢驗跨鏡頭、跨時間的持續記憶。若你關心的模型包括各類 long-video world models、action-conditioned world models,以及 text continuation 類影片模型,這個項目很值得納入測試流程;不過目前提供的資料以 benchmark 與評測框架為主,是否能全面代表所有真實創作場景,仍要配合你自己的生成任務一併觀察。

GitHub: https://github.com/study-overflow/MBench

Paper: https://arxiv.org/pdf/2606.00793

Categories: 開源, 清華大學, 模型, 視頻模型, 世界模型, Video, 框架, 工具, 庫, Win

OmniVideo-100K:增強影音推理訓練數據集

這是一個面向音訊與影片聯合理解的數據集項目,重點不在片段標註,而在較完整的跨模態推理。它更像是幫模型補課的訓練材料庫。

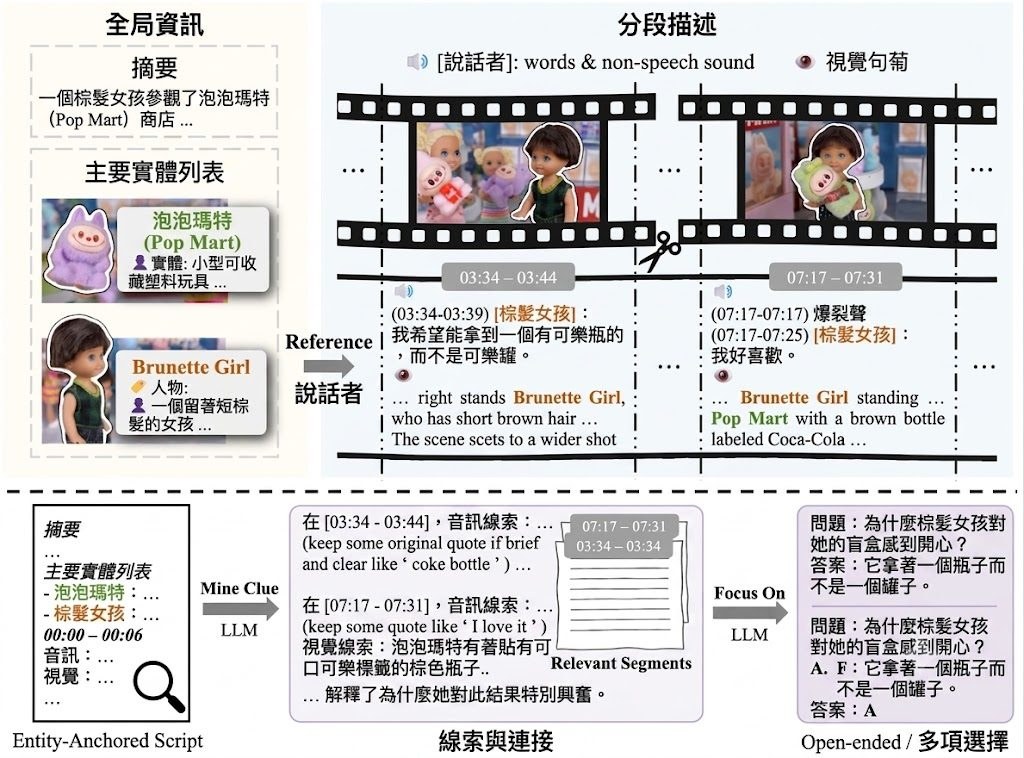
Framework Overview

現時不少影音問答資料建立流程,普遍沿用「video-caption-QA」範式:先把影片切成短片段,再分開寫視覺與音訊描述,最後生成 QA。論文作者認為這種做法容易出現 modality bias、temporal misalignment,同一角色在不同片段亦可能描述不一致,令問題多數只圍繞局部事件,難以考驗長時間跨度的 audio-visual reasoning。

OmniVideo-100K 是一個 Dataset 數據集,目標是為 Multimodal Large Language Models (MLLMs) 提供較完整的影音推理訓練材料。它提出兩個核心機制:Entity-Anchored Video Scripting 先把原始影片整理成結構化 script,包括摘要、主要實體清單,以及帶時間戳的分段音畫描述;Clue-Guided QA Generation 則先抽取跨片段、跨模態線索,再生成較複雜的問答。

這種設計的關鍵,不在於題目數量大,而在於先整理證據鏈再出題。對比舊方法把長文本理解和 QA 合併成一步,OmniVideo-100K 把線索挖掘獨立出來,較有機會產生涉及因果、未來預測與假設推理的題目,而不只是問畫面中「見到乜」。

如果你想測試這個項目,可以先留意 Hugging Face 上的 OmniVideo-100K 與人手驗證的 OmniVideo-Test,看看資料結構是否適合自己的訓練流程;做研究的人則可直接比較模型在外部 benchmark 的變化。論文提到,VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B 經此資料集微調後,在 OmniVideo-Test 最多提升 20.59%,在 Daily-Omni、JointAVBench 也有最多 12.64% 增幅,同時盡量保留在 Video-MME 這類一般影片 benchmark 的能力。

  • 針對舊式「video-caption-QA」流程的三個痛點:modality bias、temporal misalignment、敘事不連貫
  • 用 structured scripts 加 entity list,補回跨片段指代一致性與聲音來源對應
  • 任務覆蓋 10 類,包括 FGP、STD、CU、CP、SA、ESO、SM、CR、FP、HR
  • 適合做影音理解、跨模態推理、指令微調資料研究的人參考
  • 相關模型包括 VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B

整體來看,這個項目的價值在於它不只新增一批資料,而是重寫影音 QA 資料的組織方法。若你關心的不是單張畫面問答,而是影片內角色、聲音、事件先後與推論之間的連結,OmniVideo-100K 會比一般自動合成資料集更有研究參考價值。

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Video, Audio, 工具, 庫, 語音, Dataset 數據集

OmniDirector:免配對數據的多鏡頭運鏡克隆技術

OmniDirector 透過「相機網格」表示法,從多鏡頭影片中克隆運鏡動作,驅動靜態圖像生成動態影片,無需交叉配對數據訓練。

Play video

OmniDirector 由清華大學(Yu-Shen Liu 為北京清華大學團隊)與 Kling Team(快手科技)的研究團隊,共同開發,成員包括 Jiwen Liu、Shujuan Li、Zhixue Fang 等人,團隊來自多個機構,橫跨學術界與業界。研究團隊提出一種無需交叉配對數據的通用多鏡頭相機克隆方法,解決從參考影片中複製運鏡來驅動靜態圖像的難題。

傳統相機控制方法往往依賴大量成對數據進行訓練,而 OmniDirector 的核心創新在於提出「相機網格」(camera grid)表示法。將參考影片的相機姿態渲染為三維空間中的運動軌跡,形成統一的網格表示。配合階層式提示詞擴展代理(hierarchical prompt expansion agent),把多模態控制信號整合成協調的指令。

使用時,使用者只需提供一張源圖像和一段參考影片,OmniDirector 便能克隆其中的運鏡動作,生成動態影片。多鏡頭場景下,新方法支援鏡頭之間的連貫過渡與一致的內容呈現,保持原始的視覺語言。特殊運鏡方面,涵蓋希區柯克式變焦、子彈時間與鏡頭畸變效果,適用的場景類型包括人像、動物、建築及 AIGC 內容等。

OmniDirector: General Multi-Shot Camera Cloning without Cross-Paired Data

OmniDirector 適合從事影片創作、動畫製作或需要快速生成動態素材的內容創作者,以及研究相機控制技術的開發者。經過與其他頂尖相機控制方法的對比,新方法在控制穩定性與物件形變方面表現出色。

重點摘要:
– 核心創新為「相機網格」表示法,免依賴交叉配對數據
– 支援極端運鏡、多鏡頭連貫過渡與特殊相機效果
– 場景泛化能力強,涵蓋人像、動物、建築及 AIGC 內容
– 開源提供論文與程式碼,方便研究與應用

目前 github.com/lisj575/OmniDirector 這個倉庫是空的,沒有 source code 或 model 。

項目: https://ymlinfeng.github.io/OmniDirector.github.io/

Categories: 北京大學, 清華大學, AI productions, 數字人, 模型, 視覺模型, Video, 框架

elframe 簡易提取影片任何幀

最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。 ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!

最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。

ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!

本免費功能為本站測試 OpenSpec 開發成果
Categories: Image, 影像處理, 線上服務

Tunee.ai 可直出 MV

Tunee.ai 是一款次世代 AI 音樂智能體服務,提供自然語言對話驅動的創作體驗,方便各類用戶用簡單描述、音頻、圖片等多模態方式生成、改編、混音、母帶、MV 甚至專輯封面。

Tunee.ai 是一款次世代 AI 音樂智能體服務,提供自然語言對話驅動的創作體驗,方便各類用戶用簡單描述、音頻、圖片等多模態方式生成、改編、混音、母帶、MV 甚至專輯封面。

This AI Makes Music From Anything!
Categories: 線上服務, 免費試用, 音樂

Firebase Studio – 雲端 Vibe 編程

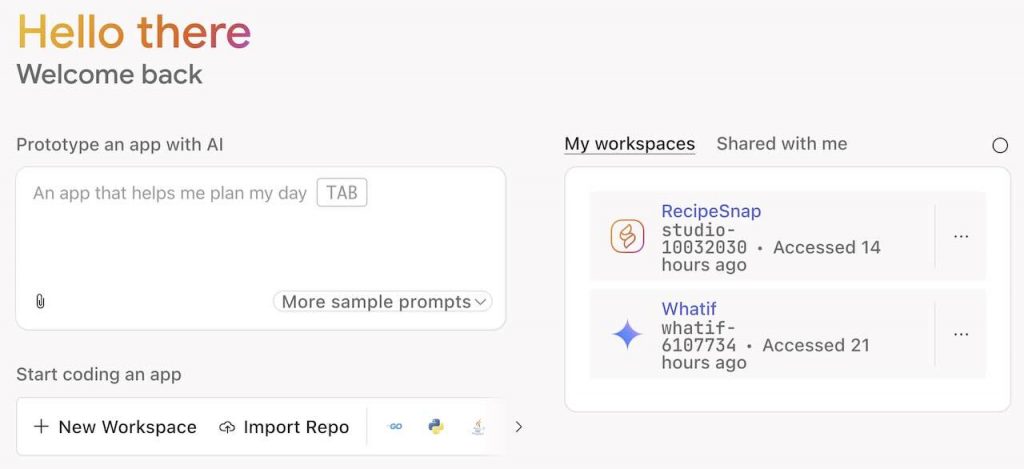
Google Firebase Studio 的目標是盡量簡化開發流程,就算你是剛剛開始學寫 App 也不用擔心。只要你有基本了解,Firebase Studio 可以透過 AI 助手 Gemini 幫你寫 Code、Debug 同埋改善效能。完成了之後,無論是全方位的應用程式,抑或 API、後台、前端同埋手機 App,佢都可以幫你自動整合發佈。測試期間,你可以擁有 3 個的免費工作空間。

Google Firebase Studio 的目標是盡量簡化開發流程,就算你是剛剛開始學寫 App 也不用擔心。只要你有基本了解,Firebase Studio 可以透過 AI 助手 Gemini 幫你寫 Code、Debug 同埋改善效能。完成了之後,無論是全方位的應用程式,抑或 API、後台、前端同埋手機 App,佢都可以幫你自動整合發佈。測試期間,你可以擁有 3 個的免費工作空間。

Firebase Studio: 9 Must See Features (FREE to Use)
Categories: Agentic, Gemini, 線上服務, IDE

Explorer 生成式三維世界

Odyssey 公司開發的「Explorer」,一個能將圖片轉換成逼真三維世界的生成式世界模型,強調「故事至上」的理念,如同 Pixar 的成功經驗,科技應服務於故事和說故事的人。Explorer 利用高斯點雲 (gaussian splats) 技術建構細節豐富的場景,並能與現有 3D 創作軟體整合,實現手動編輯的功能。目前 Explorer 應用於電影、遊戲製作的虛擬製作流程中,未來目標是實現即時世界生成,並拓展更多應用,文中也提及與 Pixar 共同創辦人 Ed Catmull 的合作,突顯其在該領域的領先地位和遠大抱負。

Odyssey 公司開發的「Explorer」,一個能將圖片轉換成逼真三維世界的生成式世界模型,強調「故事至上」的理念,如同 Pixar 的成功經驗,科技應服務於故事和說故事的人。Explorer 利用高斯點雲 (gaussian splats) 技術建構細節豐富的場景,並能與現有 3D 創作軟體整合,實現手動編輯的功能。目前 Explorer 應用於電影、遊戲製作的虛擬製作流程中,未來目標是實現即時世界生成,並拓展更多應用,文中也提及與 Pixar 共同創辦人 Ed Catmull 的合作,突顯其在該領域的領先地位和遠大抱負。

Categories: 線上服務

MMAudio 自動配音效模型

Categories: 模型, Audio, 聲效

Page 49 of 55
1 … 47 48 49 50 51 … 55