Holo-World 把天氣與鏡頭控制放進影片生成

Holo-World嘗試用一張圖生成可控影片,同時處理鏡頭、物件移動與天氣變化。它瞄準的是世界模型裡最難兼顧的一致性問題。

Repository image for XiangchenYin/Holo-World

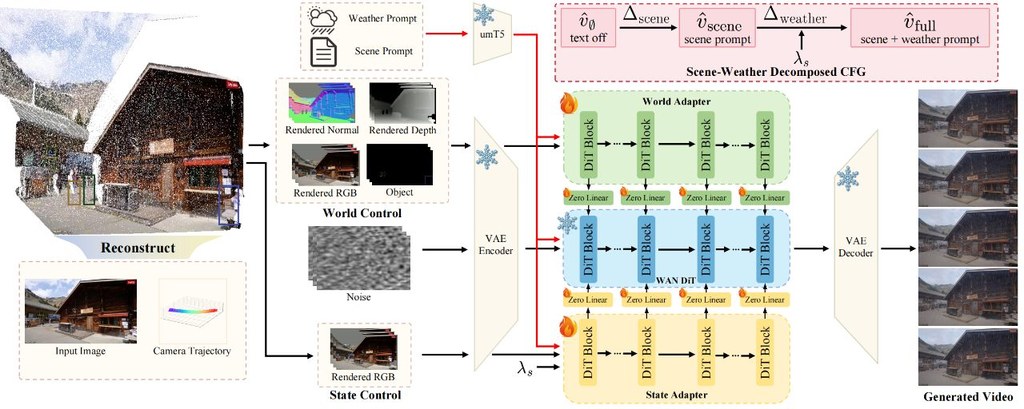
Holo-World 是一個Video World Model項目,目標不是單純把靜態圖片變成短片,而是由單張首幀出發,按照指定的鏡頭路徑、物件動態與天氣指令生成影片,盡量保留原本場景結構。對一般讀者來說,可把它理解成「你先給一個世界起點,再要求系統改變拍攝方式與天氣,但不要連場景骨架都改走」。

它和常見影片編輯做法的分別,在於不少方法要先有來源影片,甚至依賴已經包含未來結構的重建場景;Holo-World 則強調 first-frame-anchored source-to-state 設定,只由一張圖開始。這種取向更靈活,但難度也高,因為模型要自己補出後續畫面,同時維持鏡頭控制、物件位置和天氣效果不互相打架。

這個項目核心包含 HoloStateData、Unified Scene Adapter 與 Scene-Weather Decomposed CFG。前者是為相機、物件、天氣建立統一監督樣本的資料集;後兩者則把「場景保持」與「天氣轉換」分開處理,目的是減少下雨、下雪、起霧時把整個場景細節一併沖散的情況。論文與項目頁提到,量化與視覺結果都顯示它在 weather-state generation 上優於 video-to-video weather editing baselines,但目前倉庫內容仍偏研究展示,未見完整安裝與推理流程,較適合先當作研究方向理解。

  • 可由單張圖片出發,而非必須先提供完整來源影片
  • 同時控制 camera、object、weather,比單一條件生成更完整
  • 重點取捨在於維持場景結構一致,同時讓天氣效果夠明顯
  • 較適合研究 world model、可控影片生成、合成場景模擬的團隊

如果你關心自動駕駛模擬、生成式影片控制,或想研究世界模型如何把幾種控制訊號整合,這個項目很有參考價值。相關模型與組件可留意 Holo-World 本身,以及資料集 HoloStateData;從現有資料判斷,它現階段更像研究型模型與方法展示,未必是即裝即用的生產工具。
GitHub: https://github.com/XiangchenYin/Holo-World

項目: https://xiangchenyin.github.io/Holo-World/

Categories: 開源, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 工具, 庫, 中國

ImageWAM 用圖片編輯做機械人決策

ImageWAM把世界動作模型改成圖片編輯思路,嘗試避開影片生成的高成本。對機械人控制研究者來說,這個方向幾有啟發性。

Repository image for yuyangalin/ImageWAM

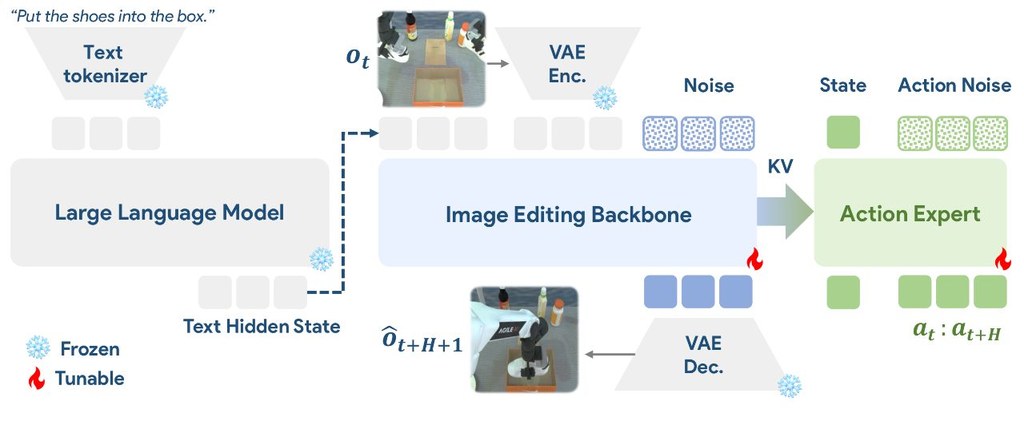
ImageWAM 是一個模型訓練與評測項目,核心目標是用 image-editing foundation models 取代傳統 World Action Models (WAMs) 常見的影片生成流程,處理機械人動作預測又慢又重的問題。它的判斷很鮮明:與其生成一段未來畫面,不如直接從「當前影像 + 指令」抽取足夠的動作線索。

這項目把圖片編輯模型的中間表徵拿來做 robot action prediction。根據項目頁資料,ImageWAM 推論時不一定要解碼出編輯後影像,而是使用單次 image editing forward step 產生的 KV caches,再交給 action expert 生成未來動作,方向上比多幀影片預測更輕量。

先看 FLUX.2 ImageWAM,因為倉庫已表明它是主力版本,並提供 4B 與 9B 變體。之後再按手上資料與算力,準備本地 datasets、pretrained weights、ActionDiT 初始化權重,然後在 LIBERO、LIBERO-plus 或 RoboTwin 這幾個基準環境做訓練與評測。

這個方向不只是概念實驗。項目頁列出 RoboTwin 2.0 為 93.38%、LIBERO 為 98.4%、LIBERO-Plus 為 83.1%,並提到可節省 4.1× FLOPs、推論延遲加速 84.7%。這些數字很吸引,但始終以作者公開的實驗設定為準,若換成不同機械人平台或資料分布,表現仍要再驗證。

  • 支援多個相關模型:FLUX.2 ImageWAM、OmniGen2 ImageWAM、Ovis-U1 ImageWAM
  • FLUX.2 提供 4B 與 9B 版本,Ovis-U1 走較細模型路線
  • 適合機械人控制、world modeling、action prediction 研究與基準測試
  • 重點不是生成漂亮畫面,而是抽取對動作決策有用的變化資訊

整體來看,ImageWAM 不算面向一般用家的 AI 工具,更像給研究者與工程團隊驗證新路線的開源項目。若你關心 world action models 是否一定要靠影片生成,這個項目提供了一個相當具體,而且有基準成績支持的反例。

GitHub: https://github.com/yuyangalin/ImageWAM

項目: https://zhangwenyao1.github.io/ImageWAM/

Categories: 開源, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 影像模型, 影像處理, Robotic, 工具, 庫, Dataset 數據集

SSync 用選擇式蒸餾改善影片物件分解

SSync 針對影片物件分解常見的對齊成本高、訊號互相拖累問題,提出更精準的學習方式。它不是改整套架構,而是補強 slot-based 方法的弱點。

SSync

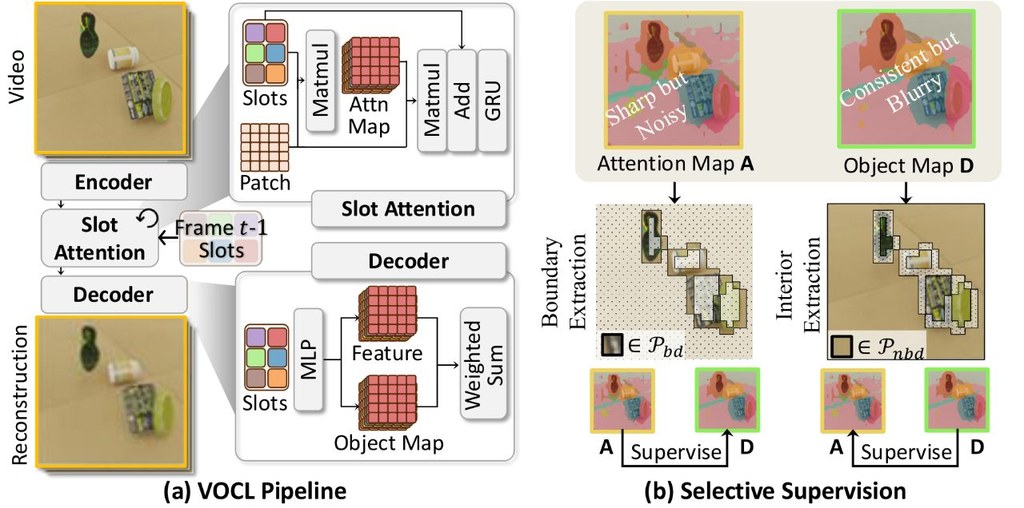
現有的 video object-centric learning(VOCL)多數沿用 slot-based frameworks,通常建基於 reconstruction-driven encoder–decoder architectures:encoder 產生 attention maps,decoder 產生 object maps,再嘗試把兩者對齊。近年的 dense alignment strategy 會對所有 spatio-temporal patches 做 contrastive learning,但這種全對全對齊會把 encoder 的雜訊和 decoder 的模糊邊界一併放大,計算量亦會升到 quadratic complexity,影片一長就更難擴展。

SSync(Selective Synergistic Learning)屬於一個可插入現有流程的 PyTorch 學習模組,目標是改善影片中的物件分解質素。它不是強迫所有 patch 全面一致,而是只挑選較可信的訊號做 mutual-distillation:用 encoder 幫手修邊界,用 decoder 清理物件內部雜訊,方向相當明確。

這項目把「全部都對齊」改成 selective distillation,並透過 pseudo-labeling 把成本降到 linear complexity。作者亦加入 transitive pseudo-label merging,處理 slot redundancy,將時序上反覆重疊的 slots 合併,減少模型把同一物件拆成多份的偏差。

如果你本身有研究 Slot Attention、影片分解、無監督物件發現,這項工作相當值得細看;如果你只是想快速試概念,亦可直接留意作者提供的 PyTorch implementation、Hugging Face 權重和 project page。它屬於 plug-and-play module,較適合已有 VOCL 基礎模型的人接入比較,而不是給完全零基礎讀者當成獨立應用程式。

  • 核心問題:dense alignment strategy 計算昂貴,亦會傳播 encoder 與 decoder 各自的錯誤
  • 核心方法:Selective Synergistic Learning 只蒸餾可靠線索,分開處理 boundary refinement 與 interior denoising
  • 結構補強:加入 transitive pseudo-label merging,減少 slot redundancy
  • 論文聲稱:可提升 decomposition quality,並對 slot configurations 有較強 robustness
  • 相關技術詞:VOCL、slot-based frameworks、Slot Attention、mutual-distillation、pseudo-labeling

整體來看,SSync 的價值不在於另起爐灶,而是在既有 slot-based video learning 範式上,直接指出 dense patch alignment 的兩個痛點:錯誤傳播與計算擴張。對研究型讀者而言,這比單純再堆模型容量更有意思;對工程導向團隊而言,它也提供了一個較容易插入現有項目的改良方向。

GitHub: https://github.com/wjun0830/SSync

項目:https://wjun0830.github.io/SSync/

Categories: 開源, 模型, 視覺模型, Video, 框架, IDE, Python, 編程, 深度學習

MiniMax-M3:開源多模態模型新選擇

MiniMax-M3 已在 Hugging Face 上公開下載。這模型聚焦多模態輸入與模型部署整合。

Og image

MiniMax-M3 是 MiniMaxAI 放上 Hugging Face 的模型。主要提供模型推理,image、video、tool_call 及 think 等標記,顯示它很可圍繞多模態互動、工具調用與對話生成能力而設計。

這項目的用途是把文字、圖片或影片訊息放進同一套模型流程中處理。

值得關注的在於它不只像傳統文字模型那樣處理純文字,還預留了工具調用與多種內容標記格式。對開發 Agentic workflow、聊天助理、內容理解流程的人來說,這類設計可減少自行定義輸入格式的工夫,亦方便把不同媒體資料放進同一條處理鏈。

重點可先看以下幾點:
– 支援 image、video 等多模態標記
– 具備 tool_call 結構,適合工具調用場景
– 可用於聊天、內容理解與自動化互動流程

若你是開發者、研究者,或想找可整合多模態能力的模型,MiniMax-M3 有一定參考價值。至於效能、模型尺寸、硬件需求與基準測試,暫時未有完整列出,使用前宜先核對 Hugging Face 頁面的更新資訊。

項目: https://huggingface.co/MiniMaxAI/MiniMax-M3

Categories: 開源, 模型, 多模態模型, Video, Image, MiniMax

ActWorld 讓世界模型學懂互動

ActWorld不只可移動視角,亦能在生成過程中操作物件。它把導航與互動放入同一個 Interactive World Model。

Og image

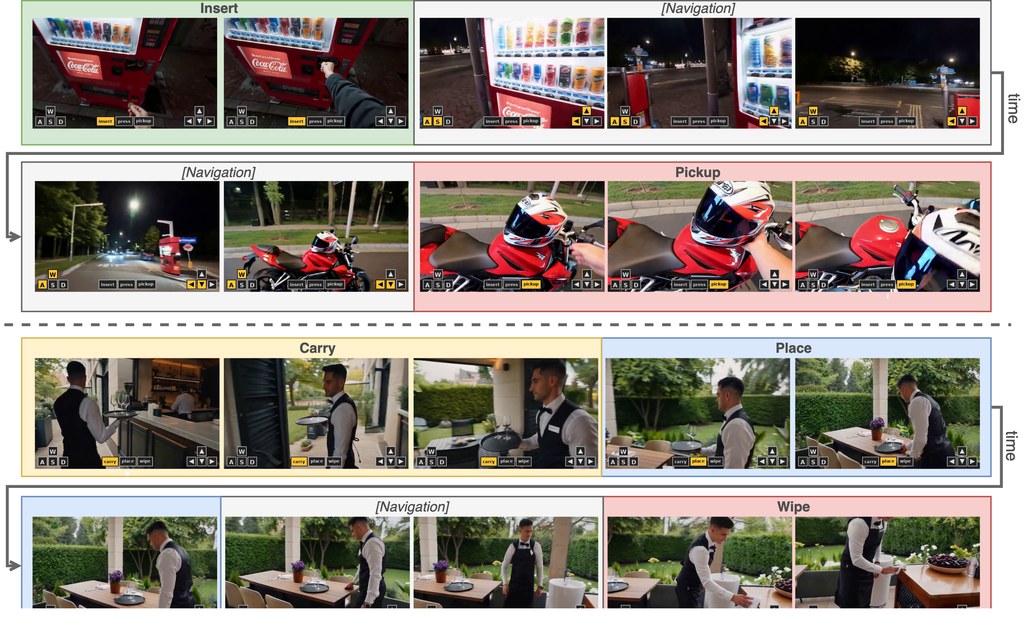
ActWorld 是一個 Interactive World Model,目標是把「可四處觀看的世界」推進到「可以即時操作的世界」。以往不少世界模型主要支援移動、轉向、環視等導航動作,對場景中的物件互動支援有限;這個項目則加入中途操作物件的能力,例如拾取、搬運、放置,令同一次 rollout 不只是在場景中行走。

這個項目想處理兩個核心問題:一是缺少高質素的人與物件互動數據,二是模型容易忘記早前發生、但會影響之後物件狀態的關鍵畫面。為此,團隊建立了 100K interaction video dataset,並以 chain-of-thought reasoning 產生 per-chunk captions;同時提出 hierarchical action-aware memory 和 persistent memory bank,讓模型按互動重要性保留歷史資訊,減少 action-forgetting。

使用時,讀者可先從項目頁面的 Paper、Code、Video 和 Comparisons 了解能力範圍。從內容描述判斷,ActWorld 適合研究 Interactive World Model、Computer-use agents(CUAs)相關模擬環境、機械人互動、或需要長時序場景生成與控制的團隊參考。

  • 在單一模型內同時處理 long-horizon navigation 與 object interaction
  • 透過 100K interaction video dataset 補足互動數據不足
  • 用 hierarchical action-aware memory 保留較重要的互動歷史
  • 以 persistent memory bank 追蹤事件更新與物件身份

按頁面說明,實驗結果顯示它在不犧牲 viewpoint control 的情況下,interaction fidelity 明顯優於只做導航的 baseline。現階段公開資訊以研究展示為主,若想深入理解效果,最應留意 Comparisons 及論文中的評測設定與限制。

項目: https://interactwm.github.io/ActWorld/

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Dataset 數據集

UniAR 用一個 Transformer 包辦看圖、作圖、改圖

UniAR 針對多模態模型常見的雙 tokenizer 分裂問題,改用單一視覺 tokenizer。這個方向同時瞄準理解、生成與編輯三種影像任務。

teaser

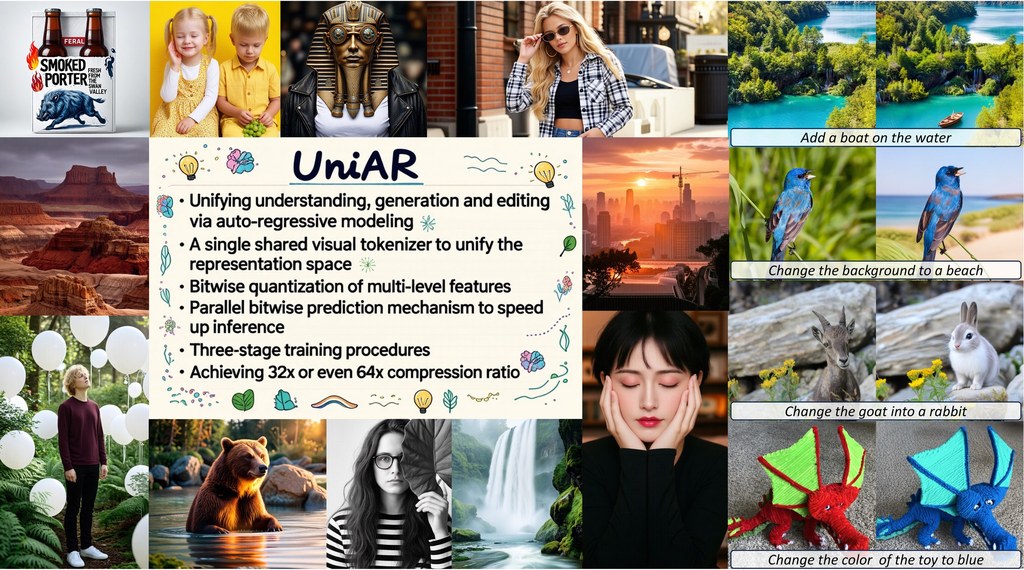
現有 Unified Multimodal Models(UMMs)多數會把影像理解和影像生成分開處理,常見做法是用兩套 visual tokenizers。作者認為這種 fixed paradigm 會把表示空間拆開,模型生成完圖片後,還要再重新編碼才能理解自己剛產生的內容,shared context 也就難以真正成立;UniAR 因此提出一個 unified autoregressive framework,用單一 discrete visual tokenizer 連接理解、生成與編輯。

項目屬於多模態模型,目標是用同一個 Transformer 解決 image understanding、image generation 和 image editing 之間來回切換的成本。它的核心判斷很直接:若模型看圖與作圖共用同一套視覺 token,流程就不需要額外 re-encoding,系統結構會更一致。

技術上,UniAR 有幾個辨識度很高的設計。Multi-level BSQ tokenizer 把高層語意與低層細節一併保留,並透過 Binary Spherical Quantization 擴大有效 vocabulary;parallel bitwise prediction 則把視覺碼以分組方式一齊預測,令 autoregressive 長序列壓短,論文提到 1024×1024 影像只需 256 個 AR tokens,對應 32x visual compression ratio。

  • 單一 discrete visual tokenizer 取代雙 tokenizer 架構
  • 支援 image understanding、image generation、image editing 同模運作
  • Multi-level BSQ tokenizer 同時顧及語意與細節
  • parallel bitwise prediction 壓縮視覺序列,加快 autoregressive 生成
  • DiT-based visual decoder 以 discrete visual tokens 重建高保真影像
  • 需求:Python 3.12、CUDA 12.1+、推理的 GPU 記憶體 >= 24 GB

如果你想試這個項目,較合理的切入點不是直接拿來當日常工具,而是先看它公開的模型權重與項目頁,分開測理解、生成、編輯三類輸出是否一致。它較適合研究多模態統一架構的人、關注 Qwen 生態的開發者,以及想比較 autoregressive 與 diffusion 混合路線的讀者。

性能方面,原文聲稱 UniAR 經 large-scale pre-training、supervised fine-tuning 和 reinforcement learning 後,在 image generation 與 image editing 達到 state-of-the-art,同時在多模態理解 benchmark 保持競爭力。不過目前公開資訊較像研究成果展示,visual decoder training code 仍未完整放出,因此更適合拿來理解方法論,而不是立即評估成成熟生產工具。

相關模型與組件包括 SD3-medium visual decoder、Qwen Team 背景下的多模態模型路線,以及論文聚焦的 Unified Multimodal Models(UMMs)。若你在意的不是單次生成效果,而是模型能否「理解自己生成的內容」,UniAR 的 shared context 設計確實提出了一個有意思而且相當具體的答案。

GitHub: https://github.com/ShareLab-SII/UniAR

項目: https://sharelab-sii.github.io/uniar-web/

Categories: 開源, 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 框架, Vibe Coding, 工具

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

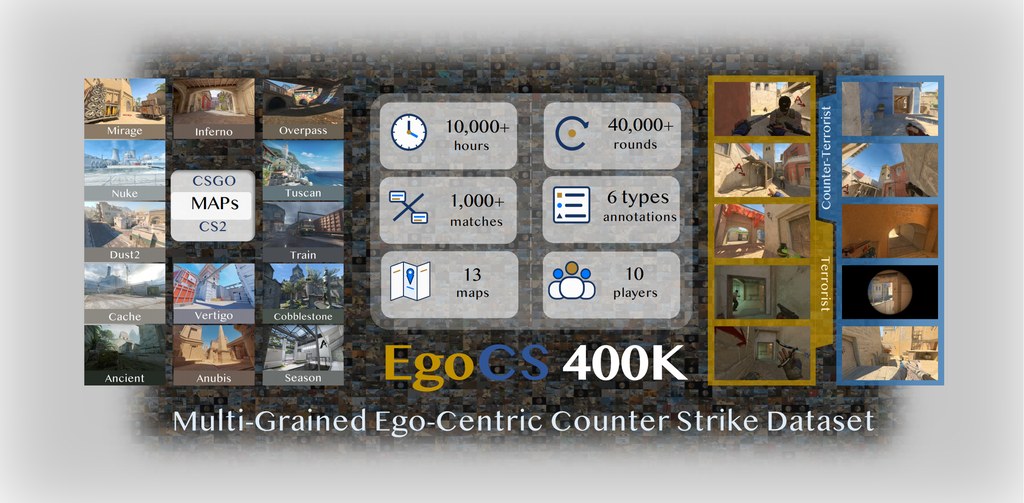
現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, 庫, 動畫, Dataset 數據集

SeeQ 讓 VLM 學識自己出視覺問題

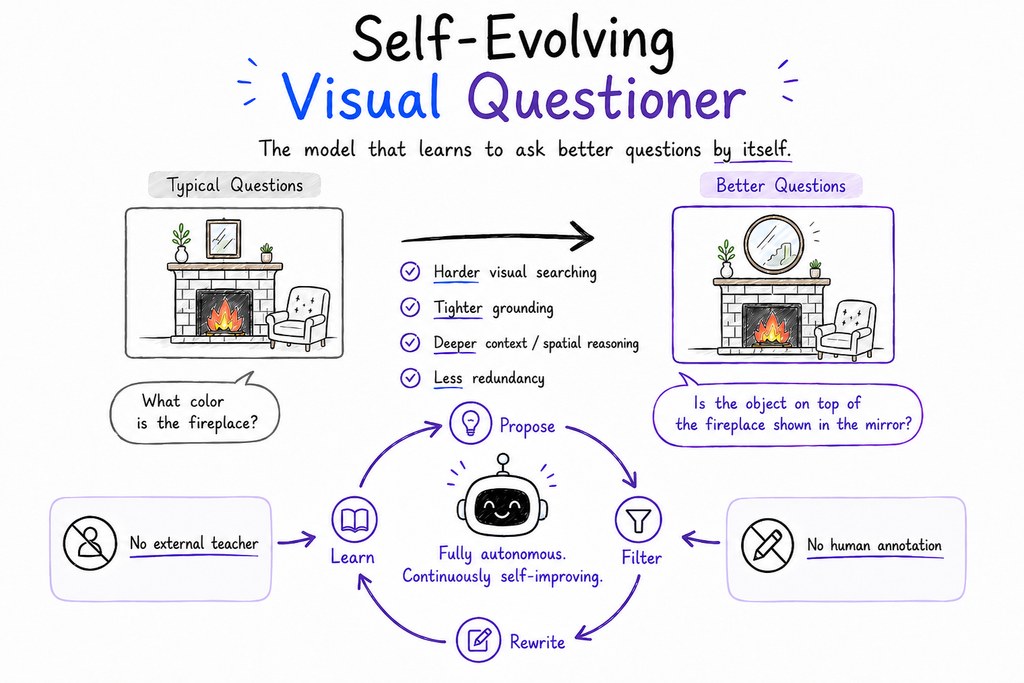
這個項目聚焦 Visual Question Generation,想解決高質視覺提問數據昂貴又難擴充的問題。它用自我演化流程,令 VLM 由答題者變成會主動發問的系統。

Cover Figure overview

現有 Vision-Language Models(VLMs)多數按「被動答題」範式訓練:人類或外部模型先提供問題,模型再學習回答。論文認為這種 fixed inputs 做法受制於靜態資料分佈,Visual Question Generation(VQG)亦容易卡在標註成本高、題目深度不足這兩個瓶頸,所以 SeeQ 提出 Self-Evolving Visual Questioner,用同一個 VLM 同時做 proposer 與 filter,自動從未標註圖片生產更難、更貼近畫面內容的問題。

這個項目屬於框架兼研究型工具,重點不是再做一個普通題庫,而是建立完整流水線:先生成 seed questions,再反覆改寫,提升 visual search、context 與 spatial reasoning 要求,之後再由模型自行過濾。作者同時加入 exploration diversity 控制,目標是避免訓練一路收窄,最後只剩單一風格題目。

如果你想試,較合理的做法是先準備圖片對應的 JSON 輸入,再分開看 generation 與 evaluation 兩部分輸出。倉庫內沒有附模型權重、數據集與快取,評測亦會用到 image-capable OpenAI evaluator 與 Qwen embedding models,所以較適合已經有 VLM 環境、想驗證自動出題流程的研究者或多模態團隊。

  • 以未標註圖片開始,自動生成、改寫、過濾視覺問題
  • 保留 Agentic evaluation,從 visual search、evidence coverage、context、spatial reasoning 評分
  • 另用 Qwen embedding models 檢查整體多樣性,不只看單題質素
  • 強調 zero external supervision,不依賴人工標註或 GPT-4V 這類外部 teacher models

創新點在於它不單止用 VLM 產生問題,還把「提問能力」當成可自我增強的訓練訊號,並且把 questioner 與 answerer 兩種模式一起考慮。按論文說法,這套方法在多個 backbone VLMs 上都能提升問題質素,亦把自動出題的難度邊界推高;同樣預算下,比直接用靜態來源資料訓練更有效,而模型的 answerer 能力亦未有明顯犧牲。

相關模型與元件方面,倉庫內容顯示生成流程可配合 Qwen2.5 3B 類型設定,評測會用 OpenAI 的可看圖評估器,以及 Qwen embedding models。若你關心多模態訓練、合成數據、或想建立能自己發問再自我改良的 Agentic workflow,SeeQ 的方法論比單純看分數更有參考價值。

GitHub: https://github.com/tianyi-lab/SeeQ

Paper: https://arxiv.org/pdf/2606.13929

Categories: 阿里巴巴, Agentic, AI productions, RAG, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, OpenAI, Image, 框架, 工具, IDE, Python, 庫, Dataset 數據集

TVEdit:文字與點拖軌跡合一的圖片編輯項目

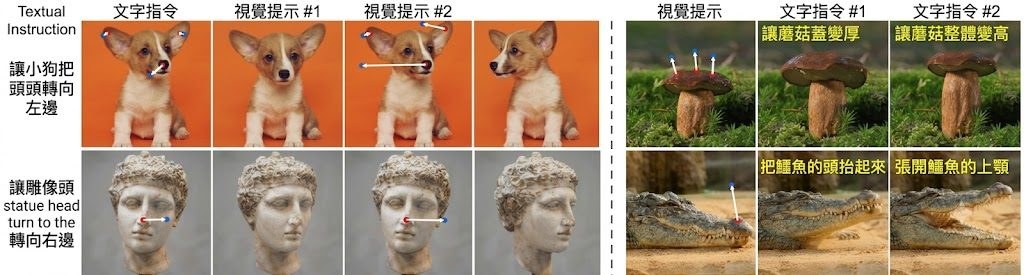
TVEdit 把文字意圖同視覺軌跡一併建模,令圖片編輯更準確。它亦自建評測,檢查語意、位置同畫面一致性。

TV-Edit Gradio demo

TVEdit 是一個圖像編輯項目,目標是解決「只靠文字講意思,或者只靠拖點講位置」都不夠準的問題。以往文字指令較易表達語意,但難控制空間;點拖軌跡可以指位置,卻容易令語意變得含糊,所以作者把兩者合併成 Text-Vision Co-Instructed Image Editing。

這項目的做法是用一個文本與視覺指令配對資料集來訓練,資料超過 23K 筆,來源與動態影片有關。再配合 TV-Edit 框架,把拖曳或點選等視覺指令轉成更有語意的控制表示,然後接到預訓練編輯骨幹上,例如 Qwen-Image-Edit。

它能同時處理「想改成什麼」與「要改到哪裡」,而不是只偏重其中一邊。作者另外建立了 TV-Edit-Bench,專門看語意忠實度、空間對齊同畫面一致性,這比一般只看最終效果的做法更能反映模型有沒有真正聽懂指令。

先載入 Qwen-Image-Edit,再配 TV-Edit 權重,之後在 Gradio 介面上上傳圖片、畫出軌跡、輸入文字指令,再調 CFG 同步數生成結果。若有加速 LoRA,步數可以大幅減少,適合想快速試驗互動式編輯的人。

  • 結合文字語意與點拖軌跡,令空間控制更細
  • 用 23K+ 配對資料補足跨模態指令訓練
  • TV-Edit-Bench 同時看語意、位置、畫面一致性
  • 目前已提供推理程式、模型權重同網頁示範
  • 適合做互動式圖片編輯、研究評測或模型整合

GitHub: https://github.com/PolyU-VCLab/TVEdit

Paper: https://arxiv.org/pdf/2606.16767

Categories: 開源, 香港理工大學, 阿里巴巴, Agentic, RAG, MCP, 模型, 視覺模型, 模型訓練, Qwen, Image, 影像模型, 影像處理, 框架

Memento:把長片段角色一致性補回來

Memento 針對多鏡頭長影片的角色走樣問題,改用記憶重建去約束生成。它把連貫性和身份一致性一起處理,適合故事式影片生成。

Teaser

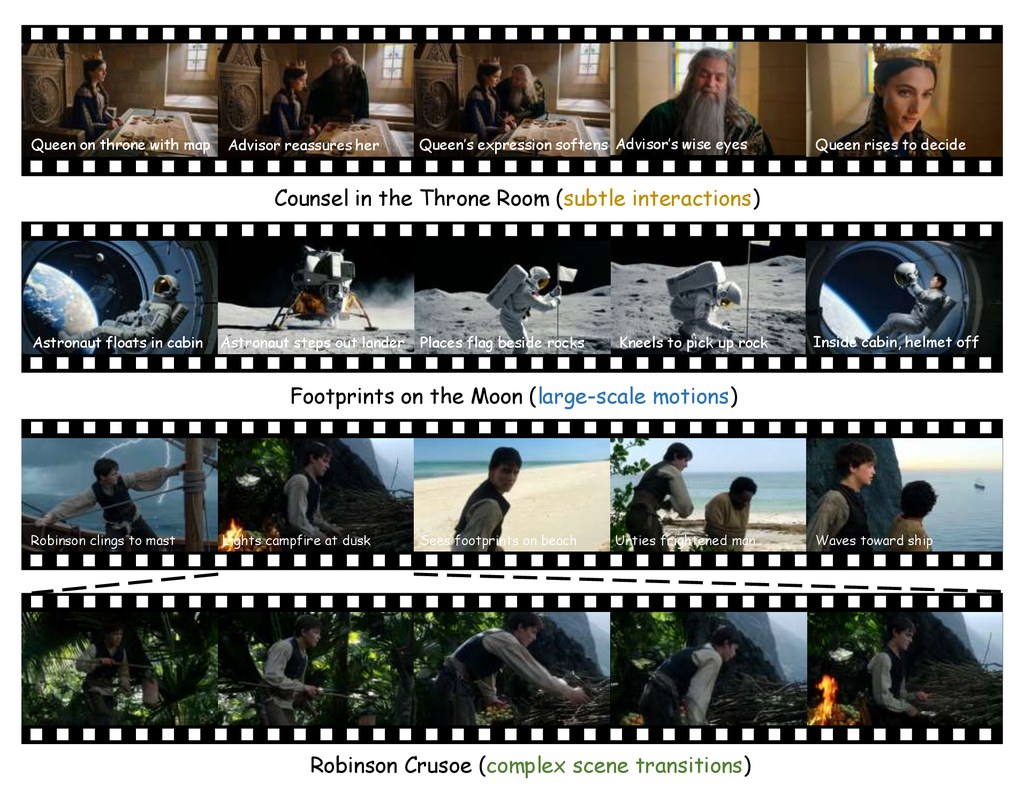
Memento 是一個影片生成框架,重點解決長篇、多鏡頭故事影片中角色外觀容易前後不一致的問題。傳統做法多半只顧下一段鏡頭看起來合理,Memento 則把「能否從記憶重建角色」當成身份是否被保留的檢查方式。

它的做法是把全局故事描述、每個 shot 的文字提示,連同歷史記憶一起送入生成流程,逐鏡頭自回歸地產生影片。使用時可準備對應格式的 JSON 故事腳本,再配合提供的權重與基礎模型做推理;項目也支援訓練與輸出完整影片。

GitHub: https://github.com/ernie-research/Memento

項目: https://ernie-research.github.io/Memento/

Categories: 開源, Agentic, 模型, 視頻模型, 模型訓練, Video, 框架, 庫, 百度

Page 47 of 55
1 … 45 46 47 48 49 … 55