Breeze TTS 2 即時語音生成

Breeze TTS 2 主打即時語音互動,兼顧聲線設計、聲線模仿與低延遲串流。它把自然語言指令和參考音訊結合起來,令語音生成更靈活。

Og image

Breeze TTS 2 屬於 text-to-speech(TTS)模型,核心目標是把即時語音互動做得更自然,並同時處理聲線模仿、聲線設計和語氣控制。它基於自然語言指令,既可以用參考音訊去保留聲線特徵,也可以不靠參考音訊直接設計聲音,這令使用場景比一般單一路徑的 TTS 更廣。

模型權重只限研究與非商業用途,而原始程式碼則採用 Apache 2.0,這表示權重與程式碼的授權條款並不相同。

Breeze TTS 2 支援 Voice Clone、Voice Design、Voice Direction,同時提供 Vocal Events,讓使用者可在文字中加入 (laugh)、(cough) 之類的表現指令。頁面亦強調它有 ultra-low-latency streaming,適合需要即時回應的對話式語音互動。

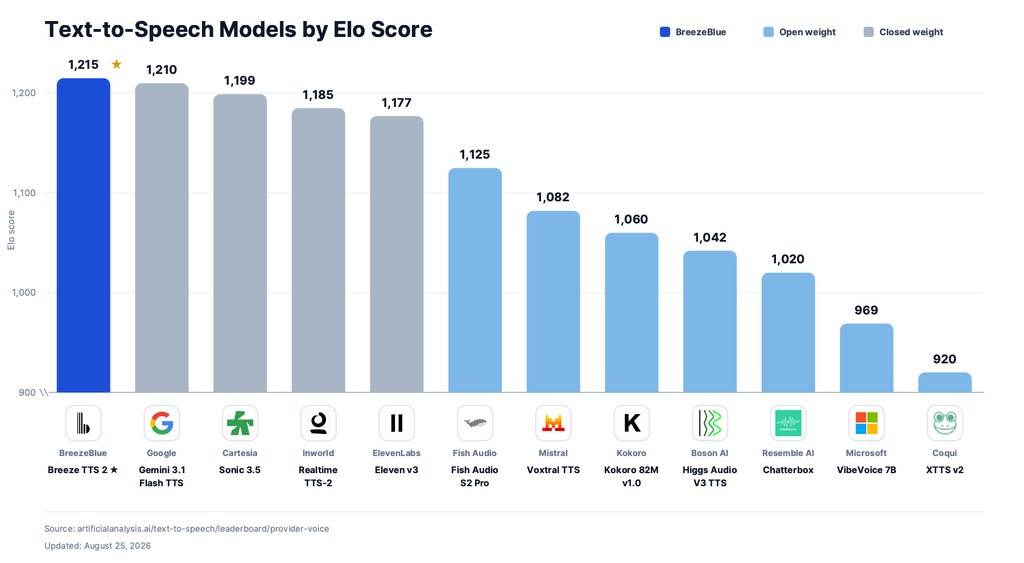
重點主要集中在功能和評測定位,沒有提供 GGUF 檔案、mmproj、量化版本、檔案大小,亦未提到 llama.cpp、Ollama 或 LM Studio。只見到它在 Artificial Analysis TTS leaderboard 排名第一,並聲稱表現超越部分閉源前沿系統;但由於頁面未展示完整測試細節,較適合把它視為一個以互動延遲、可控性和聲線表現力作賣點的語音模型。

  • 支援參考音訊模仿,也支援純文字描述生成新聲線
  • 可以用文字內嵌事件控制笑聲、咳嗽等表現細節
  • 主打低延遲串流,適合即時語音互動
  • 權重屬研究與非商業用途,授權限制要先看清
  • 頁面未提供量化、GGUF 或本地推論框架資訊

模型

Categories: 開源, 文字轉語音, 模型, 語音

ReFlowSET 影像翻譯模型,衛星影像新標準

ReFlowSET瞄準 SAR 影像難讀這個老問題,唔再沿用 latent diffusion model 的天花板。它用高保真 latent 空間配合 flow matching,換來更快取樣同更穩定畫質。

Repository image for KAIST-VICLab/ReFlowSET

落雨、夜晚甚至雲層遮擋時,Synthetic Aperture Radar(SAR)仍然影到地表,但訊號雜訊同幾何外觀都令判讀門檻偏高。ReFlowSET 屬於影像翻譯模型項目,處理的是 SAR-to-EO image translation:把 SAR 影像轉成較接近光學 Earth Observation(EO)影像的表達,方便人看,也方便接到後續視覺流程。

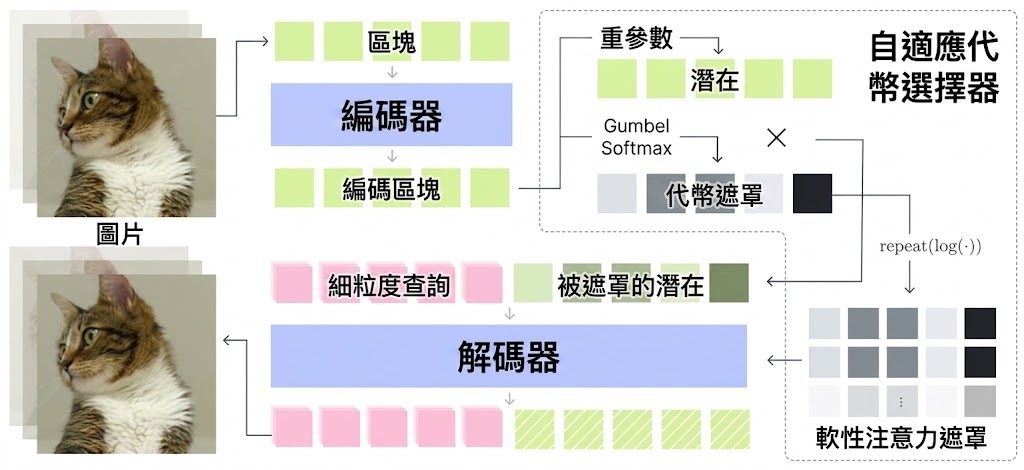
它沒有沿用常見的 latent diffusion model 微調路線,而是保留凍結的 FLUX.2 autoencoder,改用從零開始訓練的 conditional flow-matching transformer。這個選擇直接避開舊方法受限於原有 autoencoder 重建上限的問題,同時把生成放進較高保真的 latent space 內處理;代價是主體模型仍然相當大,DiT 達 509M 參數,訓練門檻不算低。

訓練時,模型會根據 SAR latent 去預測由隨機噪聲走向 EO latent 的線性 flow velocity,並加入 representation alignment,將中途特徵對齊到凍結的 DINOv3 ViT-L/16 teacher。呢個 teacher 同 REPA projector 只在訓練期間使用,推理時會移除,所以正式生成流程比訓練結構簡潔,亦解釋到它點樣兼顧語義對齊同推理效率。

項目在 QXS-SAROPT 與 SAR2Opt 上,團隊把十五種早前方法放到同一 protocol 同 evaluator 之下重訓比較,ReFlowSET 取得兩個資料集最佳 DISTS,並在 SAR2Opt 拿到最佳 FID 與 LPIPS。它亦提供四步取樣設定,速度約比五十步版本快 11 倍,較適合想測試 SAR 轉光學可視化、遙感分析前處理,或研究生成品質與延遲取捨的團隊。

  • 以 frozen FLUX.2 autoencoder 加 conditional flow-matching transformer 重建 SAR-to-EO 流程
  • 用 DINOv3 ViT-L/16 做 representation alignment,但 teacher 不會帶入推理
  • 在 QXS-SAROPT 與 SAR2Opt 拿到最佳 DISTS,SAR2Opt 亦有最佳 FID 與 LPIPS
  • 四步取樣版本大幅縮短生成時間,適合做速度與畫質折衷測試
  • 已公開 PyTorch 實作、論文預印本與預訓練模型,較適合研究型團隊直接驗證

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Image, Python, Dataset 數據集

KATok 教影片 VAE 自己丟 Token 減運算量

Kakao 開源 KATok,一個會根據內容自動決定保留多少 token 的影片 VAE,靜態畫面用得少,動態場景留得多,省下的算力直接交給下游擴散模型。

Repository image for kakao/KATok

KATok 處理嘅係影片生成入面一個常見但少有人拆開嚟解決嘅問題:傳統影片 VAE 用固定壓縮比,無論係一張幾乎唔郁嘅定鏡,或者主體快速移動嘅場面,每段都會被切成同一個 token 數。呢種做法喺靜態片段上明顯浪費頻寬,令擴散模型要做好多無意義嘅工作。

佢嘅做法係喺 transformer VAE 嘅 latent bottleneck 加一個可學習嘅 keep-or-drop 決策,對每個 token 估計要唔要保留,仲會一齊學 latent 表示。遮罩同時控制 latent 值同 decoder 嘅注意力,decoder 用 coarse-to-fine 結構由稀疏 token 重建細節,因此 token 數變成內容嘅結果,而唔係預設參數,亦唔需要推理時搜索。

喺 Panda-70M 256²×16 設定下,平均 366 個 token 就可以達到 31.24 PSNR 同 5.12 rFVD;喺 UCF-101 嘅稀疏生成實驗中達到 61.53 gFVD,比 dense transformer tokenizer 訓練快 6.9 倍。代價係當 token 被丟棄後空間佈局會被打亂,所以佢哋仲設計咗 cascaded mask prior 同 joint content–position 變體,幫下游擴散模型補返結構。

值得留意嘅重點:

  • 自適應 token 化,內容決定 token 數,無需推理時搜索或人手調參
  • 喺 Panda-70M 用 366 個 token 達到 31.24 PSNR / 5.12 rFVD
  • UCF-101 稀疏生成快 6.9 倍訓練速度,質素達 61.53 gFVD
  • 提供 inference code 同權重(仍在內部審核),訓練碼暫未開源
  • 直接用 PyTorch SDPA 即可行,安裝簡單

如果你嘅團隊需要處理大量冗餘嘅影片片段,又想慳運算量畀下游生成模型,呢種由內容決定 token 數嘅做法比起單純壓解像度更貼近問題本質。

項目主頁 · GitHub

Categories: 開源, Image, 推理引擎

Lucida:用「解析、生成、放置」三步把實景變成可編輯的模擬場景

字節跳動 Seed 團隊把真實室內環境拆解成獨立物件資產,透過閉環姿態修正讓重建結果能直接用於模擬。

Og image

從一段真實拍攝的室內影片,要還原成可以模擬、可逐個編輯嘅場景,一直都係 3D 重建嘅痛點:擺位、遮擋同殘缺幾何往往令資產難以重用。Lucida 就係針對呢個矛盾提出嘅方案,屬於實景到模擬(real-to-sim)類嘅場景建模系統。

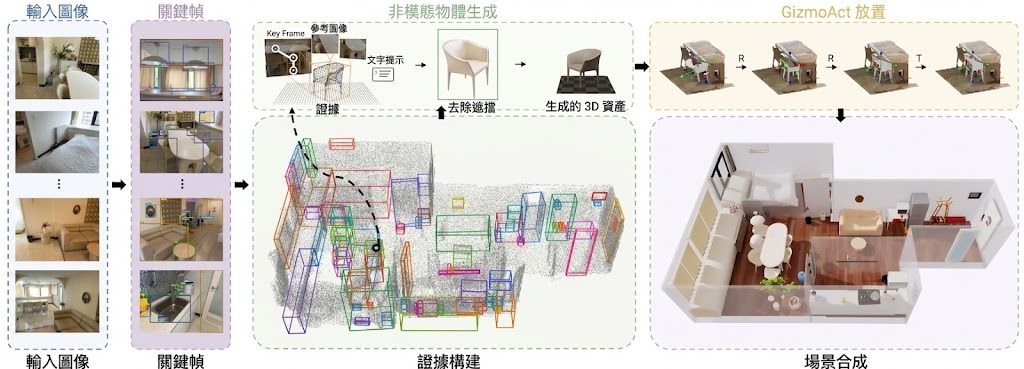
整個流程分成三步。第一步 Parse 揀選有用嘅關鍵幀,跨視角對應實例並建立場景圖,輸出遮擋、局部點雲同參考視圖等證據。第二步 Generate 利用每組證據合成無遮擋嘅物件影像,再提升成完整、可編輯嘅 3D 資產。第三步 Place 先粗略初始化,再用 GizmoAct 喺閉環中反覆執行姿態編輯,直到渲染結果同觀察對齊。

GizmoAct 係呢套系統嘅核心控制器,由視覺語言模型(VLM)操作 3D 編輯器,每一步根據渲染觀察、點雲疊加同正交視圖等線索,落一個可執行嘅姿態修正。同一條策略可應付由 Boxer、Any6D* 到 SAM 3D 等不同初始化,並以最多 4 個視圖同 12 步修正完成對齊。

Lucida 喺 R2S、CA-1M 同 Aria Digital Twin 數據集上都提升咗場景級 3D 物件檢測、姿態估計同完整場景重建指標。重建出嚟嘅場景以一組獨立、可編輯嘅 mesh 呈現,每件物件都準備好進入模擬階段。

對從事機器人模擬、室內數據合成或場景理解嘅團隊,呢套閉環做法比起傳統單次擬合更能容忍幾何誤差同遮擋問題,令實景資產更易直接落落去模擬器使用。

重點摘要

  • 三步流程:Parse、Generate、Place 把實景拆解成可重用物件資產
  • GizmoAct 閉環修正:VLM 操作 3D 編輯器,反覆落姿態編輯直到對齊
  • 初始化容忍度高:同一策略兼容 Boxer、Any6D*、SAM 3D 等不同起點
  • 輸出可直接模擬:每件物件係獨立、可編輯 mesh
  • 多數據集提升:喺 R2S、CA-1M、Aria Digital Twin 都有指標改進

項目主頁

Categories: 北京大學, 字節跳動, 視覺模型, Video, Image, 3D

GeoNeXt 把影片生成模型當幾何學習:統一深度與法向量估計

GeoNeXt 把現成的影片生成模型改造成單一架構,同時預測單目深度與表面法向量;只需五萬九千筆訓練樣本,就能做到跨場景的零樣本遷移。

GeoNeXt framework

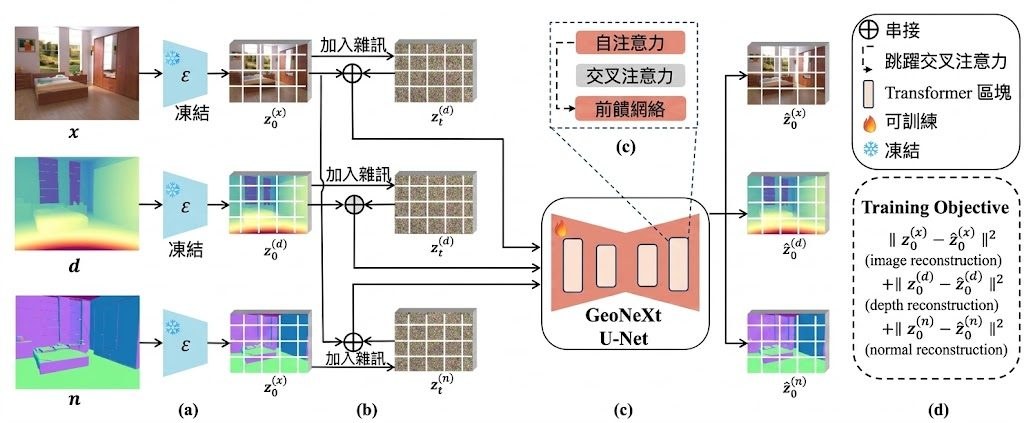
過往要從一張 RGB 影像同時取得深度圖與表面法向量,往往要靠兩個獨立網路串接,幾何一致性也容易在接縫處走樣。GeoNeXt 的切入點是把這些幾何訊號當成影片生成模型的「下一幀」:以 Stable Video Diffusion 為骨幹,把 RGB、深度、法向量一起送進 VAE 潛空間,在同一條去噪軌跡上共同生成,讓外觀與幾何從訓練開始就互相對齊。

兩個權重版本都放在 Hugging Face:GeoNeXt-Wan 約 1.42B 參數,GeoNeXt-SVD 約 1.52B 參數,兩者都能輸出深度與法向量。本地跑推論需要一張 24 GB VRAM 的 CUDA GPU,並透過 Conda 建立獨立環境;首次執行會自動從 Hub 下載所需的 checkpoint、base model 與 VAE,之後會從本地快取載入,因此斷網或重複測試時可直接用 –checkpoint、–base-model、–vae-model 指向本地檔案。

從應用角度,3D 重建、AR/VR 場景理解、機器人視覺等需要一致幾何的工作流都會受惠;研究員也能把它當作零樣本基準,與 GeoWizard 等專用模型直接比較深度、法向量及重建網格品質。

重點摘要:

  • 新意:把幾何估計重新表述為影片模型的下一幀預測,讓 RGB、深度、法向量共享同一條去噪軌跡。
  • 規模:以 Stable Video Diffusion 為基礎,提供 Wan 與 SVD 兩組約 1.4B–1.5B 參數的權重。
  • 數據效率:只用 59K 訓練樣本,就在多個基準上做到強健的零樣本泛化。
  • 硬體門檻:24 GB VRAM 的 CUDA GPU 即可推論,兩個版本需分開建立 Conda 環境。
  • 差異:相比串接兩個專用網路,單一模型同時輸出深度與法向量,有助於改善跨通道的一致性。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 世界模型, Video, Robotic, 3D, Dataset 數據集

ComfyUI-FL-MiniMaxH3 時間軸節點

這套 ComfyUI 節點把 MiniMax H3 的提示詞、音訊與影片生成整理成可重拍、可分鏡及可組裝的時間軸工作流。

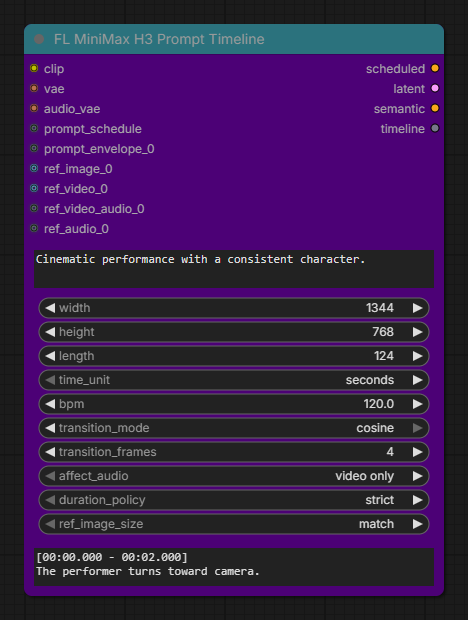
想控制影片每一秒出現甚麼畫面、配合節拍切分鏡頭,或者只重做其中一段而保留其餘內容,FL MiniMax H3 提供的是一套 ComfyUI workflow nodes,實際處理 MiniMax H3 影片與音訊 latent 的時間軸編排、取樣和合成問題。

核心節點會建立原生的 nested H3 video/audio latent 及 prompt conditioning。你可以手動設定 timeline,亦可接入 FL PROMPT SCHEDULE;系統支援以秒、frame 或 beat 安排提示詞,並把 H3 image、video、video audio、soundtrack 及獨立 audio reference 編碼到同一條可重用時間軸。

FL MiniMax H3 Prompt Timeline

與先將資料攤平再處理的流程相比,項目保留 MiniMax H3 原有的巢狀影片及音訊結構,並提供 native latent upscaling,調整影片 latent 的高度和寬度時毋須經過 VAE 往返。需要更細緻修整時,pixel-space refinement 才會執行 decode、resize、re-encode,再於指定 sampling-step window 內細化結果。

  • 可按節拍規劃獨立或明確分組的 shots
  • 支援 frame-exact temporal reshots,只重生成指定區間
  • 可把上一個 render 的 authored tail 作為 hard-cut motion context
  • 內置 sampler previews,並可按時間軸組裝最終影片

使用者需要已有節點所需的 H3 text encoder、video VAE 和 audio VAE;適合需要精確控制分鏡、重拍範圍和聲畫結構的 ComfyUI 創作者及影片工作流程,而非用作性能比較。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, MiniMax

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

四步生成同步音畫:FastH3 預覽模型拆解

非官放加速 MiniMax FastH3 以四次 Transformer forward 生成同步影片與音訊,但需要專用 VSA-H3 後端及多張高階 GPU。

Og image

文字提示輸入後,FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree 可在四次 Transformer forward 內生成同步影片與音訊,適合測試快速 text-to-audio-video 工作流程。模型明確基於 MiniMaxAI/MiniMax-H3 微調及蒸餾,並以 data-free DMD2 和 VSA-H3 訓練至 step 1300,在 90% sparsity 下換取較少取樣步驟。

模型需要 FastVideo 的 VSA-H3 attention backend,不能只下載權重後以一般推論工具直接執行。官方測試配置使用四張 B200 GPU;其他多 GPU CUDA 系統可改用 Triton kernel,但 GPU 數量必須能整除 H3 的 56 個 attention heads。頁面沒有提供 llama.cpp、Ollama 或 LM Studio 支援,也沒有列出 GGUF 檔案、量化級別、檔案大小或 mmproj 附加檔案,因此不能據此建議 Q4_K_M 或其他量化方案。

  • 四次 forward 生成音訊與影片,速度取向明確
  • DMD2、VSA-H3 及 90% sparsity 用於 data-free 蒸餾
  • 目前只支援 text-to-audio-video,FL2VA 和 Ref2VA 尚未蒸餾
  • 困難動作、細節及部分音訊可能不及 MiniMax H3 base model
  • 頁面未提及 MTP draft speculation、v2 更新或檔名變更

這個 Preview checkpoint 仍可能在動態、細節和音訊穩定度上落後原始 MiniMax H3,定位較接近快速生成與研究測試版本。使用時要留意 MiniMax H3 Community License,以及 FastVideo 安裝流程對 CUDA 13、Blackwell 路徑和專用 kernel wheel 的要求。

模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, MiniMax

write-then-publish:自動 .md 排版成為圖文卡

寫完文章後,毋須再分別排版圖片、卡片和長文格式,這個項目把發布前的整理工作集中在同一個工作區。

写了就发全屏工作区,左侧是长篇文章编辑框,右侧是三列并排的九张图文卡片,第三张卡片包含真实视频截图

由寫作到發布,最花時間往往不是產生內容,而是重新分頁、整理圖片和適配不同平台格式。這個項目屬於內容製作工具,讓同一份 Markdown 正文同步輸出圖文卡片與公眾號長文,並保留原有結構,不會因為切換模式而改寫內容。

項目採用 Vanilla HTML/CSS/JS,亦提供本地運行方式。圖片支援上傳、貼上、拖放和批量導入,Wiki 圖片引用則可讀取 Obsidian 的 ![[圖片.png]]、![[附件/圖片.png]] 及標準 Markdown 圖片語法。瀏覽器獲得目錄權限後,Markdown 會寫回「寫了就發」,新增圖片則放到「寫了就發/附件/」;未能寫入時會降級為 Markdown 加附件 ZIP。

圖文卡片會自動分頁,標準輸出為 1728 × 2304 PNG;公眾號模式保留標題、列表、引用、程式碼、表格和正文圖片,亦可調整主題、字體、字號與主題色。Live Photo 透過 WebCodecs 處理,可按小紅書或公眾號設定片段時長、比例、裁剪及聲音,並按原始頁序批量下載。

  • 同一份正文切換兩種發布格式
  • 支援 Obsidian 雙向同步及附件整理
  • Live Photo 可剪輯、預覽及批量打包
  • 未授權目錄時提供 ZIP 降級方案
  • Supabase 登入模式以 Row Level Security 按 auth.uid() 隔離資料

項目不涉及生成模型,因此不會替作者寫稿或改寫內容,價值集中在發布前的排版與素材整理。內容創作者、經常維護 Obsidian Vault 的作者,以及需要同時經營公眾號和圖文平台的小型團隊會較容易受益;macOS 本地版另可在配置完成後同步到公眾號草稿箱,但跨平台發布能力仍受瀏覽器權限和平台整合限制影響。

GitHub

Categories: 開源, Image, Mac, 安全

Breeze TTS 2:低延遲語音生成再推一級

Breeze TTS 2 把即時語音互動、聲線設計同語氣控制放埋一齊,主打低延遲同高可塑性。它較適合要做配音、語音代理或互動內容嘅團隊。

BreezeBlue

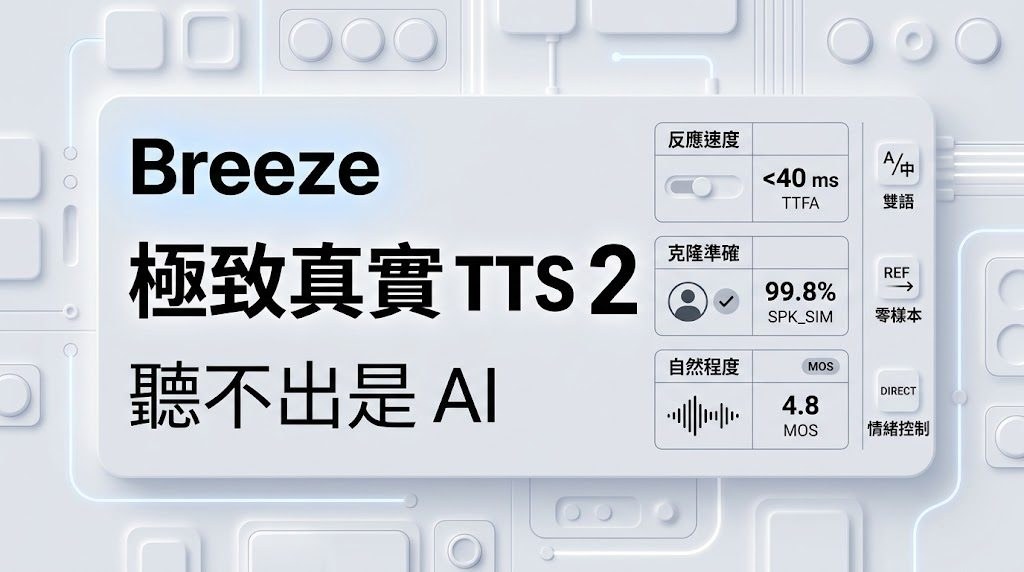
Breeze TTS 2 係一個文字轉語音(text-to-speech, TTS)模型,重點唔止係把文字讀出,而係處理即時互動入面最難平衡嘅兩件事:聲音要自然,回應又要夠快。佢支援 Voice Clone、Voice Design 同 Voice Direction,代表可以由參考錄音複製聲線,亦可以純靠自然語言描述去設計新聲線,再按指令調整語氣、節奏同表達。

對內容製作、語音代理、遊戲角色配音同多語言產品來講,呢種做法比單純 TTS 更有彈性。文本內仲可以插入 Vocal Events,例如笑聲、咳嗽、清嗓子呢類表情提示,令生成聲音更接近真人演繹,而唔係只係平鋪直敘讀稿。

項目資料顯示,佢喺 Artificial Analysis TTS leaderboard 排名第一嘅 open-weight 模型,亦聲稱喺部分測試中超越商業系統。低延遲係另一個賣點:warming 後喺 NVIDIA H100 可做到少於 40 ms 的 time to first audio,RTF 約 0.32,適合即時對話場景。

不過,repo 同時寫明模型權重、衍生模型同 self-hosted outputs 只限研究同非商業用途,呢點對想直接落地嘅團隊影響好大。代碼層面提供 PyTorch inference code,但原始資料未交代完整安裝流程或部署細節,較合理嘅理解方式係先把佢視為一個面向研究與產品原型驗證的高性能 TTS 模型。

  • 支援參考錄音複製聲線,亦支援純文字描述設計新聲線
  • 可以用指令調整語氣、情緒、語速同演繹方式
  • 低延遲串流適合即時語音互動同 voice agent
  • 在 open-weight TTS 基準中聲稱領先,但授權限制較嚴
  • 適合配音、互動內容、多語言語音產品同研究團隊

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, Agentic, 模型, NVIDIA, Audio, Clone, Python, 語音, Dataset 數據集

Page 25 of 55
1 … 23 24 25 26 27 … 55