ProVisE 用像素答案重做空間評測

空間理解唔一定適合用文字作答,ProVisE改咗評測入口,令圖像生成模型可以用畫、點、標記去答題。你會更易睇清楚,模型到底係唔識空間,定只係答題格式唔對。

ProVisE logo

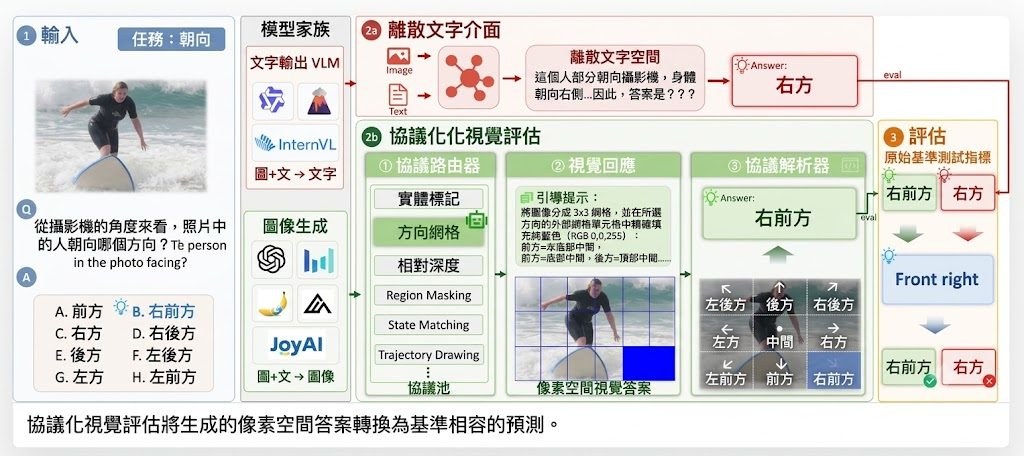
當一條空間題目本來應該用圈選、標記路徑或者遮罩去表達,硬要模型交出座標、選項字母或文字描述,結果往往唔係能力差,而係答題介面同模型表達方式錯位。ProVisE屬於評測框架,處理的正是呢個落差:它唔改原本 benchmark 任務本身,只改回應介面,讓圖像生成模型用像素空間交答案,再轉回 benchmark 可計分的結構化輸出。

現有 spatial benchmarks 多數沿用 text-only interface,假設所有模型都應該以 coordinates、option labels 或 textual descriptions 回答。作者認為這種固定範式會壓縮 regions、paths、affordances 呢類本身偏視覺的判斷,因此提出 Protocolized Visual Evaluation:先由 task-aware router 指派 visual protocol,再用固定 guidance prompt 同 parser 約束輸出,最後仍然交回 original benchmark metric 評分。Text-output VLMs 就維持原本答題空間,兩類模型可以在同一套任務語義下比較。

ZJU-OmniAI/ProVisE 在於把「模型唔識答」同「評測方法逼錯答案格式」分開處理。配套的 SpatialGen-Bench 收錄 470 個 curated samples,涵蓋 14 個 subtasks,同時分成 perception、understanding、reasoning、interaction 四個 capability levels;研究結論亦相當直接,image-generation models 在可把判斷外化成像素標記的任務上有競爭力,但 text-output VLMs 在另外一些題型仍然較穩定,兩者並非誰全面取代誰。

  • 保留原有 benchmark metric,只替換答案介面,方便同既有結果對照
  • 用 visual protocol 限制生成內容,減少任意畫圖帶來的解析歧義
  • SpatialGen-Bench 把空間能力拆成 14 個 subtasks,唔再只看單一總分
  • 適合研究 VLM、image-generation models、agent 空間理解能力的團隊採用

安裝門檻看來不高,程式環境以 Python 3.10+ 為主,並已公開 code、project page 與 Hugging Face 上的 SpatialGen-Bench。現階段它更像研究與評測項目,不是即插即用產品;重點也不在部署成服務,而是在你想驗證模型空間認知時,能否用更貼近模型輸出形式的方式做比較。對做多模態模型、視覺評測或 Agentic 系統的人來說,ProVisE提供了一個相當清晰的檢查角度。
項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, Image, Python, Dataset 數據集

VCSD 點樣逼可以 Vision-Language Models 真係睇圖

同一條問題配原圖同抹走內容嘅控制輸入,VCSD用兩次預測差異教模型分清邊啲答案真係來自視覺訊息。它瞄準嘅唔係加大模型,而係減少模型「冇睇圖都答到」嘅錯位。

Cover Figure overview

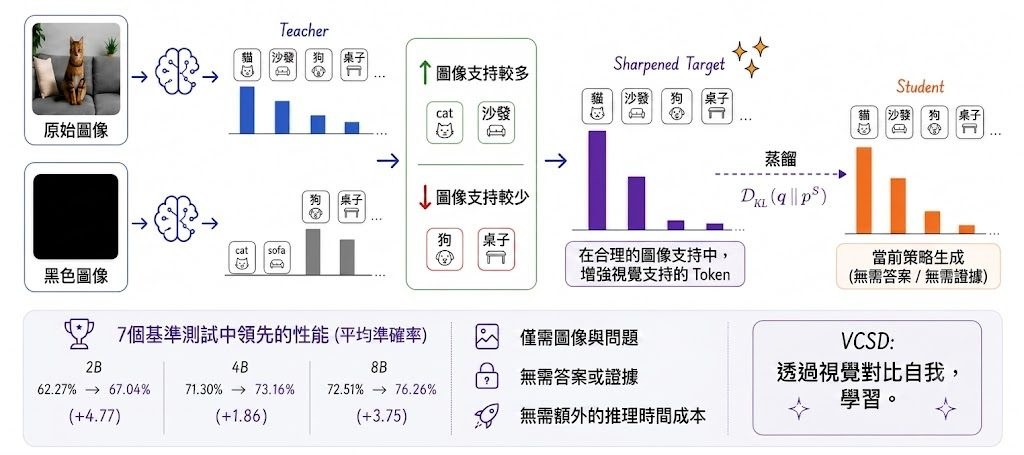
不少 Vision-Language Models 會表面上處理圖片,實際卻沿住語言慣性作答。VCSD 屬於模型訓練方法,針對嘅正正係呢種「答案似乎合理,但未必真係由圖像帶動」嘅問題:它讓同一個 EMA teacher 分別看原圖同內容被抹走嘅 control input,再用兩者對每個 response token 嘅分佈差異,提煉出更依賴視覺內容嘅學習目標。

現有 on-policy self-distillation(OPSD)多數靠 privileged answers 或 visual evidence 製造 teacher 比 student 更強嘅訊號,VCSD反過來把 image-content removal 變成非對稱來源。做法唔係直接獎勵某幾個字,而係用原圖分佈 p_hi 同控制輸入分佈 p_ctrl 嘅 log-probability 差,配合 α 調整對比強度,再用 β-plausibility mask 限制只喺 teacher 原本已視為可信嘅 token 集合內重新分配機率;README 亦講明 β 設成 0.0 會令訓練崩潰,代表呢個護欄唔係裝飾,而係方法成立嘅關鍵。

項目目前仍然係 work in progress,代碼、設定同文件都可能再改。倉庫已放出訓練資料格式線索,例如 train.parquet 需要 prompt 同 image 欄位,train_answer.parquet、val_answer.parquet 用作 answer-conditioned validation;訓練則建基於繼承自 verl 嘅 GRPO/PPO 流程,VCSD 相關改動集中喺 verl/trainer/ppo/vcsd.py、verl/workers/actor/dp_actor.py 同 actor 設定檔,表示它比較似可插入現有 RL 訓練管線嘅附加目標,而唔係一套獨立框架。

  • 核心取向係用 visual contrast 代替 privileged answers 或 visual evidence
  • 學生模型學習嘅係 full-vocab KL 目標,唔係逐 token 手動加權
  • control input 可設成 black、degrade 或 noimg,用來測試答案有幾多真係靠圖像
  • 已公開結果顯示,VCSD 在 ViRL39K 上對 Qwen3-VL 與 Qwen3.5 系列均比 matched OPSD 更好

從已公開數字看,Qwen3-VL 在七個 benchmark aggregate 上由 2B 的 62.27 升到 67.04、4B 由 71.30 升到 73.16、8B 由 72.51 升到 76.26,方向相當清楚:它想改善嘅唔係推理時計算量,而係訓練期間點樣把「圖片真正提供咗乜嘢」變成更乾淨嘅監督訊號。對已經有 Vision-Language Models RL 訓練流程、又想減少外部 teacher 與額外標註依賴嘅研究團隊,呢個項目值得跟進;不過現階段仍要接受文件未齊、介面可能變動,以及結果主要來自論文與項目頁面披露。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Image, VLA, Robotic, 框架, Dataset 數據集

TableVerse 想補上機械臂數據缺口

想訓練更能適應雜亂桌面嘅機械臂,最缺的往往唔係模型,而係夠真實又夠大量嘅場景數據。TableVerse 用 Real2Sim 把網上圖片整理成可模擬環境,方向相當清晰。

TableVerse main figure

機械臂要學會喺凌亂桌面執放物件,卡位通常唔在控制器,而在訓練資料太乾淨、太想像化。TableVerse 屬於Dataset 數據集加上資料生成流程,重點不是再用文字幻想場景,而是用 Real2Sim 從網上真實圖片重建可放進模擬器的桌面配置,直接處理泛化操作最缺的場景真實感。

現有做法常見兩條路:text-to-layout hallucination,或者較簡化的 procedural generation。作者批評前者容易做出物理上唔合理的擺位,後者又捉唔到人類日常環境常見的密集雜物;因此 TableVerse 改成 deterministic reconstruction,從非結構化的 in-the-wild image data 還原具備 metric scales、authentic topologies 同 verified mechanical stability 的場景,取向明顯偏向可落地訓練,而唔係只追求合成速度。

項目現時最重要的成果是 TableVerse-100K,公開了 100,000 個 physically consistent 的桌面環境,並配對 interactive manipulation trajectories。網站資料顯示,它還接上自動化 task-conditioned trajectory generation,先由 MLLM 根據場景視角提出 object-to-target 配對,再生成 collision-free pick-and-place demonstrations,令數據不只得靜態場景,亦包含可直接餵給操作策略學習的示範。

  • 以真實圖片重建桌面,而非只靠生成式佈局
  • 提供 100K 場景與 pick-and-place 軌跡,規模夠大
  • 強調物理一致性、機械穩定性與模擬可用性
  • 適合做 generalizable manipulation 與桌面操作研究

部署角度上,這個 GitHub 儲存庫目前更接近論文與資料入口,主要連到 arXiv、HuggingFace dataset 同項目網站,未見完整訓練或評測程式公開。換句話說,研究團隊現階段較可能把它理解為高品質資料來源與方法參考,而不是即裝即跑的機械臂框架;對做 robotic manipulation、模擬訓練數據建構,或者研究 Real2Sim 流程的人,參考價值很高。

項目主頁 · GitHub · Paper

Categories: 開源, 字節跳動, 多模態模型, Image, Robotic, Dataset 數據集

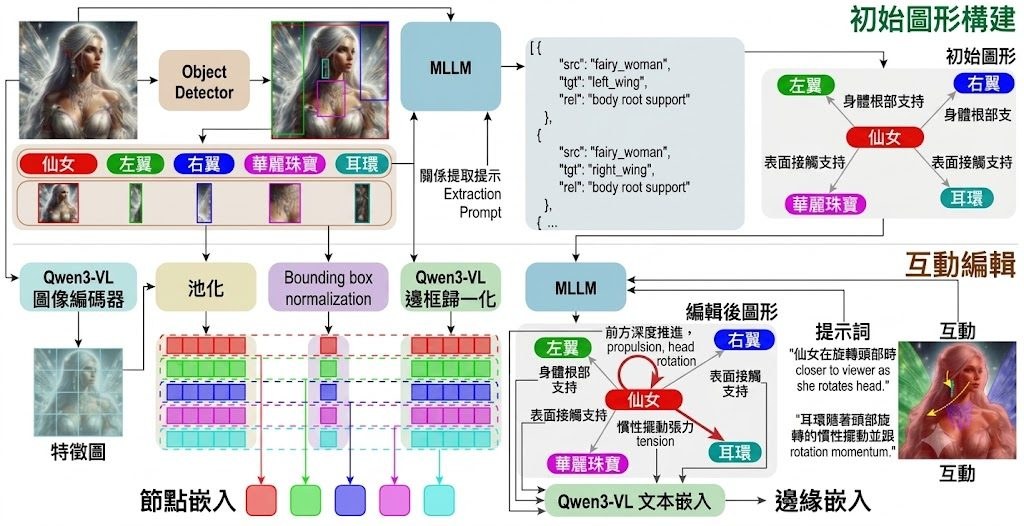
GraphVid 把圖生影片拆解成圖節點關係圖

GraphVid 用一張關係圖重新組織影片生成流程,讓畫面之間的動作轉折更像被刻意安排,而非逐格拼湊。

Og image

PLAN-Lab(伊利諾伊大學厄巴納-香檳分校)開源的 GraphVid 採用 Diffusers 框架,用 Stable Diffusion 類的 Diffusion Pipeline 配 bfloat16 精度載入,適用於 CUDA 與 Apple MPS 裝置。這個名稱裡的「Graph」不是社群網絡圖,而是把影片拆成多個關鍵畫面節點,再用一張小型關係檔 graph.pth(約 118 MB)描述節點之間如何銜接——模型先理解這些畫面該怎樣排序與過渡,再交由 transformer、VAE 等模組逐段生成。

頁面沒有公開 base model 來源,也沒有說明訓練資料或評測指標,因此難以判斷它的整體品質,只能從架構面推測它把控制粒度從「逐幀文字描述」轉移到「節點拓樸」。使用 DiffusionPipeline.from_pretrained 配合 torch_dtype=torch.bfloat16,屬於現今影片擴散模型常見的省記憶體做法。

從模型卡提供的程式碼範例可見,GraphVid 直接接受文字 prompt 即可生成畫面,毋須手動編排節點,這層抽象對一般使用者比較友善;進階用家則可透過 graph.pth 微調節點關係,控制運鏡節奏。整個 gvc_ckpt_folder 容量約 64.3 GB,包含 scheduler、text_encoder、tokenizer、transformer、VAE 等標準組件,搭配 Hugging Face 提供的 Colab / Kaggle 範例即可快速試跑。

  • 關係圖驅動:以 graph.pth 定義畫面節點與時序關係,再交由擴散模型生成影片。
  • Diffusers 相容:透過 DiffusionPipeline 載入,支援 bfloat16 與 CUDA / MPS。
  • Apache-2.0 授權:可自由下載研究與再分發,但頁面未提供量化版本。
  • 硬體需求高:完整 checkpoint 約 64.3 GB,建議使用高階 GPU。
  • 缺乏評測數據:原始頁面沒有提供基準分數或與其他影片模型的直接比較,採用前宜自行測試。

若以本地消費級 GPU 試跑,建議先把 torch_dtype 設為 bfloat16,並留意 VRAM 是否足以容納 transformer 與 VAE 的權重;想進一步壓縮,可留意社群後續是否釋出量化或 LoRA 版本。

項目主頁

Categories: 開源, Google, NVIDIA, Stable Diffusion, Image, 框架, 教學, Python, 蘋果

TrajLoc 把路線描述對準衛星圖

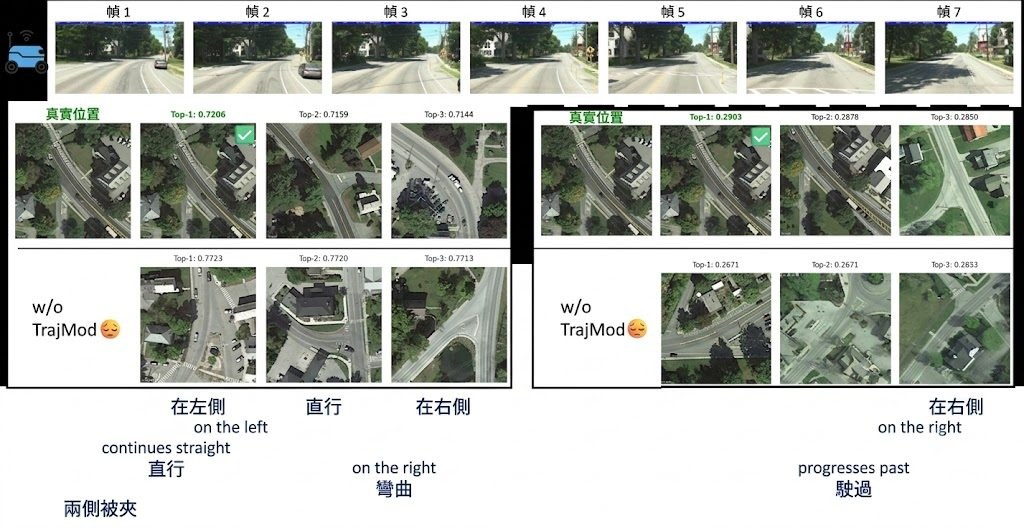
單張街景未必足夠判斷位置,TrajLoc改為沿住整段路線做比對。影片、文字敘述,甚至兩者一齊用,都可以指向同一塊衛星瓦片。

A trajectory can be queried as dense video or as abstract language — both retrieve the same satellite tile.

只靠一張街景相去配對衛星圖,遇到轉彎、路口相似、視角受限時好容易失手;TrajLoc改為追蹤整段移動路線,將街景影片、自然語言路線描述,或者兩者結合後對應到帶地理標記的衛星瓦片。它屬於跨視角 geo-localization 模型連同 benchmark 項目,處理的是「把連續路徑準確放回地圖」這個問題。

現有 cross-view 資料多數停留在 single-image、video-only 或 text-only 範式,作者認為這樣會拆散同一條路線入面本來互相補強的時序線索與語意線索,因此一併推出 SeqGeo-VL。呢個 benchmark 收錄 38,863 組對齊的 video-text-satellite triplets,並有 91.8% human verification pass rate,重點不是再加大資料量,而是把 sequential 同 linguistic 兩種證據放入同一任務。

TrajLoc沒有另起一套龐大時序架構,而是由 pretrained CLIP ViT-L/14 延伸成 video、text 同 satellite encoders,再用 co-training curriculum 將三種查詢模式放入同一個表示空間。作者另外加入 TrajMod,將路線幾何資訊 tau={(Δx_i, Δy_i, θ_i)} 轉成 FiLM 的 scale/shift 參數,直接調節 query embedding;做法比單靠提示詞更明確,亦保留 frozen encoders 的可重用性。

  • 支援 video、plain language、video+text 三種查詢方式
  • SeqGeo-VL 是首個同時包含 sequential 與 linguistic cross-view benchmark
  • TrajMod 只用 waypoint offsets 與 headings,不靠 map 或 POI metadata
  • 項目提供 agent-ready tool interface、persistent Python API 同 JSON CLI

從示範與說明看,TrajLoc的定位很清楚:它不是通用多模態聊天模型,而是給 spatial reasoning、戶外機械人、導航研究同 multimodal agents 調用的專門工具。225 ms 的示例檢索速度對互動式流程有吸引力,但目前公開資訊主要集中在 benchmark 與檢索能力,部署前仍要留意資料覆蓋範圍、地區泛化,以及自己的工作流是否真有影片或路線文本可供查詢。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, Embedding, 多模態模型, 模型訓練, Qwen, API, Video, Image, Python, Dataset 數據集

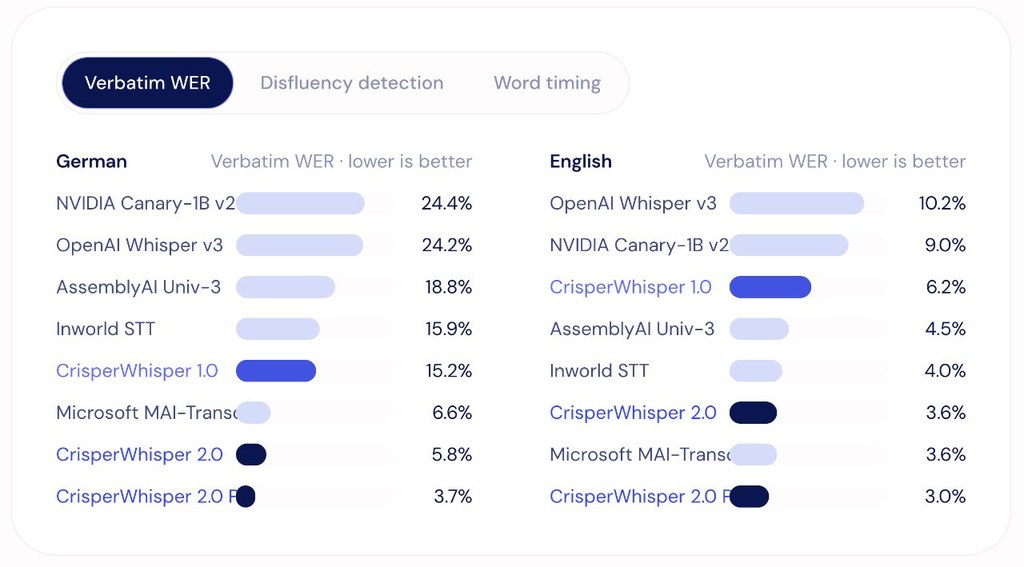
CrisperWhisper 把語音逐字稿變成可控制輸出

同一段錄音,可以要逐字保留停頓與口吃,也可以要乾淨可讀版本。CrisperWhisper 把語音辨識最常混在一起的兩種需求分開處理。

Repository image for nyrahealth/CrisperWhisper

做會議紀錄、訪談整理或臨床語音分析時,最大落差往往唔係辨識到幾多字,而係系統究竟寫出「講咗乜」定「本來想表達乜」。CrisperWhisper 屬於開源語音辨識模型項目,核心價值係將 verbatim 同 intended 兩種轉錄模式變成可明確控制的輸出,令逐字稿唔再受訓練資料風格左右。

呢個取向同一般 speech-to-text 系統好唔同。常見做法會不一致地刪走 filler、重複、停頓同 cut-off,CrisperWhisper 2.0 就刻意保留呢啲語音細節,或者按需要輸出整理後版本;同一段錄音可以得出兩份用途完全不同嘅文本。對做 TTS 資料整理、醫療或研究訪談分析、需要精準字幕時間碼嘅團隊,呢種分流比單純追求可讀性更有用。

項目另一個關鍵位係時間對齊同長音訊處理。它提供 word-level timings,讀稿語音平均邊界誤差約 30 ms,對話語音約 41 ms;長音訊則用 conditional continuation 避免一般分段轉錄常見嘅重複漏字。README 亦提到推理端基於 CTranslate2,配合 speculative decoding,同時減輕 Whisper 常見 looping-hallucination 問題,方向明顯係朝住 production inference。

  • verbatim 與 intended 兩種模式分開控制,適合同一錄音對應不同工作流
  • 支援 multilingual,覆蓋多數 Whisper 支援語言
  • 可用 Verbatimize 依據音訊加乾淨文本補回真實語氣詞與口誤
  • 長音訊轉錄著重連續性,減少 chunk 邊界造成嘅錯漏
  • Nyra Verbatim Speech Benchmark 以 disfluency F1 等指標衡量保真能力

安裝與部署方向相對清晰:模型可經 PyPI、Hugging Face 同文件使用,推理路線圍繞 CTranslate2 runtime,而唔係只停留喺研究展示。要留意嘅取捨亦好直接,當你要的是可讀、可發布文本,intended 模式更合適;當你要保留猶豫、重複、笑聲同語音事件,verbatim 模式先真正發揮價值。呢個項目唔係單靠更高 WER 成績去吸引人,而係重新界定逐字稿應否忠於說話表面形式,並且用 benchmark 將呢件事量化。

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, NVIDIA, Medical醫學, 語音, Dataset 數據集

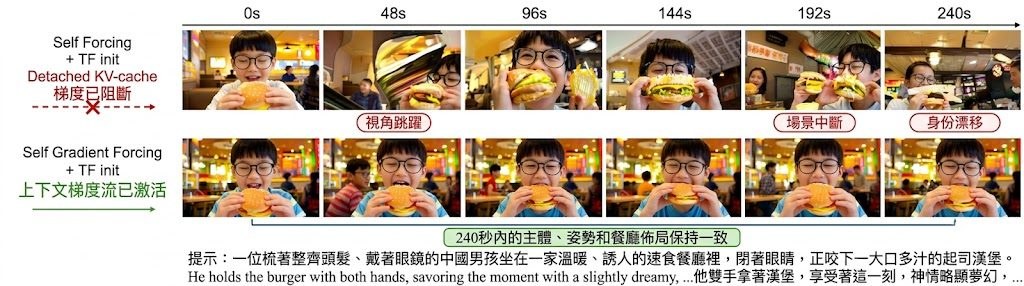
Self Gradient Forcing 補長影片一致性缺口

短片訓練、長片生成之間最易出事的,往往是角色走樣同場景漂移。Self Gradient Forcing想補上的,正正是長時間影片外推時失掉的記憶監督。

Self Gradient Forcing teaser

生成影片拉長到幾分鐘之後,角色樣貌、鏡頭方位同場景佈局愈來愈唔穩,往往不是畫質問題,而是模型早段寫入的歷史記憶愈來愈幫不到後面幀。Self Gradient Forcing(SGF)屬於訓練方法項目,核心是替自回歸影片擴散模型補回一段原本缺失的 context-gradient path,處理 long-video extrapolation 時常見的 identity drift、scene break 同 temporal instability。

作者點名現有做法多建基於 Self Forcing:模型用自己 rollout 出來的歷史作訓練,的確能減少 exposure bias,但 historical key-value cache 在後續生成裡只是 frozen rollout state,未能讓未來幀的損失回頭教早前的記憶應該怎樣寫得更有用。SGF 的做法是 bounded two-pass replay,第一輪先照推理方式無梯度 rollout,第二輪只重建抽樣步驟所需的 context-gradient,避開完整長序列反向傳播的成本,同時保住 causal memory 的可訓練性。

項目現時已放出訓練碼、推理碼同 checkpoint,底層接到 Wan2.1-T2V-1.3B 與 Wan2.1-T2V-14B,亦依賴 Causal-Forcing 的初始化權重。配置分成 framewise 同 chunkwise 兩路,預設推理可生成 963 個 latent frames,解碼後約 240 秒、16 fps,環境足夠時會用 8 GPUs,否則退回單卡串行生成;這個門檻說明它較接近研究與算力密集型內容生產流程,而不是輕量即開即用工具。

  • 針對 Self Forcing 的 historical context-gradient gap,而不是單純調參延長影片
  • 用 bounded two-pass replay 補監督,取捨在於訓練更複雜,但比全序列回傳梯度更可控
  • 同時提供 framewise 與 chunkwise 設定,方便比較不同長片生成路線
  • 依賴 Wan 基座模型與 Causal-Forcing 初始化,部署前要先備好對應權重

就已公開描述來看,SGF 的價值不在另起一套全新生成架構,而是在保留 native autoregressive training objective 的前提下,修正自生成記憶無法被未來損失有效監督的缺口。對研究 long-horizon video generation、需要單一 prompt 與 seed 維持數分鐘敘事一致性的團隊,這個項目有相當清晰的參考價值。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, 模型訓練, Video

Trace 用可驗證資料重做視覺推理訓練

想訓練視覺模型識得真係推理,而唔係靠題型記憶,Trace提供咗一套可重播、可核對的資料生成方法。它不只出題,連答案點樣得來都一併保留。

trace mark

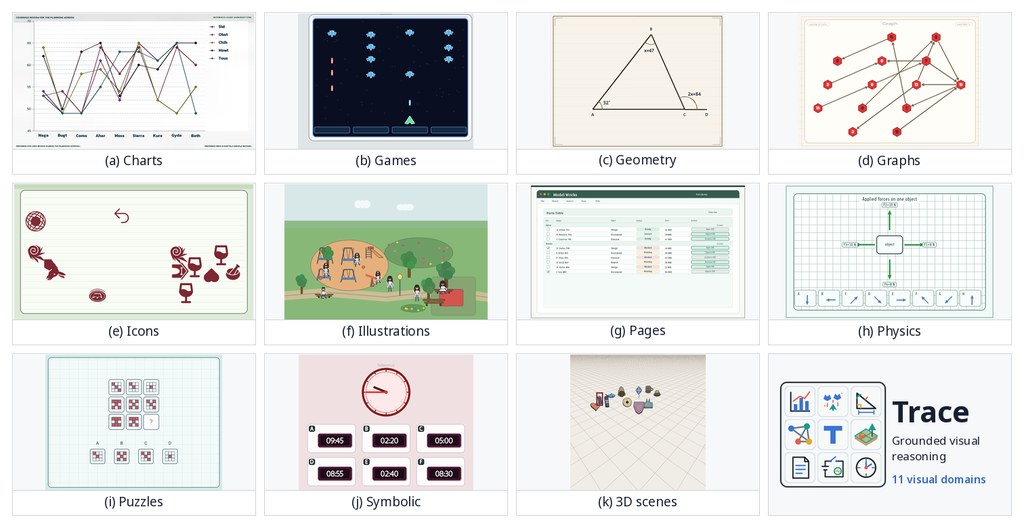
很多視覺推理資料集都只交付圖片同答案,模型答啱咗,未必代表推理過程真係站得住腳。Trace把重點放在可驗證 post-training:它屬於一個資料集兼生成環境,針對的問題是怎樣穩定產生 grounded visual-reasoning 任務,並且讓答案、標註與驗證流程互相對得上。

它採用一條很清晰的生成路線:domain → scene grammar → task program。現有做法常見是先有人手整理題目,或者由圖像與文字鬆散配對,再用最終答案做監督;Trace則用 deterministic seed 先建立 semantic scene state,再由 task program 從同一個狀態推導 typed answer、verifier state,最後才渲染圖片與提示。這種 shared-state 設計的分別,在於題目不是「生成完再補標註」,而是從源頭就把圖像、問題、答案同 execution trace 綁定。

對研究團隊來說,這個取向很有吸引力,因為它同時照顧訓練、檢查同重播。每個例子除了 image、prompt、typed answer,還有 image-space annotation、verifier metadata 同 execution trace;對想做 RLVR、後訓練驗證,或者想分析模型到底錯在觀察、計算還是規則理解的人,資料密度比一般 benchmark 高得多。

  • 收錄 11 個 visual domains、277 個 scene grammars、1,000 個任務
  • 已公開 66,000 個 generated examples,亦提供 Hugging Face dataset 與模型檢查點
  • 驗證不只看最終答案,還保留 verifier state 與 replayable execution trace
  • 以 Qwen2.5-VL-3B、Qwen2.5-VL-7B 做 post-training,兩個尺度都有明顯提升

數字上,它在 2,000 個未見過、但由同一批 task programs 生成的新例子上,將 Qwen2.5-VL-3B 由 24.45 提升到 41.05,Qwen2.5-VL-7B 由 34.25 提升到 51.55。這些結果首先說明 Trace對同分佈泛化有幫助;首頁亦提到用 64,000 個 Trace instances 訓練後,對 24 個外部 benchmarks 的 macro-average 也有改善,但摘要資訊未列完整分項,解讀時仍要看原始報告。

Trace最適合被理解為一個用來建構可核對視覺推理訓練資料的基礎項目,而不只是另一個出題庫。它的取捨也很明確:換來高度可驗證與可重播,代價是任務分佈由 scene grammar 同 task program 明確界定,較適合研究訓練方法、評測設計同模型行為分析,未必等同自然世界的開放式視覺理解。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 模型訓練, Qwen, DeepSeek, Image, Dataset 數據集

Voicebox 本地語音克隆完整工作台

想喺自己部機完成語音克隆、朗讀同聽寫,Voicebox 幾乎把整條語音 I/O 流程收進同一個桌面項目。它吸引人的地方,不只係多模型,仲有本地私隱同跨平台部署。

Voicebox

把語音克隆、TTS、聽寫同 agent 語音互動放埋一個桌面介面,正正擊中不少內容創作、無障礙輸入同 AI 工作流嘅痛點。Voicebox 屬於本地優先嘅開源語音工具項目,重點唔係單做一種聲音生成,而係將完整 voice I/O stack 放到 Mac、Windows 同 Linux 上運行,令模型、錄音同聲音資料都留喺自己部機內。

它最有競爭力嘅地方,在於把雲端常見嘅兩段流程合併:一邊做語音輸出,一邊做全域聽寫,仲可以接到 MCP-aware AI agent。對比只做 TTS 或只做 dictation 嘅服務,Voicebox 提供嘅係一個較完整工作台;代價亦明顯,本地推理對硬件、模型管理同快取安排有一定要求,想追求最省心體驗,未必比純雲端方案輕鬆。

支援面向相當廣,內建 7 個 TTS engines,包括 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 同 Kokoro,亦提供 zero-shot cloning 同 50+ preset voices。23 種語言加上後製效果,例如 pitch shift、reverb、delay、chorus、compression 同 filters,令它唔止適合做旁白,對要快速試聲線、做角色語氣、整理語音筆記嘅小團隊同個人創作者都幾有用。

  • 本地執行係核心價值,私隱敏感內容唔使上傳雲端
  • 一個項目包辦 voice cloning、speech generation、dictation 同 agent 語音介面
  • 支援多個 TTS engines,同一段內容可按聲線、語氣同語言需要切換
  • Chatterbox Turbo 可處理 [laugh]、[sigh]、[gasp] 等 paralinguistic tags,Qwen CustomVoice 可用自然語言控制演繹方式

安裝方式以桌面應用為主,官方已提供下載、文件同 troubleshooting,理解上接近本地 AI studio,而唔係單一模型倉庫。現有資料未見統一基準分數或嚴格 benchmark,對聲音相似度、延遲同穩定性,仍要視乎你選用邊個 engine、樣本質素,同埋會唔會改用 local or remote inference;但作為把多語音模型、克隆流程同輸入輸出控制整合起來嘅開源項目,它已經比只提供單點功能嘅工具更接近可長期放入工作流。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, Agentic, MCP, Qwen, Clone, Mac, Linux, 語音

Facial-Expression-Prompting:幫 AI 影片角色演得更可信的提示詞 Skill

想拍角色反應戲,但提示詞只寫到情緒名?這些 Skill 會把動機、微表情同鏡頭節拍補完整,令 AI 影片生成更似一場表演。

Repository image for zhouwei713/facial-expression-prompting

情緒寫得太粗,AI 影片角色往往只會交出一個「表情」,而唔係一段有起伏的反應。呢個 GitHub 項目定位好明確:它係一個為人物表演而設的提示詞 Skill,專門把模糊情緒拆成可拍、可生成、可放入文生視頻與圖生視頻模型的演出指令,處理的是角色點樣由看到事件、壓住反應,再慢慢洩露情緒。

最有用的地方不只是擴寫字數,而係先補足角色點解會有反應。它用五個問題建立因果鏈,再把眼神、眼瞼、眉間、嘴角、下顎、呼吸、姿態同聲音排成時間軸,連鏡頭、光線、時長同負面約束都一併整理。對 Seedance、Kling、Runway、Veo 呢類模型來講,呢種寫法比單一句「她很傷心」更容易生成連貫畫面。

同類做法常見是堆情緒形容詞,或者直接放大表情強度;呢個項目反而重視克制、遞進同角色自我控制,所以特別適合特寫、關係戲、對白反應同微表情場景。代價亦好清楚:它偏向劇情演出導向,唔係追求高速出稿的萬用提示詞模板,使用者最好本身知道角色處境,先能發揮得更準。

  • 支援完整視頻模式同表演片段模式,前者補全整段提示詞,後者可插入既有腳本
  • 適合 Seedance、Kling、Runway、Veo 等 AI 視頻模型
  • 重點唔在誇張表情,而在可見的情緒轉折、微表情同鏡頭配合
  • 會按表演節拍決定時長,而唔係固定把每段反應寫成同一秒數

這個 Repo 可理解成一個可直接複用的 Agent Skill/提示詞模板項目,而唔係獨立模型或推理服務。它較適合內容創作者、短片導演、角色動畫設計者,或者要反覆修改人物反應戲的團隊;當目標係令 AI 生成的角色「有心事」而不只是「有表情」,呢個項目的取向相當實用。

GitHub

Categories: 開源, Agentic, AI productions, Video, txt2img, 提示詞, Skill 技能

Page 36 of 55
1 … 34 35 36 37 38 … 55