OraRL:標註即 Rollout,統一多模態模型強化學習

OraRL 把影片標註轉成可靠的正向 rollout,令同一模型兼顧定位、分割、追蹤、問答與空間理解。

Animated OraRL method preview

面對一段長影片,模型要同時回答內容問題、找出時間片段、定位畫面區域,往往要在多套任務方法之間取捨。OraRL 是一個用於統一影片多模態模型(video MLLMs)強化學習的研究項目,將原本只用來評分答案的標註,序列化成模型可直接學習的 oracle rollout。

它的核心做法是把一條標註答案加入同一提示的 policy samples,再只用 policy rewards 計算 on-policy baseline,避免準確標註扭曲模型原本的相對比較;annotation-policy reward gap 則用於方向性修正,最後以 sign-balanced pruning 篩選更新訊號。這個安排保留探索,同時不需要 chain-of-thought supervision 或額外解碼。

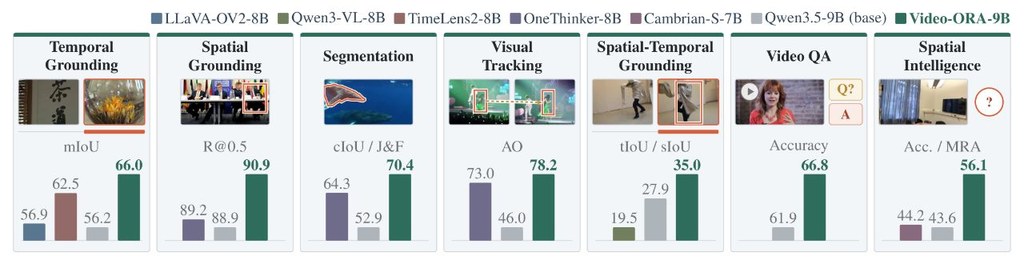
同一套更新規則覆蓋 temporal grounding、spatial grounding、segmentation、tracking、spatial-temporal grounding、video QA 及 spatial intelligence,Video-ORA-9B 則以一個模型處理七類影片理解任務。4B 設定的更新時間由每步 92.5 秒降至 62.4 秒,速度提升 1.48 倍,單張 GPU 峰值記憶體亦由 62.4 GB 降至 50.9 GB。

推理部分提供較實用的取捨參考:H20 以 vLLM 和 BF16 載入時,4B 及 9B 分別佔 8.6 GiB 和 17.6 GiB;十分鐘、每秒兩幀的影片採用 answer-only decoding 後,總延遲由 29.03 秒降至 24.30 秒。儲存庫列出 Environment、Training 及 Evaluation 文件,但提供的資料未包含完整安裝步驟或可直接下載模型的細節,較適合研究團隊按文件檢查環境後測試。

  • 訓練方法:標註同時作為正向 rollout 和任務有效的學習目標。
  • 涵蓋範圍:一套 RL recipe 支援七類影片感知任務。
  • 效率改善:4B 更新速度提升 1.48 倍,記憶體需求下降。
  • 推理優化:支援影片快取、一次解碼重用及 answer-only decoding。
  • 適合情境:需要統一處理影片定位、追蹤、分割、問答和空間推理的研究或工程團隊。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Video, 影像處理, 框架, Dataset 數據集

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

VA-Judger training pipeline

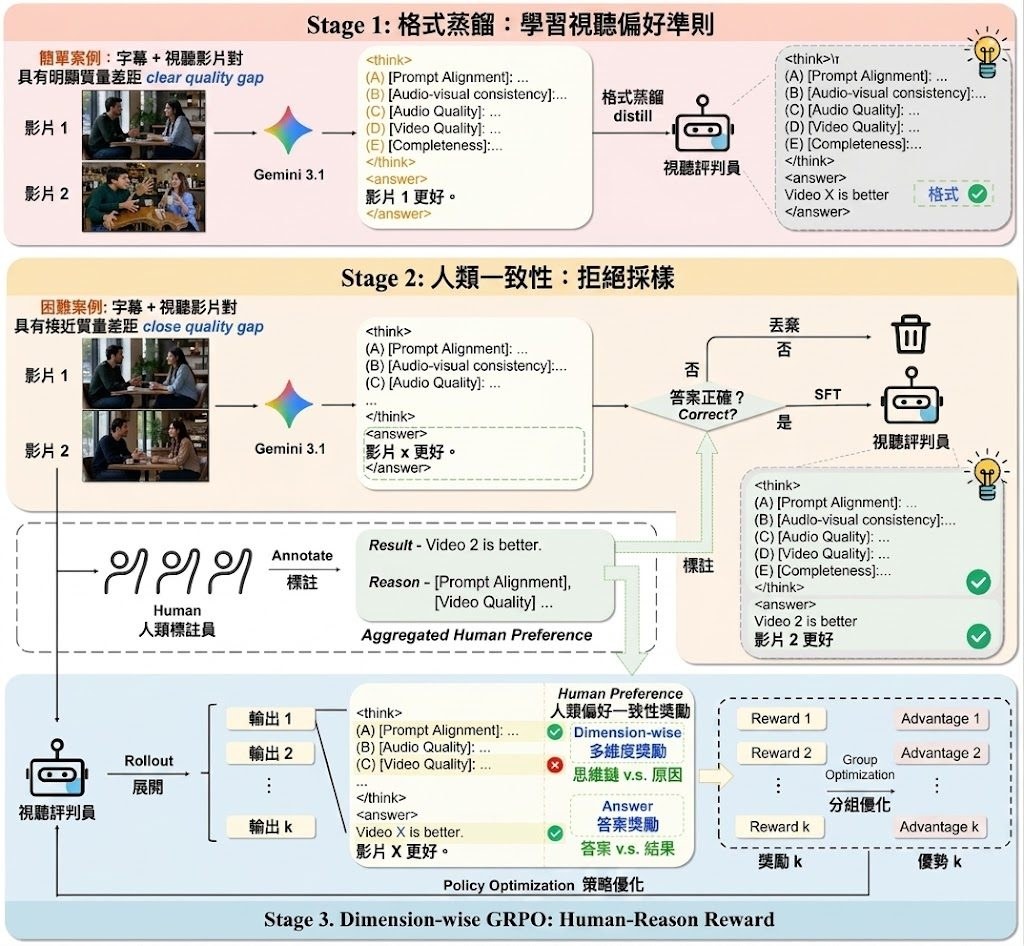
同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

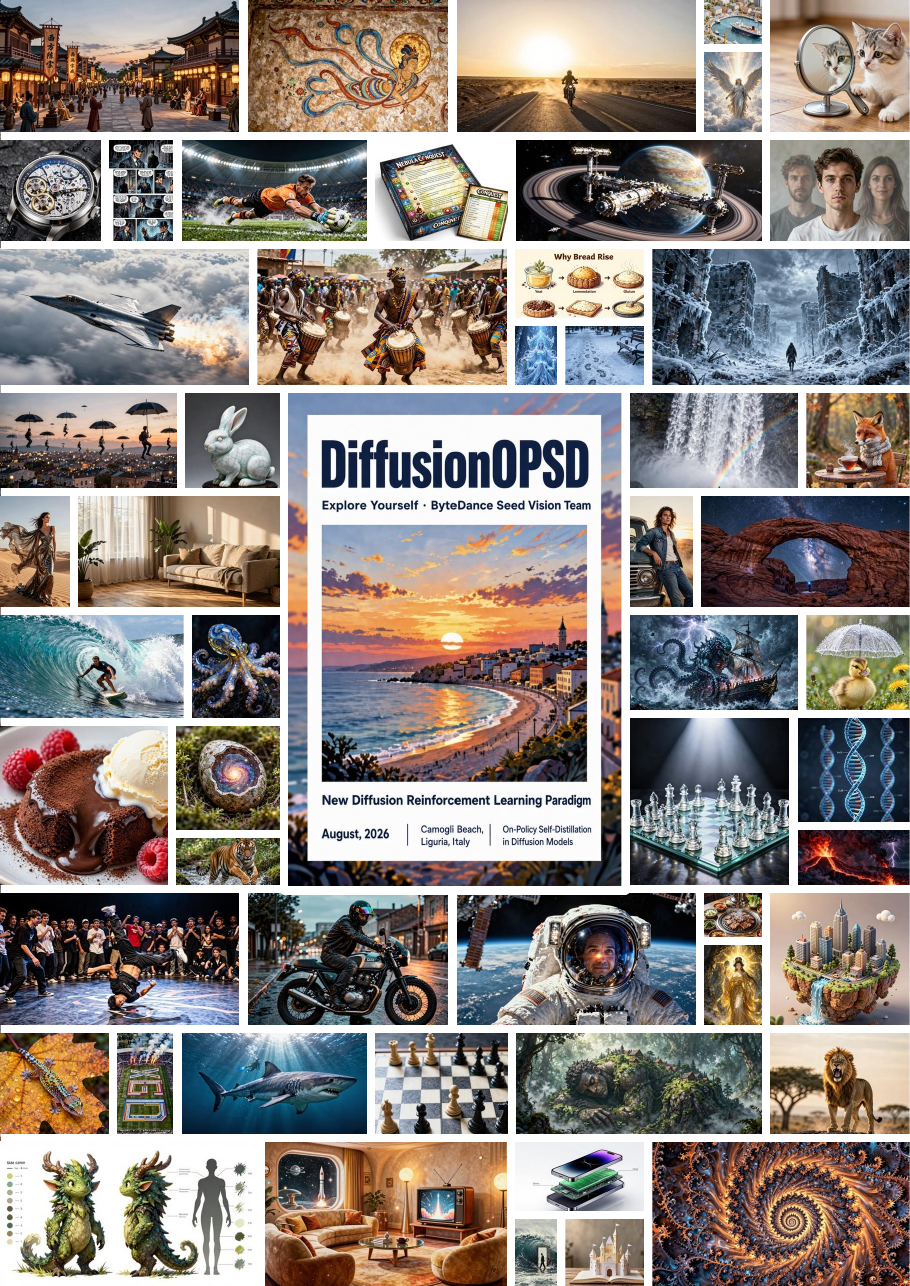
DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

WeMM-Embedding 統一多模態向量

WeMM-Embedding 把文字、圖片、影片和視覺文件放進同一套向量空間,適合要做檢索、比對和跨模態搜尋的場景。它同時提供不同尺寸選擇,方便在準確度與成本之間取捨。

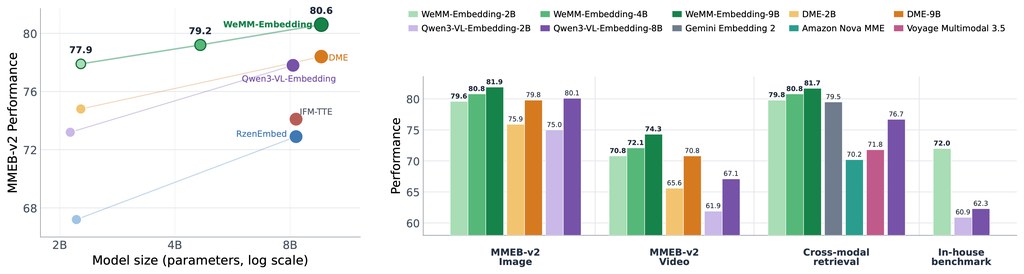
WeMM-Embedding Performance Overview

WeMM-Embedding 是一組多模態 embedding 模型,目標是把文字、圖片、影片、視覺文件和交錯式多模態輸入,轉成可直接比對的統一向量。對要做搜尋、相似度比對、內容檢索或跨媒體匹配的團隊來說,這種做法比逐一分開處理不同素材更省事。

它提供 2B、4B、9B 三個版本,還支援 Matryoshka dimensions,代表可以按需要輸出不同長度的 embedding,減少計算和儲存成本。README 也提到,向量來自 <embedding> token 的最後一層 hidden state,再做 L2 normalization;目前不支援 audio。

實作和試跑方式都算直接,既可以用 transformers,也可以用 SentenceTransformer 直接載入 Hugging Face 模型 ID。作者同時標明推理較建議用 transformers==5.2.0,原因是較新的版本在前處理行為上可能有差異;serving 方面則測過 vLLM 和 SGLang。

  • 統一處理 text、image、video、visual document 和 interleaved multimodal inputs
  • 支援 Matryoshka dimensions,可按成本需要縮短 embedding 長度
  • 適合做跨模態搜尋、內容去重、相似度比對和檢索索引
  • 推理可用 transformers 或 SentenceTransformer,部署可接 vLLM、SGLang
  • 現階段不支援 audio,做語音相關流程要另配其他模型

對要處理多媒體內容的應用團隊、檢索系統、內容平台和資料整理流程,這類模型最直接的價值是減少多套表示法之間的銜接成本。它在多個基準上取得領先結果,但實際選型仍要看你要的是完整維度、較低成本版本,還是偏向部署效率的配置。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, Embedding, 模型, 多模態模型, Video, Image, Audio

JoyAI-Echo: 拓展長音訊視訊生成技術

它把文字轉影片做成可跨鏡頭延續的音畫生成流程,重點不只是一段片,而是人物、聲音同場景連貫下去。ComfyUI 節點版本可配合官方推理管線,方便逐鏡調整。

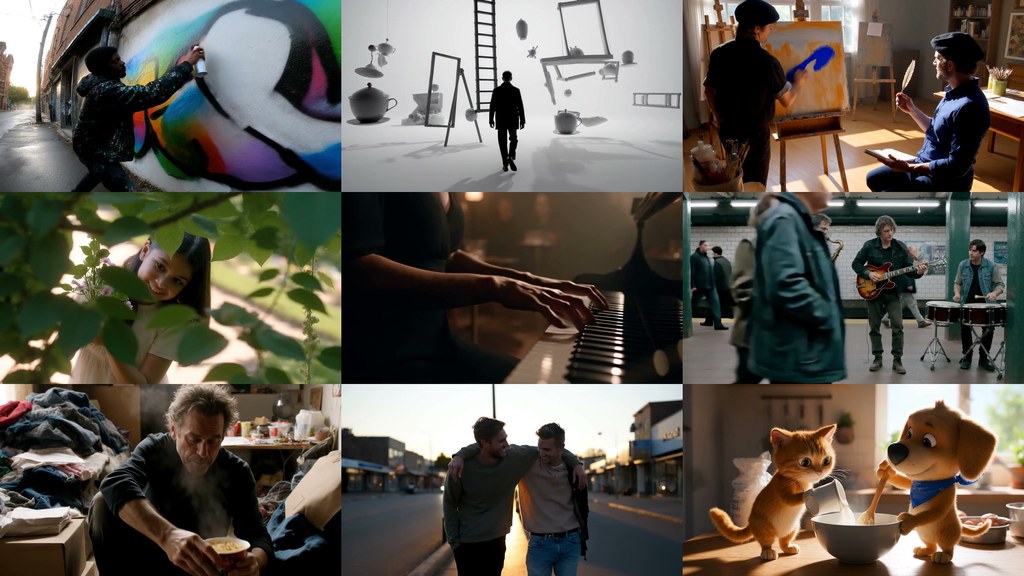
JoyAI-Echo generated video gallery

JoyAI-Echo 是一個面向 text-to-video(T2V)同多鏡頭長片段生成的模型項目,處理的是短提示詞難以撐住長篇敘事、角色外觀與聲音容易斷裂的問題。它的做法不是單段出片,而係用跨鏡頭 memory 去維持故事連貫,連動音畫一致性。

官方說明強調它走 full bf16 precision,唔採用 GGUF quantization,目標係貼近正式推理管線的輸出。現階段支援 T2V,同多鏡頭長視頻;image-to-video(I2V)未支援。另有 ComfyUI_JoyAI_Echo 節點包,適合想喺工作流入面逐鏡改 prompt、即時預覽、再串接後續鏡頭嘅人。

  • 可做長篇音畫故事,展示例子去到 10 分鐘
  • 支援少步數生成,長片與 causal world model 都偏向快速推理
  • cross-shot memory 會保留角色外觀、聲線同連貫性
  • ComfyUI 版本方便分鏡調整,同官方管線保持一致
  • 目前重點在 T2V,多鏡頭長片段,未覆蓋 I2V

它和一般單段影片模型最大分別,在於將「一段生成得像」推進到「多段接得住」。如果要放進實驗室、內容團隊,或者做互動世界、長敘事原型,這種可續接的記憶機制會比只看單次輸出更實用;但代價是對 GPU 記憶體要求高,官方節點提到 48GB VRAM 同 GPU memory hot-swap 才較穩陣。

項目主頁 · GitHub

Categories: 開源, ComfyUI, 多模態模型, 視頻模型, 世界模型, Video, Image, Audio

GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

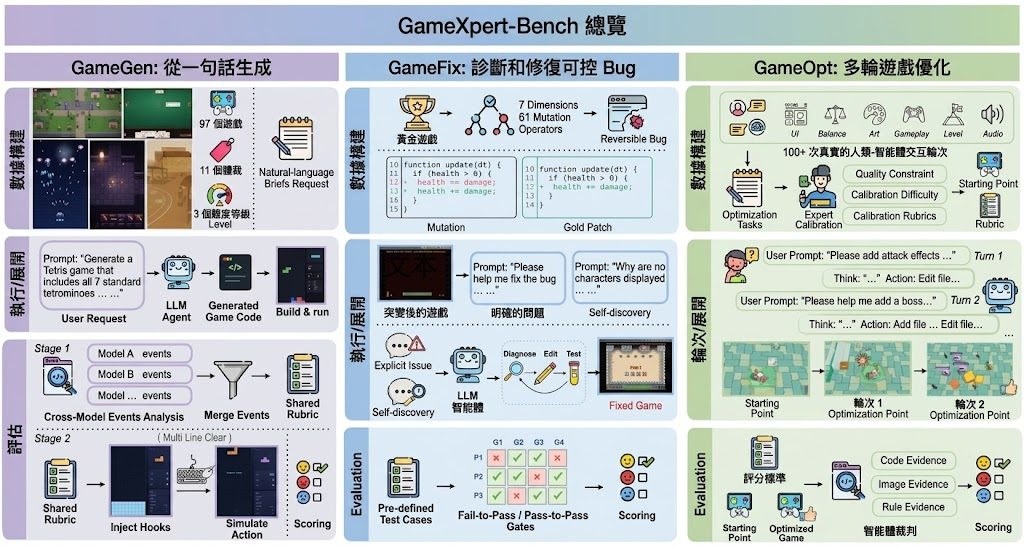
騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

NVidia Hydra-0 以人類動作統一機械人訓練

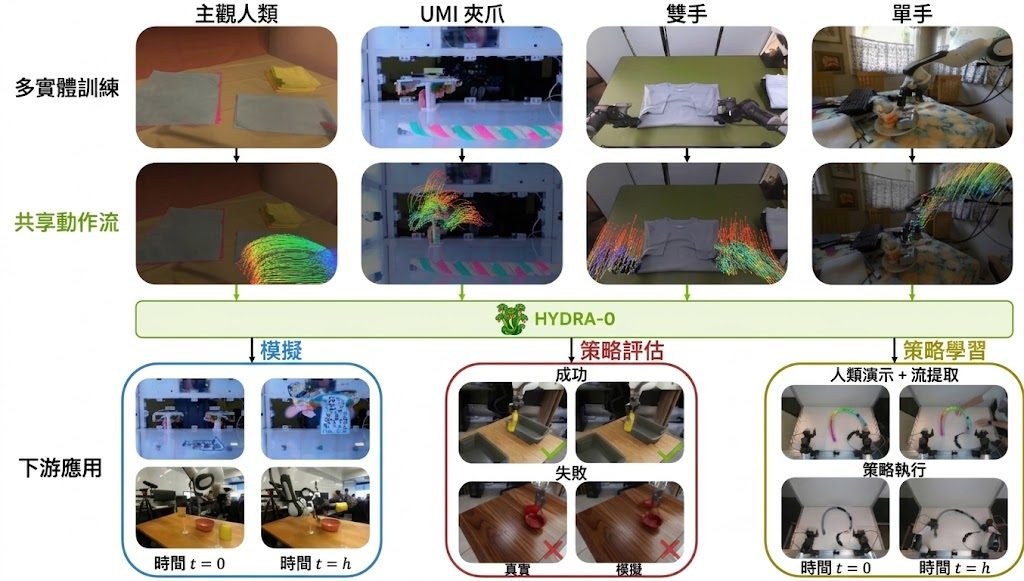
Hydra-0把機械人動作轉成畫面上的像素流,讓同一個世界模型學習不同機械人形態,並支援模擬、策略評估及真機控制。

Og image

機械人面對不同手臂結構、夾具和操作環境時,動作通常以各自的關節或末端執行器座標表示,令資料難以共用。Hydra-0以 Action Flow 將可見的機械人運動表示成影像平面上的像素流,建立跨形態、任務和環境的共同控制介面,屬於面向通用控制的 world model。

Hydra-0在運行時採用 hybrid simulator:physics engine 負責移動機械人,learned video model 則預測動作對場景造成的變化。模型可從 egocentric human demonstrations、handheld UMI grippers、single-arm robots 和 bimanual robot arms 等互動影片學習,減少依賴單一機械人平台資料的限制。

Forward mode會根據 gripper flow 預測未來場景,生成的結果可用於 open-loop policy evaluation;inverse mode則由目標物件的 flow 推導相容的機械人運動,再透過 supervised readout 轉換成可執行動作。把模擬、策略測試和控制放進同一套模型流程。

• 以像素流統一四種不同 embodiment 的互動資料
• 同時支援世界預測、策略評估及機械人控制
• 以 physics engine 和 learned video model 組成 hybrid simulator
• 最佳配置令 robot-motion error 降低90.4%,object-motion error 降低60.2%,比較基準為 action-conditioned baseline

Hydra-0適合需要整合多來源示範影片、先在模擬環境測試策略,再連接真實機械人的研究和開發工作。它仍然依賴動作影片、像素流表示和模型預測的準確度,跨形態轉移能否在更多任務中保持穩定,仍要配合完整數據和真機測試判斷。

項目主頁

Categories: 視覺模型, 世界模型, NVIDIA, Video, Image, World-Action Model, Robotic

ComfyUI-MiniMaxH3-Contex-Loop:讓 MiniMax H3 多場景影片可重試續作

把多場景影片拆成可審核、可重試的製作流程,減少一次渲染失敗便要由頭再做的浪費。

MiniMax H3 Contex Loop v0.5 — scene plans that survive the render

多場景影片最麻煩的地方,往往不是生成單一鏡頭,而是其中一幕出錯後要重做整段流程。ComfyUI-MiniMaxH3-Contex-Loop 是一套開源 ComfyUI 工作流工具,利用一個可重用的 sampling body,按 scene Plan 逐幕生成 MiniMax H3 影片,並把已接受的片段從磁碟組合起來。

每個場景都可以獨立設定提示詞、seed、時間、圖片、動態影片及音訊參考;Review Gate 會讓使用者選擇批准、重試、reroll 或提早停止。candidate_count 亦可為單一場景生成多個候選,最後由使用者揀選指定 take,減少整條工作流反覆排隊的成本。

  • 支援中斷後 resume、partial assembly 及 atomic checkpoints
  • 可延續現有片段,處理 inpainting 和 two-ended bridges
  • Guide 與 protected AV-prefix transitions 有助維持畫面、動態及聲音連接
  • 支援 latent-to-PNG export,並可從已儲存資產恢復製作

v0.5 要求較新的 ComfyUI,包含原生 Add Guide for MiniMax H3。FFmpeg 放在 PATH 會較方便,沒有時可由 ComfyUI 內置 PyAV 處理 review 和 assembly,因此硬件、模型配置及渲染時間仍然是主要限制。倉庫目前以 main 作為支援的 0.5 發行線,已儲存的 0.4 workflows 和 checkpoints 仍然支援,較適合把生成流程分段管理的影片創作者及技術團隊。

GitHub

Categories: 開源, ComfyUI, AI productions, Video, Image, 框架, MiniMax

SparsePR 讓影片生成以稀疏注意力加速,毋須重新訓練

SparsePR 將稀疏注意力帶入四款影片模型,在維持生成質素的同時,把執行速度提升最多 2.61 倍。

Repository image for PardisTaghavi/SparsePR

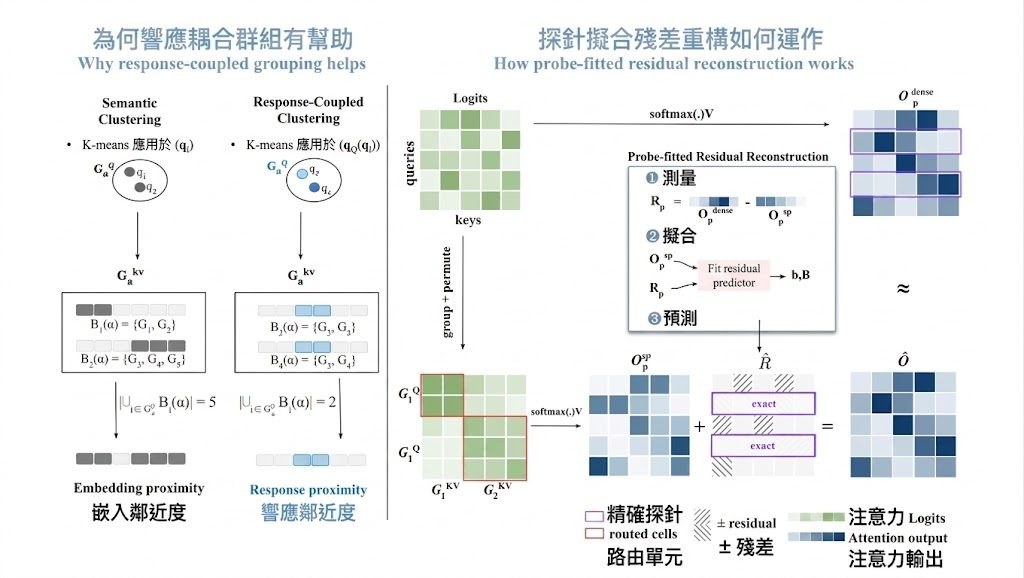
影片生成最吃資源的部分,往往不是提示詞或輸出格式,而是 Video Transformer 裏大量 Attention 計算。SparsePR 屬於 training-free sparse attention 參考實作,透過減少不必要的 query、key/value 互動,加速 HunyuanVideo-13B、Wan2.2-I2V-A14B、Cosmos-Predict2.5-14B 及 Cosmos3-Nano-16B,毋須額外訓練模型。

它沒有單純按注意力集中程度刪走區塊,而是以 Response-Coupled Partitioning 按目前回應分組,再用少量 exact probe rows 配合 Probe-Fitted Residual Reconstruction,補回稀疏計算遺漏的輸出。使用者可透過同一個介面,在 dense baseline 與 SparsePR 之間切換,直接比較影片質素、速度和顯存取捨。

  • 執行 pair density 約 21.9% 至 26.0%
  • 端到端速度提升約 1.48 至 2.61 倍
  • 涵蓋文字轉影片、圖像轉影片及 image-to-world 情境
  • 在 VBench 及 PBench 進行評估,部分 Cosmos-Predict2.5-14B 結果達 40.33 dB

項目要求 Linux,並建議使用 NVIDIA H100;HunyuanVideo、Wan2.2、Cosmos-Predict2.5 與 Cosmos3 需要分開的 CUDA 12.8 wheel 環境,原因是 Cosmos3 依賴較新的 Diffusers 和 Transformers。可選的 fused CUDA kernels 有助進一步執行,但安裝門檻明顯高於一般影片生成工具,模型 checkpoint 亦要從官方 Hugging Face 儲存庫取得。

SparsePR 適合研究影片生成效率、建立高端 GPU 推理基準,或需要在保留畫面質素下減少計算量的團隊。它目前仍是參考實作,支援模型和硬件環境較有限;對只有消費級 GPU、只想快速試玩影片生成的使用者,成本與環境配置可能抵銷加速帶來的好處。

項目主頁 · GitHub

Categories: 開源, 模型訓練, NVIDIA, Video, Image, 框架, Linux

InfinityEdit:支援多輪連續編輯嘅開源影片框架

InfinityEdit 將影片編輯變成連續接力,每個指令都在上一段結果上再延伸。它適合要處理長片段、持續畫面同多輪改動嘅場景。

Pianist source video thumbnail

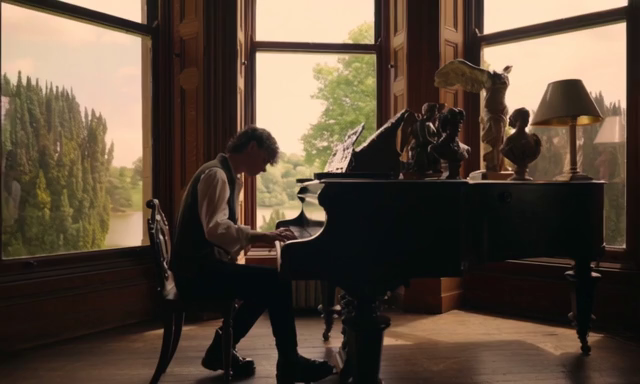
InfinityEdit 係一個影片編輯框架,核心問題唔係單次改一段短片,而係面對持續流入嘅影片,連續套用多個指令,令後一段自然接住前一段,仲要保住畫面連貫。對做長片生成、直播式視覺改寫,或者需要一路加指令一路修正畫面嘅工作流程,佢處理嘅正正就係「編輯唔可以只限喺固定片段內」呢個限制。

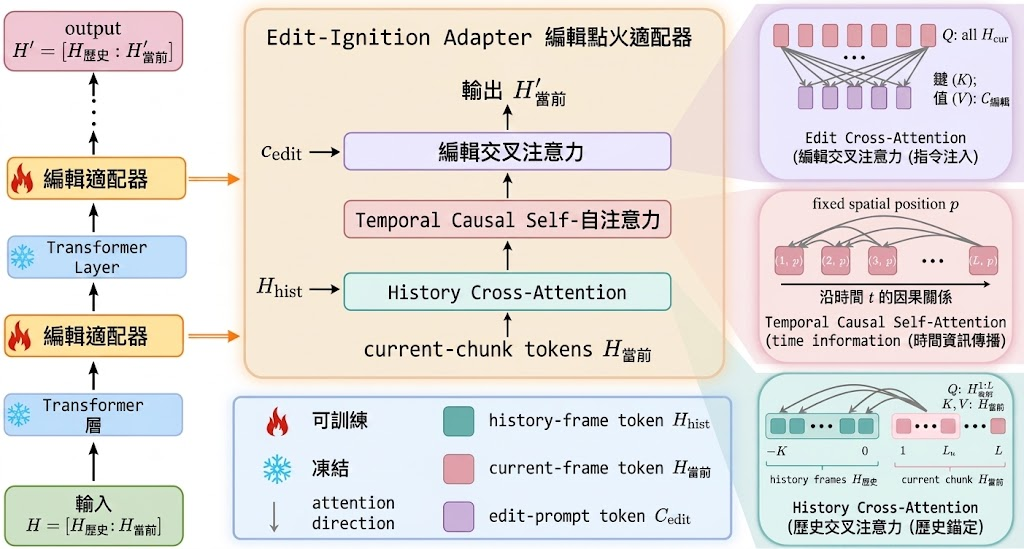
佢嘅做法係喺凍結嘅 video diffusion backbone 上面加一個輕量嘅 Edit-Ignition Adapter,令原本負責串流生成嘅模型多咗三層訊息路徑:歷史畫面引導、時間因果注意力,同埋編輯指令注入。生成時只會喺有新編輯指令到達嘅那一段啟動 adapter,之後嘅片段就交回原模型接力,記憶體負擔唔會一路膨脹。

項目提供訓練程式同多輪推理流程,安裝方法都幾直接,先建 Python 3.11 環境,再裝 requirements.txt,之後下載基座模型 Helios-Distilled。訓練分兩階段,第一階段學基本編輯能力,第二階段再針對低噪聲細節同時間權重做修正;推理則會輸出一串 source.mp4、edit_1、edit_2 之類嘅連續結果,方便睇到每次指令點樣疊落去。

同一般固定源片逐格改寫嘅方法相比,InfinityEdit 睇重嘅係「延續」而唔係「覆寫」。呢個取捨令佢更貼近長影片、持續鏡頭、反覆編修呢類工作,但亦意味住訓練資料要先做 VAE latent 同文字 embedding 預處理,流程比即插即用工具重少少。官方展示同評估都集中喺長片生成同多輪 sequential editing,顯示佢嘗試解決嘅唔係單次風格轉換,而係編輯累積後仍然保持穩定。

  • 支援多輪順序編輯,每次指令都建立喺上一段已編輯內容之上
  • 以凍結 backbone 配合輕量 adapter,改動集中,唔需要重寫整個生成模型
  • 適合長片生成、持續鏡頭改寫、分段式影片修正呢類場景
  • 訓練同推理都已經拆好流程,但前期資料預處理同模型下載仍然係必要步驟
  • 評估重點放喺長序列穩定性同編輯連貫性,而唔係單一片段嘅局部改動

對做影片生成、研究串流式編輯,或者想將文字指令一路疊加到同一條影片流嘅團隊,呢個項目提供咗一個較完整嘅技術路線。佢唔係追求一次過改到最盡,而係用較細嘅介入,令編輯可以一路接力落去,仲保持住原本生成器嘅長片能力。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Embedding, Video, 框架, Python

Page 27 of 55
1 … 25 26 27 28 29 … 55