DMAD:MiniMax-H3 影片生成壓縮至四步

DMAD 將 MiniMax-H3 的 50 步生成流程壓縮至 4 步,兼顧 1344×768 影片與原生立體聲音輸出。

Videos generated by the 4-step DMAD student of MiniMax-H3 (video only; every clip also has generated audio)

由 50 步縮至 4 步,DMAD 讓 MiniMax-H3-33B 可以更快完成文字轉音訊影片生成,同時保留 1344×768 影片及原生立體聲音。這項目屬於模型蒸餾與推理工具,實際處理的是高質素生成與推理速度之間的取捨。

項目提供兩個 rank 128 的 LoRA,每個約 1.4GB,分別是論文使用的 lora critic,以及在 AVGen-Bench 取得較高分數的 full critic。它們都掛載於 H3 transformer,將 50 步 teacher 轉成四步 student;DMAD 以兩個 discriminator head 分辨真實資料、teacher 樣本與 student 樣本,直接學習 log-density ratio,省卻 DMD 所需的輔助 diffusion model。

  • 4 步生成 1344×768 影片及立體聲音
  • 提供 lora critic 與 full critic 兩個版本
  • 支援獨立推理程式及 Diffusers pipeline
  • 方法以 adversarial distillation 取代額外 score fitting

MiniMax-H3 與 rCM 的人類偏好比較為 84.6%,但 AVGen-Bench 只明確指出 full critic 分數較高,未提供具體差距;選擇模型時仍應按畫面質素、聲畫同步及硬件成本自行測試。
項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, MiniMax, LoRA

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

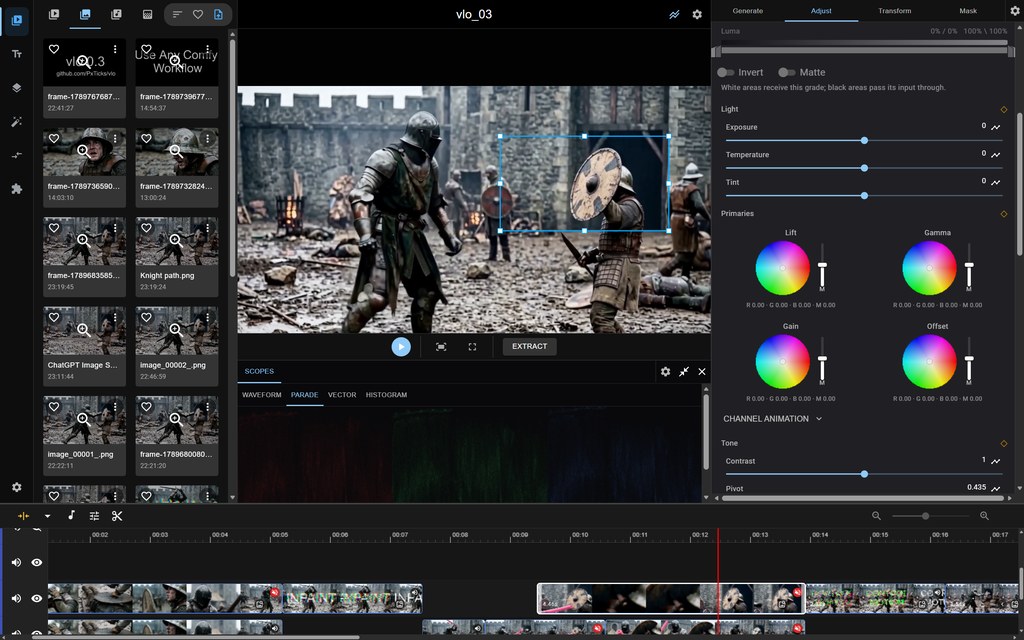
Vlo 把 ComfyUI 帶進本地影片剪輯時間線

Vlo 將生成式 AI、ComfyUI 和傳統剪輯工具放在同一條時間線,適合想在本地處理影片的創作者。

landing

想在影片時間線內直接交給 AI 做遮罩、修補或畫面變換,Vlo 提供了一條較完整的工作流程。它屬於免費、開源的本地影片編輯器,處理的是生成式 AI 與逐格剪輯之間難以銜接的問題,亦支援在本機或遠端 GPU 上編輯同一批本地項目檔案。

Vlo 把 ComfyUI bridge 接入編輯器,圖片、影片和時間線選取內容都可以送入 ComfyUI 工作流;SAM2 points editor 則用於遮罩,並配合自動裁剪與拼接處理 video inpainting。自動調整 aspect ratio 讓不同影片模型處理素材時毋須先裁走畫面,色彩校正、音訊、版面、濾鏡、keyframes、spline editor、beat detection 和可吸附 markers,則補上傳統剪輯所需的控制。

測試時需要 Chromium-based browser,官方已測試 Chrome 和 Edge;Firefox 由於 WebCodecs 實作差異,早期測試曾出現明顯延遲。媒體渲染由 mediabunny 包裝 WebCodecs,配合 File System Access API 直接管理磁碟檔案,但清除瀏覽器資料後可能遺失項目資料夾位置。

  • ComfyUI 工作流可直接套用到時間線選取內容
  • SAM2 遮罩支援影片修補流程的自動裁剪與拼接
  • 本地項目可配合本機或遠端 GPU 編輯
  • 具備逐格影片編輯所需的 keyframes 和 spline 控制
  • 目前依賴 Chromium,瀏覽器兼容性是主要限制

Vlo 較適合需要把 AI 影片生成、inpainting 和傳統後期剪輯放在同一個工作區的創作者或小型團隊。項目沒有提供可直接比較的性能指標,現階段較能確認的是它以 WebCodecs 支撐 frame-accurate nonlinear video editing,並以可擴展的 ComfyUI 工作流延伸功能;瀏覽器限制和本地檔案管理方式,仍會影響團隊採用前的測試安排。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, API, Video, Image, 影像處理, Audio, 工具, Content Creator

VoxMem 測試音訊模型的記憶盲點

VoxMem 不只測模型記得講過甚麼,還檢查能否辨認說話者、語氣與背景聲音,直面多輪語音記憶的缺口。

VoxMem logo

當語音助手要回想幾次對話之前的內容,答案未必藏在文字轉錄稿內:誰說過一句話、當時的語氣,以及背景傳來甚麼聲音,同樣可能決定答案。VoxMem 屬於語音記憶評測基準,透過多次會話測試 Large Audio Language Models(LALMs)能否保留及運用這些非文字資訊。

項目把測試拆成兩條軸線:需要找回的聲音證據包括 speech semantics、speaker identity、paralinguistic cues 和 environmental sound;記憶操作則涵蓋 information extraction(IE)、multi-session reasoning(MSR)、temporal evolution tracking(TET)及 answer refusal(AR)。這個安排比只問模型能否找回一句原話更接近長期語音助手的工作情境。

VoxMem 提供 3,196 個評測實例,涵蓋 34,743 段、共 177小時的語音會話,並固定問題及證據,只改變8K、16K、32K 和 64K tokens的上下文長度。測試者可從 GitHub 項目取得程式碼,再配合 Hugging Face上的資料集重現評測;Python 3.9 或以上是已列出的基本環境,但不同 LALM仍可能需要各自的模型存取設定。

結果指出,15個 LALMs 在 32K 上下文下沒有模型達到 40% 整體準確率;模型記住文字內容的能力明顯高於辨認說話者、語氣及環境聲音,而且歷史越長,差距越大。這令VoxMem 更適合用來找出語音記憶系統的失效位置,而非單純作為模型排名工具。

• 同時測試聲音證據與記憶操作,涵蓋15個有效組合
• 以多會話歷史取代單一錄音,檢查跨場景整合能力
• 包含證據不足時拒絕回答,能檢視模型是否過度猜測
• 非文字聲音資訊在長上下文下明顯較難保留

研究語音代理、會話記憶、音訊模型或長上下文系統的團隊,能用這套基準分辨問題究竟出在聲音理解、跨會話推理、狀態追蹤,還是拒答判斷。資料採用 CC BY-NC 4.0,程式碼則使用MIT授權,商業產品整合前仍要獨立檢查資料使用條件。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, Audio, 工具, Python, 語音, Dataset 數據集

ComfyUI-MiniMaxH3Mod:可重用參考模組

你可以把它理解成 MiniMax H3 的參考素材管理層,把圖像、影片和聲音整理成可重用的 RefMod。

ko-fi

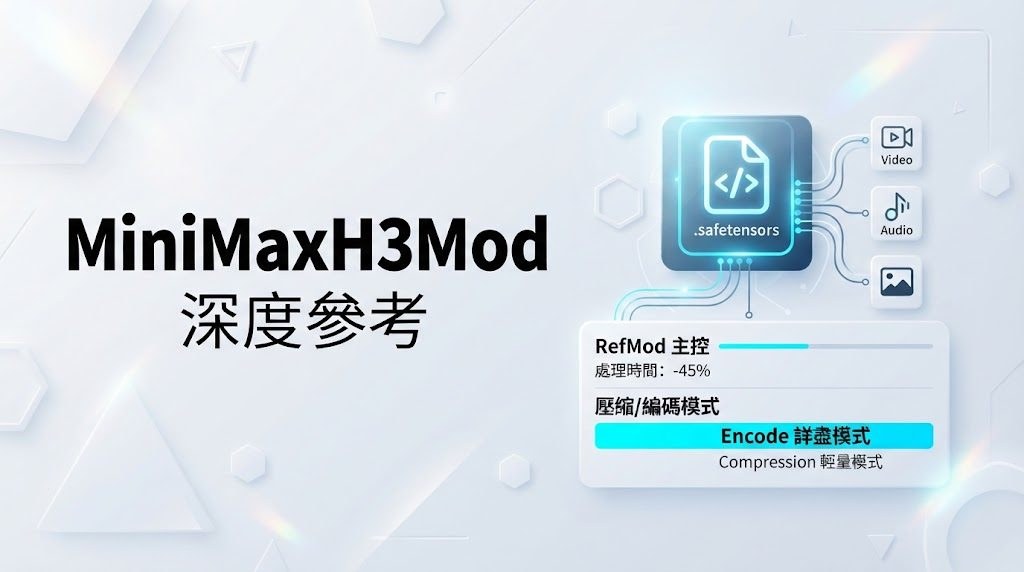
想在 ComfyUI 的 MiniMax H3 工作流中重用同一組人物、場景或聲音參考,不必每次重新編碼原素材。ComfyUI-MiniMaxH3Mod 是一個開源 custom node 項目,處理 RefMod 的建立、儲存、載入、組合及套用,讓圖像、影片和音訊參考可以保存成 .safetensors,再交給 Apply H3 RefMod 使用。它不會訓練 H3 權重,也不是 LoRA 或監督式概念學習工具,而是接入 H3 原生 reference-token 路徑的儲存與選擇層。

使用時需要將項目放入 custom_nodes 後重新啟動,並把標準 H3 video VAE、audio VAE 及原生 CONDITIONING 接到相應節點。項目已提供 Create H3 RefMod、Create H3 RefMod Master、Load H3 RefMods、Apply H3 RefMod 等節點;Master 可以一次處理視覺和音訊,save=False 則可只產生記憶體中的 bundle,不寫入檔案。ComfyUI Manager 可處理 safetensors、numpy 和 Pillow 等 Python 依賴,影片資料夾載入則可按需要加入 opencv-python 或 imageio。

  • 支援圖像、影片、音訊 RefMod,並可在同一個 .safetensors bundle 儲存視覺與聲音。
  • encode 保留較多細節但消耗更多 reference tokens;training 先壓縮 latent,降低 token 成本,亦可能損失細節和動態。
  • Collect H3 RefMod Masks 可處理不同尺寸的 MASK,並按對應參考素材保留尺寸;上游裁走的像素則無法恢復。
  • Full Reference video sampling 會先決定因果 frame 數,避免 16 等限制直接截掉影片尾段。
  • Loader 和 Axis 採用按需增加的參考槽位,並可分開選擇 All、Visual 或 Audio。

它和單純把素材放在工作流內的做法不同,RefMod 會把編碼結果保存下來,之後重用時可避免重複處理來源檔案。壓縮模式適合控制 token 和生成成本,完整 encode 則較適合作為身份或細節比較的基線;兩者都不能保證只轉移指定屬性,身份、服裝、背景和構圖仍可能互相混合。項目支援最多八個參考槽位、子資料夾、外置磁碟及 extra_model_paths.yaml 登記的 RefMod 根目錄,Library 和 Config 亦能搜尋及檢視已保存內容。

可調整的 max_tokens、frame limit、視覺 budget policy 和 Refinement Steps,令項目較適合需要反覆測試參考組合的創作者、ComfyUI 工作流作者,以及要管理大量人物或場景素材的團隊。truncate 會削減畫面內容以符合 token 預算,error 則在超出預算時停止保存;這些選擇直接影響細節保留和工作流是否繼續。項目目前沒有提供可與原生完整 reference workflow 對齊的正式基準測試,Windows 是原先測試環境,Apple Silicon 只覆蓋部分預處理和 H3 VAE 檢查。

音訊支援仍是最大限制。項目可以保存及混合視覺、音訊參考,亦曾成功處理音樂參考,但目前測試未能完成 speaker-identity transfer,因此不能當作已驗證的 voice cloning 解決方案;它亦不會自動修正影音同步。API 和 node schema 仍在演變,節點名稱及輸入欄位可能隨版本調整,適合接受工作流需要維護、並願意自行測試參考強度與 token 取捨的使用者。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型訓練, API, Video, Image, 影像處理, Audio, 工具, Content Creator, Clone, 庫, 語音, 音樂, 蘋果, MiniMax, LoRA

Audio8 ASR Infinite:持續運行語音轉錄

Audio8 ASR Infinite 以可調音訊時鐘和延遲,處理長時間串流轉錄的反應速度與記憶體增長問題。

Repository image for Edge0-AI/Audio8-ASR-Infinite

長時間錄音、直播字幕或語音助理最怕轉錄愈跑愈慢,甚至因上下文累積而出現漂移。Audio8 ASR Infinite 屬於原生串流語音識別模型,透過 rolling KV cache 將記憶體和延遲維持在有界範圍,支援 24/7 連續轉錄;目前支援中文及英文。

模型可在 80、120、160 ms 音訊時鐘之間選擇,每秒作出 12.5、8.3 或 6.25 次決策,並可將 transcription delay 設於 240 至 560 ms。延遲愈低,回應愈快;較長延遲則有較多時間累積語境。Semantic VAD 亦會分辨思考停頓、口吃和真正句末,減少傳統 acoustic VAD 過早截斷語句的問題。

架構承接 Voxtral realtime audio architecture 和 DSM-style streaming:Causal Audio Tower 以 Voxtral Realtime 4B 為初始權重,Audio Projector 及 Frame Length Embedding 由隨機初始化訓練,Decoder 和 LM Head 則採用 Qwen2.5-3B-Instruct。項目仍屬 preview release,後續會在同一 frame grid 加入即時語義感知。

  • 適合直播字幕、長時間會議紀錄及持續運行的語音介面
  • 可按硬件資源和回應要求調整音訊時鐘及延遲
  • 目前資料未提供完整安裝流程、硬件需求或公開 benchmark 數據
  • 使用 adapted vLLM build 才能對應無限長度串流運行

對需要低延遲、不中斷轉錄的團隊,這個模型的價值在於把速度、延遲可調性和長時間穩定運行放在同一個架構內,但正式採用前仍要自行測量廣東話支援、GPU 佔用及不同時鐘組合的辨識準確度。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Audio, 語音, Dataset 數據集, 廣東話

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

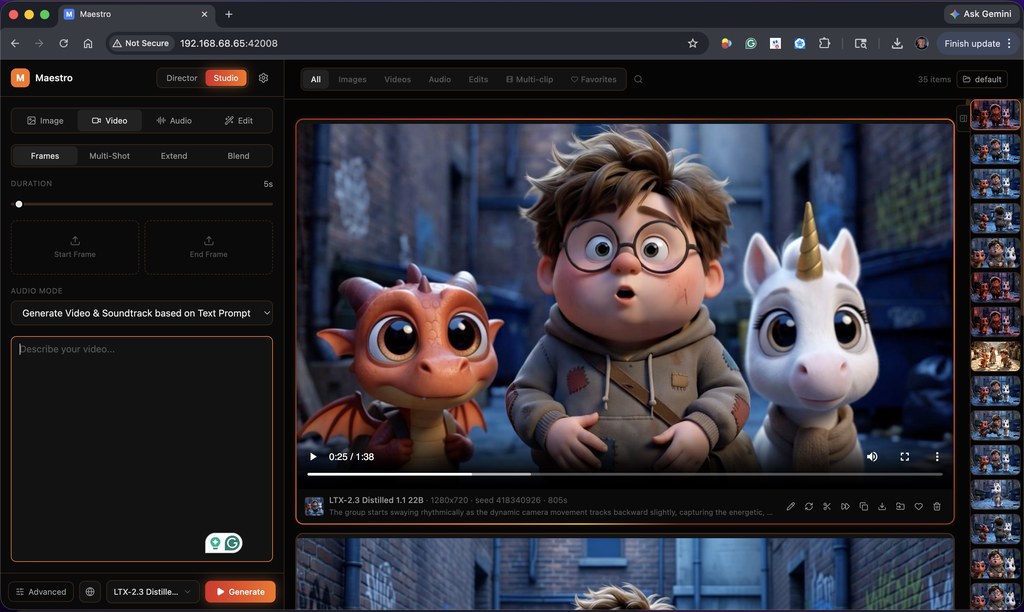
Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

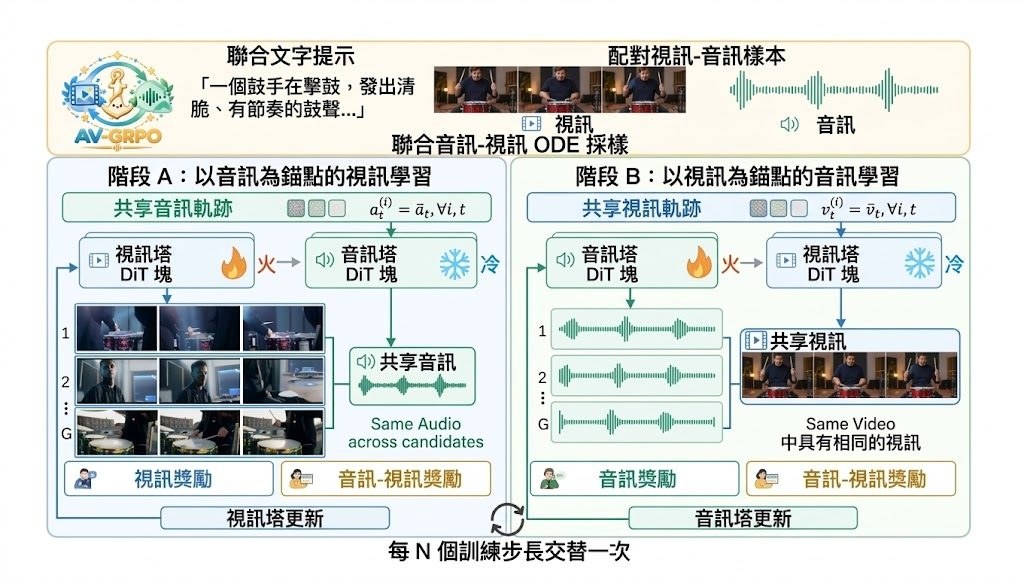
AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

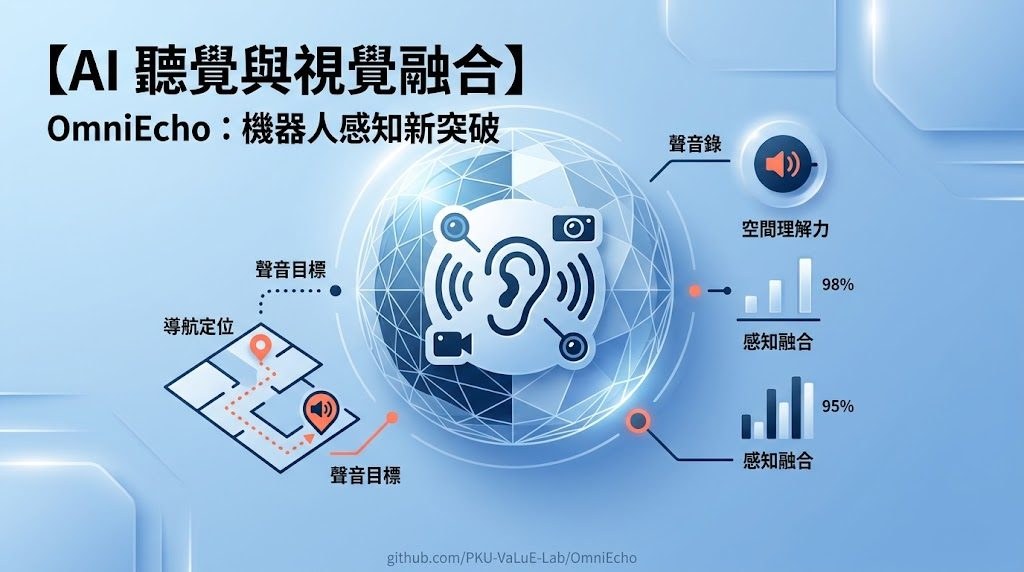
OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

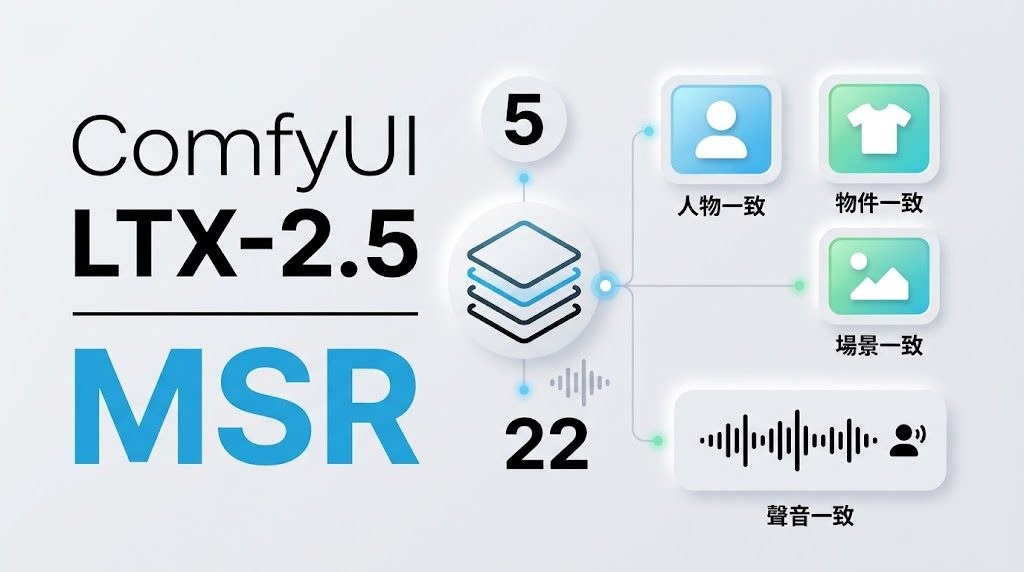
LTX-2.5 加入多圖與聲音參考控制

想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

Page 4 of 12
1 2 3 4 5 6 … 12