Confucius4-T3PO:14B 即時翻譯模型,邊聽邊譯並兼顧延遲

逐段輸入文字後,模型以 AI 判斷何時繼續等候、何時輸出譯文,減少即時翻譯必須在速度與語境之間二選一的情況。

Confucius4-T3PO

會議口譯或直播字幕需要盡快顯示譯文,但太早翻譯又可能欠缺上下文。Confucius4-T3PO 是一款 140 億參數的文字即時翻譯模型,接收細粒度文字片段後,會決定繼續等候還是輸出部分譯文,支援中英互譯。

它以 READ/WRITE 決策控制等待與輸出,並提供不同延遲模式,讓使用者按即時性需要調整速度與翻譯質素的取捨。已提交的譯文只會逐段追加,不會回頭改寫;交錯式歷史紀錄亦可重用 KV cache,減少重複計算。模型以 Qwen2.5-14B 為基礎,經串流翻譯冷啟動及 Pareto-aware 強化學習,兼顧翻譯質素與延遲。

模型本身只處理文字,並不原生接收語音。語音翻譯需要串接串流自動語音辨識(ASR);項目另有 R2T2 ASR 模型,可組成語音轉文字翻譯流程。推理介面包括逐段文字翻譯 API,以及接收 16 kHz 單聲道 PCM16LE 音訊的 WebSocket 串流示範。

  • 適合需要逐步顯示字幕或翻譯結果的串流應用及口譯流程。
  • 可按低、原生或高延遲模式調整輸出節奏;延遲與翻譯質素需要取捨。
  • API 可查詢分段統計及 WAIT/TRANS 統計,方便觀察單次工作階段的決策情況。
  • 儲存庫提供推理程式碼,並連結模型頁及線上示範;所列資訊未提供硬件需求或效能基準,正式部署前宜先測試目標語言、音訊流程及延遲。

對字幕平台、遠端會議及串流口譯團隊而言,逐段輸出有助減少等待完整句子才見到譯文的落差;但語音流程仍依賴外部 ASR,部署成本亦會受 14B 模型及推理環境影響。
GitHub · 模型

Categories: 開源, 模型, Qwen, API, Audio, 語音

YuE2 補上真實音訊 Tokenizer,支援歌曲翻唱微調

YuE2取得音訊編碼與真實錄音適配能力,可將自家錄音轉成語義碼,再微調歌手風格。

Og image

當你餵給 YuE 一段參考音訊(例如某歌手的演唱片段或特定樂器風格,要求接續生成)時:必須先用 Tokenizer 將參考音訊「壓成代碼」傳入模型。若 Tokenizer 品質不佳,音色在第一步壓縮時就失真了。

這個 v4 工具能更高保真地將輸入聲音轉為 Token,讓後續模型捕捉到的音色特徵更貼近原音。

錄音轉換、歌手風格微調和歌曲翻唱,原本受限於 YuE2 沒有隨附的 audio → semantic-token encoder。這個項目基於 m-a-p/YuE2-3B 及 m-a-p/MERT-v2-FullSong,加入音訊 Tokenizer 與 NAR-branch LoRA,讓 YuE2-3B 可以處理自家錄音,並以真實製作音訊調整解碼效果。

Tokenizer 取用 MERT-v2-FullSong 第 20 層特徵,先按音軌作 instance normalization,再以 8 層、d=512 的 Transformer,在 512-frame 視窗內轉換成 32,768 種 YuE2 semantic codes,特徵率為 25 Hz。留出歌曲測試的 top-1 exact match 為 16.1%,但近似 code 產生的聲音接近,NAR round-trip 聽感測試約達 95%。

  • tokenizer_head_joint_v4.pt、.safetensors、.bf16.safetensors:音訊編碼 head
  • nar_lora_joint_v4.pt、.safetensors、.bf16.safetensors:NAR 解碼分支 LoRA
  • _comfyui.safetensors:配合 ComfyUI 的 YuE2 權重布局
  • LoRA rank 為 32,覆蓋 28 層 NAR attention、MLP,以及完整替換的 vae2llm 和 llm2vae

.bf16 版本約為完整精度檔案的一半,head 與 fp32 的輸出一致率為 98.6%。項目附有 scripts/ckpt_io.py、訓練迴圈和推論腳本;ComfyUI 可把 LoRA 載入 YuE2 checkpoint 的 MODEL 輸出,強度設為 1.0,CLIP 輸入不受影響。頁面沒有提供 GGUF 檔案、檔案大小、上下文長度、Ollama、LM Studio、llama.cpp 或 MTP draft speculation 支援資料,亦沒有列出可供選擇的量化級別。

模型先以 4,765 首 YuE2 自行生成歌曲訓練,再適配真實音訊;因此它的價值集中於提升真實錄音的編碼與 NAR 解碼,而非取代 YuE2-3B 的完整生成能力。授權為 CC-BY-NC-4.0,商業用途需要另行確認授權條件。

模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Audio, 工具, 廣東話, Tokenize

OmniVChat:測試 AI 能否同時聽懂及看懂

直接把聲音和影像交給AI,回覆是否仍有根據?OmniVChat 提供評分工具,但測試與訓練分數不能混用。

OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue

讓AI直接接收用戶的聲音和影像,再以文字回答,OmniVChat(Omni Video Chat)提供了檢驗這類對話的評估與訓練獎勵工具。問題藏在影音之中,不另附文字提問、外部影像描述或自動語音辨識(Automatic Speech Recognition,ASR)轉錄,適合測試多模態模型能否連結所見所聞。

OmniVChat-Bench包含2,800段合成對話,按分層準則評分,涵蓋五類能力:

  • Dialogue-State & Link Perception(DSLP):理解對話狀態與連結。
  • Multimodal Entity Alignment(MEA):把說話對應至正確的可見實體。
  • Model Self-Awareness(MSA):交代自身身分與物理限制。
  • Anti-Hallucination(AH):回答以影音證據為依據。
  • Emotion Recognition(ER):結合面部與聲線辨識情緒。

評估分數r(y)介乎0至1,以Subcategory Mean匯報;OmniVChat-RL共用評分核心,另加格式、效率與風格獎勵,範圍為0至1.5,兩者不能直接比較。

研究團隊可先查看儲存庫的評分程式與範例,再到Hugging Face取得完整標註及媒體。這個項目只提供程式碼、範例與文件;合成對話的結果亦不足以單獨判斷模型在真人影音互動中的可靠程度。

GitHub

Categories: 開源, 香港中文大學, 阿里巴巴, 多模態模型, Video, Audio, 工具, 庫, 語音

HyperFlow 自蒸餾影片生成省六成推論成本 – MiniMax-H3 八步出片

Video Rebirth 推出嘅 HyperFlow 係一個針對 MiniMax-H3 嘅 8 步 LoRA 適配器,透過 data-free flow self-distillation 將 50 步推論壓到 8 步,仲行得喺官方 diffusers Modular Pipeline 之上。

Repository image for Video-Rebirth/hyperflow

影片生成模型一直面對一個現實樽頸:想要更高品質,就要更多 sampling steps,亦意味住更長嘅等待同更高嘅運算成本。Video Rebirth 推出嘅 HyperFlow 就直接針對呢個取捨落手,喺 MiniMax-H3 官方權重之上加一個 8 步 LoRA(PEFT,rank/alpha 256,覆蓋 attention、feed-forward 同兩組 time embedder),將官方 50 點 sigma schedule 嘅 49 次前向推論壓到 8 次,而且唔需要額外訓練資料。

你可以把它理解成一個「加速層」:base weights、VAE、conditioner 同 t2va、fl2va、ref2va 三種 workflow(全部對應影片加音訊)都維持官方版本,呢個項目只負責載入 LoRA、兩個 time embedder 同固定嘅 8 步 sigma grid。官方修訂號、權重路徑、適用範圍等資料都收錄喺 hyperflow.json manifest 入面。LoRA 喺 Hugging Face 開源,授權沿用 MiniMax H3 Community License,呢個倉庫就提供 loader 同 example scripts,透過 hyperflow_blocks("fl2va") 等 API 直接接入 diffusers Modular Pipeline。

HyperFlow 嘅特點係 data-free:模型自己產生候選影片、篩走不合格嘅、然後用通過嘅樣本做 self-distillation,屬於佢哋 RSI(Recursive Self-Improvement)訓練範式嘅 self-distillation 部分。對比一般影片生成流程,呢種做法唔需要額外收集標註資料,亦唔需要人手標籤。實際運行時仲可以選擇加裝 NVIDIA Sol-Attn sparse attention(PyTorch ≥ 2.10、CUDA ≥ 12.8、Triton ≥ 3.6,支援 SM80–SM120),官方聲稱喺 H200 上比 dense attention 快約 13%,並可透過 Ulysses context parallel 擴展至最多 4 張 GPU。

對想用 MiniMax-H3 出片、又希望壓低推論時間嘅團隊或獨立開發者嚟講,HyperFlow 提供咗一個直接掛載嘅方案;對研究自蒸餾或自改進路線嘅從業者嚟講,佢亦係一個具體嘅開源參考。需要注意嘅係 num_inference_steps 唔應該手動指定,步數同 sigma grid 都由權重檔案內置決定。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Audio, Python, 庫, MiniMax

lanshu-create-ai-presenter-video:數字人影片 Skill:一張圖+文案自動生成完整講解影片

一個針對通用數字人影片製作 Skill。你輸入主題或文案,再加一張授權人物圖,它就會按完整配音時間軸組織生成、剪輯同驗收,輸出一條可發佈嘅講解片。

Repository image for cclank/lanshu-create-ai-presenter-video

做數字人講解片最麻煩嘅地方,往往唔係生成人物,而係口型、文字同聲音對唔齊,最後剪埋一齊就甩拍。lanshu-create-ai-presenter-video 嘅切入點正正喺呢度:佢將「完整配音」鎖定為全片時間基準,人物主素材、字幕、關鍵詞動效同鏡頭轉場都跟住呢條音頻排,從而減少口型漂移同片段接駁嘅問題。整個項目屬於 Agent Skill 工具,由 Codex 或其他兼容本地 Skill 嘅 Agent 環境直接調用,源碼本身唔綁定任何特定服務商、模型或私有接口,可以按當前環境可調用嘅能力動態選擇配音、人物生成同口型同步工具。

最低門檻只需要一份主題或文案,再加一張已授權、包含清晰成年人物嘅參考圖。聲音樣本、屏幕錄影、B-roll、品牌素材、目標平台、時長、橫豎屏同風格等都係可選輸入,畀進階用戶調整。Skill 目錄會隨階段讀取對應參考文檔:generation.md 處理文案、聲音、能力選型同人物提示詞;editing.md 負責時間軸、字幕預設、封面同導出;qa-recovery.md 處理技術驗收、人工驗收同常見故障修復,避免一次過佔用過多上下文。

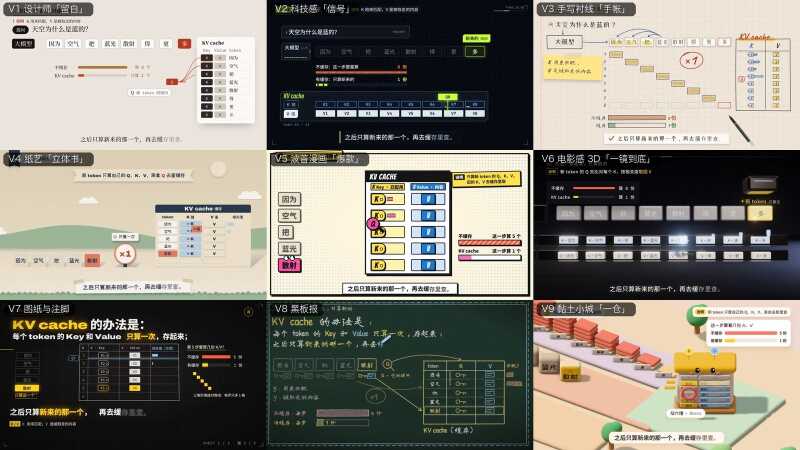
key名称the look · 画面best for · 适合3D
v1-editorialV1 设计师「留白」warm paper, ink, one vermilion accent, data blocks, page turns · 暖白纸、墨色、一抹朱红,大留白serious, premium explainers; business and product topics · 严肃、高级感、商业与产品no
v2-signalV2 科技感「信号」dark HUD, acid-lime accent, labels decode in, packets on wires, glitch cuts · 暗色仪表盘、荧光绿、数据包流动AI / infra / networking, anything “system-like” · AI、基础设施、网络、系统类no
v3-notebookV3 手写衬线「手帐」grid paper, a live pen writes every word, sticky notes, eraser · 方格纸上真笔书写、便利贴、橡皮擦teaching step by step, derivations, study notes · 一步步推导、学习笔记、教学no
v4-paperV4 纸艺「立体书」kraft pop-up book, pieces fold up with soft shadows, parallax · 牛皮纸立体书、折起的纸片、视差warm stories, processes, consumer topics · 有温度的故事、流程、大众话题no
v5-comicV5 波普漫画「爆款」halftone comic page, stickers slam on, bursts and sound words · 半调网点漫画、贴纸拍入、爆炸字punchy short videos, hot takes, myth vs fact · 节奏快的短视频、观点、辟谣no
v6-cinematicV6 电影感 3D「一镜到底」Three.js one-take in a graphite studio, porcelain props, bloom · 一镜到底的 3D 影棚、瓷质道具、辉光flagship pieces, launches, big-picture concepts · 旗舰内容、发布、宏观概念yes
v7-draftingV7 图纸与注脚one black drawing sheet, leader lines, ghost-letter karaoke, true footnotes · 黑色图纸、引线、注脚、卡拉OK式大字technical deep dives for practitioners · 面向从业者的技术深挖no
v8-chalkboardV8 黑板报a wooden blackboard written live in chalk, felt eraser, chalk mind map · 木框黑板、粉笔现写、板擦、粉笔脑图复习classroom feel, beginners, memory-friendly recaps · 课堂感、入门、便于记忆no
v9-clayV9 黏土小城「一仓」an isometric plasticine town, every analogy labelled with its real term · 等距黏土小城,比喻 + 真实术语标签analogies for non-experts, cute and friendly · 用比喻讲给外行、可爱亲和yes

預設輸出係 9:16、1080×1920、30fps 豎屏,時長 45 至 75 秒,發佈響度目標約 -16 LUFS。初始化可透過 init_job.py 自動建立標準任務目錄同 job.json,preflight.py 會做前期檢查,最後由 finalize_delivery.sh 收尾輸出,同時產出 QA 報告。環境要求 Python 3.9+、FFmpeg/ffprobe、Bash、jq、awk、sed,以及至少一種可調用嘅影片生成、語音生成同口型同步能力。

佢唔係一個獨立嘅模型,而係一套組織數字人影片工序嘅 Skill 框架,價值在於把配音、人物、字幕、剪輯、驗收等步驟統一在同一條音頻時間軸上,避免最常見嘅口型錯位同片段斷裂。內容創作者、行銷團隊、課程錄製同需要快速產出講解影片嘅場景會較受惠,特別係想喺不同 AI 服務商之間靈活切換、又唔想被單一平台鎖死嘅人。

  • 以完整配音為全片時間基準,減少口型漂移同片段接駁問題
  • 源碼不綁定服務商或模型,可按環境動態選擇配音、人物、口型工具
  • 三份參考文檔按階段讀取,控制上下文用量
  • 預設 9:16 豎屏、1080×1920、30fps、主題片長 45–75 秒
  • 支援聲音樣本、B-roll、品牌素材、平台、橫豎屏等可選參數

GitHub

Categories: 開源, Agentic, AI productions, 數字人, Video, Audio, 提示詞, 框架, Content Creator, Python, 語音, Skill 技能

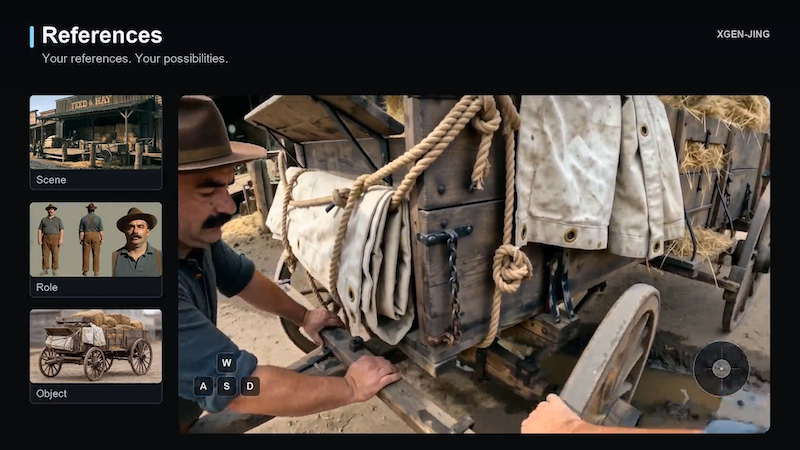
XGEN-JING 世界模型開源:邊走邊生成影片與音效

XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

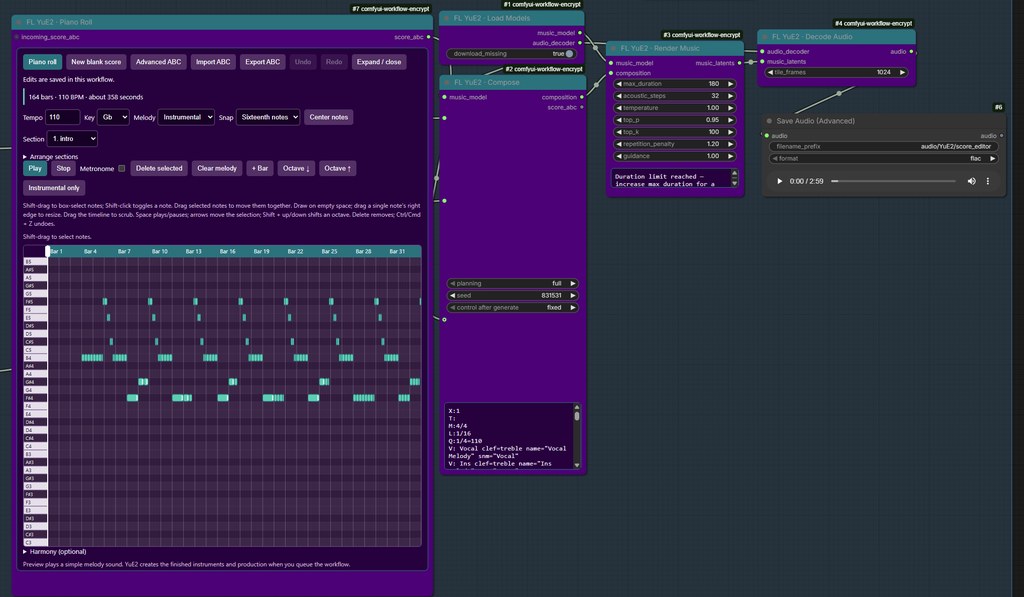
ComfyUI-FL-YuE2:ComfyUI 內砌歌:FL YuE2 把樂譜編輯、AI 作曲、LoRA 訓練三件事接起來

ComfyUI-FL-YuE2 是一組節點,把 YuE2-3B 音樂模型包進 ComfyUI 工作流,讓你用鋼琴卷軸寫樂譜、灌歌詞,最後輸出 48 kHz 立體聲成品,亦支援 AR LoRA 訓練。

YuE2 inference workflow in ComfyUI

以往想在 ComfyUI 玩音樂生成,往往要面對幾個卡位:要自行接 YuE2 的推理指令、要另外找譜面編輯工具、想做 LoRA 微調更要跳出 ComfyUI 自己搞訓練腳本。FL YuE2 嘗試一次解決這三件事,把樂譜編輯、AI 作曲、AR LoRA 訓練全部接成節點流程,對熟悉 ComfyUI 圖形化工作流的用家算是頗順手的整合。

項目核心是一個可視化鋼琴卷軸編輯器,支援點擊加音、Shift 框選、箭頭鍵移動、Undo/Redo 等基本操作,並提供 Instrumental 或 Sung 旋律模式。和弦面板可摺疊,匯入的 ABC 樂譜會保留 slash chord 等進階標記。換 Key 時同時處理旋律與和弦根音,最短轉調、超出音域會直接拒絕而非裁切音高,設計上偏向「樂理正確」多於「暴力生成」。

音訊輸出走 YuE2-3B 加獨立 VAE 解碼器,產出 48 kHz 立體聲,內建瀏覽器合成器可預覽節段節拍,但並非最終成品音色。LoRA 訓練流程則提供數據集檢視與 checkpoint 預覽,方便用家挑選權重繼續微調。

重點摘要
– 屬於 ComfyUI 自訂節點套件,整合 YuE2-3B 音樂生成與樂譜編輯
– 鋼琴卷軸支援框選、群組移動、Undo/Redo,轉調按樂理而非裁切處理
– 推理與 AR LoRA 訓練共用同一組節點,方便迭代
– 需 NVIDIA GPU 支援 BF16,已驗證 RTX PRO 6000 Blackwell,其餘 24 GB 配置未經驗證
– 首次執行約下載 7.8 GB 模型權重,支援中斷續傳與離線模式

適合已有 ComfyUI 基礎,又想嘗試可控音樂生成或自訓風格 LoRA 的用家。注意目前僅在 Windows + Python 3.12 + Torch 2.11 環境驗證,跨平台或較舊 GPU 仍需自行測試。

GitHub

Categories: 開源, ComfyUI, 模型, 模型訓練, NVIDIA, Audio, Python, 音樂, Dataset 數據集, 廣東話

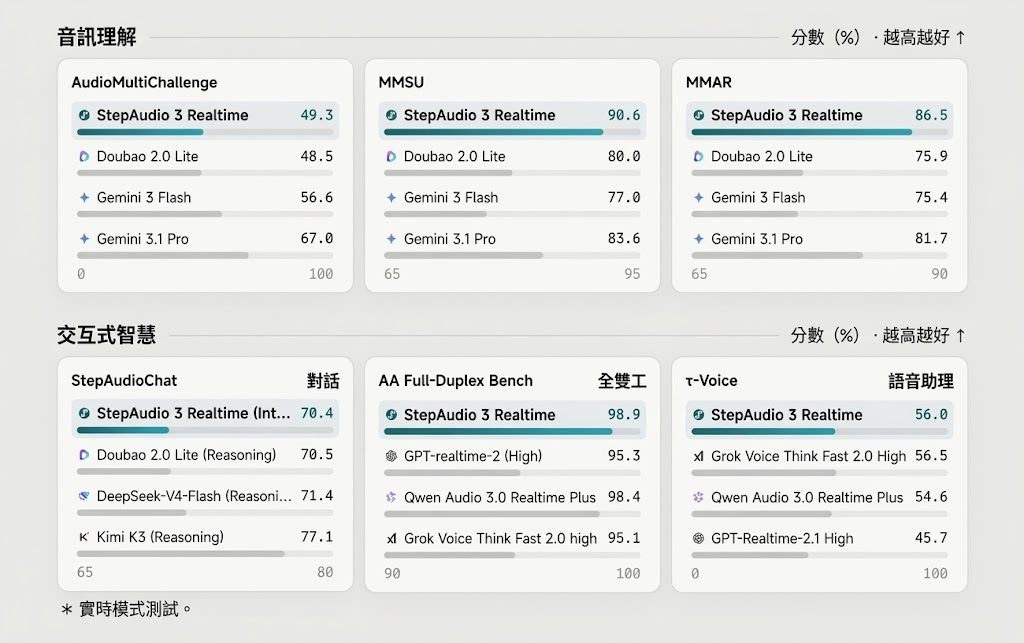
[技術文章]StepAudio 3 Realtime:邊講邊思考的即時語音模型

StepFun 推出 StepAudio 3 Realtime API,用「邊講邊想」機制打破語音對話的延遲與深度矛盾,做到即時回應同時保持複雜推理能力。

Hugging Face

StepAudio 3 Realtime API 由 StepFun-Audio 團隊開發,定位為音頻語言基礎模型,專門處理實時語音互動中最棘手的取捨:既要快速回應,又要進行深度推理。傳統語音助手往往犧牲思考深度換取低延遲,這套模型用「Think-While-Speaking」(邊講邊想)機制,讓模型在語音輸出的同時私下執行推理,從而兼顧即時性與邏輯深度。

整體架構圍繞連續的「聆聽—對話—思考—行動」循環運作。Deep Perception 模組負責捕捉豐富的聲學線索,理解用戶意圖;Seamless Duplex 模組則同步處理音頻流,妥善應對停頓、插話、打斷等自然對話現象。在推理模式下,模型在 StepAudioChat 基準達到 73.0 的宏觀平均分數,啟用 Think-While-Speaking 後,對話與推理表現可媲美專門的推理模型,同時保持即時語音輸出。

這套方案的核心矛盾在於延遲與推理深度的對立,Think-While-Speaking 的並行設計試圖打破這個零和遊戲,讓語音助手不再需要在「答得快」與「答得深」之間二選一。

重點摘要:
– 核心架構:Deep Perception + Seamless Duplex + Think-While-Speaking 機制
– 效能表現:StepAudioChat 基準 73.0 宏觀平均分,推理模式對標專用推理模型
– 設計目標:解決語音對話中低延遲與深度推理的傳統矛盾
– 開發團隊:StepFun-Audio Team(StepFun 旗下)

項目主頁 · Paper

Categories: Agentic, Audio, 語音

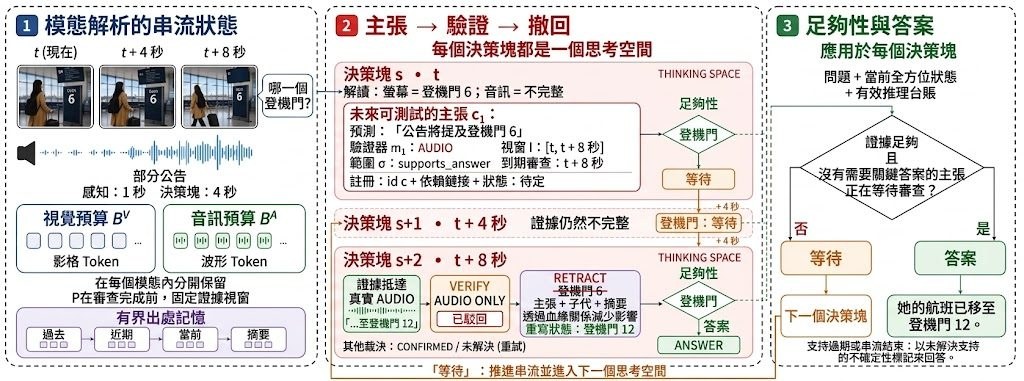
OST:可撤回串流推理的「過早下結論」

香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

video-to-h3-prompt SKILL:逐幀反推參考影片,自動生成可貼即用 H3 提示詞

項目把『看幾幀就寫 vibe』的拍腦袋流程,換成五通道取證管線:密集抽幀、音頻交叉驗證、因果事件鏈、剪輯層分離,最後產出對應 MiniMax H3 五種輸入模式的完整模板。

Repository image for LoveRain1997/video-to-h3-prompt

如果你試過把一段參考影片丟給 AI 影片模型、要它重做或延伸,應該都撞過同一面牆:憑『整體 vibe』寫提示詞,往往會錯過動作、把 BGM 誤認為現場聲。今次做的是把這個『創作猜測』變成可驗證的逆向工程,輸出可直接貼進 MiniMax H3 的提示詞骨架。

做法上,它不放棄『一對多逆問題』的本質——同一段畫面,背後劇本可以是 A 也可以是 B。它讓多個候選劇本同時存在,再用 4–8fps 密集抽幀和 0.5s RMS 去裁決哪個版本站得住。同時,頻譜圖負責分辨音樂與環境聲。

它對剪輯層的處理也相當細:定格哏、白色閃屏、漫畫風的集中線/網點/狀聲詞,全部歸入 editing 與 overall_soundscape,不會和實景動作混在一起。因果事件鏈(trigger→action→reaction)則把袖口、單手、車頭外殼這類畫面邊緣的施力者也算進演員名單,避免關鍵 3–5 幀就這樣消失。

對 Coser/換角場景,它只換外表不改劇本,再做動作相容性檢查、分級道具,並把動漫設定翻譯成真人 cosplay,最後吐出一張替換表。輸出端覆蓋 T2VA、I2VA、FL2VA、L2VA 的 14 欄模板,以及 Ref2VA 的六段模板,全部用 <Subject>/<Picture>/<Video>/<Audio> 標籤紀律收束。

適合想用影片反推 AI 影片提示詞的人:二創作者、廣告分鏡、動漫改編的工作流。比起『看幾幀就 vibe』,它的取捨是慢、但每一步都有可追溯證據;代價是要提供參考影片與可選劇本線索,並接受密集取證帶來的額外處理成本。

重點摘要:
– 五通道取證管線取代單一直覺寫 prompt
– 密集抽幀 + 音頻峰值用作裁決證據,而非裝飾
– 剪輯層、漫畫後製、鏡頭外施力者都獨立建模
– 覆蓋 H3 五種輸入模式,欄位與標籤紀律齊備
– 換角只動外表,動作相容性與道具分級有 SOP

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, Video, Audio, 提示詞, Content Creator, MiniMax, Skill 技能

Page 5 of 12
1 … 3 4 5 6 7 … 12