Digital Human Koubo:一句需求生成數字人口播廣告,連聲音也自動完成

相片加一句需求,就能串起數字人口播、字幕與影片包裝;代價是依賴外部雲端生成。

一張相片加一句需求,便可生成有數字人口播、字幕和促銷包裝的短片。andyhuo520/digital-human-koubo 是由人工智能(Artificial Intelligence,AI)代理執行的影片工作流,串連文案、對嘴、聲音整理和剪輯。

主持人設定存於 persona.json,固定外觀和聲線描述;GPT Image 合成場景後,Grok Video 1.5 經 Renoise 的 Model Context Protocol(MCP)製作每段最多 15 秒的口播片。按 SKILL.md 配置代理並連接服務後,可先看倉庫示例;其中一條 27 秒廣告耗用 482 Renoise credits,不能視為固定價格。

  • Whisper 逐段轉錄核對文稿,每段檢查 4 格畫面;若畫面出現生成字幕,該段會重做。
  • 頻譜匹配、去齒音及響度標準化協助統一分段聲音;測試中的齒音差距由 13.2 dB 降至 5.9 dB。
  • 48 項影片包裝手法參考 25 條創作者影片整理,可按需要增減。

這套流程適合需要反覆製作商品介紹或社交平台短片的小型內容團隊,也能把文字置於主持人身後。成品仍受外部模型服務和點數成本限制,使用前宜先檢查口型、畫面及人物一致性。

GitHub

Categories: 開源, AI productions, MCP, 數字人, 模型, Video, Image, Audio, Content Creator, 庫, Skill 技能

CapCut 以外,Concat 把影片剪輯搬回本機

想剪片但不想上載素材、註冊帳戶或處理浮水印?開源影片編輯器 Concat 提供本機字幕、語音與多軌剪輯功能。

Concat

剪短片、上字幕、替換背景,卻不想先建立帳戶,把原片交給雲端平台處理,Concat 提供了另一條路。這個跨平台開源影片編輯器把自動字幕、文字轉語音、聲音複製、背景移除、多軌剪輯及 4K 匯出放進同一個介面,支援 macOS、Windows、Linux 與 Android。

Concat 屬於桌面及流動裝置影片編輯工具,核心特色不是追求完整取代所有專業軟件,而是針對 CapCut 常用的剪輯流程,減少上載素材及依賴訂閱的摩擦。自動字幕由本機 Whisper 處理,選擇模型大小後即可把字幕放上時間軸,再配合文字轉語音、關鍵幀動畫、特效及標題完成內容製作。

這項取捨十分清楚:素材可完全留在本機,離線工作,不會因平台政策改變而失去作品控制權;但代價是本機運算能力會直接影響字幕生成等功能的處理速度。Concat 亦提供語音複製,只需數秒錄音便可建立聲音,適合處理旁白、角色對白及多語言版本,背景移除則涵蓋人物、物件,亦可自行修正遮罩。

  • 支援 macOS、Windows、Linux 及 Android
  • 本機 Whisper 自動字幕,無須上載影片
  • 提供文字轉語音、聲音複製及背景移除
  • 支援多軌剪輯、關鍵幀、特效、標題與 4K 匯出
  • 無浮水印、無需帳戶,亦沒有上載限制或訂閱費用

對內容創作者、獨立製作者、教育工作者及需要處理敏感素材的團隊而言,這是一套頗完整的本機工作流。多軌剪輯、位置、縮放、旋轉、透明度及音量關鍵幀控制,令它不只停留在簡單裁片工具;惟目前版本號仍為 0.2.8,跨平台的成熟度、介面細節及不同裝置上的匯出表現,仍須經實際作品驗證。

GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, Video, Audio, 軟件, 工具, Content Creator, Mac, Linux, 語音, 動畫

video-use:一句指令把素材剪成 final.mp4

video-use 將 Claude Code、FFmpeg 與 AI 動畫工具串成影片剪輯流程,適合需要快速製作短片的創作者與內容團隊。

video-use

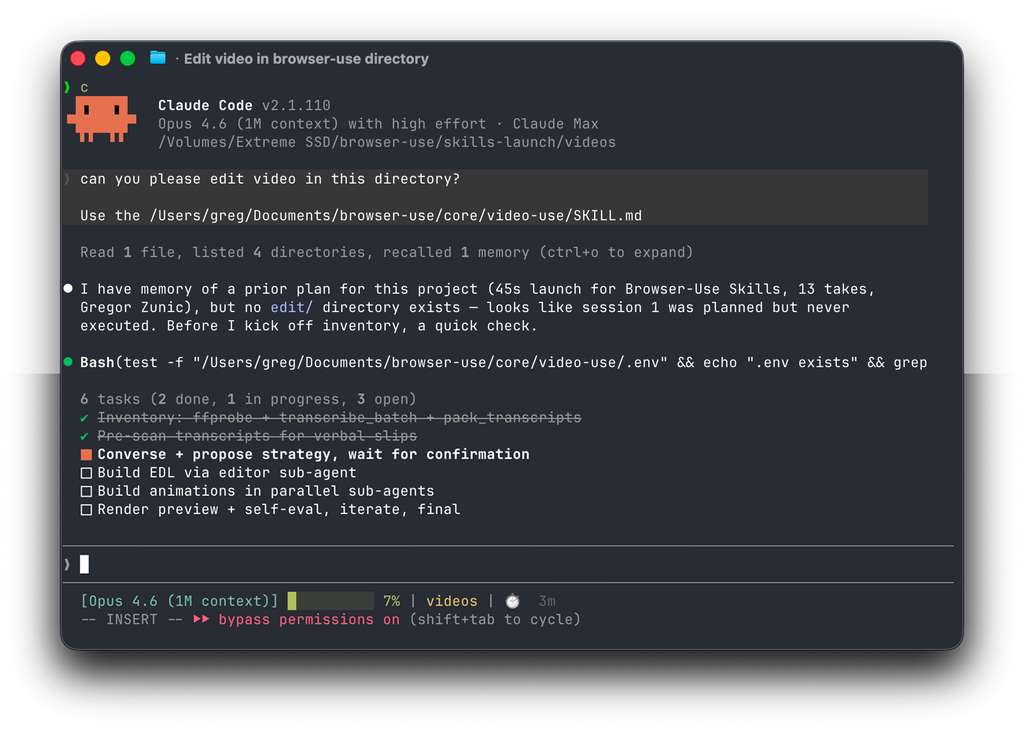
剪片最花時間的往往不是逐格拖拉,而是刪去口誤、停頓、重拍,再處理字幕、調色和動畫。開源項目 video-use 將這些工作整合到 Claude Code 對話中:把原始素材放入資料夾,提出剪輯要求,確認方案後便可取得 final.mp4。

它屬於 Agent 影片剪輯工具,依賴 FFmpeg、ElevenLabs API,以及支援 shell access 的 Agent;Claude Code、Codex、Hermes、Openclaw 等均可按技能方式整合。Agent 會先盤點素材並提出策略,待你確認後才進行剪輯,亦可用 project.md 保存跨次工作的記憶。

  • 自動移除「umm」、「uh」、重試開頭及拍攝間的空白
  • 支援預設或自訂 FFmpeg 調色,並在剪接點加入 30ms 音訊淡出
  • 預設以每兩字一個大寫單元燒錄字幕,樣式可自行調整
  • 可並行呼叫 HyperFrames、Remotion、Manim 或 PIL 製作動畫疊層

這種做法省去大量重複剪輯操作,也毋須在預設項目與選單之間來回切換。代價是成果會受素材品質、Agent 判斷、FFmpeg 設定及 ElevenLabs 服務影響;影片內容、關鍵 API 費用與電腦運算資源仍要由團隊控制。它適合對話式影片、教程、旅遊片段、訪談及社交媒體短片,但複雜敘事和高度精準的專業後期仍需要人工覆核。

影片輸出前,工具會逐個檢查剪接點,協助發現突兀轉場或音訊爆音;然而自我評估並不等同真人審片。採用這個項目時,重點不在追求完全自動,而在讓 Agent 先處理機械而重複的工序,把最後一輪節奏、內容與品牌審校留給創作者。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, Audio, 工具, Content Creator, OpenClaw, Anthropic, 動畫, Skill 技能

RubatoCodec:深入神經音訊編碼 – 殘差向量量化(RVQ)與高保真重構架構

固定長度切分未必適合語音的每個片段;RubatoCodec 按訊號變化分配事件,並可逐段解碼,面向低位元率語音處理與串流生成。
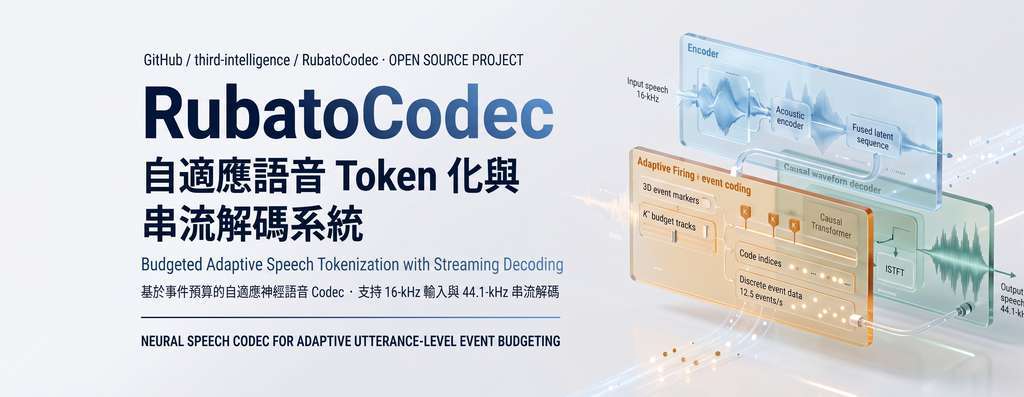
RubatoCodec architecture

語音片段的資訊密度各有不同,若一律按固定長度切分,便難以按內容分配編碼資源。RubatoCodec 是神經語音編碼器,會把語音轉成帶有離散碼索引和持續時間的可變長事件,並支援逐段重建波形,適合需要控制碼率或串流輸出的語音系統。

它在 50 Hz 潛在表示上,參考多尺度潛在特徵差異和波形頻譜通量,累積分配事件;預設目標比例為 0.25,整段語音的事件數則按公式精確控制。這種做法毋須另設邊界預測器、邊界標籤或 rate loss,但仍需把事件持續時間一併納入編碼,不能只看碼索引的位元率。
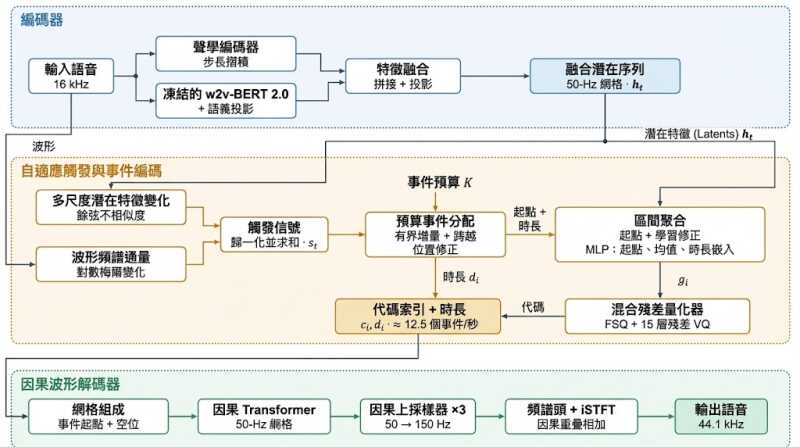
量化器採用 16 層混合式殘差結構:首層是接受語義監督的 FSQ,其後 15 層使用 DAC-style residual VQ。解碼時可選用 1 至 16 層的任意前綴深度,名義碼索引位元率約為 150 至 2,400 bit/s,另加持續時間資訊;模型以約每秒 12.5 個事件表示語音,輸入為 16 kHz,因果串流解碼器輸出 44.1 kHz。

每個事件代表約 80 毫秒音訊,在 H200 上解碼約需 11 毫秒,具備逐事件或分批解碼的條件。這是硬件與模型設定下的速度數據,不能直接當成其他設備上的延遲保證;現有資訊亦未提供足以比較音質取捨的具體評測結果。

研究人員、語音模型開發團隊,以及需要低碼率儲存或即時音訊處理的系統,可用公開模型和 Python API 載入語音、編碼,再按指定深度解碼。重點包括:
– 事件長度按語音訊號變化調整,整段事件數受目標比例控制。
– 支援逐事件或分批串流解碼。
– 可選不同量化器深度,在碼率與表示容量之間調整。
– 編碼資訊除離散碼索引外,亦包括事件持續時間。
– H200 上每事件約需 11 毫秒解碼,其他硬件表現未有提供。

基本使用範例(推論與重構流程)

專案通常遵循標準 PyTorch 神經編解碼介面,基本 Python 處理流程如下:

import torch
import torchaudio
from rubatocodec import RubatoCodec

# 1. 載入模型與權重
device = "cuda" if torch.cuda.is_available() else "cpu"
model = RubatoCodec.from_pretrained("third-intelligence/RubatoCodec").to(device)
model.eval()

# 2. 讀取並預處理音訊(重取樣至模型支援之採樣率)
waveform, sample_rate = torchaudio.load("input.wav")
if sample_rate != model.sample_rate:
    resampler = torchaudio.transforms.Resample(sample_rate, model.sample_rate)
    waveform = resampler(waveform)

waveform = waveform.unsqueeze(0).to(device)  # [Batch, Channels, Time]

# 3. 編碼:提取離散 Tokens (RVQ Codes)
with torch.no_grad():
    # tokens 形狀通常為 [Batch, Num_Quantizers, Frames]
    tokens = model.encode(waveform)

# 4. 解碼:由離散 Tokens 還原音訊波形
with torch.no_grad():
    reconstructed_waveform = model.decode(tokens)

# 5. 儲存重構音訊
torchaudio.save("reconstructed.wav", reconstructed_waveform.squeeze(0).cpu(), model.sample_rate)

GitHub · 模型
Categories: 開源, 模型, NVIDIA, API, Audio, Python, 語音, Dataset 數據集

PawCT:分拆四聲部合唱

把合唱錄音轉成可分辨女高音、女低音、男高音與男低音的 MIDI 音符,有助排練和樂譜重建。PawCT 直接輸出四部聲線,並以 YouChorale 測試其分部能力。

Ground truth, PawCT, PagCT, and PagCT plus Post-VA piano rolls

要從整隊合唱錄音還原各聲部,難處不只是聽出音符,還要判斷每個音符屬於哪一部。PawCT 是一套合唱自動音樂轉錄(Automatic Music Transcription,AMT)研究模型,會把混合錄音轉成女高音、女低音、男高音與男低音(SATB)的獨立音符軌,適合用於排練準備、音樂教育和樂譜重建。

PawCT 亦提供 PagCT,先轉錄不分聲部的合併音符軌;另一個基線 Post-VA 則在第二階段,按符號音樂資料為音符分配聲部。PawCT 把聲部辨識納入端到端轉錄,並以共享編碼器配合 SATB 專屬的起音、延音結束及音框輸出頭;音域先驗(RP)和有序連續性先驗(OC)則在訓練損失中限制不合理音域與旋律走向,推理時毋須額外模組。

YouChorale 的 PagCT 的單軌音符 F1 為 0.382,高於 Yu et al. (2024) 的 0.237;SATB 平均音符 F1 則由 PagCT 加 Post-VA 的 0.175,升至 PawCT 加 RP 與 OC 的 0.225。

  • 想取得單一音符軌,可測試 PagCT;需要分開四部聲線,則應看 PawCT 的輸出。
  • 模型、訓練、評估、視覺化及釋出檢查程式碼均已納入儲存庫,另有線上示範與程式碼導覽可供參考。
  • YouChorale 的音訊、標註、MIDI 檔案及生成預測並未一併公開,因此仍有待完整重現。

對音樂研究者、合唱團排練者及開發音樂教育工具的團隊而言,PawCT 提供了直接檢視分部轉錄的研究起點;若只需合併音符,PagCT 的定位較簡單。現有公開內容較適合檢查方法與程式流程,重現比較實驗前則要先核對資料、評估協定和歷史設定是否齊備。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Audio, 工具, 庫, 語音, 音樂, Dataset 數據集

FocusGUI 自動揀對的訊息做 GUI 代理

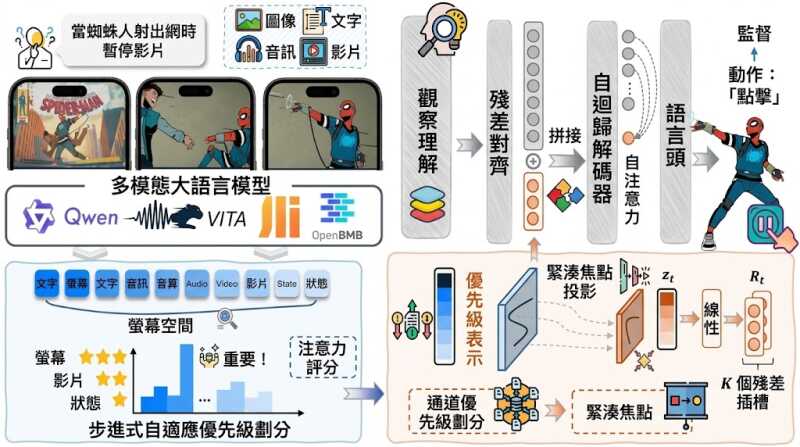
南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。

對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

DuET 鋼琴演奏轉譜新模型:音符與幀並行編碼

DuET 把鋼琴演奏 MIDI 轉成結構化樂譜,靠音符與幀雙編碼加上節拍監督,音訊輸入可經 Transkun v2 串接。

DuET architecture

鋼琴演奏轉譜(Performance-to-Score Transcription)一直有個難題:演奏帶有彈性速度、踏板與力度,傳統音訊轉譜方案往往把節奏「拉直」,忽略了 rubato 與呼吸。DuET 採用 Note–Frame 雙編碼結構,音符分支處理離散音高與時值,幀分支處理節奏細節,雙方透過雙向交叉注意力交換資訊,譯碼器輪流從兩個表示預測譜面屬性,目標是兼顧音高準確度與演奏的時序彈性。

節拍與強拍(beat 與 downbeat)做聯合監督,模型在學習譜面結構的同時也理解小節脈絡,這對 rubato 段落特別有幫助。位置編碼方面用上 TimeRoPE(相對演奏時間)與 TPRoPE(音程關係),讓模型對時間偏移與音高距離有更好的歸納能力。輸出涵蓋 MusicXML、聆聽用 MIDI 與結構化音符預測,方便樂譜軟體直接開檔。

輸入端支援 MIDI 直入;若要吃音訊,需要加裝音訊前端,流程是 Transkun v2 先把鋼琴錄音轉成 MIDI,再交給 DuET 處理。預訓練權重放在 Hugging Face(Wayne42/DuET),模型約 0.1B 參數,授權為 CC BY-NC 4.0,學術與非商業用途可直接取用。

對音樂技術研究者、數位音樂學(Digital Musicology)團隊、開發自動評分或伴奏系統的人來說,這類保留演奏細節的轉譜工具比純音訊轉譜更貼近真實場景;鋼琴老師想把學生錄音整理成樂譜、作曲人要做編曲分析,也都能直接受惠。Demo 已上架 Hugging Face Spaces,可先試效果再決定是否部署。

重點摘要:

  • 雙編碼設計:Note encoder 與 Frame encoder 經雙向交叉注意力融合,兼顧音準與節奏彈性
  • 節拍聯合監督:beat 與 downbeat 同時學習,有助處理 rubato
  • TimeRoPE + TPRoPE:相對時間與音程關係的位置編碼
  • 輸出齊全:MusicXML、聆聽 MIDI 與結構化音符預測,主流樂譜軟體可開
  • 權重與 Demo:Hugging Face 提供 Wayne42/DuET 權重與 Spaces Demo,CC BY-NC 4.0 授權

GitHub · 模型

Categories: 開源, 模型, 模型訓練, Audio, 工具, 音樂

DeepMind Sierra AI 原生即時語音

Google DeepMind 與 Sierra AI 討論原生音訊模型,聚焦即時語音互動的速度、自然度與工程限制。

Og image

語音助手要做到自然對話,關鍵不只是把文字轉成聲音,而是要在用戶說話期間理解內容、掌握語氣,並快速作出回應。Google DeepMind 的 Valeria Wu 與 Sierra AI 的 Soham Ray 透過對談,介紹原生音訊模型如何處理這類即時語音 AI 的核心問題。

討論內容集中於 native audio models,以及建立更流暢即時語音系統時遇到的挑戰。相較於把語音先轉成文字、再交由文字模型處理的流程,原生音訊模型直接處理音訊訊號,有機會保留更多語調、停頓和對話節奏;但系統仍要兼顧理解準確度、回應延遲和運算成本。

內容涵蓋的重點包括:
– 原生音訊模型如何支援更自然的語音互動
– 即時對話中延遲與回應流暢度的取捨
– 建立高質素 voice AI 所面對的工程挑戰
– Google DeepMind 與 Sierra AI 對下一代語音體驗的觀察

這段內容適合關注語音介面、客服自動化、AI agent 和多模態模型的讀者。影片沒有提供完整技術規格或獨立效能測試,因此較適合作為理解發展方向與產品設計難題的入門材料,而不是部署指南。

影片介紹

Categories: Agentic, AI productions, 模型, 多模態模型, Google, Gemini, Video, Audio, 語音, 安全

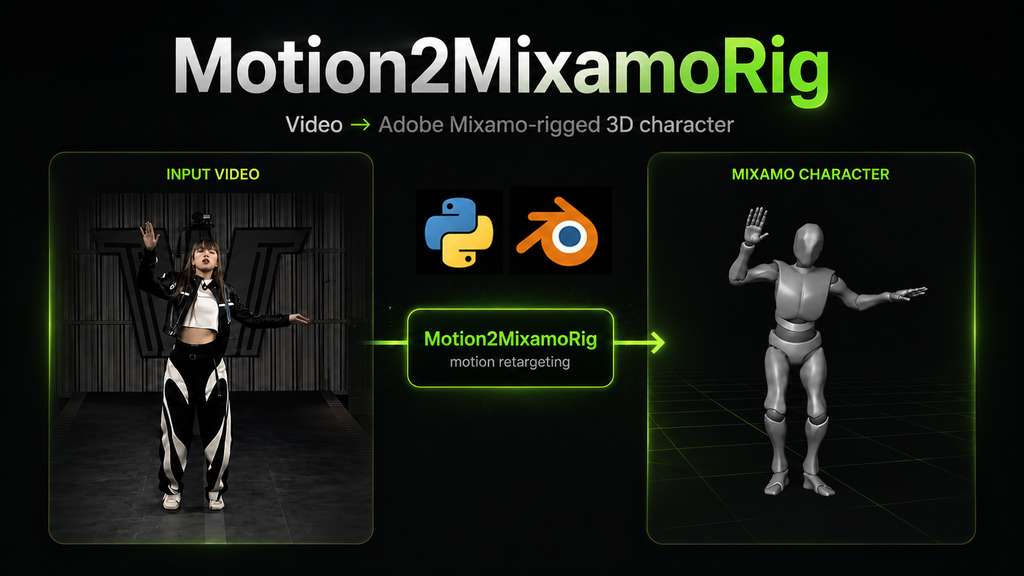
Motion2MixamoRig:把真人動作搬入 Mixamo 角色的開源工具

Motion2MixamoRig 將單人影片或照片姿勢轉成 Mixamo 角色動作,直接輸出可供 Blender、Unity 使用的 3D 檔案。

Motion2MixamoRig

把單人動作影片或一張姿勢照片套到 Mixamo 角色上,Motion2MixamoRig 便可輸出預覽影片及帶蒙皮的 .glb 角色檔,減少遊戲開發者重新製作基礎動作的工序。它屬於 3D 動作轉移工具,處理的是真人影像與已綁定骨架角色之間的動作銜接問題。

流程以 SMPL-X、GVHMR 等模型先從影像估計人體動作,再將結果映射到 Adobe Mixamo rig;模型不負責生成全新動作,而是把影片或照片中的姿勢重建後套用到指定角色。輸出可放入 Blender 或 Unity,仍要留意單人畫面、遮擋、鏡頭角度及原角色骨架會影響結果。

模型權重首次執行時約需下載 5 GB;原始資料沒有提供正式性能基準或準確率數字。項目目前仍屬 experimental,0.1.0 提供 command-line pipeline,亦附有 Blender 4.2+ Extension,並在外部 Python 環境執行同一套流程。

  • 支援影片動作及單張照片姿勢
  • 輸出預覽影片與 .glb 檔案
  • 兼容 Blender、Unity 工作流程
  • 需要單人素材及外部模型權重

遊戲原型、角色動畫測試及需要快速重用真人動作的團隊較適合採用。ffmpeg 並非流程必需,但缺少它會令輸出影片沒有聲音,並可能無法在瀏覽器播放;對需要穩定製作級動畫的人員而言,仍要自行檢查骨架映射、腳部滑動和遮擋造成的誤差。

GitHub

Categories: 開源, AI productions, 數字人, 模型, Video, Image, Audio, 工具, 3D, Python, 庫, 動畫

YuE2 Studio 由樂譜到成曲:讓 AI 音樂可編輯重做

YuE2 Studio 先把風格與歌詞寫成可修改樂譜,再生成完整人聲歌曲,讓 AI 作曲不再只剩一個音訊檔。

logo

由風格描述和歌詞開始,YuE2 Studio 會先產生旋律與和弦樂譜,再演唱成最長約 10 分鐘的完整歌曲。這個項目屬於本地執行的 AI 音樂製作軟件,處理的是生成歌曲後難以修改編曲、旋律和聲部的問題。

YuE2 由 M-A-P 開發,先以 ABC notation 記錄 composition,再輸出歌曲;使用者可以閱讀及編輯樂譜,之後以相同 composition 重新渲染不同聲音。它不是只提供一次性音訊生成,而是把 score 帶回製作流程,較適合需要反覆改歌詞、旋律或配器的創作者。

項目建基於 yue2.cpp,一個原生 C++/CUDA port;桌面介面則採用 Rust、React 和 Tauri,執行路徑不需要 Python、Node.js 或 launcher。Windows 提供安裝程式及 portable folder,支援離線運行;NVIDIA 顯示卡需要至少 6 GB VRAM,AMD 和 Intel 透過 Vulkan 的支援仍屬 experimental。

  • 先寫樂譜再生成演唱,保留 composition 的修改空間
  • 支援歌曲、stems、MIDI、lyric sheets、scores 和 videos 的檔案管理
  • 內置十段 equalizer,並提供 Winamp 頻率配置預設
  • 可在本地 GPU 執行,毋須依賴線上音樂服務

它較適合有歌詞、曲式或編曲要求的獨立音樂人、內容創作者,以及需要離線處理素材的團隊。硬件限制亦相當直接:NVIDIA 6 GB VRAM 是較穩妥的起點,非 NVIDIA 顯示卡則要接受 Vulkan 路徑仍可能不完整。

GitHub

Categories: 開源, NVIDIA, Audio, 軟件, 工具, Content Creator, Mac, Python, 音樂, 廣東話

Page 2 of 12
1 2 3 4 … 12