Super-Star:讓數字人邊聽邊做

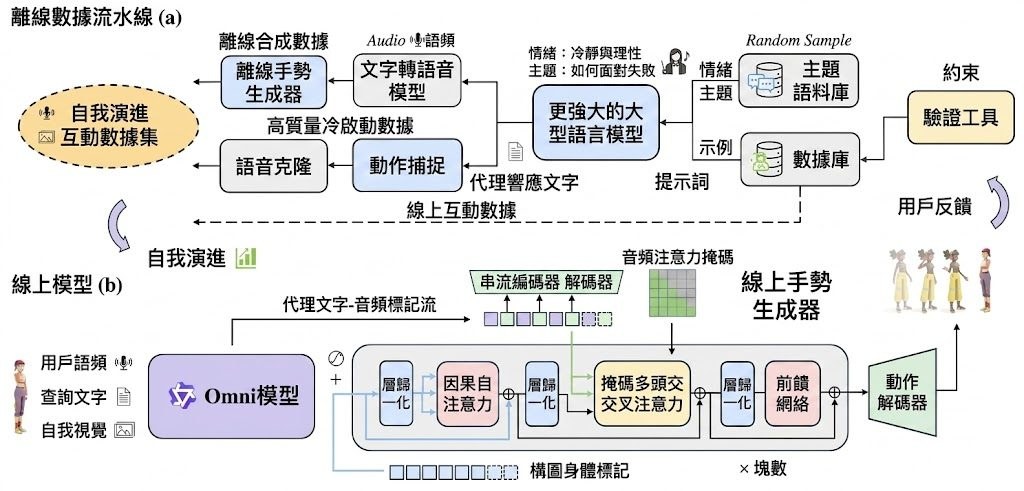
Super Star 將串流語音、對話和身體動作連成一條即時管線,令 3D 數字人毋須等待完整語音才開始配合手勢。

logo

數字人要一邊回應、一邊自然做出配合語氣的動作,關鍵不只是生成語音,而是不能偷看未來內容。Super Star 屬於面向 3D 數字人的即時互動框架,處理多模態輸入、串流回應語音,以及與語音同步的身體姿態生成。

Super-Star 把 Streaming Speech Response 與 Online Gesture Generator 兩個模組接合。前者採用 Qwen3-omni 產生串流回應語音,後者是因果多模態自回歸模型,根據目前收到的語音和 motion history 預測下一段動作,因此可在低延遲下生成手勢,不需等整段對話完成。

離線資料流程會按主題和情緒建立人機對話,再為回應語句生成 co-speech gestures;線上互動收集到的使用者偏好,會回流到 closed-loop self-evolving data pipeline,支援持續調整。相比先取得完整語音再生成動作的做法,Super Star 以較少未來資訊換取即時性,但動作預測亦更依賴目前語音片段和歷史狀態。

  • 串流語音與動作同步,適合虛擬陪伴、直播角色及互動式數字人
  • Qwen3-omni 負責回應語音,Online Gesture Generator 負責身體動作
  • 研究結果主張改善 latency-quality trade-off、語音動作同步及使用者偏好
  • 訓練 Motion Tokenizer 和 Online Gesture Generator 時需要 WAV 音訊
  • CUDA driver 需為 12.4 或以上,完整執行細節仍要配合 Qwen3-omni 及 vLLM-Omni 文件

提供的資料包含 training、inference 和 evaluation code。訓練部分使用 RQVAE 的第一層 codebook 解碼,對應論文線上模型採用的 VQVAE,測試者需要準備 WAV 檔案並填寫音訊路徑和輸出目錄。對研究團隊及需要低延遲數字人互動的開發者而言,項目較適合作為研究原型或客製化系統的起點,而非即裝即用的成品。
項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 多模態模型, 模型訓練, Qwen, NVIDIA, Audio, 3D, 語音, Dataset 數據集

TLive-Omni:專攻直播電商的多模態理解模型

TLive-Omni 將影像、影片、語音和文字統一成文字輸出,特別適合要即時理解直播內容的場景。它同時處理商品畫面、聲音與對話脈絡,目標是減少直播電商裡資訊斷裂的問題。

logo

TLive-Omni 是一個多模態理解模型,針對直播電商場景,把影像、影片、語音和文字整合到同一個文字輸出介面。對做直播監控、商品理解、內容標註或客服輔助的人來說,它處理的是同一場直播裡多種訊號難以對齊的問題。

這個項目建基於 Qwen3.5 backbone,再接入 AuT audio encoder 和輕量 MLP 對齊層,並用 timestamped Per-vGrid 把聲音片段和對應畫面放在一起。它支援最長 256K tokens context,適合長時間直播流的連續理解,而不是只看單段截圖或單句語音。

訓練流程分三階段 SFT,先做語音與語言對齊,再擴展到完整多模態指令跟隨,之後加入 Faithful-RFT,強調回答要貼近直播場景的即時需要。README 亦列出聲音辨識、講者分析、商品視覺定位、文字辨識、時序定位、影片密集描述和 omni-modal QA 等能力,顯示它不是單一功能模型,而是面向直播任務的綜合型系統。

  • 4B 和 9B 版本都已公開,方便按算力和部署成本選擇。
  • 在直播電商的音訊、影像和影片任務上有不錯表現。
  • 對一般基準也有泛化能力,不只局限於單一場景。
  • 更適合需要長上下文、多訊號同步分析的團隊。
  • 取捨在於它很聚焦直播電商,未必是通用多模態助手的最佳替代。

整體來看,TLive-Omni 把直播場景最麻煩的訊號對齊、長上下文理解和即時回答放在同一條路徑處理,對做電商直播分析、內容審核和銷售輔助的團隊會更實用。它的價值不在於把功能堆滿,而在於把多模態理解收斂到直播工作流裡真正會撞到的問題。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 多模態模型, Qwen, Video, Audio, 語音

WeMM-Embedding 統一多模態向量

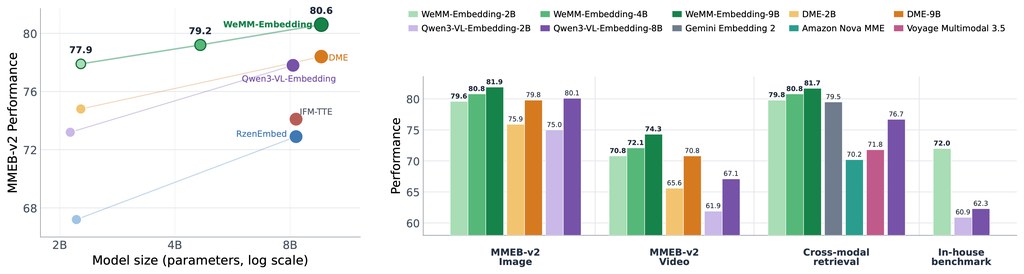
WeMM-Embedding 把文字、圖片、影片和視覺文件放進同一套向量空間,適合要做檢索、比對和跨模態搜尋的場景。它同時提供不同尺寸選擇,方便在準確度與成本之間取捨。

WeMM-Embedding Performance Overview

WeMM-Embedding 是一組多模態 embedding 模型,目標是把文字、圖片、影片、視覺文件和交錯式多模態輸入,轉成可直接比對的統一向量。對要做搜尋、相似度比對、內容檢索或跨媒體匹配的團隊來說,這種做法比逐一分開處理不同素材更省事。

它提供 2B、4B、9B 三個版本,還支援 Matryoshka dimensions,代表可以按需要輸出不同長度的 embedding,減少計算和儲存成本。README 也提到,向量來自 <embedding> token 的最後一層 hidden state,再做 L2 normalization;目前不支援 audio。

實作和試跑方式都算直接,既可以用 transformers,也可以用 SentenceTransformer 直接載入 Hugging Face 模型 ID。作者同時標明推理較建議用 transformers==5.2.0,原因是較新的版本在前處理行為上可能有差異;serving 方面則測過 vLLM 和 SGLang。

  • 統一處理 text、image、video、visual document 和 interleaved multimodal inputs
  • 支援 Matryoshka dimensions,可按成本需要縮短 embedding 長度
  • 適合做跨模態搜尋、內容去重、相似度比對和檢索索引
  • 推理可用 transformersSentenceTransformer,部署可接 vLLM、SGLang
  • 現階段不支援 audio,做語音相關流程要另配其他模型

對要處理多媒體內容的應用團隊、檢索系統、內容平台和資料整理流程,這類模型最直接的價值是減少多套表示法之間的銜接成本。它在多個基準上取得領先結果,但實際選型仍要看你要的是完整維度、較低成本版本,還是偏向部署效率的配置。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, Embedding, 模型, 多模態模型, Video, Image, Audio

JoyAI-Echo: 拓展長音訊視訊生成技術

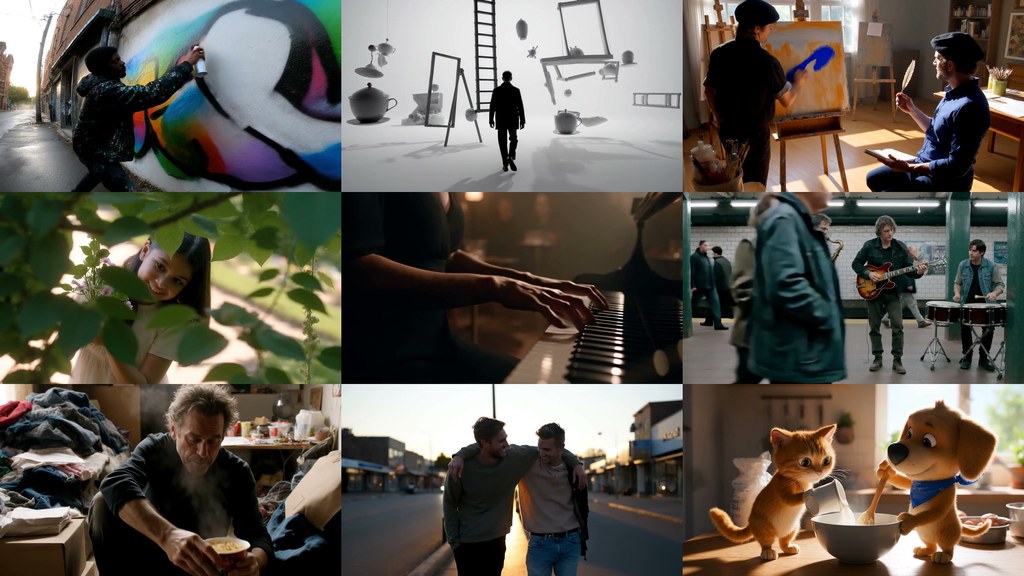
它把文字轉影片做成可跨鏡頭延續的音畫生成流程,重點不只是一段片,而是人物、聲音同場景連貫下去。ComfyUI 節點版本可配合官方推理管線,方便逐鏡調整。

JoyAI-Echo generated video gallery

JoyAI-Echo 是一個面向 text-to-video(T2V)同多鏡頭長片段生成的模型項目,處理的是短提示詞難以撐住長篇敘事、角色外觀與聲音容易斷裂的問題。它的做法不是單段出片,而係用跨鏡頭 memory 去維持故事連貫,連動音畫一致性。

官方說明強調它走 full bf16 precision,唔採用 GGUF quantization,目標係貼近正式推理管線的輸出。現階段支援 T2V,同多鏡頭長視頻;image-to-video(I2V)未支援。另有 ComfyUI_JoyAI_Echo 節點包,適合想喺工作流入面逐鏡改 prompt、即時預覽、再串接後續鏡頭嘅人。

  • 可做長篇音畫故事,展示例子去到 10 分鐘
  • 支援少步數生成,長片與 causal world model 都偏向快速推理
  • cross-shot memory 會保留角色外觀、聲線同連貫性
  • ComfyUI 版本方便分鏡調整,同官方管線保持一致
  • 目前重點在 T2V,多鏡頭長片段,未覆蓋 I2V

它和一般單段影片模型最大分別,在於將「一段生成得像」推進到「多段接得住」。如果要放進實驗室、內容團隊,或者做互動世界、長敘事原型,這種可續接的記憶機制會比只看單次輸出更實用;但代價是對 GPU 記憶體要求高,官方節點提到 48GB VRAM 同 GPU memory hot-swap 才較穩陣。

項目主頁 · GitHub

Categories: 開源, ComfyUI, 多模態模型, 視頻模型, 世界模型, Video, Image, Audio

GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

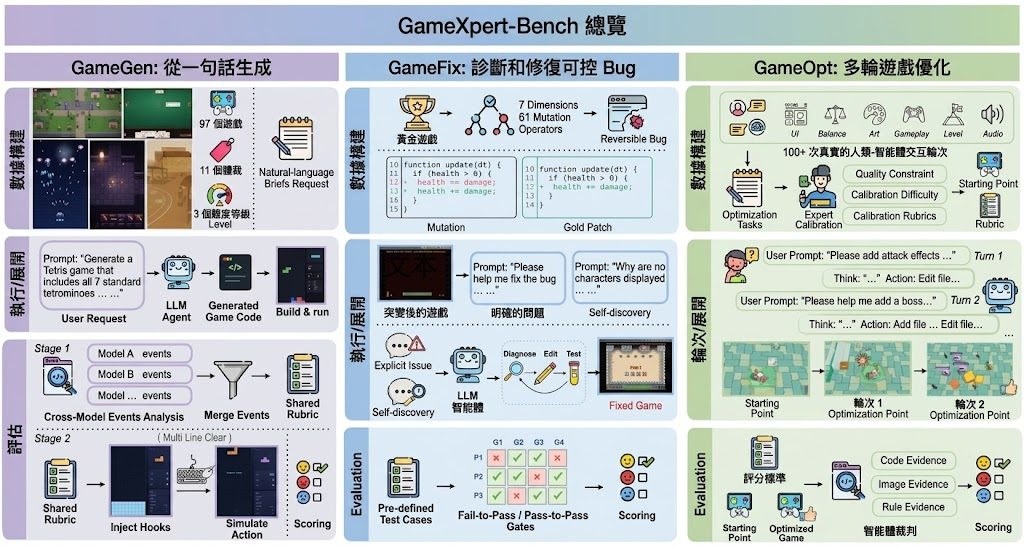
騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

Comfyui-MMH3-UltimateUpscale:長片放大不再受顯存牽制

ComfyUI 新增單節點升頻方案,讓 MiniMax H3 長片在有限 VRAM 顯示卡上處理,同時保留原有音訊。

Repository image for bbaudio-2025/Comfyui-MMH3-UltimateUpscale

長片、高解像度加上有限 VRAM(Video Random Access Memory)通常意味著要大幅降低輸出要求,但 Comfyui-MMH3-UltimateUpscale 把 MiniMax H3 的 AV latent 放進單一 ComfyUI 節點處理,目標是完成升頻而不破壞音訊。它屬於 ComfyUI 自訂工具,實際解決的是標準升頻節點無法理解 H3 視訊與音訊巢狀 latent 結構的問題。

節點會先以 temporal chunking 把長片切成重疊時間區段,再按需要進行 latent upscale,之後以 spatial tiling 分割畫面,逐塊完成 diffusion sampling,最後分別進行 spatial stitching 和 temporal stitching。每次只處理一個 tile,峰值顯存取決於單塊大小,而不是整段影片的長度或完整輸出解像度,代價是切割、重疊與拼接會增加處理時間及流程複雜度。

升頻有兩條路線:MMH3 Latent Upscale with Model Params 會載入 minimax h3 latent upscaler 3d .safetensors checkpoint,以 H3 3D model-based upscaler 改善 latent;MMH3 Latent Upscale Params 則只用 nearest、bilinear、area 或 bicubic 插值,不需額外模型,較省資源但不會補回模型推斷的細節。兩者都保留 32-channel audio,音訊部分不會重新取樣。

  • 長片可用 temporal chunking 分段處理
  • 高解像度可用 spatial tiling 控制顯存峰值
  • 單一 MMH3 Ultimate Upscale 節點包辦整個流程
  • 3D 模型升頻與免模型插值可按硬件取捨
  • 輸入必須是已完成去噪的 MiniMax H3 AV latent

這個項目較適合已經用 MiniMax H3 產生影片、但顯示卡顯存不足以一次處理完整片段的 ComfyUI 使用者,也適合需要保留同步音訊的影片製作流程。測試時應由較短片段及較細 tile 開始,確認模型 checkpoint、H3 節點及拼接結果正常,再逐步增加時間分塊和輸出解像度;它降低的是顯存門檻,並不代表長片升頻可以即時完成。

GitHub

Categories: 開源, ComfyUI, Video, Audio, MiniMax

NAPE 簡化自監督音訊片段訓練

NAPE 以因果 Transformer 預測下一個音訊 patch embedding,省去解碼器與 tokenizer,探索更精簡的音訊表徵學習方法。

NAPE Architecture

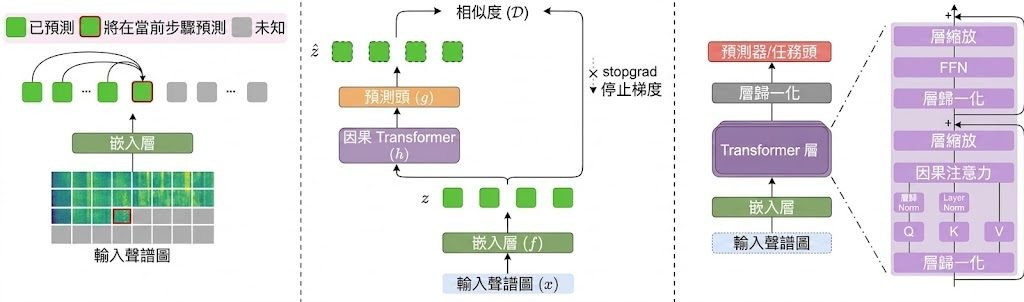
音訊模型要兼顧訓練成本、表徵能力與模型規模,往往需要加入多個輔助模組。NAPE(Next Audio Patch Embedding prediction)是一個自監督音訊表徵學習框架,將 log-mel spectrogram 切成 patch,再由因果 Transformer 根據前面的片段預測下一個 patch embedding。

NAPE 沒有 reconstruction decoder、acoustic tokenizer、student-teacher 架構或額外正則化損失。它依靠三個機制維持學習訊號:causal masking 隱藏未來位置、prediction shift 要求位置 t 預測 t+1,以及 stop-gradient 固定目標 embedding,避免模型退化成輸出相同向量。

二維 spectrogram 會按指定 scanning order 轉成一維序列,研究涵蓋 raster、diagonal、zigzag 和 time-major 四種排列;其中 raster、diagonal 及時間方向的排列較符合聲音事件的發展。模型在 AudioSet 預訓練,再於 AudioSet-2M、AudioSet-20K、ESC-50、Speech Commands V1/V2 和 IEMOCAP 進行微調或 linear probing,資料顯示它在多項任務取得 state-of-the-art fine-tuning 結果,並具備穩定的跨規模擴展能力,但原始資訊沒有提供各項具體分數。

要求系統有 Python 3.10、PyTorch 2.8.0 和 Transformers 4.56.2 的環境,並提供 requirements 檔及部分資料集處理程式;ESC-50、Speech Commands V1/V2 和 IEMOCAP 有下載腳本,AudioSet 則要自行處理涉及 YouTube 的下載流程。研究團隊亦列出程式碼及預訓練 checkpoint 的發布資訊,但 Hugging Face checkpoint 仍標示為待辦,不能把完整模型取得流程視為已經齊備。

  • 訓練訊號精簡:只用下一個 patch embedding 預測與 stop-gradient。
  • 適合音訊表徵:可支援語音指令、環境聲音及情緒辨識等任務。
  • 排列順序有影響:spectrogram 的線性化方式會改變模型看到的時間關係。
  • 測試門檻清楚:需要 AudioSet 或下游資料集,以及 W&B 追蹤實驗。
  • 限制在資料流程:AudioSet 不提供同等簡化的下載方式,checkpoint 取得狀態亦未完全明確。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, Audio, Python, 語音

MiniMax H3 整合成單一節點,ComfyUI 剪走繁瑣接線

把 MiniMax H3 的影片流程收成一個節點,省去搭工作流和找模組的時間。它更像一個整合入口,讓生成、延伸、關鍵幀同音訊驅動集中處理。

Buy Me a Coffee at ko-fi.com

在 ComfyUI 裡要跑 MiniMax H3 影片流程,最麻煩往往不是模型本身,而是工作流太碎。ComfyUI-ALLinONE-MinimaxH3 把這套流程收成單一節點,屬於 ComfyUI 的工具項目,目標是把文字生成影片、圖片轉影片、參考圖驅動、音訊帶動嘴型同影片延伸放進同一個入口。

安裝方式很直接:放入 ComfyUI/custom_nodes/ 後重啟 ComfyUI,再在畫布搜尋 ALL in ONE MiniMaxH3。項目主打幾個模式,包括 Image、T2V、I2V、R2V、Audio Drive、Keyframes、Extend 同 Chain,實際用法是先揀模式,再輸入 prompt 或參考素材,由節點接管後續流程。

官方 MiniMax H3 原生工作流、ComfyUI-H3-Motion-Context-MultiRef、MiniMax H3 Turbo pack,同埋 H3 Studio 的圖片模式都被包進同一個介面,對需要反覆試片段、接續鏡頭、處理多參考素材的影片製作流程特別實用。

  • 支援 T2V、I2V、R2V、Audio Drive、Keyframes、Extend、Chain
  • Chain 用 H3 Motion Context 做多段續接,走 latent path,避免重新編碼
  • 內建歷史、收藏同預覽,方便回看 prompt 同結果
  • 亦有 RTX / Seed2VR Video Super Resolution 的 upscale 接口
  • 作者標明仍屬 Beta,兼容性要跟指定版本和模型清單對齊

目前較適合已經在 ComfyUI 裡做影片生成、又不想每次重砌圖的人。官方工作流仍然是底層來源,呢個項目更像把常用路徑包成一個操作面,方便快速試片、改參考圖同續接片段。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

Google DeepMind 把手語 AI 放進用戶手中 涵蓋 30 種 ASL 詞彙

Google DeepMind 將手語識別 AI 整合到日常應用,讓失聰與健聽人士的溝通更自然。

A person signs with one hand while holding a smartphone, demonstrating the Gboard sign-to-text dictation feature.

聾人手語使用者日常面對的最大卡位,是怎樣讓手機或視訊鏡頭直接「讀懂」手語並即時翻譯。Google DeepMind 近期把手語 AI 從實驗室帶到實際產品中,覆蓋約 30 個美式手語(ASL)詞彙並透過 Gemini 模型支援即時回應,目標是讓聾人朋友毋須依賴真人翻譯就能完成基本對話。

這套技術並非單純的影像分類,而是結合姿態估計、語境理解與大型語言模型的能力,把手語動作轉成自然語言並維持對話節奏。比起過去只能辨識孤立詞彙的系統,現時更著重處理連續手語與多輪對話,使翻譯過程貼近真實交流節奏。

DeepMind 同時強調負責任部署,與聾人社區合作收集訓練數據,並透過小規模詞彙起步降低誤譯風險。對於依賴視訊通訊的聾人用戶來說,這項能力讓 Zoom、Meet 等場景下的溝通體驗更貼近健聽人之間的對話節奏。

這項功能適合手語使用者、聾人家屬,以及需要服務聾人客戶的企業。它並非要取代真人翻譯,而是作為日常輕量溝通的輔助工具,降低手語學習門檻並促進更即時的互動。

重點摘要:

  • 覆蓋範圍:支援約 30 個 ASL 詞彙,涵蓋日常問候與基本對話。
  • 技術核心:結合姿態估計與 Gemini 大型語言模型,處理連續手語與上下文。
  • 部署方式:整合到 Google Meet 等視訊應用,即時翻譯手語為文字或語音。
  • 負責任設計:與聾人社區協作訓練數據,從小規模詞彙起步降低誤譯風險。
  • 使用場景:聾人用戶日常視訊通話、聾人家庭成員溝通、企業客服聾人客戶。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, Video, Audio, Robotic, 安全, Skill 技能

MiniMax H3 人像寫實 LoRA,強化近鏡表情與電影感

基於 MiniMax H3 的人像寫實 LoRA,重點唔係加花巧風格,而係令面部、皮膚同鏡頭動態更自然可信。

Og image

近鏡人像、多人同框對話、手部動作呢類鏡頭,最容易暴露影片生成模型嘅細節破綻。呢個 Hugging Face 項目明確係基於 MiniMaxAI/MiniMax-H3 嘅 LoRA adapter,針對真人角色畫面再微調,重點放喺面部穩定度、皮膚質感、微表情同帶少少手持感嘅電影式運鏡,亦保留 MiniMax H3 原生同步音訊能力。

頁面提供嘅核心資訊相當集中:它屬於 text-to-video,授權採用 minimax-h3-community-license,主要檔案是 h3-realism-people-t2v.safetensors。使用方法唔複雜,要先喺 prompt 開頭加入 trigger word r34l1sm,再透過 fal 的 MiniMax H3 LoRA 端點掛載,範例 scale 係 1.0;想保留多啲 base model 原本味道,可以降到 0.6 至 0.8。

同類 LoRA 最大分別,往往唔係畫面變得幾誇張,而係同一個 prompt、同一個 seed 之下,能否穩定改善人物可信度。呢個項目用 before/after 方式展示 19 組對照,強調唯一變數係 adapter 本身,連 trigger word 兩邊都有加,目的係證明提升主要來自微調權重,而唔係提示詞技巧。頁面亦講明它係前作 MiniMax-H3-Realism-LoRA 嘅後繼版本,並且改用更大、更加聚焦人物題材嘅資料集重新訓練。

  • 基礎模型:MiniMaxAI/MiniMax-H3,關係標記為 adapter
  • 主要用途:強化寫實人物、近鏡面部、群眾、手部與紀錄片感鏡頭
  • 主要檔案:h3-realism-people-t2v.safetensors
  • 推薦控制:trigger word r34l1sm,LoRA scale 以 1.0 為預設,可降至 0.6-0.8

要留意,項目本質上係影片生成用嘅 LoRA,唔係可直接本地量化部署嘅通用文字模型。換句話講,它嘅價值更接近一個針對 MiniMax H3 補強人物鏡頭表現嘅專用適配器,而唔係完整獨立模型;使用場景亦明顯偏向 fal 平台上的 text-to-video 工作流。

模型

Categories: 開源, AI productions, 視頻模型, Video, Audio, MiniMax

Page 3 of 7
1 2 3 4 5 7