RATs 用多代理玩出機械人技能庫

RATs 把機械人學習拆成先玩、後解題兩段流程,重點不是微調,而是靠 LLM 代理寫程式累積可重用技能。

RATs pipeline overview — click to play the video

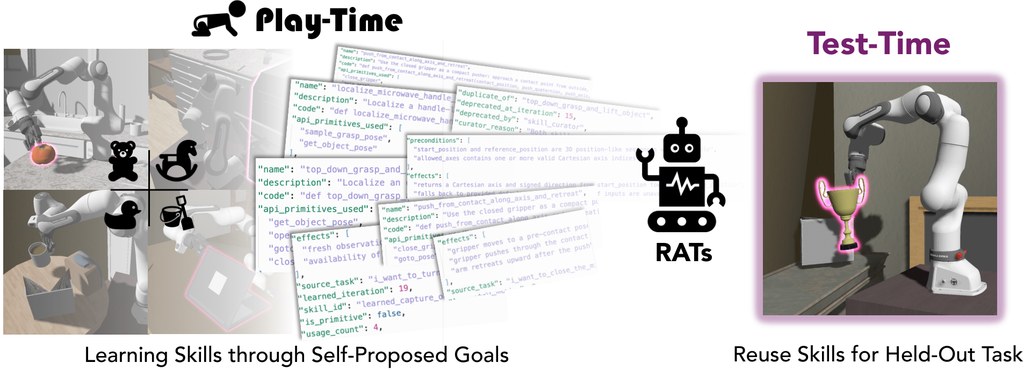
現有機械人代理很多時仍然沿用 task-driven 路線:先收到明確指令,再透過 Code-as-Policy 產生可執行程式來完成任務。RATs 則批評這種做法太依賴外部任務,令可重用技能只會在被要求時才出現,所以它提出一個多代理 Code-as-Policy 系統,先用 free-form play 自行發明練習目標,再把成功行為整理成技能庫。

這個項目屬於機械人學習框架,要解決的是機械人代理遇到新任務時,欠缺可直接調用的長期技能累積。RATs 分成 Play 與 Evaluation 兩段:前者由 proposer、planner、policy-writer、verifier、failure-diagnoser 幾個 LLM 代理協作,後者把已凍結的技能當成 planner context 重用,而且強調 no gradients、no RL,主要靠 structured natural-language feedback 與 code reuse 學習。

如果你想試這個項目,較適合把它當成研究型系統來跑 benchmark,而不是即裝即用小工具。環境要求包括 Python 3.10、CUDA-capable GPU,並牽涉 LIBERO-PRO、MolmoSpaces、Robosuite 及真實 Franka Panda 流程;比較合理的測試次序,是先看 Play 階段怎樣生成技能,再檢查 Evaluation 階段對 held-out tasks 有沒有改善。

它的創新點,在於把「玩」正式納入 lifelong robot skill learning:不是隨機探索,而是讓代理自己提出可學習任務、逐步驗證中間進度、失敗後再診斷重試,最後把成功執行蒸餾成 reusable skill library。這令技能可在跨環境情境重用,不一定綁死原本訓練場景。

論文給出的結果相當具體:在 LIBERO-PRO 與 MolmoSpaces,play-learned skills 相比 no play 與 random-play baselines 有提升,對 CaP-Agent0 分別高出 20.6 和 17.0 個百分點;把技能直接檢索進其他 inference-time Code-as-Policy agents 的 context,對 Robosuite 與真實世界 transfer 亦分別提升 8.9 和 8.8 點。相關模型與基線主要包括 CaP-X、CaP-Agent0,以及文中使用的 LLM agents 協作流程;若你關心 agentic robotics、技能重用與真機轉移,這個項目很值得細讀。

  • 類型定位:多代理機械人學習框架,核心是 Code-as-Policy 與技能庫重用
  • 方法重點:先 Play 自提任務學技能,再 Evaluation 把技能注入 planner context
  • 技術取向:不靠 gradients 或 RL,主要依賴自然語言回饋、程式修正與 code reuse
  • 適合場景:研究 embodied agents、robot skill library、cross-environment transfer 的團隊
  • 已提到的相關系統:CaP-X、CaP-Agent0、LIBERO-PRO、MolmoSpaces、Robosuite、Franka Panda
GitHub: https://github.com/Playful-RATs/rats

項目: https://playful-rats.github.io/

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Robotic, 框架, 工具, Python NLP, Python, , Skill 技能

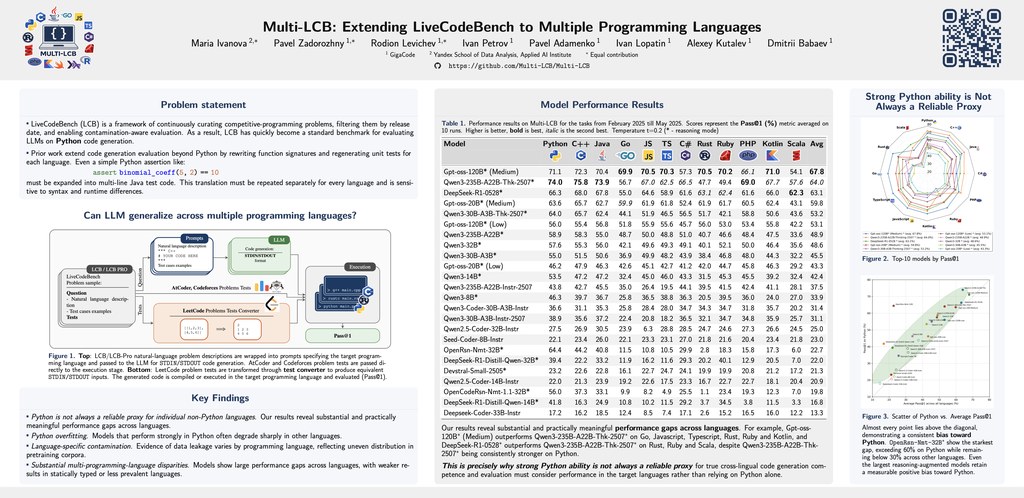
MultiLCB:即時追蹤程式模型表現

一個聚焦多語言編程能力的公開評測平台,可比較不同模型在時間變化下的表現。

codeLogo

MultiLCB(Multi Live Code Bench)是一個公開的編程模型評測項目,重點是用動態榜單和比較工具,觀察不同模型在多種程式語言上的表現。網站提供 Main Leaderboard、Model Comparison,以及按月份查看 pass@1 變化,適合想快速了解模型編碼能力的人。

這個項目處理的問題很明確:不少編程模型成績只停留在單次發布,難以看出時間變化、語言差異和推理設定的影響。MultiLCB 把資料整理成可篩選的介面,支援語言、難度、平台,以及是否使用 CoT(Chain-of-Thought)等條件,方便直接比較。

使用時,讀者可先在 Leaderboard 選擇日期範圍,再按 Python、JavaScript、TypeScript、Java、C++、C#、Go、Rust、Ruby、PHP、Kotlin、Scala 等語言篩選。若想深入看兩個或多個模型差距,可打開 Compare 頁面,用 pass@1 與平均分數交叉檢視,也可留意每月走勢圖。

  • 支援 LCB、LCB-PRO、LCB-PRO-AGENTIC 多種基準
  • 可按語言、難度、平台、CoT 條件篩選
  • 以 pass@1 為核心指標,方便直觀比較
  • 提供月份變化圖,較易看出模型進步或波動

這類項目特別適合模型研究者、AI 工程師、技術媒體,以及需要挑選 coding model 的團隊。從頁面可見,它偏向基準測試與橫向比較工具;至於數據來源、題目構成和完整評測方法,仍要配合站內 Code、Hf、Submit 或相關說明頁面再作確認。

項目: https://multi-lcb.github.io/

Categories: 開源, Agentic, 模型, Vibe Coding, 工具, Python NLP, Python, 編程

WAPO:穩定 RLVR 訓練時的損失函數項目

針對 GRPO 類方法的崩潰問題,加入 WAPO 等研究用損失函數。適合做語言模型強化學習與穩定性比較。

logobox

這是一個強化學習訓練工具項目,核心是為 Reinforcement learning with verifiable rewards(RLVR)加入多種損失函數,用來改善語言模型訓練時容易出現的崩潰問題。作者指出,傳統 GRPO 類方法雖然常見,但在 off-policy 更新下仍可能因梯度動態而失穩,所以這個 fork 直接把研究中的新損失實作進 vf.RLTrainer,方便對照測試。

項目內保留了 grpogspodr_dapo 等基線,並新增 wapo。其中 wapo 只針對正向回報的 rollout 更新,配合單向截斷與分組歸一化,思路比一般對稱 clip 更保守,目標是減少把模型推向錯誤方向的更新。

這個項目的新意不在於重新訓練一個模型,而是重新整理「哪些樣本值得被強化」這件事。論文提出的 gradient perspective 也把 token 層面的穩定性拆開分析,對想研究訓練動態的人很有參考價值。

適合以下人使用:
– 做 language model RLVR 研究的人
– 想比較 GRPO、GSPO、DR-DAPO、WAPO 差異的人
– 需要在數學推理或 multi-hop QA 做穩定性實驗的人
– 想沿用 vf.RLTrainer 再加自訂 loss 的開發者

性能方面,附帶的 arXiv 內容表示,WAPO 在數學推理與 multi-hop QA benchmark 上可提升訓練穩定性,並在多個模型家族上達到或超過基線。相關模型或方法包括 RLVR、GRPO、GSPO、DR-DAPO 與 WAPO。

GitHub: https://github.com/layer6ai-labs/wapo

Paper: https://arxiv.org/pdf/2606.16154

Categories: 開源, 模型, 模型訓練, Qwen, 工具, LangChain, LangGraph, Python, 深度學習

SeeQ 讓 VLM 學識自己出視覺問題

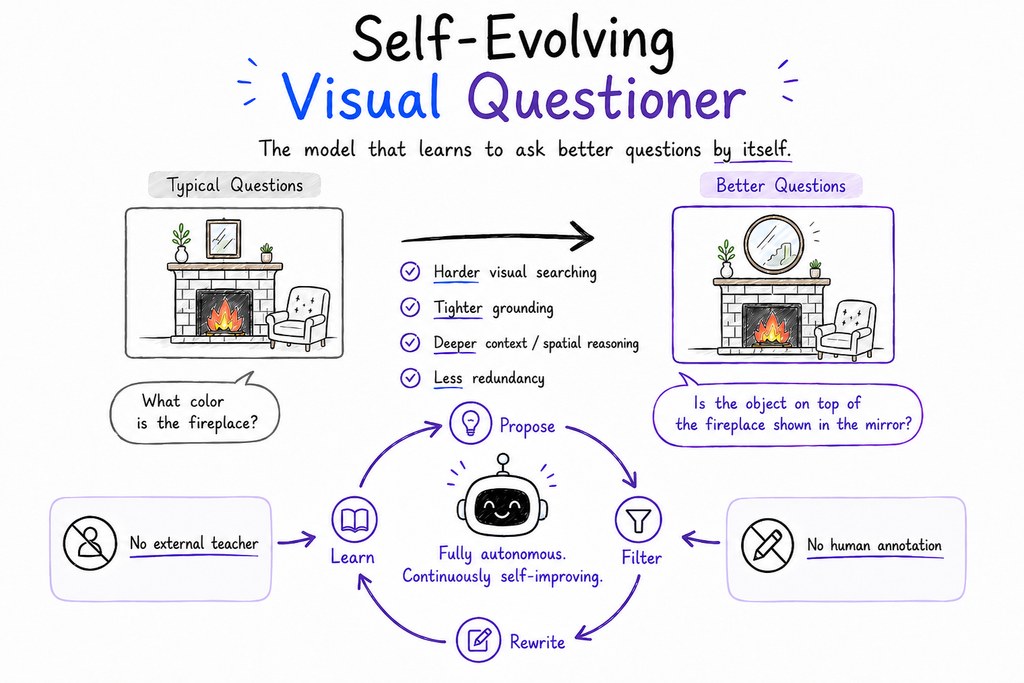
這個項目聚焦 Visual Question Generation,想解決高質視覺提問數據昂貴又難擴充的問題。它用自我演化流程,令 VLM 由答題者變成會主動發問的系統。

Cover Figure overview

現有 Vision-Language Models(VLMs)多數按「被動答題」範式訓練:人類或外部模型先提供問題,模型再學習回答。論文認為這種 fixed inputs 做法受制於靜態資料分佈,Visual Question Generation(VQG)亦容易卡在標註成本高、題目深度不足這兩個瓶頸,所以 SeeQ 提出 Self-Evolving Visual Questioner,用同一個 VLM 同時做 proposer 與 filter,自動從未標註圖片生產更難、更貼近畫面內容的問題。

這個項目屬於框架兼研究型工具,重點不是再做一個普通題庫,而是建立完整流水線:先生成 seed questions,再反覆改寫,提升 visual search、context 與 spatial reasoning 要求,之後再由模型自行過濾。作者同時加入 exploration diversity 控制,目標是避免訓練一路收窄,最後只剩單一風格題目。

如果你想試,較合理的做法是先準備圖片對應的 JSON 輸入,再分開看 generation 與 evaluation 兩部分輸出。倉庫內沒有附模型權重、數據集與快取,評測亦會用到 image-capable OpenAI evaluator 與 Qwen embedding models,所以較適合已經有 VLM 環境、想驗證自動出題流程的研究者或多模態團隊。

  • 以未標註圖片開始,自動生成、改寫、過濾視覺問題
  • 保留 Agentic evaluation,從 visual search、evidence coverage、context、spatial reasoning 評分
  • 另用 Qwen embedding models 檢查整體多樣性,不只看單題質素
  • 強調 zero external supervision,不依賴人工標註或 GPT-4V 這類外部 teacher models

創新點在於它不單止用 VLM 產生問題,還把「提問能力」當成可自我增強的訓練訊號,並且把 questioner 與 answerer 兩種模式一起考慮。按論文說法,這套方法在多個 backbone VLMs 上都能提升問題質素,亦把自動出題的難度邊界推高;同樣預算下,比直接用靜態來源資料訓練更有效,而模型的 answerer 能力亦未有明顯犧牲。

相關模型與元件方面,倉庫內容顯示生成流程可配合 Qwen2.5 3B 類型設定,評測會用 OpenAI 的可看圖評估器,以及 Qwen embedding models。若你關心多模態訓練、合成數據、或想建立能自己發問再自我改良的 Agentic workflow,SeeQ 的方法論比單純看分數更有參考價值。

GitHub: https://github.com/tianyi-lab/SeeQ

Paper: https://arxiv.org/pdf/2606.13929

Categories: 阿里巴巴, Agentic, AI productions, RAG, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, OpenAI, Image, 框架, 工具, IDE, Python, , Dataset 數據集

LoopCoder:只多跑一輪,成效反而更好

LoopCoder-v2 研究 PLT 在測試階段的迴圈次數選擇,顯示兩輪往往比三輪以上更穩定。對寫程式、工具呼叫和代理式任務,這個項目提供了更實際的取捨參考。

Only Loop Once: gain–cost trade-off in Parallel Loop Transformers

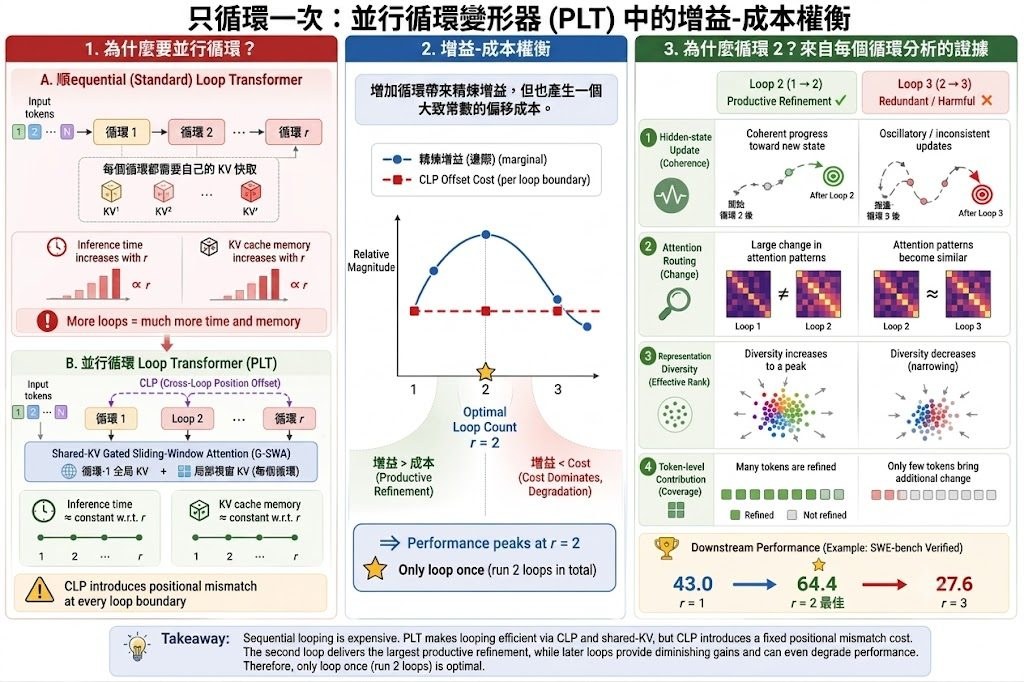
LoopCoder-v2 是一個基於 Parallel Loop Transformers(PLT)的程式碼模型系列,目標是解決「推理步數愈多,成本與表現未必同步上升」的問題。傳統 Looped Transformers 會透過重複共享區塊去增加 latent computation,但每多一輪都會拉高延遲和 KV-cache 記憶體;PLT 則用 Cross-Loop Position Offsets(CLP)和 Shared-KV Gated Sliding-Window Attention(G-SWA)把成本壓低,讓迴圈數變成可以調整的設計參數。

這個項目直接拆解「多跑幾輪到底值不值得」。作者用 gain–cost 角度分析 loop count:額外一輪可以帶來表示更新,但 CLP 也會引入位置不匹配的成本;兩邊一對比,就能解釋為何 LoopCoder-v2 在很多情況下是兩輪最好,而不是愈多愈好。這種分析方式比單看分數更有參考價值,因為它把效果升降和內部機制連在一起。

從結果看,LoopCoder-v2 的 7B 版本在多個程式相關測試都有明顯改善,尤其是 SWE-bench Verified 由 43.0 升到 64.4,Multi-SWE 由 14.0 升到 31.0,Terminal-Bench 亦有提升。相反,三輪或四輪時分數明顯回落,表示這個項目不是單純靠「加更多計算」換表現,而是存在一個較清晰的最佳點。作者亦用 hidden-state dynamics、attention evolution 和 output distribution shift 去佐證第二輪帶來主要增益,之後的輪次多數只會增加冗餘。

如果你想找的是可直接跑的模型,這個項目提供了 Hugging Face 上的 7B 權重,能透過 Transformers 載入後做文本生成或程式碼任務測試。適合關注 code generation、code reasoning、agentic software engineering、tool-use 的人,也適合想研究 test-time compute scaling、模型推理效率,或想比較 loop count 對表現影響的讀者。

  • 主要類型是模型研究項目,同時包含評測與推理分析
  • 核心結論是:兩輪通常是最佳平衡點,三輪以上可能反而拖低表現
  • CLP 令平行迴圈可行,G-SWA 則把 KV-cache 成本維持在近乎固定水平
  • 7B 版本在 SWE-bench Verified、Multi-SWE、Terminal-Bench、BFCL 等測試都有較完整結果
  • 適合用來分析程式碼模型、代理式任務,以及測試階段算力分配

GitHub: https://github.com/CSJianYang/LoopCoder

Paper: https://arxiv.org/pdf/2606.18023

Categories: 開源, Agentic, AI productions, RAG, 模型, 框架, 軟件, 工具, Python, 編程

RhymeFlow:加快影片生成的新路線

RhymeFlow 針對影片生成太慢的老問題,提出免訓練加速方法。它不只追求更快,亦嘗試保住畫面連貫度。

Repository image for Simon-Dcs/RhymeFlow

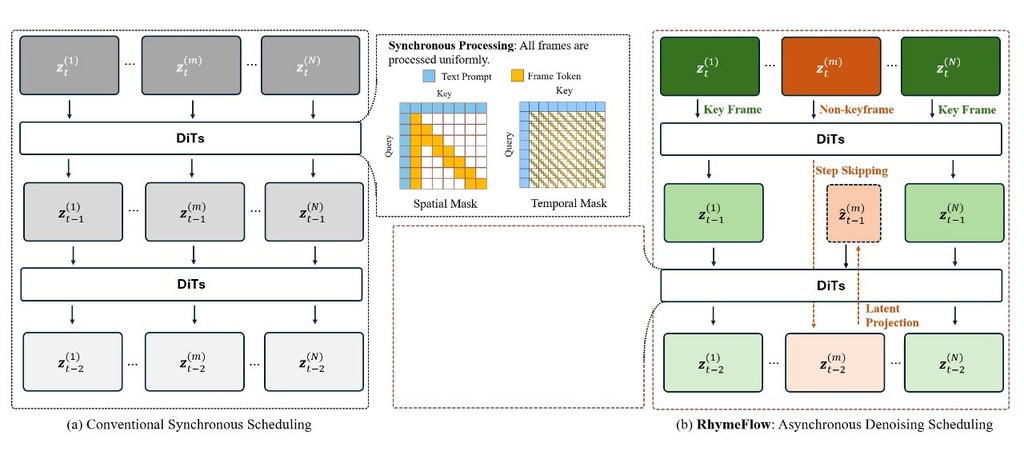
現時不少影片生成加速方法,主要仍沿用標準 diffusion pipeline:每一幀都要在所有 diffusion timesteps 完整做一次 dense denoising,再配合 sparse attention 或 KV-caching 減少單步計算。RhymeFlow 指出,這種固定範式忽略了相鄰影格內容與動作高度相關,令自然影片裡大量中間步驟其實屬於重複運算。

這是一個免訓練的影片生成加速框架,核心目標是替 DiT(Diffusion Transformers)影片模型減少推理延遲與運算成本。它將不同影格的 denoising trajectory 拆開處理:先找出主導語意變化的 keyframes,讓 keyframes 保持逐步去噪,非 keyframes 則逐步跳過部分步驟,再用 latent trajectory projection 補回時間一致性。

這個做法的創新,不在於單純把 attention 再稀疏化,而是直接挑戰「所有影格都要同步、密集去噪」的舊假設。論文描述,RhymeFlow 在現有 DiT-based video generation models 上,能同時取得更高 inference speed 與更好 visual quality;不過 GitHub 目前公開重點放在 Wan 2.1 adaptation,HunyuanVideo adaptation 仍在準備中。

如果你想試,較合理的切入點是把它當成 Wan 2.1 的加速實驗框架,比較 dense、svg、sap、rhyme、rhyme_sap 幾種方法輸出時間與畫面差異。環境要求偏高,文件列出 CUDA 12.4 / 12.8 與 PyTorch 2.5.1 / 2.6.0,亦牽涉 FlashInfer、flash-attn 和自訂 kernels,較適合已有 GPU 與 PyTorch 經驗的人。

  • 項目類型:training-free 影片生成加速框架,處理 DiT 影片模型推理太慢的問題
  • 方法重點:keyframes 做 dense denoising,非 keyframes 跳步處理,再用 latent trajectory projection 維持時序一致
  • 可比較方法:dense、svg、sap、rhyme、rhyme_sap
  • 相關模型:Wan 2.1 已有 adaptation,HunyuanVideo adaptation 尚未完整釋出
  • 適合場景:研究影片生成推理優化、比較不同加速策略、測試速度與畫質取捨

整體來看,RhymeFlow 的價值很明確:它不是改模型權重,也不是重新訓練,而是重排 denoising flow scheduling,從流程層面節省計算。對研究者與進階開發者而言,這類思路比單純堆硬件更有參考價值;對一般創作者來說,現階段門檻仍在部署與 GPU 環境。

GitHub: https://github.com/Simon-Dcs/RhymeFlow

Paper: https://arxiv.org/pdf/2606.06309

Categories: 開源, 清華大學, 騰訊, AI productions, 視頻模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, Python, 深度學習

S2L-PO 用小模型帶動大模型推理訓練

清華與港校團隊提出 S2L-PO,改用小模型提供多樣推理路徑,補足 GRPO 易收斂過快的問題。

S2L-PO method overview

這個項目來自跨校團隊,作者包括 Yiming Ren、Yiran Xu、Zicheng Lin 等人,通訊作者是 Yu Qiao 與 Ruihang Chu;所屬機構包括清華大學、上海人工智慧實驗室、香港中文大學及香港城市大學。以研究背景看,團隊明顯集中在大型語言模型訓練、推理強化學習與數學評測。

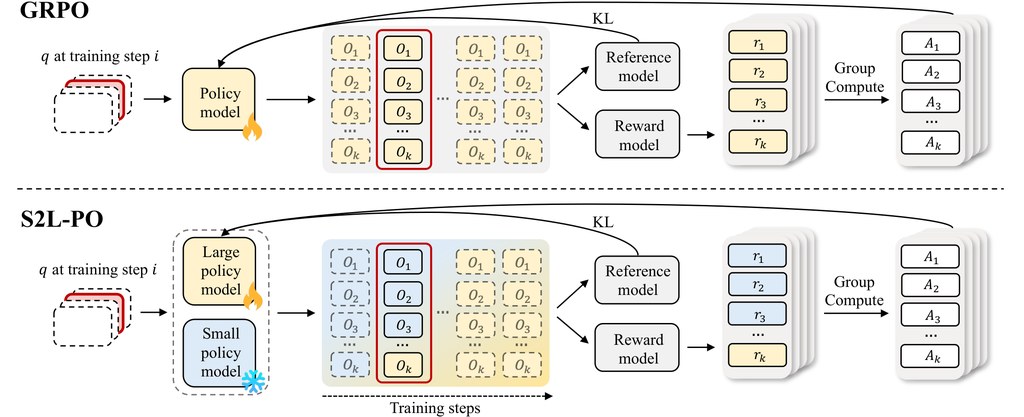
這是一個針對 Group Relative Policy Optimization(GRPO)訓練流程的研究型框架,目的是提升大型語言模型在推理任務上的 rollout diversity。現有做法多數靠提高 temperature,從 token-level randomness 增加變化,但論文指出這種固定範式容易在長推理鏈累積噪音,令軌跡變得不連貫。

S2L-PO(Small-to-Large Policy Optimization)換了一個角度:不用同一個大模型不停抽樣,而是找同家族的較小模型做 explorer,先產生一部分 qualitatively different reasoning trajectories,再讓大模型用混合 rollout 依照標準 GRPO 訓練。之後再用 progressive annealing,逐步由 small-model exploration 過渡到 fully on-policy learning,避免中途被小模型能力上限拖慢。

論文提供的結果頗有說服力。以 Qwen3-8B learner 配 1.7B explorer 為例,AIME24 Pass@1 由 15.0 提升到 23.8,AIME25 Pass@1 由 12.1 提升到 22.5;Qwen3-14B learner 配 4B explorer 亦比基線 GRPO 高。作者同時聲稱 rollout compute 還可降低,這點對訓練成本敏感的團隊尤其有吸引力。

如果你想測試這個項目,較合理的方式不是當作即裝即用工具,而是把它視為一個訓練策略參考:先看論文與公開模型設定,再比較自己手上的 GRPO 流程是否同樣受 rollout 同質化影響。硬件門檻不算低,資料列出 8B 模型約需 20 GB GPU 記憶體、14B 模型約需 32 GB,較適合研究人員、模型訓練工程師,或正在做數學推理微調的團隊。

  • 核心判斷:這是模型訓練框架,不是一般聊天應用,重點在改善 GRPO 的探索品質
  • 方法差異:由 token-level randomness 轉向 policy-level diversity,減少長鏈推理失真
  • 主要創新:用較小同家族模型充當 natural explorers,再以 progressive annealing 收回大模型主導權
  • 已列相關模型:Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B
  • 適合場景:數學推理、可驗證獎勵訓練、想提升 RLVR 與 GRPO 收斂效率的項目

GitHub: https://github.com/qishisuren123/S2L-PO

Paper: https://arxiv.org/pdf/2605.30789

Categories: 開源, 香港中文大學, 香港城市大學, 清華大學, 上海人工智慧實驗室, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 香港, 工具, Python, 深度學習

Meta 推出開源 SAM 音訊

Meta 的 SAM Audio 是首個統一的多模態模型,能從複雜音頻或視頻中精準分離特定聲音。 SAM Audio 支持文字提示(如「狗叫聲」或「人聲」)、視覺選擇(如點擊視頻中樂手)或時間範圍提示,來隔離目標聲音並生成殘餘音頻。 它適用於音樂、語音和一般環境音,超越傳統單一工具。 模型基於 Flow-Matching Diffusion Transformer,在 DAC-VAE 潛在空間運作,提供小(500M 參數)、基(1B)和大(3B)版本。 它能同時生成目標與殘餘音軌,支援真實世界場景如去除背景噪音。

Meta 的 SAM Audio 是首個統一的多模態模型,能從複雜音頻或視頻中精準分離特定聲音。

SAM Audio 支持文字提示(如「狗叫聲」或「人聲」)、視覺選擇(如點擊視頻中樂手)或時間範圍提示,來隔離目標聲音並生成殘餘音頻。 它適用於音樂、語音和一般環境音,超越傳統單一工具。

模型基於 Flow-Matching Diffusion Transformer,在 DAC-VAE 潛在空間運作,提供小(500M 參數)、基(1B)和大(3B)版本。 它能同時生成目標與殘餘音軌,支援真實世界場景如去除背景噪音。

Categories: 開源, Python, 聲效

RePlan 圖像編輯框架

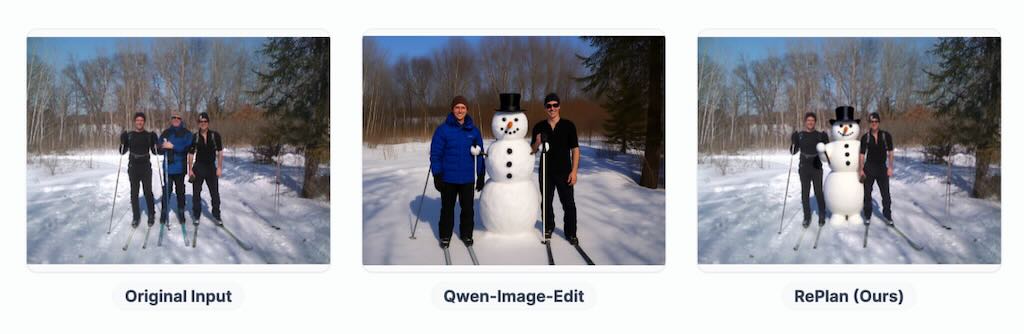
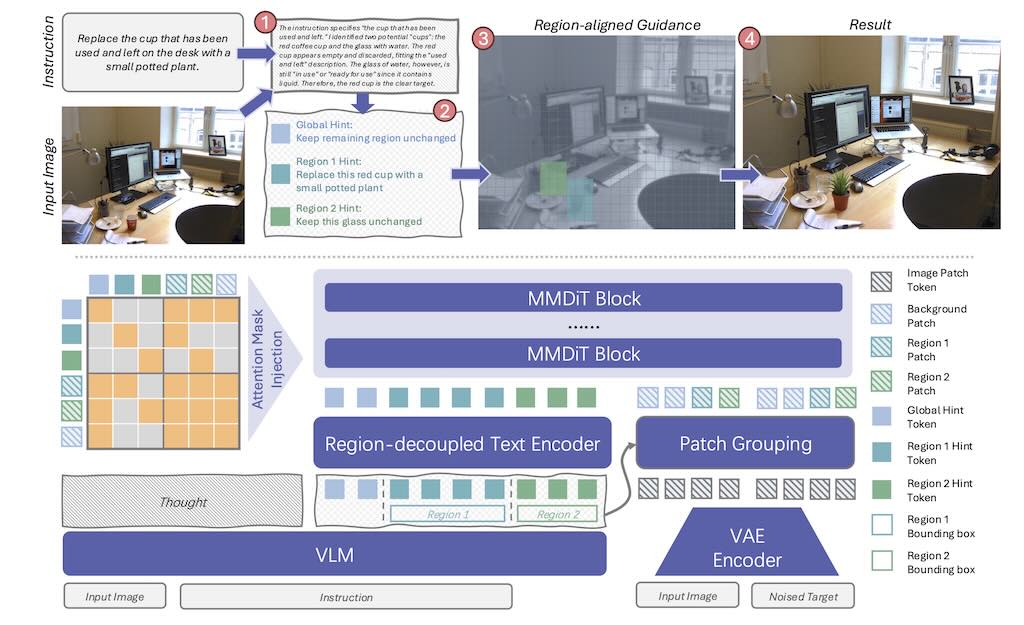
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。 框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。

框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

Categories: 開源, 香港中文大學, 香港科技大學, 騰訊, 影像模型, 影像處理, Python, 新聞

PersonaLive 安裝教學 (12G VRAM)

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

用 AI 即時變身女神|免費
Categories: 開源, 數字人, 影像模型, 影像處理, Python

Page 12 of 13
1 10 11 12 13