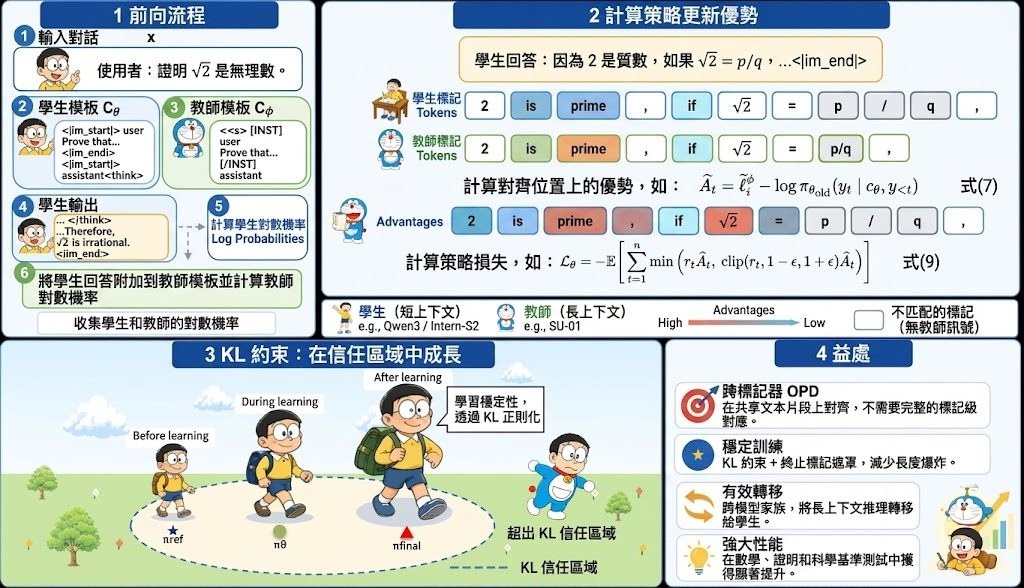
想把長上下文推理能力交到較細、較短上下文的學生模型,卡位往往唔係只有模型強弱,而是 tokenizer 不同、輸出愈蒸餾愈長,最後連訓練都變得唔穩。SimpleOPD屬於模型訓練方法項目,處理的是 long-context reasoning teacher 到 short-context student 之間的 On-policy distillation(OPD)轉移,重點放在跨 tokenizer 仍然可以學到推理能力。
它冇硬做 token-level 對齊,而是改在 shared text space 對齊,只監督師生 tokenizer 剛好切出相同文字跨度的位置。呢個取捨很務實:少了強行對齊帶來的噪音,代價是可監督位置會收窄,但換來 arbitrary teacher-student tokenizer combinations 也能成立,對 Qwen3、Qwen3.5、Intern-S2、GLM-4.7、Gemma4 這類不同家族學生模型都更有通用性。
另一個關鍵,是它直接處理「答案愈生愈長」這個訓練現象。SimpleOPD加入 student-reference KL loss,再對 </think> 和 <|im_end|> 這類終止 token 做 advantage masking,目的不是單純加正則化,而是壓住學生模型偏離初始 policy 太遠,減少 teacher-student distribution mismatch、截斷率上升與訓練失穩。
- 支援 long-context teacher 產生 100K+ token reasoning chains
- 以 shared text space 對齊,避開 tokenizer 不一致帶來的蒸餾障礙
- 透過 student-reference KL loss 與終止 token masking 控制長度膨脹
- 在 ProofBench 對 Intern-S2-Preview 帶來 +21.2 分,升至 55.2
- 結果已超過 Gemini-2.5-Pro,並提到對 HLE、HiPhO 也有外溢收益
它不是即裝即用的線上服務,而是偏研究與訓練流程的開源項目;環境依賴 SLIME 0.2.3、Python 3.10+、PyTorch 2.0+,並為 GPU、HTTP-based teacher inference、timeout、concurrency、batch processing 留好接口。受益最大的會是做蒸餾訓練、想把強教師推理能力壓到較易部署學生模型的團隊,尤其是要跨 tokenizer、又不想被超長 reasoning chain 拖垮訓練穩定性的情境。