MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

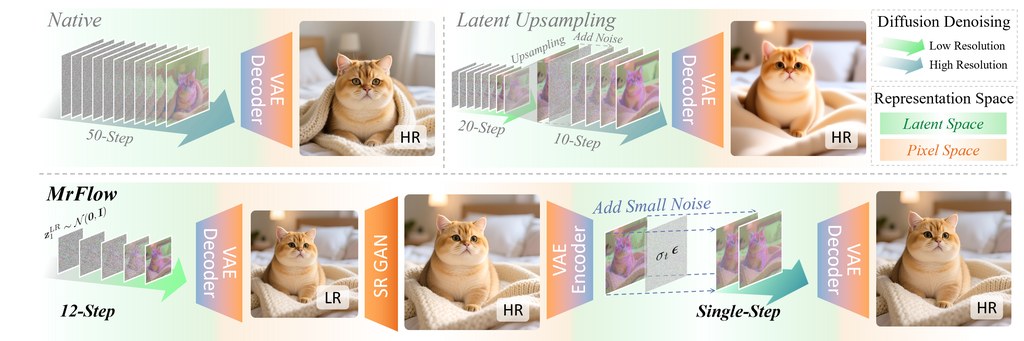
MrFlow framework

MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。
GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

PAW:把英文編譯成本地函數

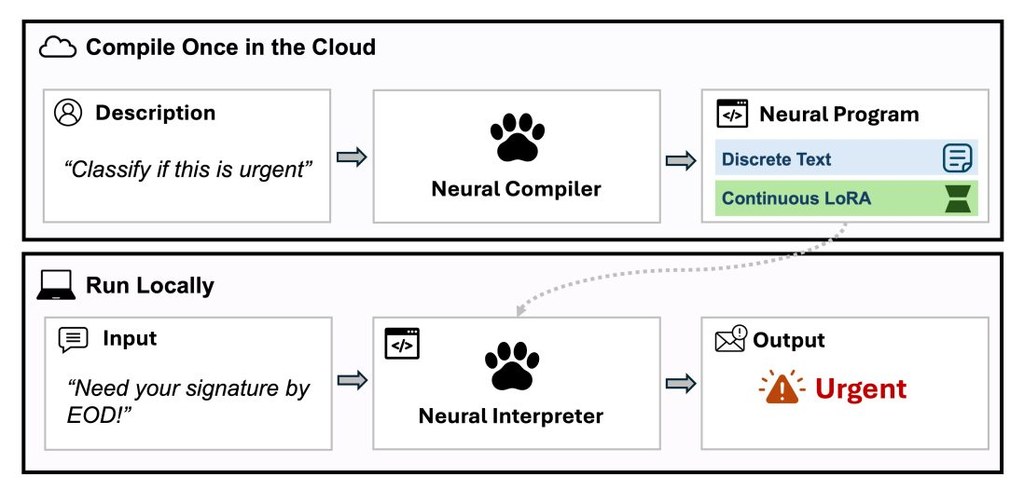
PAW(programasweights-python) 不是一般 LLM 封裝,而是把文字需求變成可離線執行的小型神經函數。它瞄準規則難寫、又不想長期依賴 API 的文字處理工作。

Repository image for programasweights/programasweights-python

PAW(programasweights-python)是一個 Python 工具兼研究原型,屬於把「自然語言」規格編譯成小型神經函數的項目。它要解決的是一類很難用正則表達式或硬編碼規則寫穩定的工作,例如修復壞掉的 JSON、模糊搜尋、分類、抽取欄位,以及把文字意圖對應到正確操作。

現有做法通常有兩條路:一條是手寫規則,遇到錯字、格式飄移同邊界情況就容易失準;另一條是把每次輸入都送去 LLM API,換來較高彈性,但會帶來網絡依賴、成本同重現性問題。Program-as-Weights(PAW)提出的做法,是先用一個 compiler 把英文描述編譯成可重用的神經程式,之後每次呼叫都在本機執行,定位由「每次都問模型」改成「先造好工具再反覆用」。

安裝路線相當直接:Python 端可透過套件取得預編譯函數,亦可自行 compile;瀏覽器端則有 @programasweights/web,但只限用 paw-4b-gpt2 這條較細的 runtime。部署取捨也寫得清楚,paw-4b-qwen3-0.6b 準確度較高,程式體積約 22 MB,本地推理約 0.05 至 0.5 秒;paw-4b-gpt2 準確度較低,但程式只有約 5 MB,支援 WebAssembly,較適合前端或輕量分發。

項目的技術定位:作者把這類問題稱為 fuzzy-function programming,並釋出 FuzzyBench 這個 10M examples 數據集,用 4B compiler 為 frozen interpreter 產生 parameter-efficient adapters。文中指出,0.6B Qwen3 interpreter 執行 PAW 程式時,效果可接近直接 prompting Qwen3-32B,同時把推理記憶體壓到約五十分之一,並在 MacBook M3 達到 30 tokens/s;這些數字有助理解它不是單純包裝模型,而是在成本、可重用性與離線能力之間重新分配。

  • 核心價值:把一次性的自然語言需求,轉成可重複呼叫的本地函數
  • 適合情境:日誌分流、格式修復、文字分類、資料抽取、意圖路由
  • 主要取捨:比直接調用大型 API 更可控、可離線,但編譯器與 runtime 選型會影響準確度與體積
  • 相關模型paw-4b-qwen3-0.6bpaw-4b-gpt2,論文亦以 Qwen3-32B 作對照
  • 受益團隊:重視本地執行、穩定輸出、低成本重複推理的開發團隊會較易受惠

這個項目最適合放在「規則太脆弱、API 又太重」的中間地帶。它未必取代通用 LLM,但對一批固定任務而言,先編譯、後離線執行的方式更像真正可落地的工程工具。

項目主頁 · GitHub · Paper

Categories: 開源, Qwen, API, Python, 編程, Dataset 數據集

Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

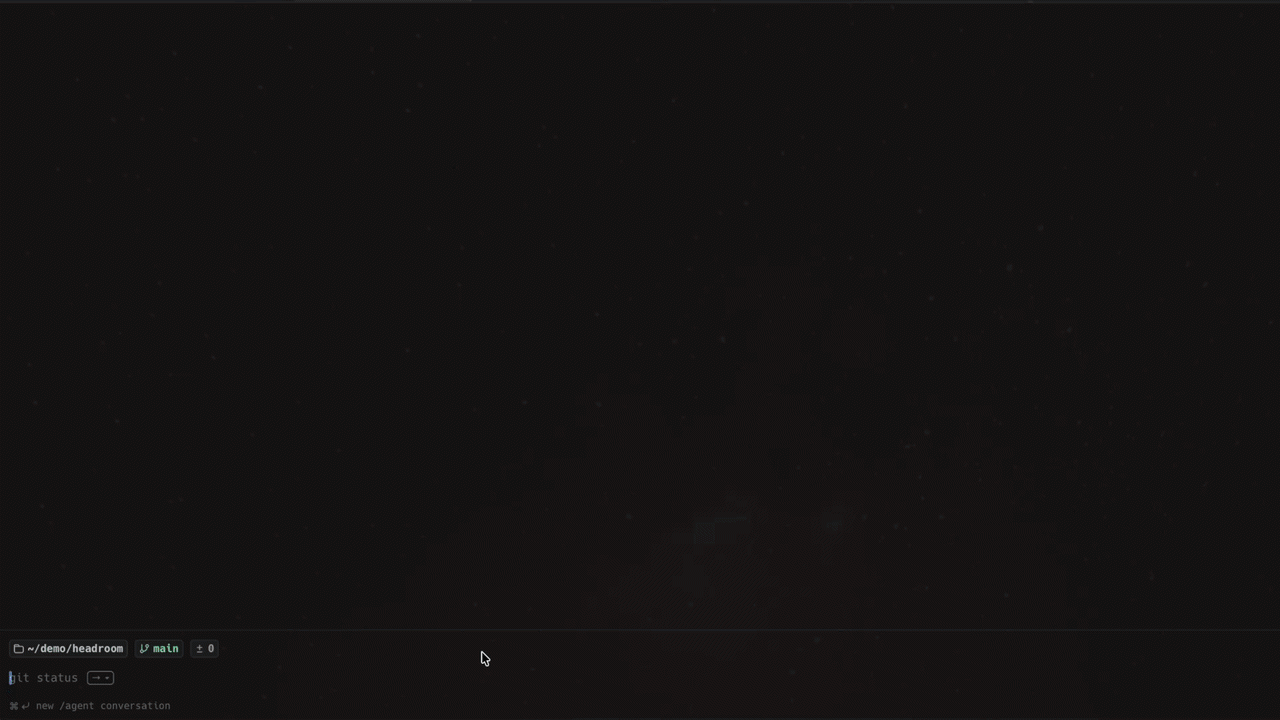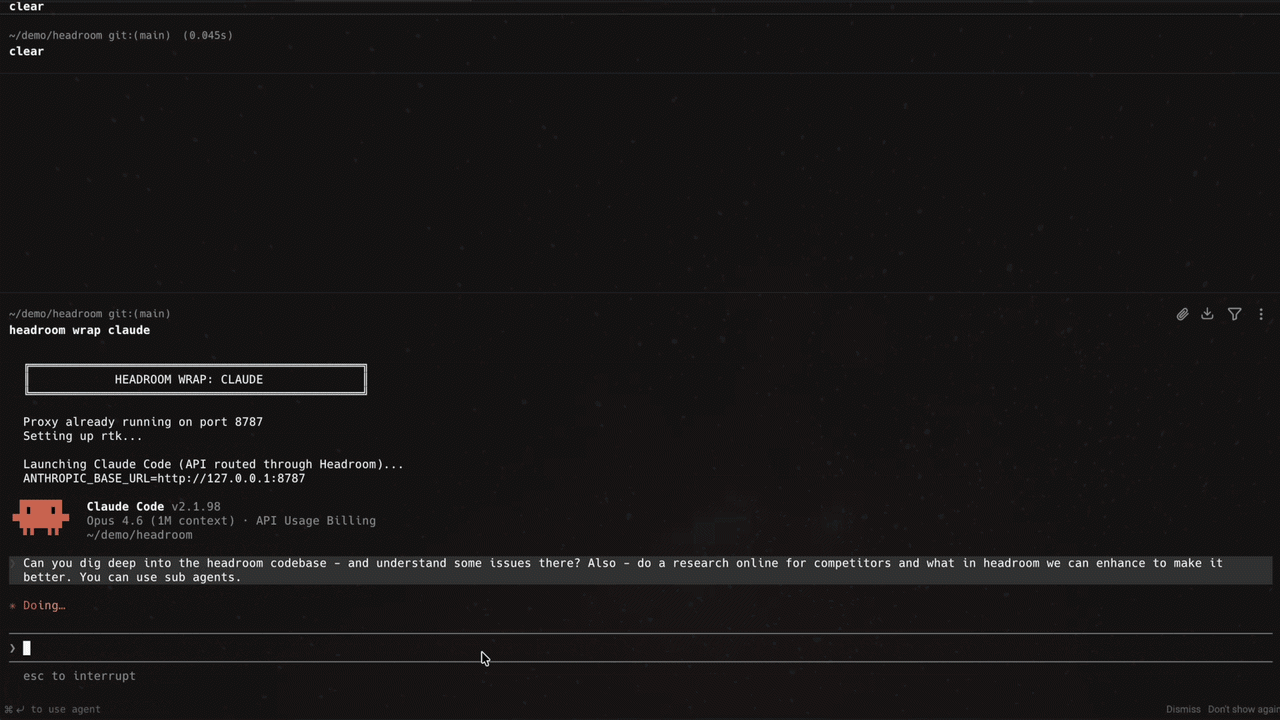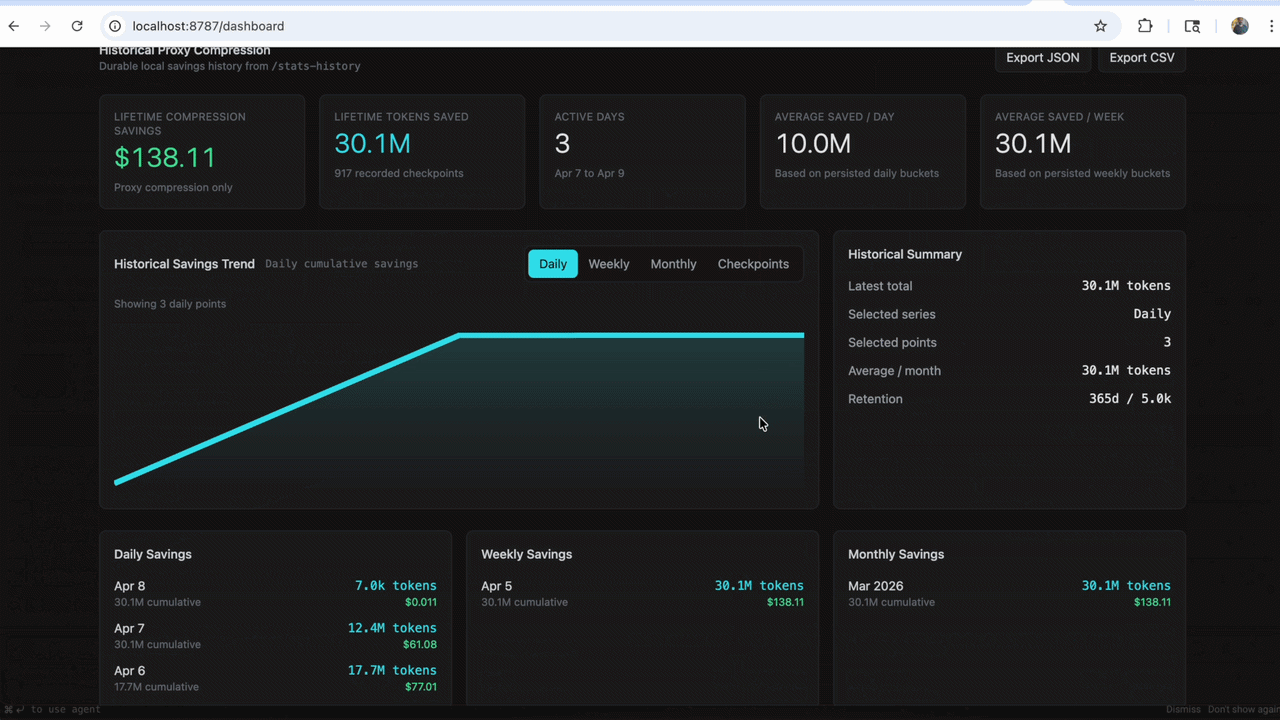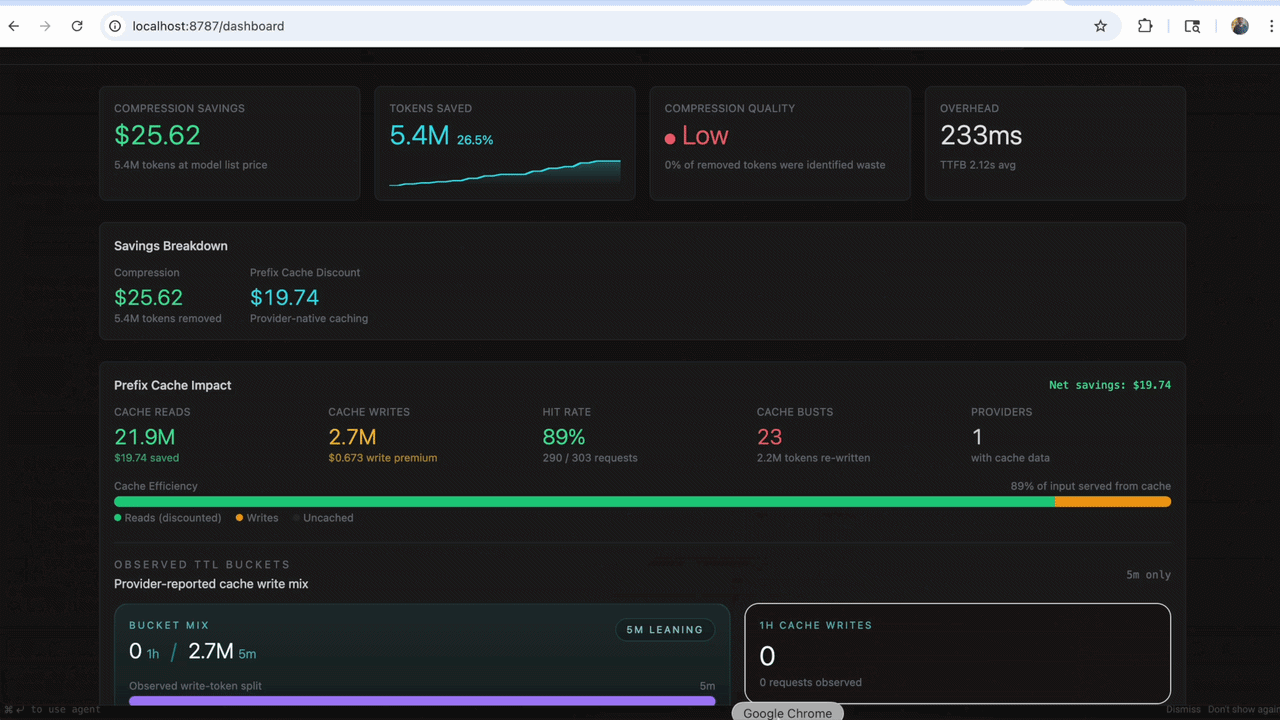
Headroom in action

Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。

GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, , 編程, Anthropic

MemoBench 點樣測世界模型記憶力

MemoBench專門檢查世界生成模型會否在物件離鏡後再出現時「記錯樣」。它用V-D-R流程,把畫質、一致性與語意判斷拆開量度。

Repository image for MemoBench-Team/MemoBench

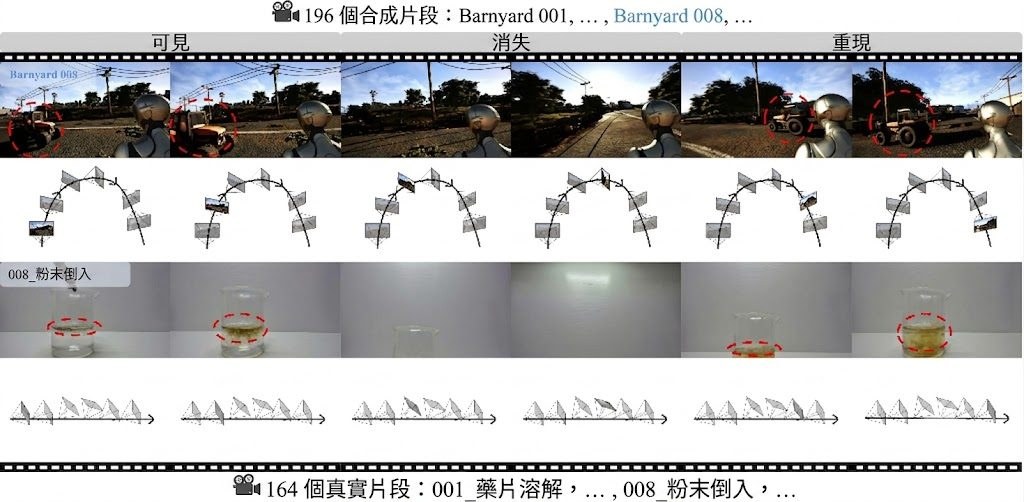
MemoBench 是一個 benchmark,屬於用來評測 world generation models 的數據集加評測工具組。它主要檢查模型在鏡頭移開再回來之後,能否把同一個物件的外觀、位置與狀態準確重建,而不是只生成一段看似流暢的影片。

現有影片生成或世界模型評測,很多時集中在畫質、動作流暢度,或者短時間一致性;作者認為這類範式未必能測到 visual memory。MemoBench 因此用 V-D-R (Visible → Disappeared → Reappear) 結構重組任務:先見到目標物件,再讓它離開視野,最後要求模型在重返視野時保持物件永久性與幾何一致性,這比單看首尾畫面更接近真正的記憶測試。

資料部分有 360 段片,分成 196 段 synthetic 與 164 段 real-world clips,並提供 V-D-R 邊界、GT camera poses、目標物件文字描述、VQA question banks 等配套。部署思路相當清楚:環境以 Linux、Python 3.11、CUDA GPU 為主,評測流程分成自動指標、Object Revisit Score (ORS),以及 VQA 三步,輸入格式是逐格 PNG 圖片;camera controllability 會用到 MapAnything,ORS 會用到 SAM-3。

它和同類 benchmark 的差異,不在於片段數量特別大,而在於把「物件消失後再出現」設成核心壓力測試,並同時覆蓋 synthetic 與真實場景。14 項指標亦不是只量畫面好不好看,還會看 temporal consistency、geometric fidelity、object permanence、camera controllability,以及 VQA-based reasoning,取向明顯偏向診斷模型缺口,而不是只做單一排行榜。

  • 適合比較 不同 world generation models 在長時序記憶上的穩定度
  • 測試材料完整,包含 phase 邊界、相機姿態、文字提示與 VQA 題庫
  • 評測角度較細,把低階畫質與高階語意一致性分開量度
  • 部署門檻不算低,需要 Linux、CUDA GPU,亦依賴 MapAnything 與 SAM-3

相關模型方面,官方內容提到已基準測試 8 個模型,但這份儲存庫摘要未列出完整名稱,因此較穩妥的理解是:MemoBench 重點不是提供新模型,而是提供一套可重覆的記憶一致性測試基準。對研究 world modeling、影片生成、camera-controlled generation 的團隊尤其有參考價值,因為它能幫你分辨模型是「畫得靚」,還是真正記得之前見過什麼。

項目主頁 · GitHub · Paper

Categories: Google, NVIDIA, Image, 框架, Linux, Python

PRA:像素級自回歸生圖的新路線

PRA 是一個 PyTorch 影像生成研究項目,主打 pixel-space autoregressive 生成。它嘗試用較細模型規模,換到更低 FID 表現。

result

PRA 是一個以 PyTorch 實作的影像生成研究項目,屬於 class-conditional pixel-space autoregressive image generation 模型與訓練框架。它要解決的問題,是直接在像素空間逐步生成圖片時,單步誤差大、而且 teacher-forced training 與推理流程不一致,令誤差一路累積。

現有 pixel-space continuous-token autoregressive 做法,多數直接預測高維像素 patch,或用 x-prediction、input noise injection 減輕誤差,但改善有限;exact rollout training 雖然更貼近推理,代價又太高。PRA 的取向是加入 Parallel Rollout Approximation (PRA):先生成低維 intermediate states,再經 pixel decoder 映射回 pixel-space tokens,同時用近似推理時的 pixel-feedback 方式保留平行訓練效率。

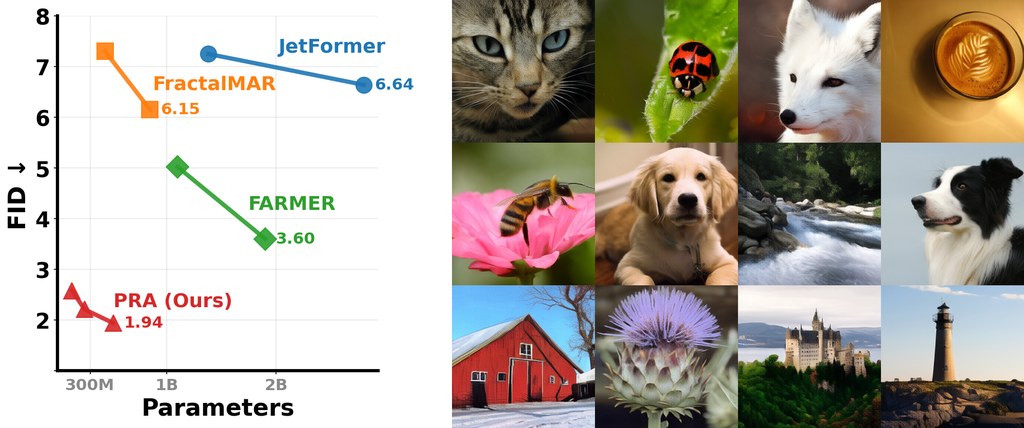
這個設計的重點,不是單純追求更大模型,而是重新處理「訓練見到的輸入」與「生成時真正收到的回饋」之間的落差。論文資料顯示,它在 ImageNet-1K 256×256 的 class-conditional 生成上,PRA-S 135M 參數已做到 FID 2.58,優於先前 billion-scale pixel-space AR 的 3.60;PRA-L 511M 進一步到 1.94,定位很清楚,就是衝着 pixel-space AR 的 SOTA 而來。

部署理解上,儲存庫已提供 environment.yml、requirements.txt、預訓練權重與 sample_ddp.py,代表作者預設你會用多卡分散式抽樣與評測。評估指標包括 FID、Inception Score、precision、recall,另有 ImageNet classification probing accuracy 作為生成以外的補充觀察,表示作者也在測試表徵能力,而不只看出圖漂亮與否。

  • 項目類型:研究原型兼模型實作,集中展示 PRA 訓練與取樣流程
  • 相關模型:PRA-S、PRA-B、PRA-L,參數量約 135M、250M、511M
  • 主要差異:不用離散 tokenizer,維持 pixel-in、pixel-out AR 介面
  • 較適合情境:研究 pixel-space AR、比較生成指標、重現 ImageNet 類條件生圖結果
  • 需要留意:目前公開內容偏向研究重現,不是即裝即用的終端應用工具

受益最大的,會是做影像生成研究的團隊、想比較 autoregressive 與 diffusion 路線的人,以及要研究像素空間建模取捨的學術項目。對一般開發者來說,這個項目較像高水準實驗平台;有現成 checkpoint 和評測流程是優點,但 CUDA、PyTorch 與 FlashAttention 相容性仍需自行處理。

GitHub · Paper

Categories: 北京大學, 模型訓練, Image, 影像模型, Python

MultiHashFormer:用雜湊重寫語言模型詞表

這個項目把語言模型的詞表問題改寫成 hash signature 生成。重點不只省參數,還想讓擴充詞彙時維持固定模型體積。

Repository image for HUIYINXUE/MHF

MultiHashFormer 是一個生成式語言模型研究項目,同時提供 Qwen3 相關實作、訓練腳本與詞彙擴充流程。它要解決的是傳統 embedding matrix 會隨 vocabulary size 線性膨脹,令模型難以用固定參數量吸收更多詞彙、語種或新領域內容。

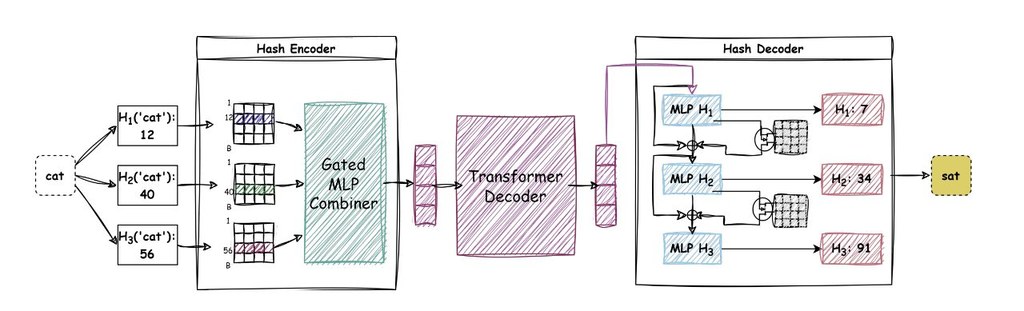
現有 hash-based 做法多數採用 many-to-one mappings,把多個 token 壓到同一個 hash index,這在 encoder-only 模型尚可運作,但放到 causal LMs 就會出現解碼歧義:模型預測到共享 index,未必能準確還原原來那個 token。MultiHashFormer 的做法是為每個 token 建立 unique hash signature,用多個獨立 hash functions 產生一串離散 hash IDs,再交由 Hash Encoder 壓成 latent vector,最後由 Hash Decoder 生成下一個 token 的 hash signature。

這個設計的取向很明確:它不是單純縮小 embedding,而是重組「token 如何表示、如何生成」這條路徑,目標是在保持參數 footprint 固定的前提下,仍可做 autoregression。來源資料亦顯示作者把它放到 100M、1B、3B 規模,並提供 standard 與 MHF 兩組訓練腳本,方便直接對照 baseline,不過 README 未完整列出所有 benchmark 數字,閱讀時應以論文結果為準。

部署理解上,這個項目比較接近研究代碼而非即裝即用產品:preprocessing 內有英文預訓練資料處理腳本,training 內分 standard 與 MHF 訓練流程,vocab_expansion 則涵蓋 tokenizer 訓練、資料準備、continual pretraining 與 expanded_tokenizer。依賴包括 transformers、flash_attn、tokenizers、lm_eval 與 mmh3,代表它面向的是已有 Python 深度學習環境、想重現論文或測試詞彙擴充的人。

  • 項目類型:研究原型兼模型訓練代碼,核心是 hash-based autoregressive language modeling。
  • 主要差異:不再用 many-to-one hashing 直接代表 token,而是生成可還原的 unique hash signature。
  • 適合情境:比較標準 Transformer 與 MHF、研究 vocabulary expansion、測試固定參數量下的多語詞表延展。
  • 相關模型:Qwen3 標準版、qwen3_ori、qwen3_hashformer,以及 100M/1B/3B 多個 HuggingFace checkpoints。

整體來看,這個項目的價值在於它不只提出一個更省參數的表示法,還試圖修補 hash 方法長期無法自然用於生成式模型的缺口。對研究語言模型架構、詞表擴展與參數效率的團隊來說,它比一般「換個 tokenizer」更值得細看,因為連輸入表示與下一 token 生成機制都一併改寫了。

GitHub · Paper

Categories: Embedding, 模型訓練, Qwen, Python, 語音

NeuraDock Agent:把 7 通道 EEG 變成可用狀態訊號

這不是一般腦波展示工具,而是把7通道EEG整理成可供應用程式使用的即時狀態。它重點不在生成炫技介面,而在穩定解析、質量把關與本地處理。

Repository image for Neuradock/eeg-workstation-agent

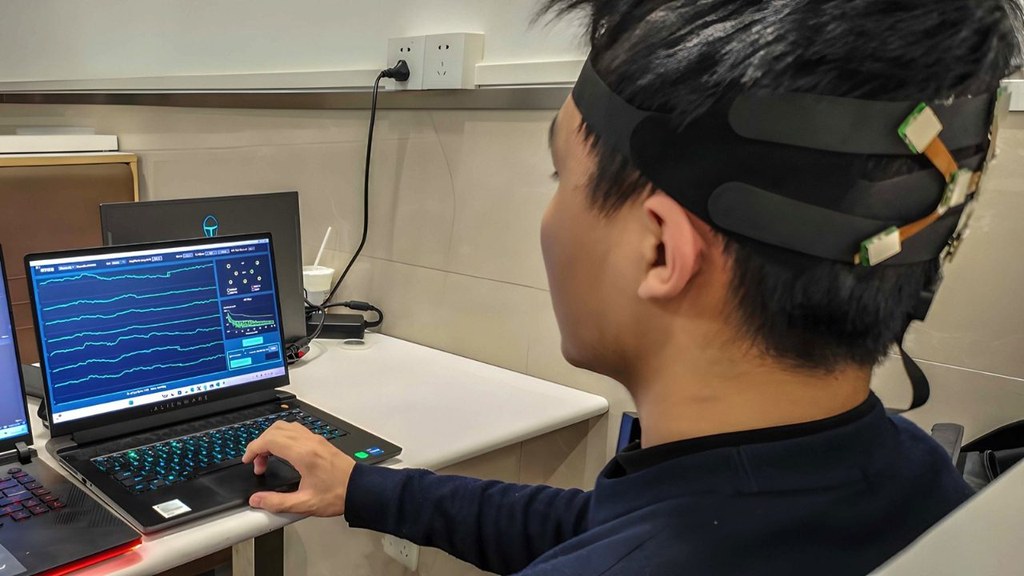
NeuraDock/eeg-workstation-agent 是一個本地優先的 Python 工具項目,也可視為面向應用整合的 EEG agent。它主要將 NeuraDock EEG Workstation 的 7 通道腦電訊號,轉成經過質量檢查的 visual cognitive-load 狀態,讓介面、XR、車載 HMI 或互動系統可以即時讀取,而不必直接處理原始 EEG。

現有不少 EEG 流程會把重心放在原始波形顯示、離線分析,或讓開發者自行拼接 preprocessing、quality control 與特徵提取;作者在技術文件中明確反對讓通用 LLM 直接對感測結果作自由解讀的做法。這個項目的取向,是把 deterministic local EEG engine 與 hardware-aware language layer 分開:前者負責解析、前處理、spectral workflows 與 machine-readable artifacts,後者只接收 allowlisted summary 與 versioned context pack,避免模型對 7-channel EEG 說出超出量測邊界的結論。

NeuraDock EEG Agent Workflow

部署路線算清晰。儲存庫列出 Python 版本範圍、支援 Windows、macOS、Linux,亦提供無硬件 synthetic replay,所以就算未買 NeuraDock EEG Workstation,也可以先啟動本地 dashboard 與 API,檢查 GET /api/status 會輸出哪些欄位;真正連接裝置時,Agent 會經 TCP 收流、做 online preprocessing,再輸出如 visual_load_indexalpha_peak_hzalpha_suppression_from_baselinequality.status 等狀態。示例資料要到另一個資料儲存庫下載,這裡沒有直接附上人類 EEG 數據,反映作者對資料安全與分發邊界相當保守。

和同類做法相比,它的差異不在「能否分析 EEG」,而在於它刻意收窄可宣稱的範圍。這套工具聚焦 posterior Alpha dynamics、within-subject Rest/Task visual cognitive-load comparison,以及 quality-gated adaptation,並清楚說明它不是 medical device,亦不能直接診斷 attention、fatigue、impairment 或跨個體比較表現。這種取捨令它的野心比一些泛用腦機介面平台細,但換來較可控的輸出與較低的誤讀風險。

  • 定位明確:屬於本地執行的 EEG 分析工具項目,重點是把 7 通道訊號轉成應用可讀狀態。
  • 測試門檻較低:有 synthetic replay,未接硬件都可以先驗證 dashboard、API 與流程。
  • 邊界控制做得細:LLM 不接觸 raw EEG 與 dense time-series arrays,只接收精簡指標與受控上下文。
  • 適合即時互動場景:視覺搜尋、adaptive vehicle HMI、cognitive load game 都是直接示範。
  • 資料解讀有限制:結果偏向個體內比較,不適合把不同人的 workload 分數直接放在同一把尺上。

性能描述方面,技術報告提供了幾個辨識度很高的訊號。其一,12 份錄音在十次 numerical repetitions 下得到相同 structured results,完整 Rest/Task 執行在三次重跑下亦產生相同 result、report 與 figure hashes,說明 deterministic pipeline 不是口號。其二,作者做了 request-capture 與 failure-injection experiments,檢查資料邊界與本地 artifacts 在 HTTP、格式錯誤及連線失敗下是否仍能保留。其三,boundary-awareness benchmark 涵蓋 ordinary 與 adversarial questions,並結合 qwen3.7-max 和 kimi-k2.6 生成輸出;這部分重點不是比較哪個模型最聰明,而是檢查語言層有沒有超越硬件與工作流容許的解釋範圍。

相關模型與組件方面,README 沒有把核心 EEG 推理包裝成 foundation model,而是以 reviewed workflows 為中心;可見的外部模型主要是 optional LLM mode 會用到的 LLM,例如 qwen3.7-max、kimi-k2.6。適合受益的人,包括做 HCI、XR、遊戲互動、復健訓練、工業監測與研究原型的團隊;他們想要的通常不是一套醫療級診斷系統,而是一個可以穩定輸出、容易接入前端或控制邏輯、又盡量把資料留在本機的腦訊號工具鏈。

項目主頁 · GitHub · Paper

Categories: Agentic, Qwen, API, 框架, Medical醫學, Mac, Linux, Python

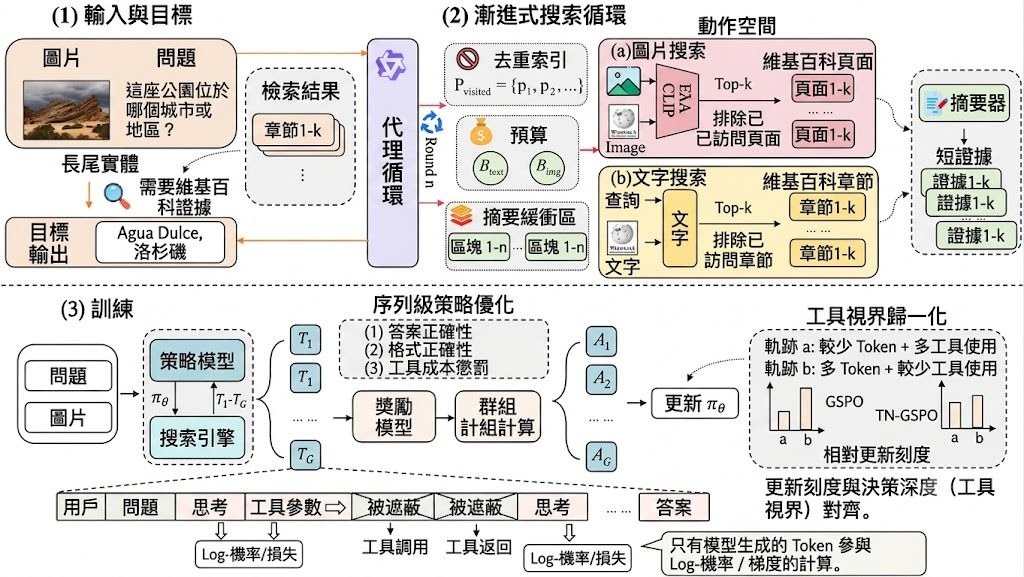
ProMSA 把 KB-VQA 變成會搜尋的代理

ProMSA不是普通問答模型,而是會逐步搜尋證據的KB-VQA研究項目。它用TN-GSPO訓練代理,重點在於搜尋節奏、模態切換與停止時機。

ProMSA overview

這是一個針對 Knowledge-Based Visual Question Answering(KB-VQA)的研究原型兼訓練項目。它要處理的問題,是模型不只要看懂圖片內容,還要連接外部知識來源例如 Wikipedia,先找對實體,再用足夠證據回答問題。

現有做法多數採用固定的 retrieve-then-generate 流程:先選好 retriever、設好 static top-k,再做一次檢索後直接生成答案。作者認為這種範式遇到 long-tail entities 很脆弱,第一步找錯就難以修正,也不擅長組出 multi-hop 證據鏈;所以 ProMSA 改成 progressive multimodal search agent,讓同一個 MLLM 逐輪決定用 image search、text search,還是 stop。

這個項目的取向很明確:它不是單純把檢索接到模型前面,而是把搜尋本身變成推理流程一部分。配合 de-duplication exclusion list、tool-call budget 同 reward penalty,它會避免重覆撈同一批內容,亦會在證據足夠時停手,減少無效工具呼叫;訓練上再用 TN-GSPO,而不是只靠 GRPO 或 vanilla GSPO,目標是令長度與工具步數不同的軌跡都能較穩定更新。

  • 支援 image search、text search、stop 三種動作
  • 針對錯誤首次檢索加入 failure recovery 與 multi-hop 搜尋
  • 採用 veRL 工具介面,包含 multi-turn rollout、reward 與 loss
  • policy backbone 包括 Qwen/Qwen2.5-VL-7B-Instruct、Qwen/Qwen3-VL-2B-Instruct、Qwen/Qwen3-VL-8B-Instruct

網頁 已交代 Installation、Data & Model Preparation、Service Architecture、Training 同 Evaluation,表示它不只是概念展示,而是有完整實驗流程的研究項目;不過部署時應預期需要 Python 3.10+、veRL、外部搜尋服務同相應資料準備。結果描述提到在 E-VQA 與 InfoSeek 對強 RAG 和 agent baselines 有一致提升,但目前提供的是研究報告式結論,較適合做 KB-VQA、multimodal agent、RAG policy 訓練的團隊參考,而不是即裝即用的通用產品。

項目主頁 · GitHub · Paper

Categories: 清華大學, Agentic, RAG, 視覺模型, 模型訓練, Qwen, Python, 中國

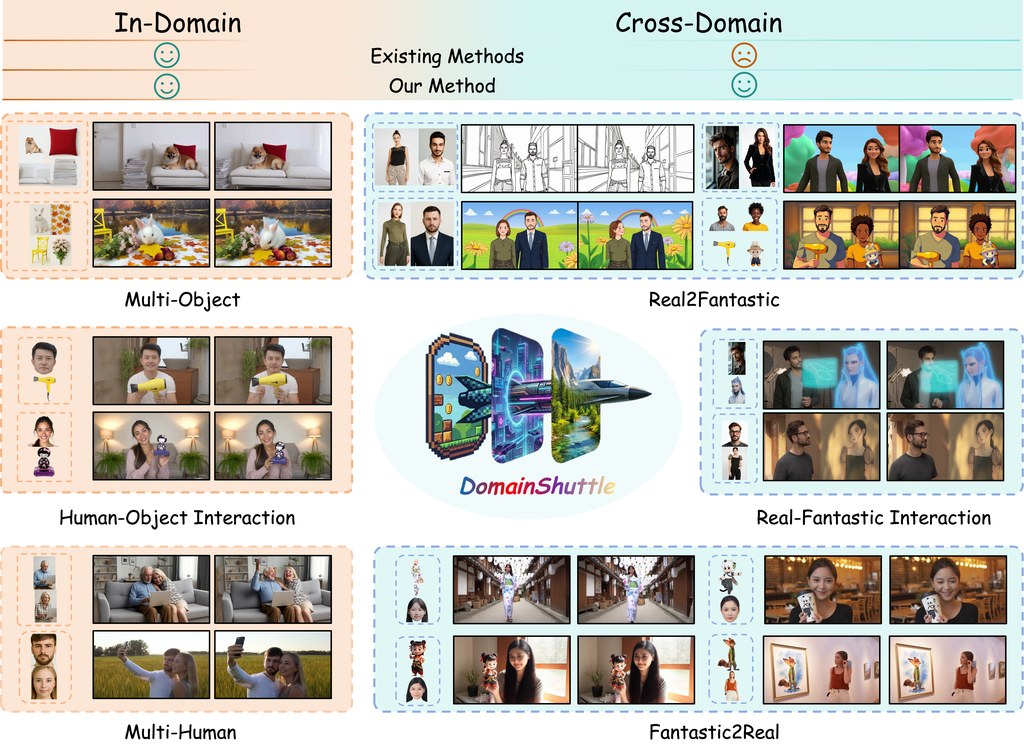
DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

teaser

DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

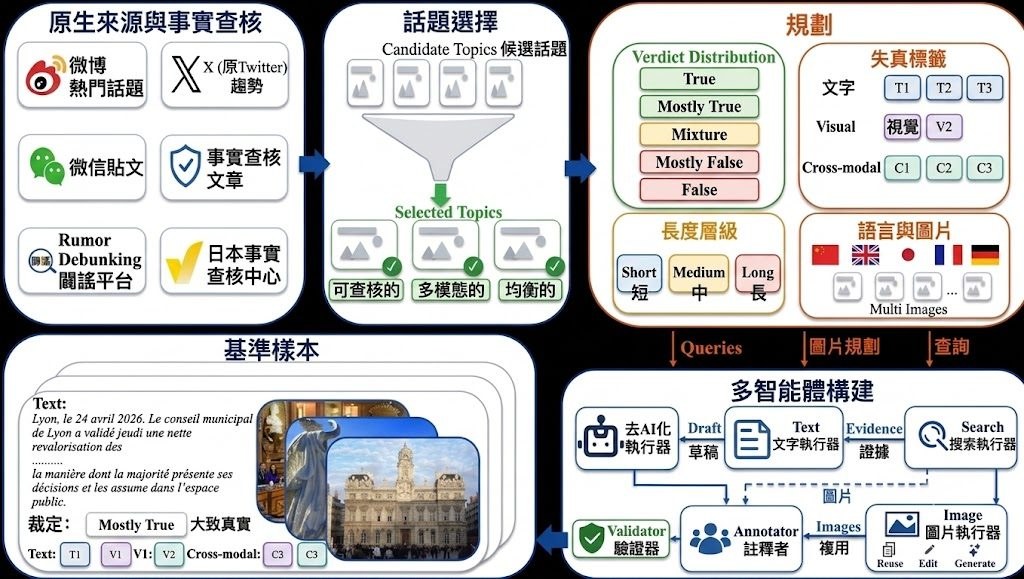
ReMMDBench-Agent 驗證多模態假資訊

這是一組重現論文結果的研究代碼,集中比較三種多模態 misinformation detection agent 系統。重點不只看分數,亦看證據如何被拆解、檢索與重用。

Repository image for DANG-ai/ReMMDBench-Agent

開發團隊來自上海交通大學、上海人工智慧實驗室、清華大學、中南大學,以及中國電子科技集團第十五研究所,核心作者把 ReMMDBench 同 ReMMD-Agent 一起公開,方向很明確:用較接近真實網絡帖文的方式,檢查圖文混合內容中的 misinformation。這個 GitHub 項目屬於研究原型加評測代碼集合,主要用來重現三個 multimodal misinformation detection agent 系統在 ReMMDBench 上的結果,並比較它們怎樣做判斷。

現有做法常把多模態假資訊檢測收窄成單圖、二分類,或者一次過把整段文字與圖片丟給模型判斷;作者認為這種 fixed-pass 判斷方式難以處理長敘事、多張圖片、跨語言與部分真實內容。這個項目因此提出一套以 ReMMDBench 為核心的 agentic 驗證路線:Baseline 1 是 3-stage MMD-Agent,Baseline 2 是 MCTS-based 5-verdict + 8-taxonomy agent,而主系統 ReMMD-Agent 則用 atomic decomposition、RAG(Retrieval-Augmented Generation)與 multi-expert judge,把結論建立在可追蹤的證據狀態上。

跟同類方法相比,ReMMD-Agent 的取向不是只追求一次答中,而是先把帖文拆成 atomic claims、image observations、text-image bindings,再檢索 multimodal evidence,之後重用 persistent memory,減少重複工具呼叫。這種設計的取捨很清楚:流程更長、配置更多,但換來較好的可解釋性,也更適合處理 five-way L1 veracity labels、8 個 L2 distortion labels,以及 multilingual multi-image 場景。

安裝與測試思路也相當具體。三個子項目各自有 requirements.txt、設定檔與啟動腳本;要先把資料根目錄指向 ReMMDBench,再在 .yaml.env 內填入模型端點與金鑰佔位內容,之後可先用 mmd-agent/test_qwen.py 這類健康檢查確認後端可回應,再跑各自的 evaluation scripts。倉庫已附上 Qwen-family 後端的保存結果與 artifacts,包含 Qwen 4B、9B、27B,亦明確標示 temperature = 0.0、LLM caching 與預建 RAG index,方便重現 headline numbers,而不必由零開始建立整套流程。

  • 主系統:ReMMD-Agent,核心結構是 atomic decomposition + RAG + multi-expert judge
  • 對照系統:3-stage MMD-Agent 與 MCTS-based t2-agent,方便看不同 agent 設計的取捨
  • 資料與標註:ReMMDBench 有 500 samples、2,756 images、5-way L1 與 8 類 L2 標籤
  • 相關模型:Qwen-family 4B / 9B / 27B;首頁亦提到 GPT-5.2 曾用於 leaderboard
  • 較適合的情境:研究團隊、事實查核流程設計者、多語內容審核與 agent benchmark 比較

性能方面,倉庫重點是重現論文中三套系統在 500-sample ReMMDBench 的結果,而不是提供一個即裝即用的線上服務。它較適合拿來做 benchmark 驗證、分析不同 agent pipeline 的表現,或者研究 evidence reuse 對多模態判斷有幾大幫助;要直接放進產品,仍要自行補回資料接入、服務封裝與更穩定的推理基建。

GitHub: https://github.com/DANG-ai/ReMMDBench-Agent

項目主頁: https://dang-ai.github.io/ReMMD/

Categories: 清華大學, 上海人工智慧實驗室, Agentic, RAG, 視覺模型, 多模態模型, Qwen, API, Image, 框架, 工具, 線上服務, Python, , 安全, 深度學習, 中國

Page 10 of 13
1 8 9 10 11 12 13