Hermes WebUI 把代理搬到瀏覽器

想長開一個會記住上下文的 AI agent,又不想長期困在 terminal,Hermes WebUI 正好補上這個缺口。它保留 CLI 能力,同時把多裝置存取整理得更順手。

Workspace file browser with inline preview

把一個長時間運行、會累積記憶的 autonomous agent 放到瀏覽器,而且幾乎不削弱原本 CLI 操作,正是 Hermes WebUI 最值得留意的地方。它屬於 Agent 介面工具,實際處理的是 Hermes Agent 在日常使用裡不夠方便的互動問題,讓你不必只靠 terminal 或訊息 app 才能管理對話、工作區與設定。

跟不少另起一套前端堆疊的 Web 介面不同,Hermes WebUI 走得相當克制:不用 build step、不用 framework、也不用 bundler,只靠 Python 和 vanilla JS。這種取捨帶來的好處很直接,部署比較輕、維護點較少,亦更貼近原本 Hermes Agent 的運行方式;代價是它的重點明顯放在功能對齊,而不是做一個花巧的前端展示層。

介面設計本身也有明確工作流考量。三欄布局把 session、聊天區與 workspace 檔案瀏覽分開,模型、profile 同 workspace 控制則固定放在 composer footer,減少來回切換;再加上 token context ring、Hermes Control Center、voice、mobile 與主題切換,較適合需要長時間跟 agent 協作、又要隨時查看檔案與工具呼叫紀錄的人。

  • 1:1 對齊 Hermes CLI,終端可做的操作基本都能在 WebUI 完成
  • 支援 session、workspace、voice、profiles、安全設定與手機存取
  • 可用自動探索、手動啟動、SSH tunnel、Tailscale、Docker、Nix 等方式部署
  • 建基於既有 Hermes Agent 與現成模型,毋須另設一套推理環境

安裝理解上,它不是獨立 agent,而是 Hermes Agent 的瀏覽器前端,所以前提仍然是先把 Hermes 本體跑在伺服器,再用 bootstrap、start/ctl 腳本、Docker 或 Nix module 把介面掛上去。在存取方式、部署彈性與跨裝置操作一致性;對於已經在自架 AI agent、想把 CLI 工作流延伸到桌面與手機的人,這個項目的價值相當明確。

GitHub

Categories: 開源, Agentic, 框架, Python, 語音

RVC WebUI:低門檻變聲框架的實用與代價

這個語音音色轉換框架把訓練、推理和即時變聲放進同一個網頁介面,重點是讓少量語音資料也能做出可用效果。它的強項在於速度、易用性和模型融合,代價是硬件與延遲條件仍會影響體驗。

Repository image for RVC-Project/Retrieval-based-Voice-Conversion-WebUI

RVC(Retrieval-based Voice Conversion)WebUI 把語音音色轉換、變聲推理和即時變聲收進同一套 Web 介面,適合要快速做 AI 歌聲、配音修音或聲音風格替換的人。它不是單純展示效果,而是把訓練、檢測、推理和即時輸出串成一條可操作流程,降低了進入門檻。

這個項目主打少量資料也能訓練出可用模型,官方建議至少準備 10 分鐘低底噪語音。它採用 top1 檢索去替換輸入特徵,減少音色洩漏,並用 InterSpeech2023-RMVPE 做人聲基頻提取,處理哑音問題時速度快、資源占用也較小。

支援 Python 3.12 x64;Ubuntu 24.04、Windows 與 Linux 都有對應路徑,A 卡和 I 卡則走 CPU 依賴方案,Windows 亦可用 DirectML。即時變聲延遲官方標示可達端到端 170ms,配合 ASIO 輸入輸出設備時可進一步降到 90ms,但對硬件驅動支援要求較高。

  • 可用少量語音資料訓練,門檻比傳統聲音模型低
  • WebUI 同時覆蓋訓練、推理與即時變聲
  • ckpt-merge 允許用模型融合去調整音色
  • 可接入 pymss/MSST 分離人聲與伴奏
  • 更適合配音、歌聲轉換、直播變聲與聲音原型測試

GitHub

Categories: 開源, 數字人, 模型, Linux, Python, 語音, 中國

free-claude-code:一個代理層打通 Claude Code 與 Codex

想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。

用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。

它的價值在於工作流幾乎唔使重學。你可以照用 fcc-claude、fcc-codex 或 fcc-pi 啟動對應代理,Windows 同 macOS 亦可放在背景執行,再到本地 Admin UI 揀選並驗證供應商。可在 31 個 cloud 與本地 providers 之間切換,亦可把 Fable、Opus、Sonnet、Haiku 同 fallback 流量分別導向不同模型,這點對想控制成本、速度同能力分工的團隊幾實用。

跟直接綁死單一 API 的做法相比,這個項目押注在「保留原生客戶端體驗,再用 proxy 抽換後端」。代價是相容性要靠代理層維持,所以它明確強調只會在兼容模型上保留 streaming、tool use、reasoning 同 image input;換句話說,模型可揀得更自由,但不是每個後端都保證功能完全一致。

  • 支援 Claude Code、Codex、Pi,同時保留各自原生 model picker
  • 透過本地 Admin UI 管理與驗證 31 個 cloud/本地 providers
  • 可把不同流量類型分流到不同模型,方便平衡成本與能力
  • 適合想用本地模型、付費模型或免費模型混搭的開發團隊

安裝與測試方式偏向開發者工具鏈:項目以 Python 3.14、uv、Pytest、Ruff、Ty 組成,部署重點不是雲端託管,而是先在本機跑起 proxy,再讓代理客戶端經它連線。現階段最適合已經在用 Claude Code 或 Codex、又想統一管理模型入口的人;追求零設定即用的讀者,會覺得它比較像一層需要自己維護的基建。

GitHub

Categories: 開源, NVIDIA, API, Image, 工具, IDE, Mac, Python, 編程, Anthropic, UI/UX

CADENA 把 3D 網格逐步還原成 CAD 程式

想由3D mesh 反推可編輯 CAD 流程,CADENA 提供了一條幾務實的路。它唔係一次過寫完整程式,而係每步都先執行、再比較幾何差異。

Repository image for zhemdi/cadena

做 3D reverse engineering,最大痛點唔係生成一段似樣代碼,而係生成之後能否真的建出可用、可編輯、而且封閉的幾何。CADENA 屬於模型加推理流程的參考實作,目標是把 3D mesh 重建成 parametric CAD program;它採用 stepwise inference,每次只發出一個 operation,先執行目前前綴,再用目標幾何與已建幾何的差距決定下一步。

這種做法的價值,在於把「一次過輸出整段程式」改成可檢查、可回退的逐步生成。倉庫內的 inference/ 會做 vLLM 服務、per-operation expansion 同 prefix selection,rl/ 則負責 sandboxed prefix rendering 與排序分數;系統只保留能令 IoU 改善的步驟,所以多走幾步不會令結果更差。代價同樣清楚:部署要 Python 3.10+、CUDA GPU、vLLM,同時依賴 OpenCASCADE via CadQuery,環境比一般 Vision-Language 模型推理更重。

模型本身用的是 Qwen2-VL-2B policy,Hugging Face 釋出 sft 與 rl 兩個階段,當中 rl 對應 CADENA-RL。輸入不是單張截圖,而是八個視角拼成一張圖,六個軸向視圖加兩個等角視圖;目標物放在綠色通道,當前已建立幾何放在紅色通道,模型讀到的其實是尚未補齊的殘差。這種設計直接把「下一刀應該補邊度」轉成視覺訊號。

幾個值得留意的重點:
– 倉庫提供完整推理、資料集建立、評分與可視化流程,但不包含用來合成訓練語料的 rule-based program generator。
– cadgen/ 只有 DSL runtime 的執行半部,較適合做還原、測試與基準比較,唔係完整資料生產管線。
– 預設流程會由 mesh 目錄建立 inference dataset,再輸出每一步的程式、輸入圖同 built STL,方便檢查中途錯誤。
– 無效預測會被剔除:建不出來,或者結果不是 watertight,都不算有效答案。
– 評分包含 GMS、IoU、CD,而且結果會按 family 及整體一併報告,避免單一類型零件拉高平均值。

適合研究 CAD reverse engineering、幾何生成、製造前處理,或者想把 mesh 轉回可參數化編輯流程的團隊。現階段最實際的理解方式,是把 CADENA 看成一套偏研究導向、但已經有明確 benchmark、checkpoint 同 rollout 腳本的開源項目;可重現性做得不錯,不過完整訓練資料生成鏈未公開,想延伸到自家資料或重訓流程,仍要補上不少工程工夫。

GitHub · 模型

Categories: 開源, 多模態模型, Qwen, Google, NVIDIA, 框架, 3D, Python, Dataset 數據集

DEFT-RLVR 用延後曝光減少自動駕駛 VLM 誤判

自動駕駛 Vision-language-action models 唔少都會被正確軌跡「提示」到答啱。DEFT-RLVR想處理的,正是這種看似會推理、其實先知道答案的偏差。

Ground-truth trajectory exposure can induce post-hoc rationalization and hallucination.

自動駕駛 Vision-language-action models 一旦在推理前先見到真實未來軌跡,很容易把答案合理化,卻未必真係根據場景作判斷。DEFT-RLVR 屬於訓練與驗證框架項目,核心是把「先看場景作決定」同「之後再對照候選軌跡」拆開,減少 trajectory anchoring bias。

它的做法唔係直接生成開放式座標,而是先用 AD-MCQ 把規劃問題改成多選題,再用 DEFT 兩階段流程處理:模型先做 candidate-blind scene reasoning,之後先見到候選軌跡再揀答案。這種設計的好處,是答案可被精確核對;代價則是任務表述被收窄到候選集合之內,較接近「可驗證決策」而唔係完整路徑生成。

  • 針對的不是感知本身,而是推理監督被答案污染的問題
  • AD-MCQ 保留 braking、speed 同 lateral geometry 等差異,方便精確評分
  • DEFT-RLVR 用 GRPO 聯合優化,並且可選用 rubric 監督推理過程
  • RL 階段直接由 base VLM 開始,毋須 cold-start SFT
  • 模型採用 Qwen3-VL

部署門檻不算低。項目要求另行安裝支援 CUDA 的 vLLM,Waymo codebook reconstruction 還要額外用 Python 3.9 的 autovla waymo py39 環境;預設 recipe 亦明顯偏向大型多 GPU 節點,小型設備需要自行調整 tensor parallelism、batch size、sequence length 同 offloading。

目前公開資訊顯示,它在 AD-MCQ-500 上同時提升 trajectory selection 與 candidate-blind reasoning,較穩妥的判斷是:這套方法對研究自動駕駛 VLM/VLA 訓練可靠性、想避免「先知答案再解釋」的團隊尤其有參考價值;要落地到更開放的真實規劃流程,仍要看候選軌跡構建與算力成本能否接受。

GitHub

Categories: 開源, 視覺模型, 多模態模型, NVIDIA, VLA, Python

Poplar 把人像數據集生成變成可追溯流水線

想建立可重現的人像圖文數據集,難處往往唔係生成,而係點樣保留規格、來源同質檢。Poplar正正將呢三步串成可審核流程。

Poplar teaser

生成人像圖文數據集最易失控的地方,不在於出圖本身,而在於之後很難追查提示詞有冇被改動、畫面為何被淘汰、覆蓋範圍是否足夠。Poplar把呢件事做成一條開源流水線兼框架,專注處理 human-centric image-text dataset synthesis,將 Specify、Render、Inspect 三段分開,又用 append-only JSONL 記錄每一步。

它的做法幾務實:先抽樣人物、服裝、活動、場景、取景與光線等結構化屬性,再由 Qwen3.5-27B-FP8 把規格寫成攝影導向提示詞;之後用 Krea 2 Turbo 配合 Krea2-realism-V2 生成,每個規格只出一張圖,最後再由同一個 Qwen3.5-27B-FP8 檢查圖文是否一致、是否有明顯缺陷。重點不只是「生成到」,而是連 prompt hash、seed、重試紀錄、缺陷標記同審核時間都留底。

  • 適合研究團隊、數據工程、訓練視覺模型前的數據建設工作
  • 差異在於把語意覆蓋、渲染來源與質檢決策全部做成可追溯紀錄
  • 部署門檻不算低,已發佈排程要四張 NVIDIA GPU,並需相容 CUDA 12.6 的 PyTorch 環境
  • 質量控制包含保守式 deterministic prefilter,會重試近灰階、嚴重模糊、低細節或損壞輸出

跟只看單張生成效果的做法相比,Poplar更重視整批數據集能否重現與審核,取捨是硬件需求較高,流程亦偏向資料生產而非互動創作。現有資料未見完整基準分數,但它把審核 rubric、prompt mismatch severity、evidence 與 confidence 都納入 review records,對要建立可交付數據資產的團隊,價值相當直接。

項目主頁 · GitHub

Categories: 開源, Qwen, NVIDIA, Image, Python, Dataset 數據集

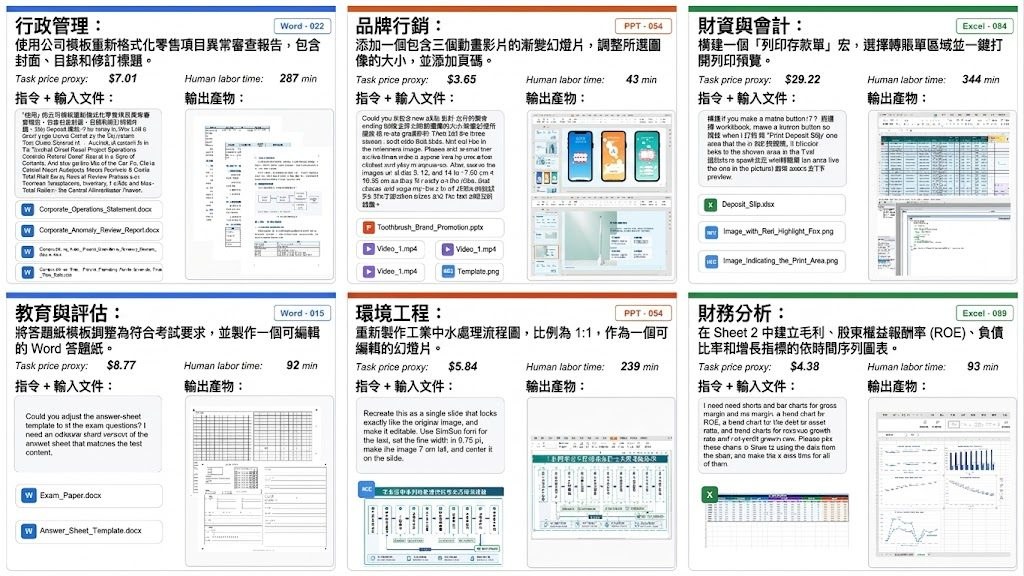
OmegaUse-OfficeVal 量度 Office 代理能力

想比較 LLM agents 做 Office 工作交付得好唔好,單靠主觀打分唔夠。OmegaUse-OfficeVal 用可執行驗證器同經濟訊號,將評測流程整理成可重跑的框架。

OmegaUse-OfficeVal benchmark framework

做 Office-suite 長流程任務,最難唔係叫模型產生文件,而係點樣穩定判斷交付物到底合格未。OmegaUse-OfficeVal 把這件事做成一個 Python 框架,同時連接 benchmark 思路與驗證流程:它收 ZIP 提交、先做安全檢查,再逐個執行 100 個 Office document evaluators,最後輸出 JSON 同 CSV 報告,適合用來評測 LLM agents 在 Office 任務中的完成度。

呢個項目的取向幾鮮明:重點唔放喺即場互動,而係放喺可重複、可審核、可批量執行的驗證。網站資料亦交代,OmegaUse-OfficeVal 對應的是一組有經濟 grounding 的長時程 Office-suite tasks,100 個任務平均要 2.32 小時人手完成,並附有人力時間與 task price proxy,方便把模型推理成本同人類成本放埋一齊看。相比只做最終分數排行,這種設計更接近團隊挑選 agent、比較交付價值時會遇到的問題。

它不是把資料集、提交內容同工作目錄全部包在倉庫內,而是把評測框架與 verifier source code 分開提供,benchmark data 另外發佈。Python 3.10 以上可跑,Windows、macOS、Linux 都支援 normal mode;其中 91 個 verifiers 可跨平台執行,另有 9 個 verifiers 依賴 Windows 上的 Office COM,相關環境未齊時會被跳過或只限指定平台處理。

  • 以 evaluate(directory: str) -> dict 統一 100 個驗證器介面,方便批量評測與整合
  • 收件前先檢查 ZIP traversal、加密、大小、檔案數量與壓縮比,安全性考慮算完整
  • 每個 verifier 在隔離 subprocess 執行,可設定 concurrency 同 timeout,減少互相干擾
  • 輸出採用 machine-readable JSON、CSV,而且每個 verifier 各有結果,後續分析較方便

這個倉庫裡主要體現在覆蓋範圍與流程穩定性,而唔係模型速度本身:可見進度、目前 verifier ID、執行 channel 同耗時,對跑大批提交會實用。它更像一個面向 Agentic 評測、研究復現同內部驗收的基建項目;想測 Office 類代理,尤其想把安全收件、隔離執行、可讀報告放進同一條流水線,這個項目的完成度相當高。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 框架, Mac, Linux, Python, Dataset 數據集, 百度

CodeNib 把代碼庫上下文交到 Coding Agent 手上

CodeNib 讓 Coding Agent 直接取用帶引用的代碼庫上下文,減少翻找檔案和拼湊脈絡的時間。它把同一份倉庫整理成多個視圖,再按需要供應給工具和介面。

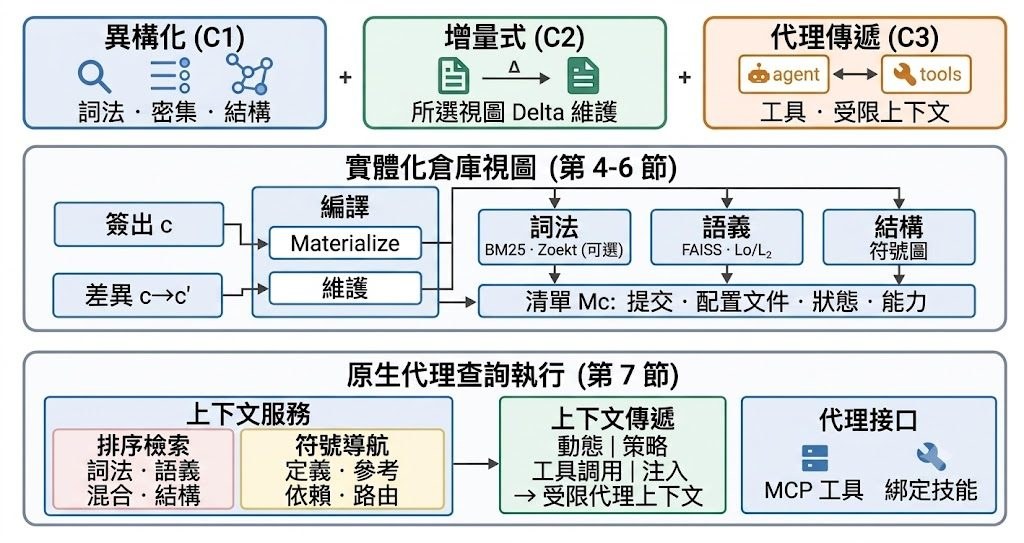
CodeNib

CodeNib 核心處理 Coding Agent 在大型項目裡最常卡住的問題:資料太散、脈絡太長、引用不清。它把倉庫編譯成 lexical、semantic、structural 同 static-navigation 多個視圖,再經 MCP、LSP-shaped providers、Python 或 HTTP API 交出去,讓工具直接拿到有來源位置的證據。

這個設計不只是做索引,而係重視增量更新同可追溯性。倉庫變動後,只會修補受影響的視圖;不適合保留的轉換才會重建。每個 view 都有獨立 manifest,記錄來源、狀態、能力同 artifact 位置,方便確認目前供緊咩上下文。

  • 主要解決 Coding Agent 讀懂倉庫時的上下文供應問題
  • 以 MCP 為核心接口,兼容 agent-native 工作流
  • Wiki、Ask view、Dependency Map 都係同一 runtime 的檢視層
  • 依賴 SCIP symbol resolution 生成 dependency map,唔靠模型猜測
  • 回答會附 file 同 line citation,方便核對

同類做法常見只係把檔案切片再丟入檢索,CodeNib 則把 lexical、dense、graph 同導航視圖放到同一個編譯流程裡。Docs 提到 live demo 支援 Python、C/C++、Go、Rust 同 TypeScript,亦展示咗一個針對 codebase 的實用取向,而唔係停留喺概念層面。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, API, Vibe Coding, Python, 編程

Temporal-Distance-JEPA 訓練世界模型能懂「時間距離」

香港浸會大學團隊把 JEPA 世界模型由「會預測」推近一步到「更識規劃」。Temporal-Distance-JEPA 針對離線示範缺少回報訊號的痛點,直接從軌跡次序挖出可用的進度成本。

Repository image for HKBU-KnowComp/Temporal-Distance-JEPA

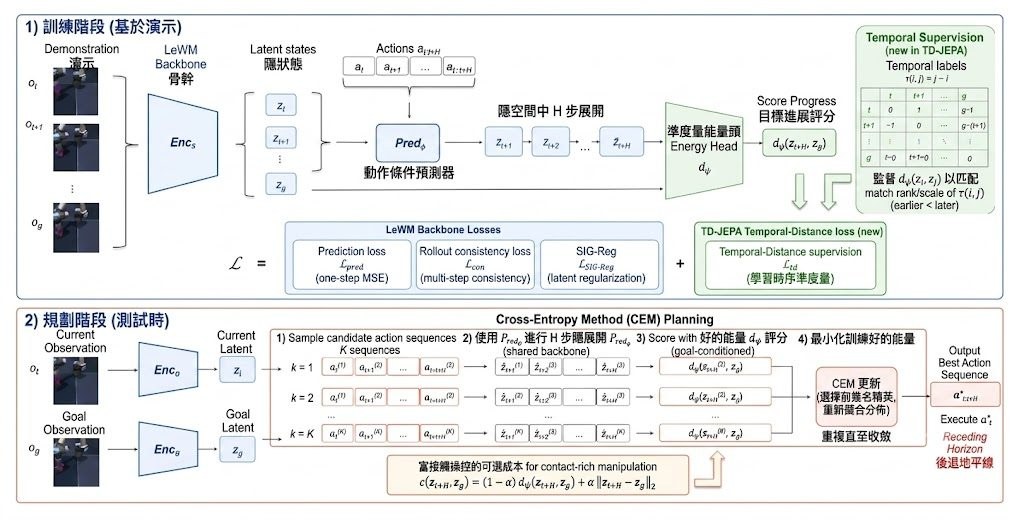
香港浸會大學 HKBU KnowComp 的 Jiaxin Bai 公開了 Temporal-Distance-JEPA 論文重現項目,核心不是再做一個更複雜的世界模型,而是修正 JEPA 規劃常見的落差:訓練時學短期 latent prediction,規劃時卻往往直接拿 latent Euclidean distance 當成目標進度。這個項目屬於模型研究重現項目,處理的是離線示範沒有 reward 時,planner 點樣判斷哪條想像路徑更接近目標。

作者保留 LeWM encoder–predictor 與 SIGReg backbone,但不再只依賴 embedding 幾何,而是從 reward-free demonstration logs 挖出 directed temporal cost。做法沿住論文邏輯很清楚:同一條 trajectory 的先後步序提供 positive targets,跨 trajectory 配對充當 heuristic negatives,再用 rollout-consistency 令學到的成本更貼近 planner horizon。這種 framing 直接回應舊範式把 latent L2 當成進度代理的限制,因為拓撲主導任務未必適合只看幾何距離。

結果在 Two-Room、Reacher 這類 topology-dominated tasks,規劃時直接部署 mined cost d_psi;到了 Push-T、OGB-Cube 這類 contact-rich tasks,則改用同一個 temporally trained checkpoint 上的 latent l2 planning。locked evaluation 下,Two-Room 成功率提升到 100.0%,高於 LeWM 的 97.4%;OGB-Cube 亦比 LeWM 高 14.2 分,並且整體上對 LeWM 與 RC-aux baseline 都能持平或更好。

  • 建基於 stable-worldmodel、stable-pretraining 與 LeWM 既有布局,重點在訓練目標與規劃成本的重新對齊
  • 公開庫是 paper-reproduction release,保留 Python CLI,但刻意不附 cluster/Slurm 包裝
  • 資料以 HDF5 形式放在 STABLEWM_HOME,涵蓋 Push-T、Two-Room、Reacher、OGB-Cube
  • 採用 10 epochs,並附有 locked results、cost matrix、diagnostics 等結果資料

這個庫比較像給已有研究工作流的人接手重跑:有 Python 環境、requirements、Hydra config、資料位置與 checkpoint 輸出方式,但沒有替不同排程系統準備現成封裝。歷史上的 contrastive SoftJEPA 相容程式仍可能留在 losses.py 或 jepa.py,不屬於公開配置;換句話說,閱讀與重現時要以 td_jepa 設定為準。對做 world model、offline RL、latent MPC 的研究團隊來說,這個項目最有價值的地方,是它把「表示學到什麼」與「規劃要怎樣排序未來」重新綁在一起。

GitHub · Paper

Categories: 開源, 浸會大學, Embedding, 世界模型, 模型訓練, 香港, Python, 中國

NVIDIA FastGen 平行解碼的加速擴散生成訓練

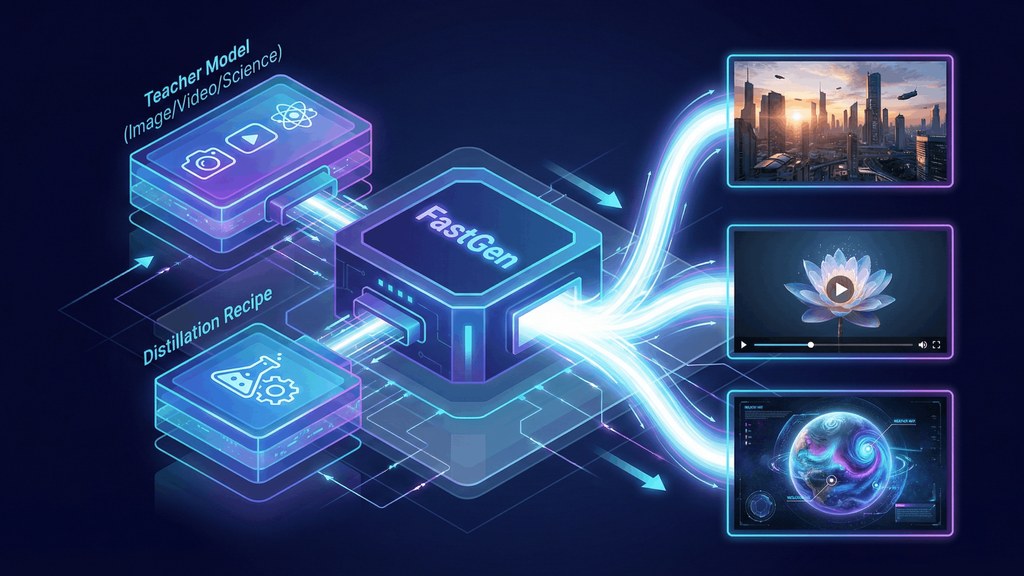
NVIDIA 團隊把擴散模型加速訓練與蒸餾流程整理成同一套框架,重點不止是跑得快,亦方便跨影像與影片任務重用方法。

Watch the video

由 NVIDIA 團隊主導,Weili Nie、Julius Berner、Chao Liu 與 Arash Vahdat 是署名作者,核心貢獻者亦包括 Weili Nie、Julius Berner、Chao Liu。這個項目放在 NVlabs 名下,定位很明確:它不是單一生成模型,而是用 PyTorch 建成的訓練框架,集中處理 diffusion models 的加速與蒸餾,讓影像與影片生成可以用較少步數完成推理,同時保留大規模訓練能力。

與一般只提供某一種加速技巧的研究代碼不同,FastGen 把 consistency models、distribution matching distillation、self-forcing、KD 等方法放進同一套結構,並且覆蓋 T2I、I2V、V2V 多種任務。這種設計的價值,在於研究團隊可以在相近配置與資料流程下比較不同蒸餾路線,而不是每試一種方法就重砌整套訓練管線。

基本理解方式:代碼庫包含 datasets、methods、networks、trainer 與 scripts,顯然以訓練、推理、評測三部分分開整理;環境方面建議用 Docker,也保留 conda 安裝路線,並支援 W&B 記錄。不過公開資訊未有列出完整 quick start 細節、現成模型清單或基準成績,現階段較像面向研究與工程團隊的基礎框架,而不是開箱即用的消費級生成工具。

Prompt:
4 NFE PDD on Wan2.1 14B: A joyful child, 
with a big smile and arms spread wide, 
swings energetically on a rusty old swing set in a sunlit backyard. The swing set, with peeling paint and creaking chains, 
contrasts against the vibrant green grass and blooming flowers surrounding it. 

The child's laughter echoes as they swing higher and higher, 
their feet barely touching the ground at the bottom of each arc.
 
The scene is captured from a low angle, 
emphasizing the height of the swings, 
with the sun casting a warm glow over everything.
Medium shot focusing on the child and the swing set.
  • 屬於框架型項目,處理的是 diffusion models 如何更快生成,而不只是再訓練一個新模型
  • 支援 ≥10B 參數的大規模訓練,較適合有多卡資源的團隊
  • 任務涵蓋 T2I、I2V、V2V,對跨模態生成研究較有吸引力
  • 方法層同時納入 consistency models、distribution matching distillation、self-forcing 等路線,方便做橫向比較

配合 NVIDIA 研究頁面的 FastGen-PDD 脈絡來看,這個項目也像是承載後續加速生成方法的底座,尤其面向 image 和 video generation 的 parallel decoding distillation。對想建立自家快速生成訓練流程、測試不同蒸餾策略,或者需要把大型 diffusion 項目整理成可維護代碼庫的團隊,FastGen 的參考價值高;但想直接下載即用、立刻看到完整評測結論的人,現有公開資料仍然偏少。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, NVIDIA, Video, Image, txt2img, Python, 語音

Page 13 of 21
1 … 11 12 13 14 15 … 21