ID-V2V:先拍片後改風格的影像研究

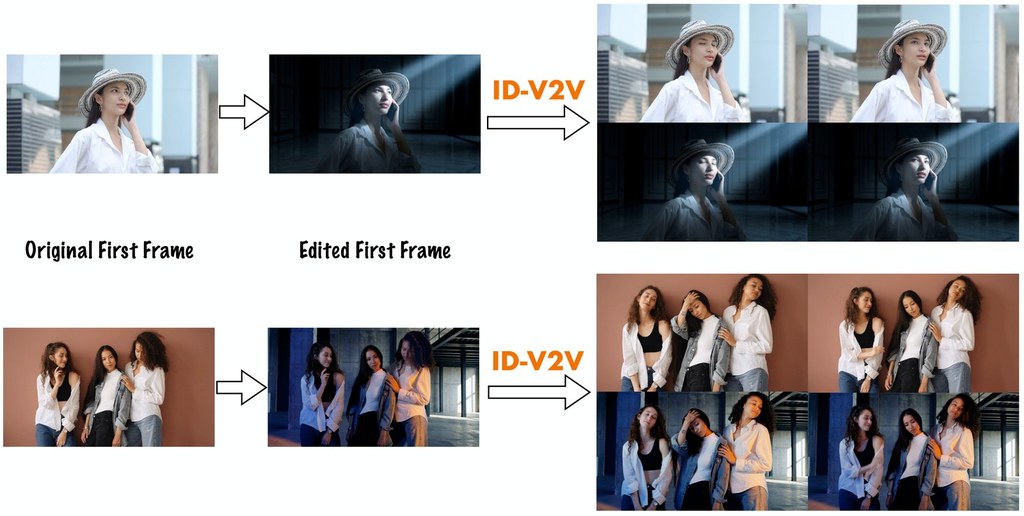
Netflix 與 Eyeline Labs 把焦點放在一件很難的事:換掉影片風格與光線之餘,角色樣貌和表演仍要留得住。ID-V2V 正是朝這個製作流程而來的研究項目。

ID-V2V teaser

開發團隊來自 Netflix 與 Eyeline Labs。這個研究項目瞄準影像製作中最棘手的一段流程:想改影片風格、場景氣氛甚至補做光線,但又不想犧牲演員的表情、眼神、口型同步和肢體動作;ID-V2V 屬於 video-to-video 生成框架,處理的正是這種「保留身份與表演、再把風格傳播到整段影片」的問題。

現有做法常把影片重繪理解成一般風格轉換或逐格生成,作者認為這種範式很難同時守住 facial likeness 與細微 performance。ID-V2V 的切入點是把 identity preservation 重新表述成 video relighting,再把 edited keyframe 帶來的風格變化交給 controlled video synthesis 處理,並結合 relit facial regions、facial normal maps、edited keyframes 與 depth sequences,將身份約束與整體畫面變化拆開處理。

這個取向的價值很直接:你先拍好 source video,再準備一張 stylized keyframe,系統便嘗試把光線、場景與風格延展到整段片,同時盡量守住人物。原始資料亦提到 imperfect keyframe 的情況,即使首張風格幀和原片姿勢未必完全對齊,模型仍會在之後的幀數重新貼近 source video 的身份與表演,這點比只追求單幀好看更貼近製作流程。

  • 提供兩個模型變體:idv2v 以及加入 normal-depth 訊號的版本
  • preprocess → generate 的推理流程與輸入輸出結構
  • 環境集中在單一 uv 環境,另需下載多個 checkpoints,預設資源需求相當高
  • 已測試於 8× A100-80GB,代表它較接近研究與製作級部署,不是輕量玩具
  • 項目定位寫得很清楚,只供 demonstration and inspiration purposes

部署與測試資訊算完整,提供環境設定、checkpoint 下載、推理流程和多種案例,但門檻不低:需要 Python 3.10、torch 2.6+cu118、SAM3 權限,以及連同 Wan2.1 相關元件在內的大量模型檔案。性能方面,項目與首頁都表示在 preserving facial likeness 與 fine-grained facial performance 上明顯優於既有方法,並支援 single-subject 與 multi-subject 場景。
項目主頁 · GitHub · Paper

Categories: 開源, Video, 影像處理, Python, Dataset 數據集

LTX-2.3 Black-Magic 黑暗補景 LoRA

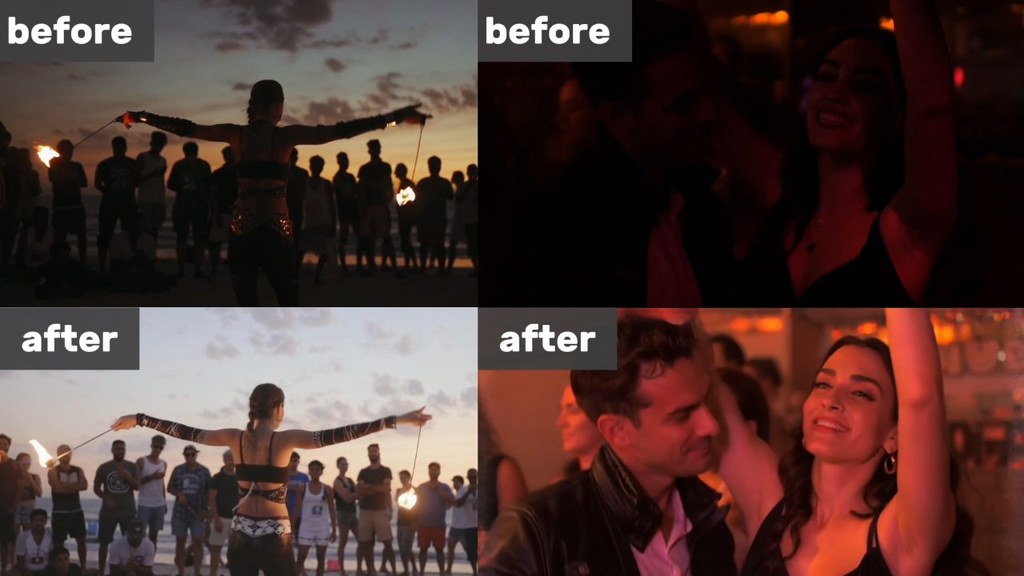
夜景片段唔夠光,未必只係拉高亮度就解決到。呢個 LoRA 走生成式 VFX 路線,重點係補出畫面可能存在的內容。

Og image

拍到過暗片段時,最直接嘅痛點係一加光就爆雜訊、細節仍然唔見。LTX-2.3-Black-Magic-LoRA 明確建基於 Lightricks/LTX-2.3,以 adapter 形式提供 IC-LoRA,定位唔係忠實還原訊號,而係替黑位內容做具時間連貫性嘅生成式重建,所以更接近 video-to-video 視覺特效模型,而唔係傳統 low-light enhancement。

取捨亦講得好清楚:當原始畫面資訊太少,模型會「推斷」暗處可能有咩,而唔係保證還原真實場景。呢種做法對氣氛鏡頭、夜景、舞台火光、森林或室內昏暗片段有吸引力,因為畫面觀感會比單純提亮更自然;但用喺證據保存、監控取證或要求真實性的工作,就要非常審慎。

項目提供嘅技術資訊相對精簡。已知它使用 diffusers,pipeline tag 係 video-to-video,模型檔案列出 black-magic-ic-lora-450.safetensors,而名稱中標示對應 LTX-2.3 22B。不過頁面截圖內容未見上下文長度、GGUF 格式量化、mmproj、llama.cpp、Ollama、LM Studio、MTP draft speculation、v2 更新紀錄、檔名變更或 chat template 說明,代表呢頁並唔係本地 LLM 部署型模型卡,相關部分無法確認。

  • 基礎模型已明示為 Lightricks/LTX-2.3,關係為 adapter,而唔係完整重訓主模型。
  • 能力核心係 shadow reconstruction,重建暗部觀感,唔等於忠實還原原始訊號。
  • 標籤集中在 ltx-video、low-light、generative-video、vfx、lighting,用途相當聚焦。
  • 已知檔案只有 black-magic-ic-lora-450.safetensors。

同一般曝光修正最大分別,在於接受「畫面不夠資料時需要生成補完」呢個前提。使用者應該將它視為風格化且偏後期製作取向嘅影像模型;想改善觀感、保住影片連續性,它有明確價值,但要用作真實場景還原,頁面本身已經劃清界線。

項目主頁 · 模型

Categories: 開源, 視覺模型, NVIDIA, Video, Image, Python, LTX

quote-and-retrieve:用「引文+檢索」的視覺文件理解

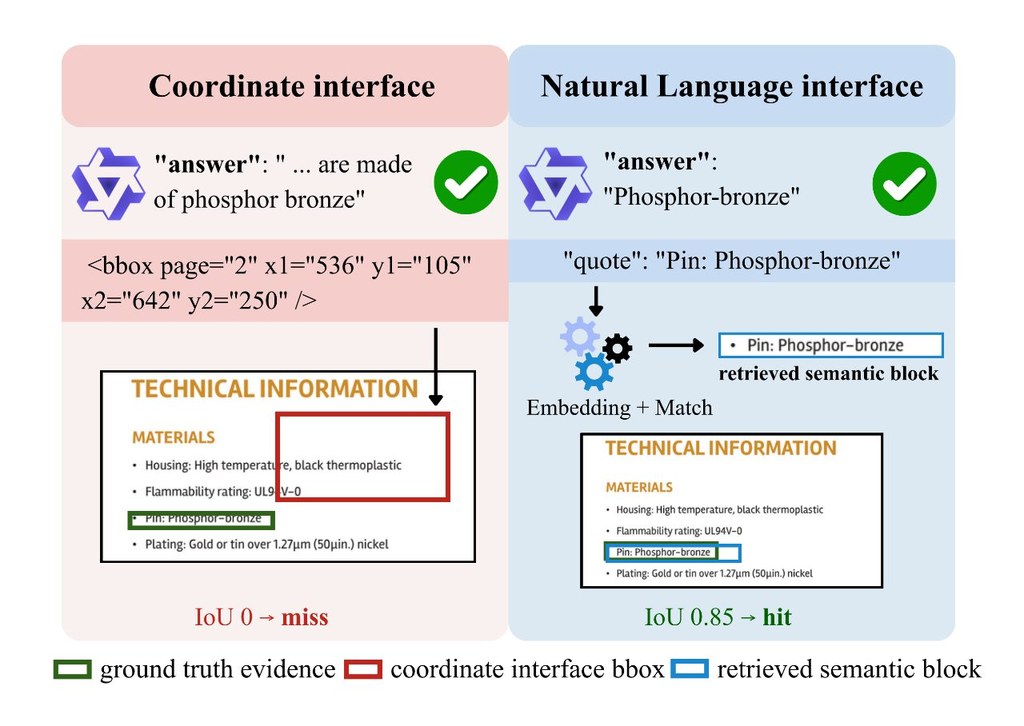
你可以把它理解成:當 VLM 答對問題卻指錯位置,問題未必出在模型,而是出在要求它輸出座標這種介面設計。換成「引文+檢索」後,歸因召回率翻倍,幻覺率近乎減半。

Repository image for Ryenhails/quote-and-retrieve

視覺語言模型 (VLM) 讀完文件回答問題時,傳統做法會要求它同時輸出 bounding box 標註證據位置;然而開源模型經常「答對但指錯」,這現象被稱為 Attribution Hallucination。這個來自赫爾辛基 Aalto 大學的開源項目主張,問題癥結很大程度是輸出介面本身的限制,而非模型缺乏 grounding 能力。

他們設計了一組控制變量實驗:固定模型、輸入頁面、題目與評分機制,僅改變證據表達方式。座標介面要求模型逐 token 生成框;語言介面則由模型輸出逐字引文,再交由外部 layout parser 與 retriever 找回對應區域(表格與圖片透過 caption 或註解引用)。在四個家族共六款開源 VLM 上,evidence recall 由座標介面下最高 8 分躍升至語言介面的 26 至 47 分,hallucination rate 近乎砍半,而答題品質幾乎不變。

基於這個對比,作者進一步提出 region-label-free GRPO 訓練方法:獎勵訊號只讀取 gold answer 與檢索區域的裁切圖,毋須任何 region-level 標註。8B 模型在這個框架下,strict attributed accuracy 由 22.4 提升至 33.8,等於用更便宜的監督換到明顯的歸因改善。

對於處理長文件、多模態表格或需要可追溯證據鏈的團隊(例如文件審核、研究文獻回顧)來說,這條 quote-and-retrieve 路線既繞開昂貴的人工框標註,也避開模型不擅長的座標生成。想要快速感受差異,只需 clone 項目後執行 python src/score_citevqa.py examples/sample_predictions.jsonl 與同一指令對座標版本跑一次;附帶的範例檔只有四題合成題,卻已重現論文核心發現。

重點摘要:
– 問題重新定位:歸因幻覺多屬輸出介面產物,並非模型能力不足
– 介面切換:座標介面換成引文+外部 retriever,evidence recall 由 ≤8 升至 26–47
– 訓練替代方案:region-label-free GRPO 用 gold answer+裁切圖作獎勵,毋須昂貴框標註
– 規模效益:8B 模型 strict attributed accuracy 由 22.4 提升至 33.8
– 快速驗證:附範例 JSONL,無需 GPU 即可重現對比結果

GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, Clone, Python

Google 開源 GNM Head:更完整的人頭 3D 模型

做人頭 3D 建模時,最麻煩往往唔係外形,而係眼球、牙齒同舌頭呢類細節。GNM Head 把呢些結構一併納入,定位明顯唔止係傳統面部 3DMM。

GNM Teaser Image

只做臉部外殼,很多時已經唔夠用;去到動畫、重建同生成式影像控制,眼球、口腔同頭部姿態一旦分離得唔好,效果就會即刻穿崩。google/GNM 目前先開放的 GNM Head,屬於3D parametric statistical human model 項目,焦點是用更完整的人頭幾何表示,處理傳統 3D Morphable Models (3DMMs) 對內部 anatomy 覆蓋不足的問題。

這個項目的取向很鮮明:不只是追求一個可調參的人臉網格,而是把 head、face、neck、eyeballs、teeth、tongue 放進同一個生成式人體測量框架。作者在技術報告指出,現有公開模型多數只覆蓋外部幾何,亦容易受限於低保真掃描資料;GNM 則結合高解析 3D scans 與 anatomy-specific artist-made samples,並加入 ocular 同 intra-oral specialized sub-models,目的就是改善幾何品質同可控性之間的取捨。

現有儲存庫較像一個生態系入口,而唔係即開即用的單一應用程式。README 清楚列出 GNM Head 已提供 NumPy、JAX、PyTorch、TensorFlow 多後端支援,亦有 Linux、macOS、Windows 的 CI;但目前公開資訊以模型與技術報告為主,未見到很完整的產品化操作流程說明,所以較適合研究、角色生成、數碼人、3D 視覺或生成式影像控制團隊按其子目錄文件逐步接入。

  • 補足傳統 3DMM 常見缺口:不只外形,連眼球、牙齒、舌頭都可控
  • GNM Head 強調 identity、expressions、head pose 的 disentangled control
  • 同時支援 NumPy、JAX、PyTorch、TensorFlow,方便接去不同研究流程
  • 技術報告聲稱在 fitting target 3D face scans 達到 SotA 表現,但具體指標仍要回看原報告

它最吸引人的地方,在於把「可生成、可擬合、可作條件控制」三條路線拉到同一個模型家族內。現階段公開內容仍以 GNM Ecosystem 的起步版本為主,想拿來做完整 production pipeline,仍要自己判斷與現有重建、動畫或生成系統的整合成本;但作為高保真人頭 3DMM 的新基礎,這個項目的研究價值同延展空間都相當高。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Google, TensorFlow, Mac, 3D, Linux, Python, 語音, Dataset 數據集

FilmOps 將電影語言拆成可分析標籤

想認真分析影片鏡頭,而唔只看「好唔好睇」,FilmOps 提供一套更接近電影製作語言的開源方法。它將畫面拆成可讀標籤,方便做評測、整理同研究。

FilmOps logo

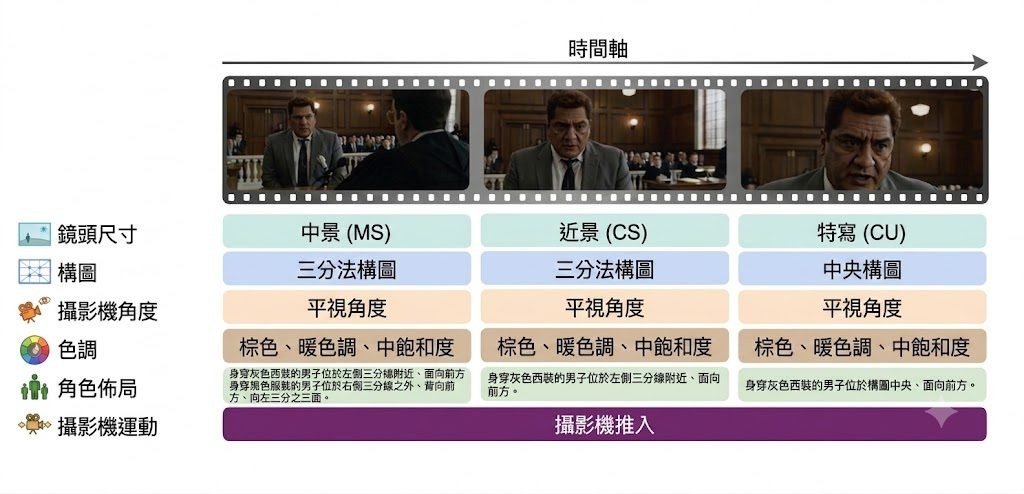
一段影片好不好,不一定只靠整體觀感判斷;鏡頭遠近、構圖、機位、色調同運鏡,往往先係影響觀感的核心。FilmOps 正正瞄準呢個缺口:它不是一般影片生成模型,而是一套開源 operator suite,用來把影片畫面映射成結構化的 cinematographic labels,處理的是電影語言難以被細緻分析與量化的問題。

現有影片 benchmark 多數集中在 general perceptual quality、text alignment 或 temporal smoothness,對專業 cinematographic language 仍然偏粗略;general-purpose MLLMs 又難以穩定辨認 film-specific attributes,而 aesthetic predictors 這類領域模型面對 cinematic content 亦有明顯 domain gap。FilmOps 的取向很清楚:不用單一大模型包辦所有判斷,而是把六個維度拆開,按任務特性分配不同 backbone,令 shot scale、composition、camera angle、color & tone、character layout 同 camera movement 可以分別處理。

它的價值在於更像一套分析管線,而不是只給你一個總分。項目覆蓋 55 個以上子類別,分類定義對齊 Film Art、ASC Manual、Cinematography: Theory and Practice,亦經過 practitioner 驗證;加上 modular architecture,可以獨立用單一 operator,或者走 unified pipeline。對要做影片生成評測、鏡頭標註、資料整理,甚至研究 FilmBench 呢類 cinematic benchmark 的團隊,這種拆解方式會比泛用多模態評分更有解釋力。

  • 屬於開源工具/模型組合,重點是把影片拆成電影語言標籤,而不是直接生成影片
  • 六個 operator 採用 task-specific backbone,包含 DINO ViT-B/14、BEiT Base、ResNet-18、InternVL3-14B
  • 支援 live-action、3D animation、2D animation 同 stylized content,強調 cross-genre consistency
  • 已交代基本部署條件,包括 Python、PyTorch、CUDA 與 ffmpeg,也提供 unified pipeline 與 checkpoints 準備方向

現有資料只明確指出它在所有維度都勝過 general-purpose MLLMs,但細節主要放在論文。配套的 FilmBench 亦用同一套 Cinematic Language 思路建立 benchmark,並聲稱 evaluator 在模型排名上與人工評分高度一致,說明 FilmOps 並非只為展示而做,而是服務整個影片評測流程。不過它始終偏向分析與標註基建,想直接拿來做完整產品,仍要自行處理 checkpoints 下載、推理資源,並接受部分 operator 對 CUDA 與較重模型的依賴。

GitHub · Paper

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, NVIDIA, Gemini, 3D, Python, 語音, 動畫, Dataset 數據集

Ollama 3.25 把開源模型帶回你部機

想喺自己電腦跑開源大模型,又唔想先砌一大堆環境,Ollama 正正係針對呢個卡位。它將模型執行、管理同串接應用壓縮成一條較順手的路。

Repository image for ollama/ollama

想將開源模型放返本地處理,又要兼顧聊天、程式整合同 agent 工作流,Ollama 幾乎係目前最直接的一條路。它屬於模型執行與管理工具,核心作用係將本地大語言模型的下載、啟動、呼叫同整合收斂到同一套介面,令 Mac、Windows、Linux 甚至 Docker 部署都比較一致。

它吸引人的地方不只是可以對話,而係可以直接接去 Claude Code、OpenClaw、Codex、Copilot 等現有工具鏈。換句話說,Ollama 唔係只提供一個聊天殼,而係充當本地模型服務層;你可以用 CLI 跑模型、經 REST API 調用,亦可以配合 ollama-python、ollama-js,或者再接 Open WebUI、LibreChat、Lobe Chat、NextChat、Perplexica 呢類前端與應用。

同類做法入面,Ollama 的取向好清楚:它唔著重花巧介面,而係先處理「點樣穩定喺本地把模型跑起來,再供其他程式使用」呢件事。背後支援 llama.cpp,意味住它承接咗本地推理生態的成熟基礎;代價亦存在,本地效能仍然受你部機的記憶體、GPU 與模型大小限制,追求大型模型或高併發時,就未必有雲端服務咁輕鬆。

  • 安裝路徑完整,覆蓋 macOS、Windows、Linux 同 Docker,理解上可以當成一個本地 AI 服務。
  • 既可直接 run 模型聊天,亦可透過 REST API、Python、JavaScript 接入現有項目。
  • 跟 Claude Code、OpenClaw、Codex、Copilot 等整合,適合做本地 agent 與開發工作流。
  • 配合 Open WebUI、LibreChat、Lobe Chat、NextChat 等,可快速補上可視化操作層。

較受惠的一群,會係想保留資料喺本地的開發者、需要快速測試開源模型的團隊,以及想把 AI 能力嵌入內部工具的人。就產品定位而言,Ollama 最有價值的地方,係將「本地跑模型」由零散步驟變成可重用的基礎設施。

項目主頁 · GitHub

Categories: 開源, Agentic, API, Mac, Linux, Ollama, Python

ProVisE 用像素答案重做空間評測

空間理解唔一定適合用文字作答,ProVisE改咗評測入口,令圖像生成模型可以用畫、點、標記去答題。你會更易睇清楚,模型到底係唔識空間,定只係答題格式唔對。

ProVisE logo

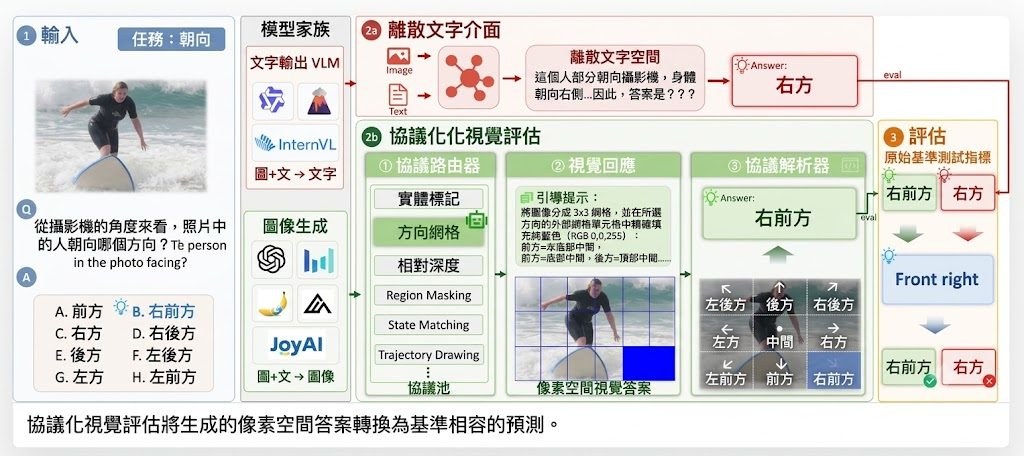
當一條空間題目本來應該用圈選、標記路徑或者遮罩去表達,硬要模型交出座標、選項字母或文字描述,結果往往唔係能力差,而係答題介面同模型表達方式錯位。ProVisE屬於評測框架,處理的正是呢個落差:它唔改原本 benchmark 任務本身,只改回應介面,讓圖像生成模型用像素空間交答案,再轉回 benchmark 可計分的結構化輸出。

現有 spatial benchmarks 多數沿用 text-only interface,假設所有模型都應該以 coordinates、option labels 或 textual descriptions 回答。作者認為這種固定範式會壓縮 regions、paths、affordances 呢類本身偏視覺的判斷,因此提出 Protocolized Visual Evaluation:先由 task-aware router 指派 visual protocol,再用固定 guidance prompt 同 parser 約束輸出,最後仍然交回 original benchmark metric 評分。Text-output VLMs 就維持原本答題空間,兩類模型可以在同一套任務語義下比較。

ZJU-OmniAI/ProVisE 在於把「模型唔識答」同「評測方法逼錯答案格式」分開處理。配套的 SpatialGen-Bench 收錄 470 個 curated samples,涵蓋 14 個 subtasks,同時分成 perception、understanding、reasoning、interaction 四個 capability levels;研究結論亦相當直接,image-generation models 在可把判斷外化成像素標記的任務上有競爭力,但 text-output VLMs 在另外一些題型仍然較穩定,兩者並非誰全面取代誰。

  • 保留原有 benchmark metric,只替換答案介面,方便同既有結果對照
  • 用 visual protocol 限制生成內容,減少任意畫圖帶來的解析歧義
  • SpatialGen-Bench 把空間能力拆成 14 個 subtasks,唔再只看單一總分
  • 適合研究 VLM、image-generation models、agent 空間理解能力的團隊採用

安裝門檻看來不高,程式環境以 Python 3.10+ 為主,並已公開 code、project page 與 Hugging Face 上的 SpatialGen-Bench。現階段它更像研究與評測項目,不是即插即用產品;重點也不在部署成服務,而是在你想驗證模型空間認知時,能否用更貼近模型輸出形式的方式做比較。對做多模態模型、視覺評測或 Agentic 系統的人來說,ProVisE提供了一個相當清晰的檢查角度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, Image, Python, Dataset 數據集

GraphVid 把圖生影片拆解成圖節點關係圖

GraphVid 用一張關係圖重新組織影片生成流程,讓畫面之間的動作轉折更像被刻意安排,而非逐格拼湊。

Og image

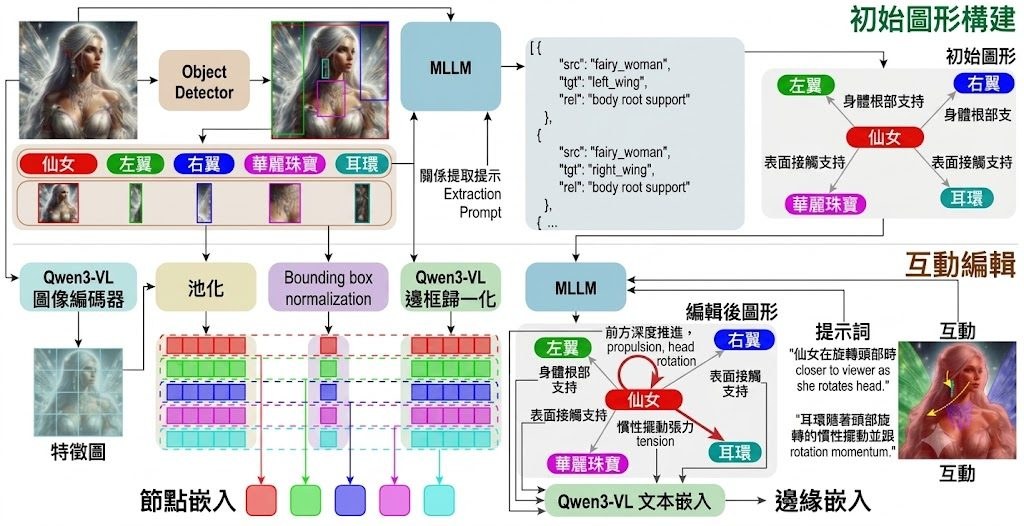
PLAN-Lab(伊利諾伊大學厄巴納-香檳分校)開源的 GraphVid 採用 Diffusers 框架,用 Stable Diffusion 類的 Diffusion Pipeline 配 bfloat16 精度載入,適用於 CUDA 與 Apple MPS 裝置。這個名稱裡的「Graph」不是社群網絡圖,而是把影片拆成多個關鍵畫面節點,再用一張小型關係檔 graph.pth(約 118 MB)描述節點之間如何銜接——模型先理解這些畫面該怎樣排序與過渡,再交由 transformer、VAE 等模組逐段生成。

頁面沒有公開 base model 來源,也沒有說明訓練資料或評測指標,因此難以判斷它的整體品質,只能從架構面推測它把控制粒度從「逐幀文字描述」轉移到「節點拓樸」。使用 DiffusionPipeline.from_pretrained 配合 torch_dtype=torch.bfloat16,屬於現今影片擴散模型常見的省記憶體做法。

從模型卡提供的程式碼範例可見,GraphVid 直接接受文字 prompt 即可生成畫面,毋須手動編排節點,這層抽象對一般使用者比較友善;進階用家則可透過 graph.pth 微調節點關係,控制運鏡節奏。整個 gvc_ckpt_folder 容量約 64.3 GB,包含 scheduler、text_encoder、tokenizer、transformer、VAE 等標準組件,搭配 Hugging Face 提供的 Colab / Kaggle 範例即可快速試跑。

  • 關係圖驅動:以 graph.pth 定義畫面節點與時序關係,再交由擴散模型生成影片。
  • Diffusers 相容:透過 DiffusionPipeline 載入,支援 bfloat16 與 CUDA / MPS。
  • Apache-2.0 授權:可自由下載研究與再分發,但頁面未提供量化版本。
  • 硬體需求高:完整 checkpoint 約 64.3 GB,建議使用高階 GPU。
  • 缺乏評測數據:原始頁面沒有提供基準分數或與其他影片模型的直接比較,採用前宜自行測試。

若以本地消費級 GPU 試跑,建議先把 torch_dtype 設為 bfloat16,並留意 VRAM 是否足以容納 transformer 與 VAE 的權重;想進一步壓縮,可留意社群後續是否釋出量化或 LoRA 版本。

項目主頁

Categories: 開源, Google, NVIDIA, Stable Diffusion, Image, 框架, 教學, Python, 蘋果

OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

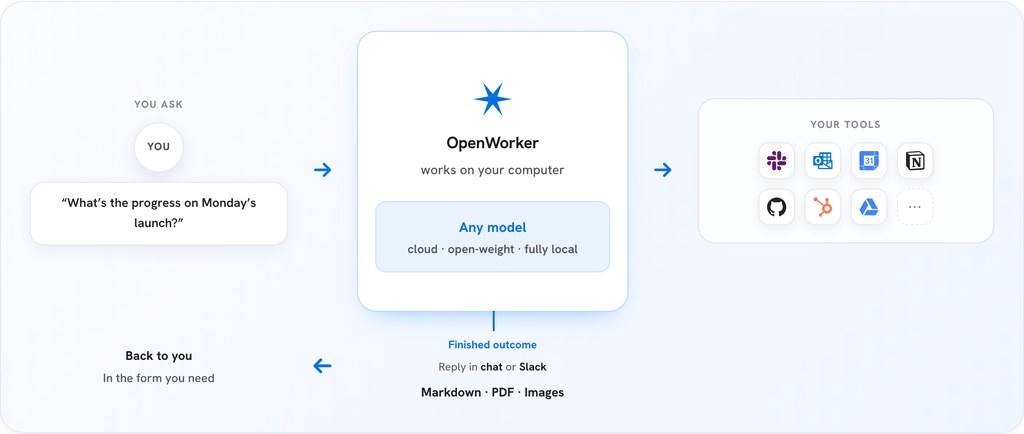
OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。

項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

TrajLoc 把路線描述對準衛星圖

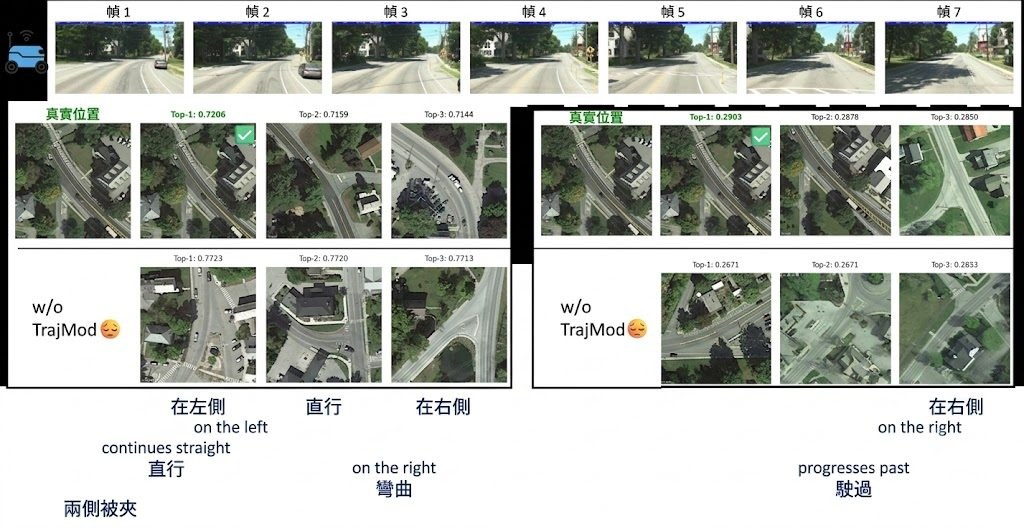
單張街景未必足夠判斷位置,TrajLoc改為沿住整段路線做比對。影片、文字敘述,甚至兩者一齊用,都可以指向同一塊衛星瓦片。

A trajectory can be queried as dense video or as abstract language — both retrieve the same satellite tile.

只靠一張街景相去配對衛星圖,遇到轉彎、路口相似、視角受限時好容易失手;TrajLoc改為追蹤整段移動路線,將街景影片、自然語言路線描述,或者兩者結合後對應到帶地理標記的衛星瓦片。它屬於跨視角 geo-localization 模型連同 benchmark 項目,處理的是「把連續路徑準確放回地圖」這個問題。

現有 cross-view 資料多數停留在 single-image、video-only 或 text-only 範式,作者認為這樣會拆散同一條路線入面本來互相補強的時序線索與語意線索,因此一併推出 SeqGeo-VL。呢個 benchmark 收錄 38,863 組對齊的 video-text-satellite triplets,並有 91.8% human verification pass rate,重點不是再加大資料量,而是把 sequential 同 linguistic 兩種證據放入同一任務。

TrajLoc沒有另起一套龐大時序架構,而是由 pretrained CLIP ViT-L/14 延伸成 video、text 同 satellite encoders,再用 co-training curriculum 將三種查詢模式放入同一個表示空間。作者另外加入 TrajMod,將路線幾何資訊 tau={(Δx_i, Δy_i, θ_i)} 轉成 FiLM 的 scale/shift 參數,直接調節 query embedding;做法比單靠提示詞更明確,亦保留 frozen encoders 的可重用性。

  • 支援 video、plain language、video+text 三種查詢方式
  • SeqGeo-VL 是首個同時包含 sequential 與 linguistic cross-view benchmark
  • TrajMod 只用 waypoint offsets 與 headings,不靠 map 或 POI metadata
  • 項目提供 agent-ready tool interface、persistent Python API 同 JSON CLI

從示範與說明看,TrajLoc的定位很清楚:它不是通用多模態聊天模型,而是給 spatial reasoning、戶外機械人、導航研究同 multimodal agents 調用的專門工具。225 ms 的示例檢索速度對互動式流程有吸引力,但目前公開資訊主要集中在 benchmark 與檢索能力,部署前仍要留意資料覆蓋範圍、地區泛化,以及自己的工作流是否真有影片或路線文本可供查詢。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, Embedding, 多模態模型, 模型訓練, Qwen, API, Video, Image, Python, Dataset 數據集

Page 14 of 21
1 … 12 13 14 15 16 … 21