Deepseek 的 5 個有趣實驗

作者進行五個關於 DeepSeek R1 以及其他模型(Claude 3.5、OpenAI)的實驗。實驗一測試模型生成 3D 瀏覽器模擬程式碼的能力,結果 DeepSeek R1 成功完成;實驗二結合 Claude 的功能與 DeepSeek R1 的推理機制,實現更複雜的資訊處理;實驗三探討模型在一個數值猜測遊戲中的推理過程,展現了模型的思考步驟;實驗四修改經典的河渡問題,測試模型是否能跳脫既有訓練資料的限制,DeepSeek R1和Claude成功解決,OpenAI則失敗;實驗五則以情境題測試模型的連續推理能力,多個模型皆能得出正確結論。整體而言,影片旨在展示大型語言模型的程式碼生成、工具使用、推理能力以及突破訓練資料限制的潛力,並分享作者對模型能力的觀察與思考。

作者進行五個關於 DeepSeek R1 以及其他模型(Claude 3.5、OpenAI)的實驗。
實驗一測試模型生成 3D 瀏覽器模擬程式碼的能力,結果 DeepSeek R1 成功完成;
實驗二結合 Claude 的功能與 DeepSeek R1 的推理機制,實現更複雜的資訊處理;
實驗三探討模型在一個數值猜測遊戲中的推理過程,展現了模型的思考步驟;
實驗四修改經典的河渡問題,測試模型是否能跳脫既有訓練資料的限制,DeepSeek R1和Claude成功解決,OpenAI則失敗;
實驗五則以情境題測試模型的連續推理能力,多個模型皆能得出正確結論。
整體而言,影片旨在展示大型語言模型的程式碼生成、工具使用、推理能力以及突破訓練資料限制的潛力,並分享作者對模型能力的觀察與思考。

I Did 5 DeepSeek-R1 Experiments | Better Than OpenAI o1?
Categories: 模型, DeepSeek, 新聞

DeepSeek R1 在 Pi 達每秒 200 個 token

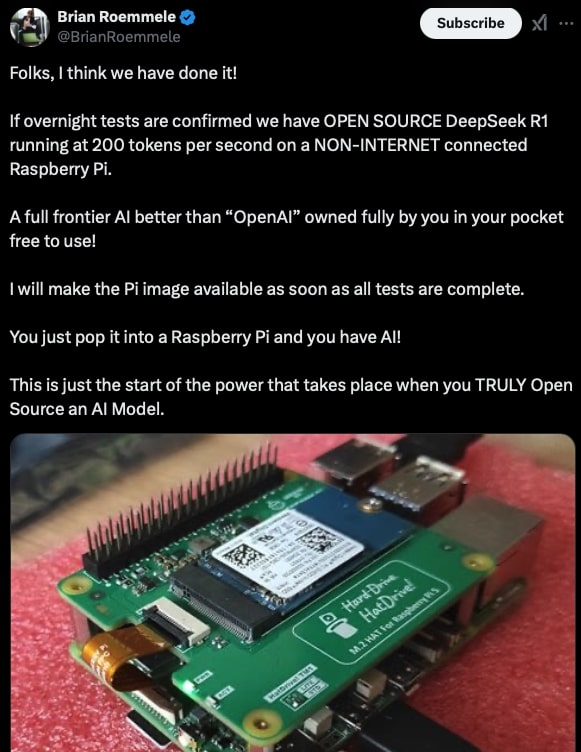
開源人工智慧模型 DeepSeek R1 在樹莓派上以每秒 200 個 token 的速度運作,這是個突破性進展。重點在於此模型的效能即使在資源受限的樹莓派上也能達到令人驚訝的表現,並超越某些商業模型,例如OpenAI的某些版本。文章同時比較了不同硬體平台(如樹莓派、桌上型電腦、高效能GPU)運行此模型的效能差異,並探討了其在遊戲NPC應用上的潛力,強調其離線運作、低延遲以及可定制性等優點。

開源人工智慧模型 DeepSeek R1 在樹莓派上以每秒 200 個 token 的速度運作,這是個突破性進展。重點在於此模型的效能即使在資源受限的樹莓派上也能達到令人驚訝的表現,並超越某些商業模型,例如OpenAI的某些版本。文章同時比較了不同硬體平台(如樹莓派、桌上型電腦、高效能GPU)運行此模型的效能差異,並探討了其在遊戲NPC應用上的潛力,強調其離線運作、低延遲以及可定制性等優點。

Categories: 開源, 模型, 新聞

生物運算將應用於 A.I. 領域

瑞士 FinalSpark 實驗室利用腦部類器官 (brain organoids) 開發生物電腦的最新進展。這些微小的球狀物,由約一萬個從幹細胞培養而成的腦神經元組成,被放置在培養器中並連接到電極,以便進行通訊和訓練。此研究屬於生物運算 (bio-computing) 或稱濕件 (wetware) 的領域,目標是創造比現今電腦更節能且高效的運算系統,並可能徹底改變人工智慧系統。

瑞士 FinalSpark 實驗室利用腦部類器官 (brain organoids) 開發生物電腦的最新進展。這些微小的球狀物,由約一萬個從幹細胞培養而成的腦神經元組成,被放置在培養器中並連接到電極,以便進行通訊和訓練。此研究屬於生物運算 (bio-computing) 或稱濕件 (wetware) 的領域,目標是創造比現今電腦更節能且高效的運算系統,並可能徹底改變人工智慧系統。

Biocomputers made from human brain cells could run the AI systems of the future
Categories: Medical醫學, 新聞

Google 正在模擬整個物理世界

谷歌最近的人工智慧計畫是模擬整個物理世界的系統,谷歌認為這是通往通用人工智慧的關鍵路徑,以及它如何與谷歌更廣泛的人工智慧策略相連,這當然包括 Gemini。  這是 Google DeepMind 一項突破性的 AI 計畫:建構模擬整個物理世界的系統,以朝向通用人工智能 (AGI) 邁進。該系統整合了多模態數據 (例如影片、音訊和機器人數據),用以模擬真實世界的物理規律,並將應用於機器人、遊戲和科學研究等領域。 這項計畫展現 Google 擴展 AI 模型以達到前所未有的智能和真實感的雄心壯志,並預期將對各產業帶來革命性的影響,加速 AGI 的實現。

谷歌最近的人工智慧計畫是模擬整個物理世界的系統,谷歌認為這是通往通用人工智慧的關鍵路徑,以及它如何與谷歌更廣泛的人工智慧策略相連,這當然包括 Gemini。

 這是 Google DeepMind 一項突破性的 AI 計畫:建構模擬整個物理世界的系統,以朝向通用人工智能 (AGI) 邁進。該系統整合了多模態數據 (例如影片、音訊和機器人數據),用以模擬真實世界的物理規律,並將應用於機器人、遊戲和科學研究等領域。 這項計畫展現 Google 擴展 AI 模型以達到前所未有的智能和真實感的雄心壯志,並預期將對各產業帶來革命性的影響,加速 AGI 的實現。

Google’s New AI Is Recreating the Whole World to Unlock Superhuman Intelligence
Categories: 多模態模型, 3D, 推理引擎, 新聞

NVidia Sana – 高速生成高解析度模型

NVidia Lab(NVlabs) Sana 是一個高效的文字轉圖像模型,其核心設計包含高效的編碼器-解碼器架構 (DC-AE)、線性擴散變換器 (Linear DiT)、僅解碼器的文字編碼器,以及 高效的訓練和採樣方法 (Flow-DPM-Solver),讓它能快速生成高解析度 (最高 4096×4096) 的高品質圖片。相較於其他大型擴散模型,Sana 模型體積小,速度快,甚至可在 16GB 的筆電 GPU 上執行,生成 1024×1024 解析度的圖片只需不到一秒鐘。文件中包含了模型的架構說明、效能數據、使用方法(包含使用 Hugging Face Diffusers 的方式)、訓練方法以及未來的發展方向等資訊。

NVidia Lab(NVlabs) Sana 是一個高效的文字轉圖像模型,其核心設計包含高效的編碼器-解碼器架構 (DC-AE)、線性擴散變換器 (Linear DiT)、僅解碼器的文字編碼器,以及 高效的訓練和採樣方法 (Flow-DPM-Solver),讓它能快速生成高解析度 (最高 4096×4096) 的高品質圖片。相較於其他大型擴散模型,Sana 模型體積小,速度快,甚至可在 16GB 的筆電 GPU 上執行,生成 1024×1024 解析度的圖片只需不到一秒鐘。文件中包含了模型的架構說明、效能數據、使用方法(包含使用 Hugging Face Diffusers 的方式)、訓練方法以及未來的發展方向等資訊。

NVIDIA SANA In ComfyUI - 100 Times Faster Than Flux And Render 4K Images
Categories: 新聞

Nvidia 透露了人工智慧的下一步

介紹 Nvidia 如何利用 物理AI (Physical AI) 推動自動駕駛和機器人領域的發展。Nvidia 認為,繼生成式AI (Generative AI) 和代理AI (Agent AI) 之後,物理AI 將是AI 的下一個前沿,這需要建立像大型語言模型那樣的「世界基礎模型」(World Foundation Model)。 Nvidia 的 Cosmos 平台正是用於建立此模型,透過生成大量逼真的合成數據來訓練物理AI 模型,克服真實世界數據收集成本高昂的問題。 Isaac Groo 平台則進一步提供工具和框架,加速機器人開發,並與 Omniverse 平台整合,打造數位孿生(Digital Twin) 以模擬和優化各種場景,例如工廠和倉庫的物流作業,以及自動駕駛汽車的測試。 整體而言,這段文字闡述 Nvidia 如何利用其技術棧,從數據生成、模型訓練到應用部署,全面推動物理AI 的發展,並預測其在自動駕駛和機器人領域的巨大潛力。

介紹 Nvidia 如何利用 物理AI (Physical AI) 推動自動駕駛和機器人領域的發展。Nvidia 認為,繼生成式AI (Generative AI) 和代理AI (Agent AI) 之後,物理AI 將是AI 的下一個前沿,這需要建立像大型語言模型那樣的「世界基礎模型」(World Foundation Model)。 Nvidia 的 Cosmos 平台正是用於建立此模型,透過生成大量逼真的合成數據來訓練物理AI 模型,克服真實世界數據收集成本高昂的問題。 Isaac Groo 平台則進一步提供工具和框架,加速機器人開發,並與 Omniverse 平台整合,打造數位孿生(Digital Twin) 以模擬和優化各種場景,例如工廠和倉庫的物流作業,以及自動駕駛汽車的測試。 整體而言,這段文字闡述 Nvidia 如何利用其技術棧,從數據生成、模型訓練到應用部署,全面推動物理AI 的發展,並預測其在自動駕駛和機器人領域的巨大潛力。

Nvdia CEO Just Revealed The NEXT STEP In AI....
Categories: 新聞

Pinokio 3.0.26 A.I. 瀏覽器更新

更新主要圍繞著使用者介面客製化、錯誤處理機制改進、以及新增多項功能三個面向。 更新包含了自定義首頁和應用程式頁面樣式、更友善的藍屏錯誤顯示及除錯API、預設整合 uv 命令和磁碟空間重複數據刪除功能,以及新增 JSON API (包含json.get、json.set、json.rm)提升資料操作效率。此外,還加入了瀏覽器自動化功能 (整合 Playwright),應用程式設定精靈簡化環境變數設定,Huggingface API 整合方便模型下載,以及新的檔案系統 API (fs.open, fs.cat)和檔案瀏覽器整合。最後,也修復了一些錯誤,例如特定埠衝突問題和Mac系統相容性問題。 整體而言,此更新增強了Pinokio的易用性、穩定性和功能性。 Pinokio 3.0.26 版本 10 點主要更新:

更新主要圍繞著使用者介面客製化、錯誤處理機制改進、以及新增多項功能三個面向。 更新包含了自定義首頁和應用程式頁面樣式、更友善的藍屏錯誤顯示及除錯API、預設整合 uv 命令和磁碟空間重複數據刪除功能,以及新增 JSON API (包含json.get、json.set、json.rm)提升資料操作效率。此外,還加入了瀏覽器自動化功能 (整合 Playwright),應用程式設定精靈簡化環境變數設定,Huggingface API 整合方便模型下載,以及新的檔案系統 API (fs.open, fs.cat)和檔案瀏覽器整合。最後,也修復了一些錯誤,例如特定埠衝突問題和Mac系統相容性問題。 整體而言,此更新增強了Pinokio的易用性、穩定性和功能性。

Pinokio 3.0.26 版本 10 點主要更新:

  1. 自訂使用者介面 (UI):使用者可以客製化首頁、應用程式頁面的 CSS 樣式,以及終端機的顯示方式。具體來說,可以透過建立 index.ejs 檔案來客製化首頁,並使用自訂 CSS 來設定應用程式頁面的樣式。
  2. 改進的錯誤畫面:當發生錯誤時,Pinokio 會顯示藍色畫面,並提供更具體、相關的錯誤訊息,而不是像以往一樣顯示模糊的 “ENOENT file not found”。
  3. Shell 中斷點 API:使用者可以在 shell.run 中指定模式,讓程式在特定模式發生時中斷,或忽略某些特定的錯誤訊息。
  4. 內建 UV 工具:Pinokio 預設包含 uv 工具,可以直接在 Pinokio 的 Shell 中使用 uv 命令。此外,uv 還支援通過 fs.link 進行磁碟空間重複資料刪除。
  5. 磁碟使用量顯示:Pinokio 會顯示每個應用程式佔用的磁碟空間大小,這有助於使用者管理磁碟空間。
  6. JSON API:新增 json.get、json.set 和 json.rm 等 JSON API,讓使用者可以讀取、設定和刪除 JSON 檔案中的屬性。json.get 可以將 JSON 檔案載入到本地變數,json.set 可以設定 JSON 檔案的屬性,而 json.rm 則可以移除 JSON 檔案中的屬性。
  7. 瀏覽器自動化:Pinokio 預設包含 Playwright,使用者可以使用 kernel.playwright API 來編寫 JavaScript 程式碼,以自動與應用程式互動。
  8. 應用程式設定精靈:每個腳本現在都有一個可選的 pre 屬性,使用者可以設定腳本執行前必須設定的環境變數。如果環境變數未設定,則會顯示精靈畫面,讓使用者填寫這些變數。
  9. Huggingface API:Pinokio 現在包含一個腳本 API,可以直接透過 JSON-RPC 呼叫來與 huggingface-cli 互動。使用者可以使用 hf.download 方法來下載 Hugging Face 模型,例如:{ “method”: “hf.download”, “params”: { “path”: “app/models”, “_”: [“adept/fuyu-8b”, “model-00001-of-00002.safetensors”], “local-dir”: “fuyu” } }.
  10. 新的檔案系統 API:新增 fs.open、fs.cat 等檔案系統 API,fs.open 可以開啟檔案或檔案總管,而 fs.cat 可以印出檔案內容。此外,使用者也可以在 pinokio.js 選單中使用 fs: “view” 或 fs: “open” 屬性來開啟檔案或檔案總管。

Categories: 新聞

Meta 推出「大型概念模型」(LCM)

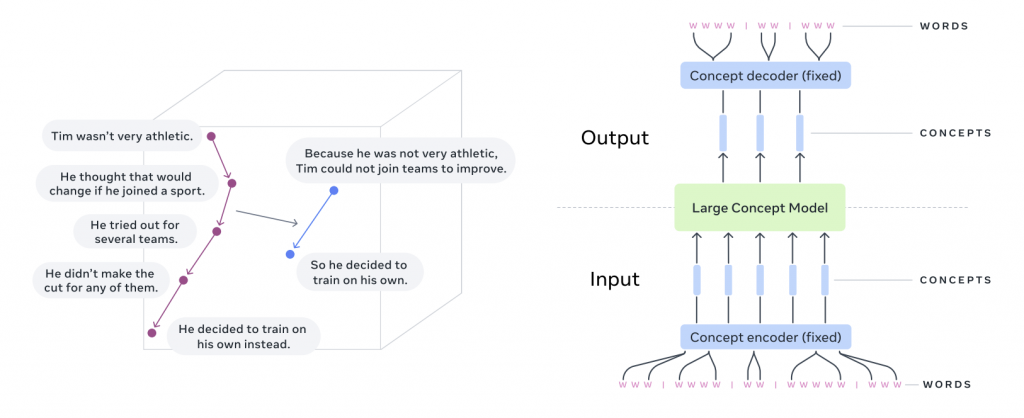
突破傳統以單詞為單位的 LLM,LCM(Large Concept Model) 直接處理句子級別的語義表示,即「概念」。研究人員利用 SONAR 嵌入空間,訓練 LCM 進行句子預測,並探索了多種模型架構和訓練方法,最終在 1.6B 和 7B 參數規模的模型上取得了優異的多語言零樣本泛化能力,尤其在摘要和摘要擴展任務上表現突出。 該研究成果及程式碼皆已公開釋出。 Jepa (Joint Embedding Predictive Architecture) 是一種在嵌入空間中預測下一個觀察表示的方法,V-JEPA (Video-JEPA) 是 Jepa 的一種伸延,加入影像作為一種自我監督的方式來學習影片的表示。 實戰: Colab 測試

突破傳統以單詞為單位的 LLM,LCM(Large Concept Model) 直接處理句子級別的語義表示,即「概念」。研究人員利用 SONAR 嵌入空間,訓練 LCM 進行句子預測,並探索了多種模型架構和訓練方法,最終在 1.6B 和 7B 參數規模的模型上取得了優異的多語言零樣本泛化能力,尤其在摘要和摘要擴展任務上表現突出。 該研究成果及程式碼皆已公開釋出。

Jepa (Joint Embedding Predictive Architecture) 是一種在嵌入空間中預測下一個觀察表示的方法,V-JEPA (Video-JEPA) 是 Jepa 的一種伸延,加入影像作為一種自我監督的方式來學習影片的表示。

Experts are STUNNED! Meta's NEW LLM Architecture is a GAME-CHANGER!

實戰:

Experimenting With LCM Models (Meta's Alternative To LLM Models)

Colab 測試

Categories: 新聞


Performer、Longformer 和 Reformer ?

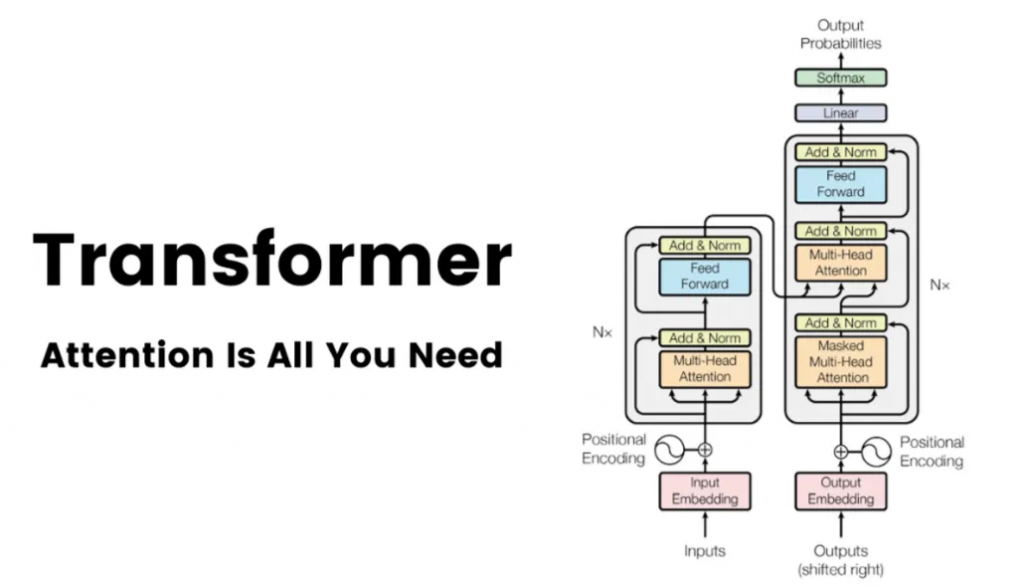
2017 年夏天,一群 Google Brain 研究人員悄悄發表了一篇將永遠改變人工智慧發展軌跡的論文。這份 “注意力就是你所需要的一切” (Attention Is All You Need) 的學術論文。當時人工智慧研究界之外很少有人知道這一點,但這篇論文將為你今天聽說過的幾乎所有主要生成式人工智慧模型奠定基礎,從 OpenAI 的 GPT 到 Meta 的 LLaMA 變體、BERT、 Claude、Bard 等。 新的架構於 2020 年已經出現,例如 Performer、Longformer 和 Reformer,旨在提高超長序列的注意力效率。目前其他人正在嘗試混合方法,將 Transformer 區塊與其他專用層結合。這個領域絕非停滯不前。展望未來,每一項新提案都將受到審查、興奮,甚至恐懼。 一文搞懂 Transformer(總體架構 & 三種注意力層)

2017 年夏天,一群 Google Brain 研究人員悄悄發表了一篇將永遠改變人工智慧發展軌跡的論文。這份 “注意力就是你所需要的一切” (Attention Is All You Need) 的學術論文。當時人工智慧研究界之外很少有人知道這一點,但這篇論文將為你今天聽說過的幾乎所有主要生成式人工智慧模型奠定基礎,從 OpenAI 的 GPT 到 Meta 的 LLaMA 變體、BERT、 Claude、Bard 等。

新的架構於 2020 年已經出現,例如 Performer、Longformer 和 Reformer,旨在提高超長序列的注意力效率。目前其他人正在嘗試混合方法,將 Transformer 區塊與其他專用層結合。這個領域絕非停滯不前。展望未來,每一項新提案都將受到審查、興奮,甚至恐懼。

一文搞懂 Transformer(總體架構 & 三種注意力層)

Categories: 新聞

Page 4 of 17
1 2 3 4 5 6 … 17