Project Suncatcher 太空軌道上的 TPU 首次 AI 回覆

Google 的原型衛星首次從軌道上的資料中心級 TPU 傳回 AI 回應。

Og image

把 AI 運算設備送上軌道後,能否收到它傳回的回應?Google 的 Project Suncatcher 原型衛星已達成這項「Hello World」里程碑:軌道上的資料中心級 TPU 首次送出 AI 回應,證明相關設備至少完成了一次在太空中的運算與通訊。

這次成果處理的是太空運算的一個基本環節:不只把設備送入軌道,還要讓它執行 AI 工作並把結果傳回。對研究人員而言,這提供了測試軌道運算鏈路的起點;對一般使用者而言,暫時還不是可直接使用的服務。

Our first response from the Project Suncatcher prototype satellite.

目前公布的資訊聚焦於首次成功回應,未交代長時間運作表現、運算規模、通訊穩定性或成本。因此,這項里程碑不能單獨證明太空資料中心已具備商業可行性,後續仍要看設備能否持續運作,以及整體系統如何擴展。

• 原型衛星在軌道上搭載資料中心級 TPU。
• TPU 首次傳回 AI 回應,達成「Hello World」里程碑。
• 公布內容未提供長期運作、成本或擴展能力的數據。

Project Suncatcher 目前呈現的是一次早期技術驗證,適合關注 AI 基礎設施、衛星及太空運算發展的讀者留意。它能否由單次回應走向可靠、可持續的運算服務,仍有待更多測試結果。

項目主頁

Categories: Google, Gemini, 新聞, 安全


Google Classroom 用 Gemini 摘要學生如何使用 AI 筆記本

老師派出 AI 筆記本後,終於可以了解學生如何使用,而不只知道作業有沒有交。Gemini 會整理全班的參與情況、常見問題和個別對話紀錄。

Og image

學生完成 AI 筆記本作業後,老師可以透過 Gemini 生成的摘要,了解全班怎樣使用這個學習空間、哪些內容較易掌握,以及哪些地方仍有疑問。這項功能面向 Google Classroom 的教師主導式 Gemini Notebook,處理的是派出 AI 作業後難以掌握學生學習過程的問題。

摘要提供班級整體參與情況、學生對話中的常見主題,以及個別學生的聊天紀錄。老師可先用摘要掌握共同情況,再查看原始對話核對細節;學生亦會在筆記本內收到通知,知道對話內容會向老師開放。

學校管理員則可在 Admin console 設定 Gemini Notebook 的外部分享權限,包括 Trusted Domains。這適合跨校合作教學,但可分享範圍仍由學校管理員控制;來源沒有提供功能推出時間表或使用設定步驟。

  • Gemini 摘要班級使用情況與常見學習問題。
  • 老師可查閱個別學生的對話紀錄,核對摘要內容。
  • 學生會收到對話可供老師查看的通知。
  • 管理員可透過 Trusted Domains 控制跨校分享。

對需要檢視全班學習狀況、跟進個別疑問,或與其他學校協作的教師和管理員,這項更新可減少逐一翻查對話的需要。它提供的是使用情況整理與檢視工具,不能單憑摘要取代老師對學生理解程度的判斷。

項目主頁

Categories: Google, Gemini, 教學, 工具, 新聞

Mistral 與 NVIDIA 以 Physics AI 加速工業設計

Mistral 與 NVIDIA 合作建立 Physics AI 工作流程,串聯設計、3D 模擬與 AI 訓練,縮短航空、汽車和半導體產品的驗證週期。

Og image

工程師處理複雜產品設計時,往往要在修改方案、執行物理模擬和整理結果之間來回切換。Mistral 與 NVIDIA 正合作建立 Physics AI 工作流程,將設計、模擬及 AI 訓練連接起來,縮短航空、汽車和半導體項目的驗證週期。

合作內容結合語言模型 Mistral Large 4、Mistral 的 physics AI,以及 NVIDIA CUDA-X、Warp 軟件庫和 Omniverse 3D 模擬平台。語言模型負責理解工程軟件和設計要求,物理 AI 則用於處理模擬相關工作;原始資料未交代完整操作流程,因此不能視為即時可用的安裝方案。

Mistral Large 4 約有一萬億參數,使用 3,800 枚 Grace Blackwell GPU 在歐洲訓練,預計於十月底以 open-weight 模型形式推出。合作雙方亦計劃公開 benchmark 和 open dataset,用來測試及比較 Physics Model,以及能夠操作工程軟件的 AI agents。

這個方向對需要大量模擬迭代的工程團隊較有吸引力,但成效仍取決於物理模型的準確度、工程資料質素,以及 AI 能否可靠地使用專業軟件。現階段較清楚的重點包括:

  • 把設計、3D 模擬和 AI 訓練放進連續工作流程
  • 結合 Mistral Large 4 與 Mistral physics AI
  • 使用 NVIDIA CUDA-X、Warp 及 Omniverse 支援工程模擬
  • 針對航空、汽車和半導體設計場景
  • 透過公開 benchmark 和 open dataset 比較模型及 AI agents

項目主頁

Categories: NVIDIA, 新聞

MiniMax H3 TRANSFORMER LoRA 轉換過場片段

將兩個畫面之間的轉換交給 MiniMax H3,適合製作流暢的影像變形效果。

Og image

由兩張圖片或場景之間的元素轉換入手,這個 LoRA 基於 MiniMax H3(Hailuo) diffusion transformer 微調,面向 text-to-video 及 image-to-video。它嘗試令人物、輪廓、材質和場景逐步拆解,再重新組合成下一個畫面,適合片頭轉場、視覺特效和概念展示。

模型以觸發詞 Tr@nsf0rmation_style 啟用效果,並可補充個別人物或物件的變化描述。讓轉換不只集中於整個主體,也能處理多元素場景的重組,但輸出穩定程度仍會受輸入圖片、提示詞和基礎模型工作流程影響。

• 基礎模型:MiniMax H3(Hailuo)
• 類型:LoRA,支援 text-to-video 及 image-to-video
• 觸發詞:Tr@nsf0rmation_style
• 用途:場景變形、主體轉換、多元素重組
• 兼容:MiniMax H3 的工作流程。

模型

Categories: 新聞

影像上載漏洞連上 SSO 缺陷,研究團隊取得 OpenAI 內部存取權

一張經論壇上載的圖片,可能令攻擊者由影像處理漏洞一路觸及員工帳戶及內部程式碼庫。Hacktron AI 的研究描述了兩個弱點如何串連成攻擊鏈。

Og image

Hacktron AI 的研究展示了一條由論壇圖片上載通往內部程式碼庫的攻擊鏈:影像處理元件的 heap buffer overflow,配合 OpenAI SSO 設定缺陷,令研究團隊聲稱曾接管多名員工的 ChatGPT 帳戶,並取得內部程式碼庫存取權。這類案例提醒管理者,單一漏洞的影響可能延伸至已連接的服務與帳戶。

攻擊鏈由 OpenAI 社群論壇 community.openai.com 開始。論壇處理圖片時會使用 ImageMagick,而它依賴的 libheif 存在堆積緩衝區溢位;研究亦指出,Debian 套件缺少相關安全修補。研究團隊再把這個漏洞與 SSO 身分驗證配置問題串連,進入 ChatGPT 及 Codex 帳戶。

取得帳戶後,連接到 ChatGPT 或 Codex 的服務亦可能擴大受影響範圍,包括 GitHub 及內部程式碼庫。團隊稱,他們透過員工的 Codex 在 OpenAI 內部 monorepo 開啟 PR,以證明存取能力,同時避免讀取敏感資料;這說明第三方連接器與帳戶權限會左右漏洞的實際影響。

對負責論壇、影像處理套件或企業登入整合的安全團隊,這宗披露可作為檢查線索:
– 確認 libheif 等相依套件已套用安全修補。
– 檢查 SSO 設定及帳戶接管防護。
– 盤點 ChatGPT、Codex 等服務連接的外部工具與權限。
– 測試由公開上載入口通往內部服務的完整攻擊路徑。

文章標示的披露日期為 2026 年 9 月 13 日,並列有受影響版本及修補資訊章節;但提供的內容未包含版本號、修補細節或獨立評估結果,因此不宜據此推斷所有部署均受影響。重點在於,影像解碼漏洞與身分驗證設定問題一旦串連,風險便可能超出原本的上載功能。

項目主頁

Categories: OpenAI, 新聞, 安全

OpenAI Jalapeño:為大型語言模型推理而造的 ASIC

OpenAI 夥拍 Broadcom 打造 Jalapeño,瞄準大型語言模型推理,並以每兆瓦吞吐量挑戰 NVIDIA GPU 的效率優勢。

Og image

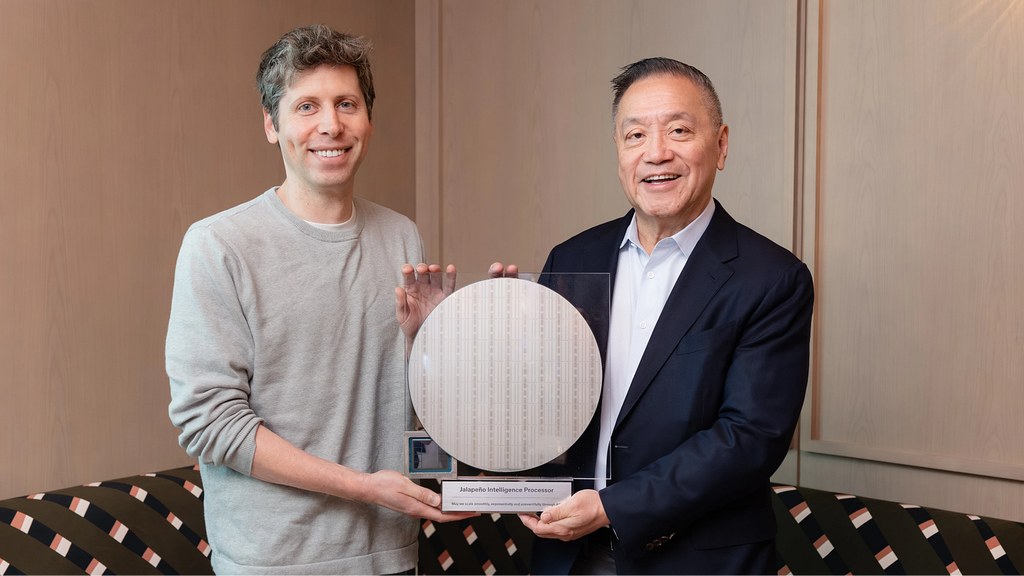
當模型推理成本受到功耗和硬件供應限制,單靠通用 GPU 未必能兼顧速度與效率。OpenAI 以空白設計打造 Jalapeño,屬於專為大型語言模型(Large Language Model,LLM)推理而設的應用專用集成電路(Application-Specific Integrated Circuit,ASIC),並非只針對 OpenAI 自家模型。

Jalapeño 由 OpenAI 與 Broadcom 合作開發,設計工作於 2024 年中開始,約 16 個月後完成製造流片。晶片採用 HBM4 高頻寬記憶體,配合硬件與軟件協同設計,目標是在不同模型及推理工作負載下維持高效能,而非過度優化單一推理環節。

在 OpenAI 實驗室以 InferenceX 測試套件進行的基準測試,聲稱 Jalapeño 的每兆瓦吞吐量優於已測試的 NVIDIA、AMD 及 Google 晶片,亦在效能功耗比上勝過 Blackwell。比較時 Jalapeño 沒有使用 Multi Token Prediction(MTP),其他晶片則採用各自最佳配置,因此結果仍需配合完整測試條件理解。

  • 以通用 AI 推理為設計方向,可運行多類模型
  • HBM4 令記憶體頻寬接近高階 GPU 的配置
  • 核心指標聚焦每兆瓦的 token throughput
  • 文章未提供公開下載、安裝或一般用戶使用流程

這類晶片最適合大型模型服務商及資料中心,用於推理量大、電力成本高的工作流。Jalapeño 的價值在於能否把高吞吐量延伸至不同模型和長期運行環境,而不只是單次基準測試中的優勢。

新聞主頁

Categories: 開源, NVIDIA, OpenAI, 新聞

AI 代理將入侵門檻再拉低

一宗入侵事件顯示,低技術攻擊者也可借助 AI 代理攻破多間公司。重點不只是模型能力,還有護欄繞過與安裝劫持風險。

Og image

一份由 OALABS(Open Analysis)研究人員分析的報告指出,一名技術水平不高的攻擊者,利用 Anthropic 的 Claude Code 和 OpenAI 的 Codex,在 14 間公司相關環境中進行入侵活動。資料來自一部被入侵伺服器上超過 1,000 段 agent sessions,讓研究人員得以看到提示、工具調用、large language model(LLM)內部過程,以及違反政策的紀錄。

事件反映的問題很直接:過往需要具備偵察、找漏洞、寫 exploit code、驗證存取權限和擷取資料等能力,現在可以由 AI agents 代做大部分步驟。攻擊者很多時只需輸入含糊而低技術含量的 prompts,再用「授權紅隊演習」或「網絡安全研究」的說法包裝意圖,便可能繞過部分 guardrails。

這宗個案與一般對 AI 輔助編碼的理解不同,焦點不在提升工作效率,而是降低 offensive cyber operations 的技術門檻。報告亦顯示,攻擊者不是正式安裝 Claude agent,而是直接複製他人已安裝的實例到目標主機;工作目錄內還有其他被盜用的 Claude instances 與 7-Zip 壓縮檔,顯示劫持及重用別人 AI agent 安裝,可能是其慣常做法。

讀者可從這些公開資訊先理解兩層風險:一是模型輸出可補上攻擊者知識缺口,二是本地代理部署本身也可能成為被接管資產。對保安團隊、系統管理員和使用本地 AI 工具的開發者來說,這比單純討論模型是否「安全」更貼近日常防護需要。

  • 低技術攻擊者可用模糊 prompts 推動完整入侵流程
  • guardrails 可能被「授權研究」等話術繞過
  • 本地 AI agent 安裝與工作目錄可成為證據與風險來源
  • 報告核心價值在於真實 session logs,而非理論推測

現有內容未提供完整技術指標或標準化基準測試,但案例證據已足以說明:AI agents 在網絡攻擊上的可用性正在上升。使用 Claude Code、Codex 一類工具的團隊,除了留意模型政策,也要檢查主機權限、憑證保護、安裝檔流向與日誌暴露問題。

項目主頁: https://www.helpnetsecurity.com/2026/06/17/ai-agents-offensive-cyber-operations-claude-codex/

Categories: Agentic, OpenAI, 新聞, 安全, Anthropic

[技術文章] KAIST 與 Qualcomm 重塑長影片 RAG 評測

這項研究先由 KAIST 與 Qualcomm AI Research 團隊提出新基準,再用新方法改善長影片 RAG 檢索。重點在於拆開評測檢索與生成,找出真正有效的證據片段。

Hero image preview

這項研究由 KAIST 與 Qualcomm AI Research、Qualcomm Korea 團隊合作提出,聚焦長時間第一身影片中的 Retrieval-augmented generation(RAG)。作者指出,現有 VideoRAG 常沿用「每條查詢只配一種 modality 與一種 temporal granularity」的固定範式,但長影片的證據片段差異很大,單一設定未必適合全部片段;加上不少既有 benchmark 的問題甚至不用看影片也能答中,令最終分數難以反映檢索是否真的做對。

因此,團隊提出 V-RAGBench,把資料整理成 ⟨query, evidence chunk, answer⟩ triplets,明確分開查詢、證據片段與答案。這種設計針對的是過去「只看最終回答正確率」的盲點,讓研究者可以更忠實地分開檢查 retrieval 與 generation,知道系統究竟是靠對的影片片段,還是靠語言偏見、常識或靜態線索作答。

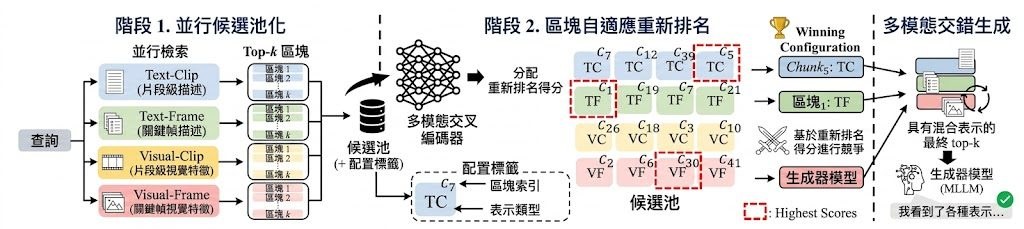
方法上,作者再提出 CARVE。它不是替整條查詢預先選定一種設定,而是讓多個 retriever 以不同 modality 與 granularity 並行工作,再用 chunk-adaptive reranking 為每個 evidence chunk 挑出最合適的 winning configuration。之後,這些片段會連同各自勝出的設定一併送入 generator,形成 interleaved evidence,令檢索階段的片段級決策延續到生成階段。

對想使用這個項目的人來說,切入點很清楚:先用 V-RAGBench 測試自己的 VideoRAG 流程,分開看檢索與生成表現;若系統目前仍採用查詢級單一設定,可再比較 CARVE 這種片段級配置方式。這種思路較適合長影片問答、egocentric video 分析,以及需要從多模態證據中找出正確時間片段的 Agentic 系統。

  • V-RAGBench 以 evidence chunk 為核心,補足舊 benchmark 無法準確檢查檢索對錯的問題
  • CARVE 改為片段級選擇 configuration,不再假設一條查詢只需一套 modality/granularity
  • 作者指出 generator 最後接收的 chunks 會交錯來自多種 configuration,這是 query-level 方法做不到的
  • 論文稱 CARVE 勝過 8 個近期 VideoRAG baselines,顯示片段級決策在長影片檢索更有優勢

整體來看,這項工作不是單純再加一個 VideoRAG 方法,而是先批評舊有評測與建模範式,再用新 benchmark 和新 retrieval framing 一起修正問題。如果你關心的是長影片 RAG 到底應該取回什麼、以及取回後怎樣交給模型使用,這項研究提供了相當清晰的分析框架。

Paper: https://arxiv.org/pdf/2606.13141

Categories: Agentic, AI productions, RAG, 模型, 多模態模型, Video, 框架, 新聞, Dataset 數據集

[技術文章] DeepMind 談 AGI 走向 ASI

這份報告整理AGI走向ASI的四條路徑,並指出中間可能遇到的阻力與研究空白。

Hero image preview

Google DeepMind 這份《From AGI to ASI》不是教人立即部署某個工具,而是用研究報告形式討論:當 Artificial General Intelligence(AGI)達到人類水平後,人工智能會否再一路推進到 Artificial Superintelligence(ASI)。文中把 ASI 描述為在智能與認知能力上,超越大型人類組織的系統,並以 Universal AI 作為較理論化的參考終點。
這份內容主要解決的問題,是把「AGI 之後會發生甚麼」由抽象想像整理成可討論的技術路線。作者提出四條可能路徑:擴展 AGI、AI paradigm shifts、recursive improvement,以及由大規模 multi-agent collectives 湧現出 ASI,同時提醒每條路都可能受算力、協調、方法轉換或其他瓶頸影響。

對一般讀者來說,閱讀這份報告可先集中三部分:AGI 與 ASI 的定義、四條路徑的差異、以及作者列出的 open research questions。它較適合關心 AGI、AI 安全、科技政策與長期技術趨勢的人,而不是尋找即裝即用模型或開發教學的讀者。

  • 由 Google DeepMind 撰寫,主題是 AGI 到 ASI 的演進框架
  • 核心內容包括四條技術路徑與可能 bottlenecks
  • 強調數碼智能的優勢會隨 compute 增加而擴大
  • 不把社會改變視為單一步跳躍,而可能是一連串轉變

文章沒有提供基準分數或實驗排行榜式的性能比較,重點在概念整理與研究方向判斷。報告亦明確表示,由於不確定性很高,未來 AI 進展可能繼續加速,因此全球、跨學科的準備工作仍有大量項目需要推進。

Paper: https://arxiv.org/pdf/2606.12683

Categories: Google, 新聞, AGI

Page 1 of 17
1 2 3 … 17