影片討論了中國AI技術在多模態模型和圖像生成方面的重大突破,以及中國在全球AI競賽中逐漸展現出的技術和能源優勢,對未來產業格局產生深遠影響。
中國在電力產能上的快速增長(目前佔全球30%以上,並以每18個月增加一個美國總產能的速度擴張),將成為未來AI競賽的關鍵優勢,因為AI訓練和應用極度依賴能源供應。
TikTok's New AI Just Beat Google and OpenAI in 38 Tests!

影片討論了中國AI技術在多模態模型和圖像生成方面的重大突破,以及中國在全球AI競賽中逐漸展現出的技術和能源優勢,對未來產業格局產生深遠影響。 中國在電力產能上的快速增長(目前佔全球30%以上,並以每18個月增加一個美國總產能的速度擴張),將成為未來AI競賽的關鍵優勢,因為AI訓練和應用極度依賴能源供應。
影片討論了中國AI技術在多模態模型和圖像生成方面的重大突破,以及中國在全球AI競賽中逐漸展現出的技術和能源優勢,對未來產業格局產生深遠影響。
中國在電力產能上的快速增長(目前佔全球30%以上,並以每18個月增加一個美國總產能的速度擴張),將成為未來AI競賽的關鍵優勢,因為AI訓練和應用極度依賴能源供應。
人工智慧與機器學習教授 Graham Morehead 回答網友對AI相關的熱搜問題!AI、AGI 和 ASI 之間有什麼區別?如果中國或美國率先實現超級人工智慧,將會產生什麼影響?AI會搶走人類的所有工作嗎?以上這些問題的解答都在本集影片中!
人工智慧與機器學習教授 Graham Morehead 回答網友對AI相關的熱搜問題!AI、AGI 和 ASI 之間有什麼區別?如果中國或美國率先實現超級人工智慧,將會產生什麼影響?AI會搶走人類的所有工作嗎?以上這些問題的解答都在本集影片中!

ComfyUI-Manager 在 3 月 28 日遷移至 ComfyUI 開發團隊所在的 GitHub Repository。因此我相信 ComfyUI 能夠持續提升使用者體驗。提供一鍵安裝、節點管理。如果您經常探索最新的 AI 繪圖技術,抑或需要特定的圖像處理節點,ComfyUI Manager 都能夠令相關操作流程更為簡易及高效。
ComfyUI-Manager 在 3 月 28 日遷移至 ComfyUI 開發團隊所在的 GitHub Repository。因此我相信 ComfyUI 能夠持續提升使用者體驗。提供一鍵安裝、節點管理。如果您經常探索最新的 AI 繪圖技術,抑或需要特定的圖像處理節點,ComfyUI Manager 都能夠令相關操作流程更為簡易及高效。
OpenAI 正式宣佈將會在它們的產品 ChatGPT 與及桌面應用程式中添加 Anthropic 的上下文協議 (MCP) 的支援。 OpenAI CEO Sam Altman 表示 “我們很開心能夠在我們的產品中增加對 MCP 的支持”。
OpenAI 正式宣佈將會在它們的產品 ChatGPT 與及桌面應用程式中添加 Anthropic 的上下文協議 (MCP) 的支援。 OpenAI CEO Sam Altman 表示 “我們很開心能夠在我們的產品中增加對 MCP 的支持”。
Embedding 文字嵌入,意思是將文字轉換為有意義的向量數值。其主要目的是為了讓 A.I. 開發者能夠利用這些向量,實現更精準的語義搜尋,即使查詢與文本內容的詞彙不完全相同也能找到相關資訊。 Google 宣布推出一個新的實驗性 Gemini 文字嵌入模型,稱為 gemini-embedding-exp-03-07。這個模型繼承了語言和細微語境的理解,適合廣泛的應用。這個新模型超越了 Google 之前的最先進模型,並在多語言文本嵌入基準測試(MTEB)中名列前茅,同時還提供了更長的輸入長度等新功能。目前已經可以透過 Gemini API 開始使用。
Embedding 文字嵌入,意思是將文字轉換為有意義的向量數值。其主要目的是為了讓 A.I. 開發者能夠利用這些向量,實現更精準的語義搜尋,即使查詢與文本內容的詞彙不完全相同也能找到相關資訊。
Google 宣布推出一個新的實驗性 Gemini 文字嵌入模型,稱為 gemini-embedding-exp-03-07。這個模型繼承了語言和細微語境的理解,適合廣泛的應用。這個新模型超越了 Google 之前的最先進模型,並在多語言文本嵌入基準測試(MTEB)中名列前茅,同時還提供了更長的輸入長度等新功能。目前已經可以透過 Gemini API 開始使用。
DeepSeek 開放源碼週(Open Source Week)是由中國人工智能初創公司 DeepSeek 在 2025 年 2 月 24 日至 2 月 28 日舉辦的一項活動,旨在展示它的建構開放、同埋協作性 AI 生態系統的承諾。在此期間,DeepSeek 每天發布一個開源代碼庫,總共有五個,這些代碼庫已在實際環境中得到驗證並已經開始應用於線上服務。
DeepSeek 開放源碼週(Open Source Week)是由中國人工智能初創公司 DeepSeek 在 2025 年 2 月 24 日至 2 月 28 日舉辦的一項活動,旨在展示它的建構開放、同埋協作性 AI 生態系統的承諾。在此期間,DeepSeek 每天發布一個開源代碼庫,總共有五個,這些代碼庫已在實際環境中得到驗證並已經開始應用於線上服務。
谷歌的 Titans 架構靈感來自人類記憶方式,包括短期、長期和持久記憶。Titans 的長期記憶能夠主動搵出相關資訊及時更新,而持久記憶就可以儲存推理技能,因此能夠擴展前文後理,並且能夠保持高準確性。
谷歌的 Titans 架構靈感來自人類記憶方式,包括短期、長期和持久記憶。Titans 的長期記憶能夠主動搵出相關資訊及時更新,而持久記憶就可以儲存推理技能,因此能夠擴展前文後理,並且能夠保持高準確性。

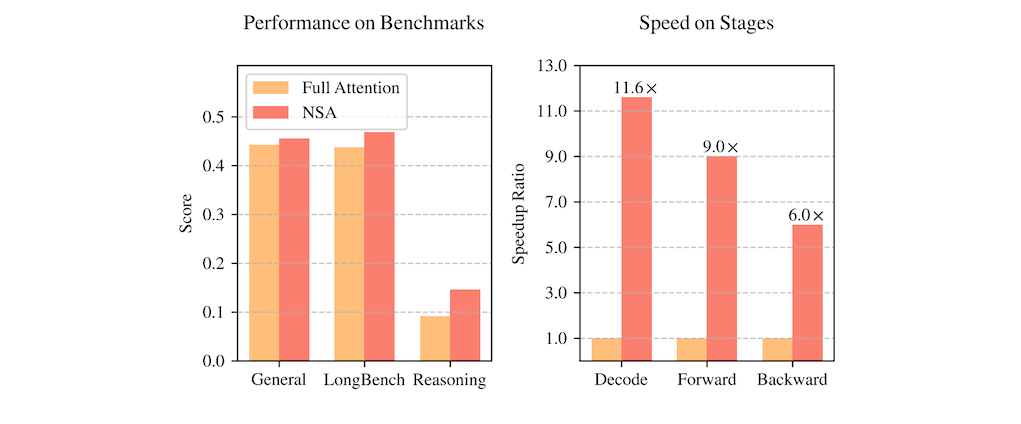
2025 年 2 月 16 日,DeepSeek 提出了一種名為「原生稀疏注意力」(NSA)Natively trainable Sparse Attention 的新型注意力機制,目的是解決長傳統注意力機制運算量過大的問題。NSA 透過結合分層式 Token 壓縮與硬體加速設計,達成既能有效處理長文本,又不會顯著增加運算負擔的目標。其核心創新點在於演算法與硬體協同優化,保持甚至超越完整注意力模型的性能。實驗證明,NSA 在多項基準測試中表現出色,並且在解碼、前向傳播和反向傳播階段都顯著加速。
2025 年 2 月 16 日,DeepSeek 提出了一種名為「原生稀疏注意力」(NSA)
Natively trainable Sparse Attention 的新型注意力機制,目的是解決長傳統注意力機制運算量過大的問題。NSA 透過結合分層式 Token 壓縮與硬體加速設計,達成既能有效處理長文本,又不會顯著增加運算負擔的目標。其核心創新點在於演算法與硬體協同優化,保持甚至超越完整注意力模型的性能。實驗證明,NSA 在多項基準測試中表現出色,並且在解碼、前向傳播和反向傳播階段都顯著加速。

這是近期較完整的影片,總結了近期在人工智慧影片技術上的突破,這些技術正快速改變著影片製作的流程。影片亦展望了未來 AI 和 3D 影片的融合創作,能夠在一個統一的場景圖中,以更高的抽象層次協調和導演式的指揮創作,實現更輕量化、更高效的影片製作流程。
這是近期較完整的影片,總結了近期在人工智慧影片技術上的突破,這些技術正快速改變著影片製作的流程。影片亦展望了未來 AI 和 3D 影片的融合創作,能夠在一個統一的場景圖中,以更高的抽象層次協調和導演式的指揮創作,實現更輕量化、更高效的影片製作流程。

這篇論文介紹了 DeepSeek 團隊開發的兩個大型語言模型:DeepSeek-R1-Zero 和 DeepSeek-R1,它們的核心目標是提升 LLM 的推理能力。DeepSeek-R1-Zero 利用大規模強化學習 (RL) 從頭訓練,展現出令人驚豔的推理能力,儘管存在可讀性和語言混雜等問題。DeepSeek-R1 則在 DeepSeek-R1-Zero的基礎上,加入多階段訓練和冷啟動數據,進一步提升效能,其推理能力已能與 OpenAI 的 o1-1217 模型相媲美。論文也展示了將DeepSeek-R1 的推理能力蒸餾到較小模型的成果,並公開釋出多個不同規模的模型,供研究社群使用。 論文詳細闡述了訓練方法、評估結果以及一些失敗的嘗試,為LLM推理能力的提升提供了寶貴的經驗和見解。 總結模型能力對比DeepSeek-R1 在函數調用、多回合任務、複雜角色扮演以及 JSON 輸出等方面的能力優於 DeepSeek-V3。 未來研究方向解決語言混合問題,目標是在未來解決這一限制。提升提示工程的穩健性,建議用戶直接描述問題並使用零樣本設置指定輸出格式以獲得最佳效果。探索利用 CoT(Chain-of-Thought)來增強這些領域的任務能力。 推理過程的挑戰儘管 MCTS 與預訓練價值模型結合使用可以提高推理效率,但通過自我搜索迭代提升模型效能仍然是重大挑戰。 冷啓動強化學習在冷啓動階段,利用檢查點收集數據並結合監督微調(SFT)來自其他領域的數據,增強模型在寫作、角色扮演和其他通用任務中的能力。針對 CoT 在語言混合方面的問題,引入了語言一致性獎勵,以提高模型的性能。
這篇論文介紹了 DeepSeek 團隊開發的兩個大型語言模型:DeepSeek-R1-Zero 和 DeepSeek-R1,它們的核心目標是提升 LLM 的推理能力。DeepSeek-R1-Zero 利用大規模強化學習 (RL) 從頭訓練,展現出令人驚豔的推理能力,儘管存在可讀性和語言混雜等問題。DeepSeek-R1 則在 DeepSeek-R1-Zero的基礎上,加入多階段訓練和冷啟動數據,進一步提升效能,其推理能力已能與 OpenAI 的 o1-1217 模型相媲美。論文也展示了將DeepSeek-R1 的推理能力蒸餾到較小模型的成果,並公開釋出多個不同規模的模型,供研究社群使用。 論文詳細闡述了訓練方法、評估結果以及一些失敗的嘗試,為LLM推理能力的提升提供了寶貴的經驗和見解。
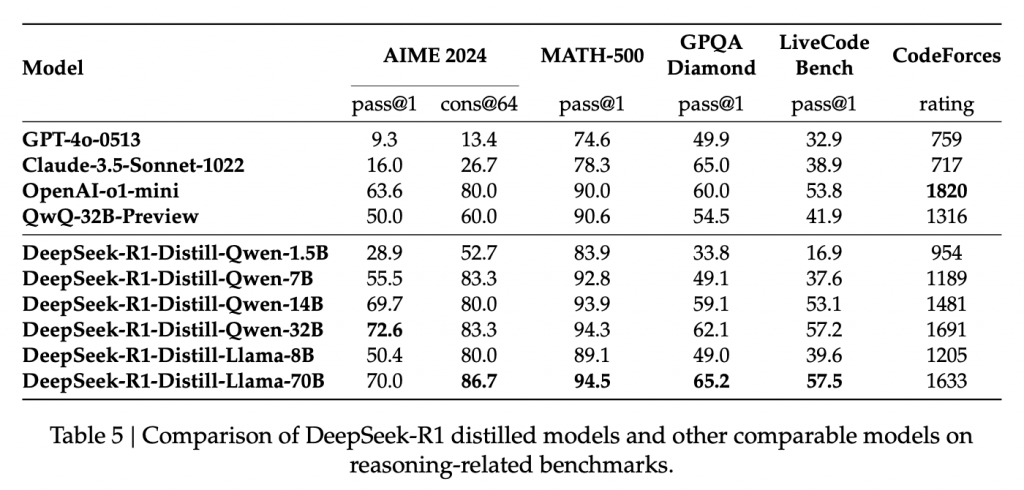
總結模型能力對比
DeepSeek-R1 在函數調用、多回合任務、複雜角色扮演以及 JSON 輸出等方面的能力優於 DeepSeek-V3。
未來研究方向
解決語言混合問題,目標是在未來解決這一限制。
提升提示工程的穩健性,建議用戶直接描述問題並使用零樣本設置指定輸出格式以獲得最佳效果。
探索利用 CoT(Chain-of-Thought)來增強這些領域的任務能力。
推理過程的挑戰
儘管 MCTS 與預訓練價值模型結合使用可以提高推理效率,但通過自我搜索迭代提升模型效能仍然是重大挑戰。
冷啓動強化學習
在冷啓動階段,利用檢查點收集數據並結合監督微調(SFT)來自其他領域的數據,增強模型在寫作、角色扮演和其他通用任務中的能力。
針對 CoT 在語言混合方面的問題,引入了語言一致性獎勵,以提高模型的性能。