Comfyui-MMH3-UltimateUpscale:長片放大不再受顯存牽制

ComfyUI 新增單節點升頻方案,讓 MiniMax H3 長片在有限 VRAM 顯示卡上處理,同時保留原有音訊。

Repository image for bbaudio-2025/Comfyui-MMH3-UltimateUpscale

長片、高解像度加上有限 VRAM(Video Random Access Memory)通常意味著要大幅降低輸出要求,但 Comfyui-MMH3-UltimateUpscale 把 MiniMax H3 的 AV latent 放進單一 ComfyUI 節點處理,目標是完成升頻而不破壞音訊。它屬於 ComfyUI 自訂工具,實際解決的是標準升頻節點無法理解 H3 視訊與音訊巢狀 latent 結構的問題。

節點會先以 temporal chunking 把長片切成重疊時間區段,再按需要進行 latent upscale,之後以 spatial tiling 分割畫面,逐塊完成 diffusion sampling,最後分別進行 spatial stitching 和 temporal stitching。每次只處理一個 tile,峰值顯存取決於單塊大小,而不是整段影片的長度或完整輸出解像度,代價是切割、重疊與拼接會增加處理時間及流程複雜度。

升頻有兩條路線:MMH3 Latent Upscale with Model Params 會載入 minimax h3 latent upscaler 3d .safetensors checkpoint,以 H3 3D model-based upscaler 改善 latent;MMH3 Latent Upscale Params 則只用 nearest、bilinear、area 或 bicubic 插值,不需額外模型,較省資源但不會補回模型推斷的細節。兩者都保留 32-channel audio,音訊部分不會重新取樣。

  • 長片可用 temporal chunking 分段處理
  • 高解像度可用 spatial tiling 控制顯存峰值
  • 單一 MMH3 Ultimate Upscale 節點包辦整個流程
  • 3D 模型升頻與免模型插值可按硬件取捨
  • 輸入必須是已完成去噪的 MiniMax H3 AV latent

這個項目較適合已經用 MiniMax H3 產生影片、但顯示卡顯存不足以一次處理完整片段的 ComfyUI 使用者,也適合需要保留同步音訊的影片製作流程。測試時應由較短片段及較細 tile 開始,確認模型 checkpoint、H3 節點及拼接結果正常,再逐步增加時間分塊和輸出解像度;它降低的是顯存門檻,並不代表長片升頻可以即時完成。
GitHub

Categories: 開源, ComfyUI, Video, Audio, MiniMax

MiniMax H3 整合成單一節點,ComfyUI 剪走繁瑣接線

把 MiniMax H3 的影片流程收成一個節點,省去搭工作流和找模組的時間。它更像一個整合入口,讓生成、延伸、關鍵幀同音訊驅動集中處理。

Buy Me a Coffee at ko-fi.com

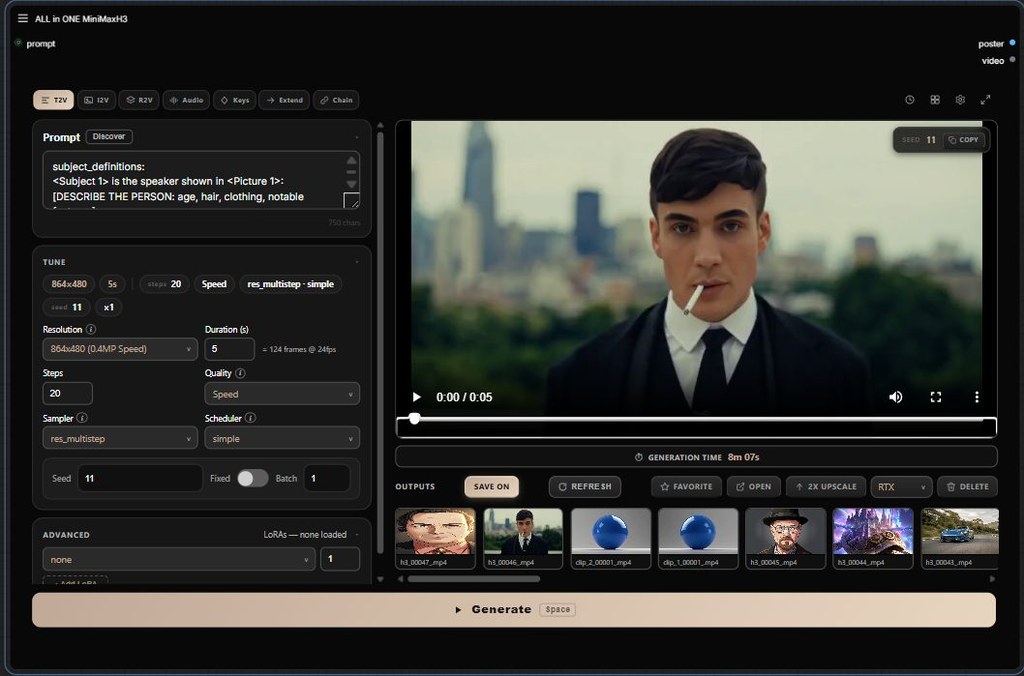
在 ComfyUI 裡要跑 MiniMax H3 影片流程,最麻煩往往不是模型本身,而是工作流太碎。ComfyUI-ALLinONE-MinimaxH3 把這套流程收成單一節點,屬於 ComfyUI 的工具項目,目標是把文字生成影片、圖片轉影片、參考圖驅動、音訊帶動嘴型同影片延伸放進同一個入口。

安裝方式很直接:放入 ComfyUI/custom_nodes/ 後重啟 ComfyUI,再在畫布搜尋 ALL in ONE MiniMaxH3。項目主打幾個模式,包括 Image、T2V、I2V、R2V、Audio Drive、Keyframes、Extend 同 Chain,實際用法是先揀模式,再輸入 prompt 或參考素材,由節點接管後續流程。

官方 MiniMax H3 原生工作流、ComfyUI-H3-Motion-Context-MultiRef、MiniMax H3 Turbo pack,同埋 H3 Studio 的圖片模式都被包進同一個介面,對需要反覆試片段、接續鏡頭、處理多參考素材的影片製作流程特別實用。

  • 支援 T2V、I2V、R2V、Audio Drive、Keyframes、Extend、Chain
  • Chain 用 H3 Motion Context 做多段續接,走 latent path,避免重新編碼
  • 內建歷史、收藏同預覽,方便回看 prompt 同結果
  • 亦有 RTX / Seed2VR Video Super Resolution 的 upscale 接口
  • 作者標明仍屬 Beta,兼容性要跟指定版本和模型清單對齊

目前較適合已經在 ComfyUI 裡做影片生成、又不想每次重砌圖的人。官方工作流仍然是底層來源,呢個項目更像把常用路徑包成一個操作面,方便快速試片、改參考圖同續接片段。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

MiniMax-H3-Text-Embeddings ?

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。

Og image

這不是傳統 NLP 或 RAG 領域中所指的「文本向量嵌入(Text Embedding)」模型。MiniMax-H3-Text-Embeddings 實際上是 DiffSynth-Studio 團隊為 MiniMax-H3 影片生成大模型所設計的「視覺特效/風格控制向量(Diffusion Templates / Textual Inversion)」。

MiniMax-H3 是一個高達 33B 參數的大型多模態生成模型,若要透過訓練 LoRA 來控制風格或特效,顯存與算力成本非常高。DiffSynth-Studio 團隊採用了類似 Textual Inversion(文字翻轉/概念嵌入) 的做法:

  1. 極輕量替代方案:將特定特效(如火爆、風暴、環繞鏡頭等)預先訓練或編碼成特徵 Tensor。
  2. 直接注入文字特徵層:這些檔案體積非常小,能在推理階段直接替換或疊加到 MiniMax-H3 的 Text Encoder 輸出上。
  3. 模組化與組合:使用者可以像掛載外掛一樣,組合多個特效 Embedding 來控制生成的影片視覺效果。

3. 總結建議

  • 如果你是在找 RAG / 知識庫 / 搜尋用的文本嵌入模型:請忽略此模型,這不是向量檢索工具。
  • 如果你是在使用 DiffSynth-Studio 進行 MiniMax-H3 影片生成:這是用來快速套用影片特效、節省顯存並替代重型 LoRA 的控制模組。

項目主頁

Categories: 開源, RAG, Embedding, 視頻模型, MiniMax

MiniMax-Music3 的音樂描述改寫技能

這個項目把短音樂描述整理成更穩定的提示文字,方便後續生成或編修。它也支援帶標籤歌詞,讓內容更貼近音樂創作流程。

Og image

MiniMax-Music3 的 music-caption-rewriter 屬於一個 Skills 項目,重點是把簡短的音樂描述,連同可選的標籤歌詞,改寫成更適合後續處理的文字。它處理的不是旋律本身,而是前期描述太短、太散,難以直接拿去做音樂生成或整理的問題。

這類寫法對內容創作者、音樂生成工作流,或要把零散想法轉成較一致提示文字的人特別有用。它的價值在於先把描述整理好,再交給後續模型或工具,減少輸入太模糊而導致結果飄移的情況。

文件目前可見的資訊主要集中在用途說明,沒有完整交代安裝步驟、執行流程或評估數據,所以較適合把它理解成一個針對文字前處理的技能模組,而不是一個獨立應用。從命名和描述來看,它和一般直接輸入短句就生成的做法不同,重心放在改寫與結構化,讓輸入更一致。

  • 處理短音樂描述的改寫
  • 可搭配 tagged lyrics 一起輸入
  • 目標是讓後續音樂生成更穩定
  • 文件未提供安裝與評測細節
  • 適合音樂生成前的文字整理工作流

項目主頁

Categories: 開源, Agentic, 音樂, MiniMax, Skill 技能

MiniMax-Music3 開放權重音樂模型

你可以把它理解成一個把歌詞、風格與編曲意圖直接變成完整歌曲的模型,重點不只係出聲,仲要保住前後段落的連貫感。它適合做 demo、原型同內容製作,代價是控制得愈細,提示詞就要寫得愈具體。

MiniMax

MiniMax Music 3 是一個音樂生成模型,重點在於把「可唱、可編、可聽完整首歌」串成一體,直接產出最長五分鐘的完整歌曲。對內容創作團隊來講,它最有價值嘅位唔係單句旋律,而係可以連住 intro、verse、chorus 到 outro,維持人聲、節奏同編曲走向一致。

輸入通常分兩層:歌詞負責唱咩,同時可以加上 [Intro]、[Verse]、[Chorus] 呢類段落標記;另一層音樂描述就交代風格、情緒推進、人聲質感、樂器配置同空間感。官方亦建議用 Structured Caption,將 Global Metadata、Vocal Details、Arrangement 分開寫,方便模型對長段落做更穩定嘅控制。

它用 8B Global LLM 處理長距離結構,再配 0.6B Local LLM 補足逐幀聲學細節,並結合 Flow Matching 同 Flow-VAE 做連續 hidden-state 合成。這種分工換來較完整的長歌一致性,但亦意味住提示詞要寫得有層次,否則編排同人聲變化未必會完全跟足預期。

  • 最適合做完整歌曲草稿、廣告歌、遊戲音樂同內容原型
  • 由歌詞加音樂描述共同控制,細節比一般單一句 prompt 更可預期
  • 支援 32 kHz、16-bit stereo WAV 輸出,方便接入後期流程
  • 強項係長段落連貫與結構完整,唔係只生成短片段
  • 目前較適合重視創作速度與可控性嘅團隊,而唔係追求即用即完美成品嘅場景

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 音樂, MiniMax

ComfyUI_MiniMaxH3_Director:一次過生成多段影片的導演台

想做長片、多段生成又唔想逐段接節點,這個項目把 MiniMax H3 的分鏡、取樣和輸出收在同一個 ComfyUI 工作流核心。

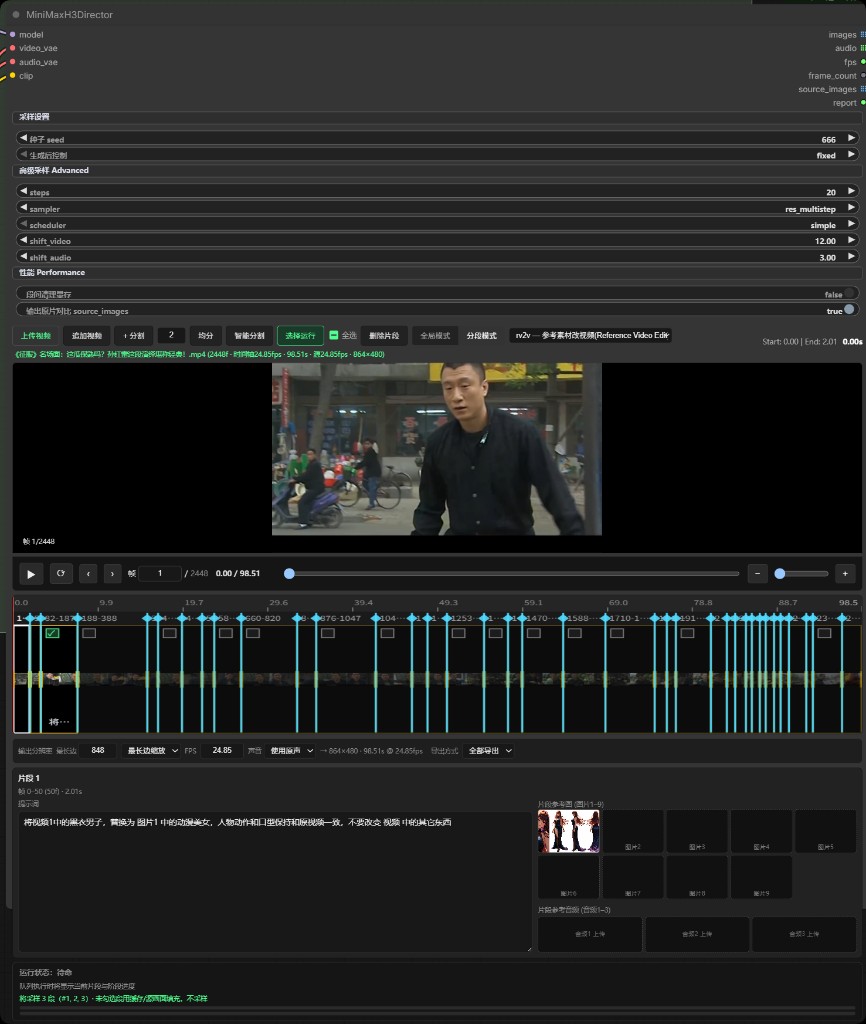
MiniMaxH3Director 工作流截图

做長影片時,最麻煩往往唔係單段生成,而係分鏡、續接、音畫輸出要分開處理。AIMixer/ComfyUI_MiniMaxH3_Director 針對的正是這個卡位:它屬於 ComfyUI 的影片生成節點插件,將 MiniMax H3 的多段規劃、條件編碼、採樣解碼和匯出合併成一個導演台,讓長視頻與多段音視頻生成流程集中管理。

它的價值不只在於把功能堆在一起,而是把幾種常見工作流放進同一個操作面。無論是 t2v、i2v、fl2v、r2v、v2v 還是 rv2v,都可沿用同一套時間軸邏輯;當中首尾幀、參考素材組、源片改寫和選擇性重跑都已經整理好,對需要反覆改段落、補鏡頭或保留原聲的創作者會實用得多。

安裝方式也算直接,前提是 ComfyUI 要升級到 v0.30.0 或以上,並已具備官方 MiniMax H3 支援。之後可用 ComfyUI Manager 透過 Git URL 安裝,或手動放進 custom_nodes,再按需要補上 scenedetect、opencv-python-headless、imageio-ffmpeg 這些依賴;模型權重與示例工作流則需另外下載。要留意的是,CLIP Loader 的 type 必須設為 minimax,而 fl2va / ref2va UNET 亦要按任務類型配對。

跟一般把多個節點逐個串起來的做法相比,這個項目明顯偏向把影片導演流程封裝成一個較完整的工作台,代價是你仍然要跟官方 MiniMax H3 節點規格保持一致,並理解不同模式背後用的是 MiniMaxH3ImageToVideo、MiniMaxH3ReferenceToVideo、MiniMaxH3SigmaShift、KSampler 與 AV 分離解碼鏈路。重點放在長片分段銜接、段間運動延續與原生立體聲輸出,較適合已經在 ComfyUI 內做影片生成、希望減少手動接線和重複操作的團隊。

  • 把多段時間軸、生成、解碼、匯出收進單一節點
  • 支援 t2v、i2v、fl2v、r2v、v2v、rv2v 多種模式
  • 可做選擇性重跑,未勾選片段可用快取或原片填補
  • 依賴官方 MiniMax H3 節點,環境版本與模型配對要設好
  • 原生輸出立體聲音頻,適合長片與多段音視頻工作流

GitHub

Categories: 開源, ComfyUI, MiniMax

MiniMax H3 人像寫實 LoRA,強化近鏡表情與電影感

基於 MiniMax H3 的人像寫實 LoRA,重點唔係加花巧風格,而係令面部、皮膚同鏡頭動態更自然可信。

Og image

近鏡人像、多人同框對話、手部動作呢類鏡頭,最容易暴露影片生成模型嘅細節破綻。呢個 Hugging Face 項目明確係基於 MiniMaxAI/MiniMax-H3 嘅 LoRA adapter,針對真人角色畫面再微調,重點放喺面部穩定度、皮膚質感、微表情同帶少少手持感嘅電影式運鏡,亦保留 MiniMax H3 原生同步音訊能力。

頁面提供嘅核心資訊相當集中:它屬於 text-to-video,授權採用 minimax-h3-community-license,主要檔案是 h3-realism-people-t2v.safetensors。使用方法唔複雜,要先喺 prompt 開頭加入 trigger word r34l1sm,再透過 fal 的 MiniMax H3 LoRA 端點掛載,範例 scale 係 1.0;想保留多啲 base model 原本味道,可以降到 0.6 至 0.8。

同類 LoRA 最大分別,往往唔係畫面變得幾誇張,而係同一個 prompt、同一個 seed 之下,能否穩定改善人物可信度。呢個項目用 before/after 方式展示 19 組對照,強調唯一變數係 adapter 本身,連 trigger word 兩邊都有加,目的係證明提升主要來自微調權重,而唔係提示詞技巧。頁面亦講明它係前作 MiniMax-H3-Realism-LoRA 嘅後繼版本,並且改用更大、更加聚焦人物題材嘅資料集重新訓練。

  • 基礎模型:MiniMaxAI/MiniMax-H3,關係標記為 adapter
  • 主要用途:強化寫實人物、近鏡面部、群眾、手部與紀錄片感鏡頭
  • 主要檔案:h3-realism-people-t2v.safetensors
  • 推薦控制:trigger word r34l1sm,LoRA scale 以 1.0 為預設,可降至 0.6-0.8

要留意,項目本質上係影片生成用嘅 LoRA,唔係可直接本地量化部署嘅通用文字模型。換句話講,它嘅價值更接近一個針對 MiniMax H3 補強人物鏡頭表現嘅專用適配器,而唔係完整獨立模型;使用場景亦明顯偏向 fal 平台上的 text-to-video 工作流。

模型

Categories: 開源, AI productions, 視頻模型, Video, Audio, MiniMax

MiniMax H3 Turbo:4 步加速的影音生成 LoRA

MiniMax H3 的 ComfyUI 加速 LoRA,把 10 秒影片生成壓到固定 4 步。它適合要在速度、畫質和可控性之間取平衡的 T2V 與 I2V 工作流。

Og image

MiniMax H3 Turbo 走的是 ComfyUI 用途的加速路線,核心價值在於把 MiniMax H3 的文本生成影片(Text-to-Video, T2V)和圖像轉影片(Image-to-Video, I2V)流程固定到 4-step Euler 推理。它不是獨立模型,而是要配合 Comfy-Org/MiniMax-H3 的 BF16 base model 使用;頁面未提供更完整的 base model 參數規模或訓練細節,所以不能再往下猜。

這種設計的取捨很直接:步數少,生成時間通常更短,但對動作細節和穩定性的容錯也會更窄。頁面列出的比較都在同一個 BF16 base model、同一輸入與 10 秒、約 0.9MP 解析度條件下做,LoRA strength 固定 1.0;不同場景下,時間大概落在 174 到 190 秒之間,速度提升存在,但不是壓倒性。

重點摘要:
– 支援 T2V 與 I2V,I2V 走第一幀路徑,亦可用最後一幀收尾
– 固定 4-step Euler,重點是縮短推理流程而非擴大模型能力
– 需要配對 Comfy-Org/MiniMax-H3 的 BF16 base model
– 頁面未列出 GGUF、mmproj、上下文長度或量化檔案資訊
– 與 lightx2v LoRA 的比較屬同級加速方案,差距主要體現在時間與輸出取向

從檔案描述看,這個項目是 LoRA,不是完整 diffusion checkpoint,所以它的定位比較像「推理策略補丁」而不是全新模型。頁面也沒有提供 llama.cpp、Ollama 或 LM Studio 的支援資訊,顯示它主要面向 ComfyUI 工作流,而不是通用本地推理框架。

檔案命名上,頁面強調這是 v2 類型的更新版本脈絡;因此可確認的只有它圍繞 H3 的 joint audio-video diffusion path,並以固定 4 步作為加速契約。若要和原始 base model 比,差別不在功能範圍,而在於把生成速度和步數控制收緊,換取更快的工作流回饋。

模型

Categories: 開源, ComfyUI, 數字人, 視覺模型, 視頻模型, Video, Image, Audio, MiniMax

ComfyUI-Spectrum-MiniMax-H3:為 H3 加速 33%

將 1056x608 影片生成由 685 秒縮短至 464 秒,避開昂貴的 transformer 重算。它屬近似加速,但影片細節可能走樣。

Repository image for xmarre/ComfyUI-Spectrum-MiniMax-H3

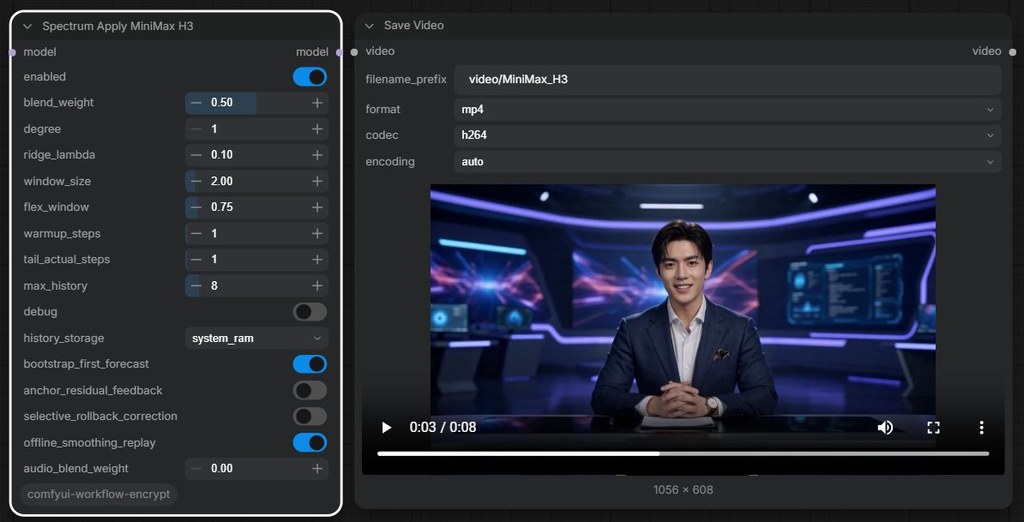
每次跑 MiniMax H3 都要付出完整 transformer 計算成本,對要反覆試 prompt、鏡頭動作同參考音訊的人來說,等待本身就是工作流瓶頸。xmarre/ComfyUI-Spectrum-MiniMax-H3 針對的正是這一步:它屬於 ComfyUI 自訂節點工具,會在部分 solver steps 直接預測 post-transformer hidden features,減少原生 MiniMax H3 audio-video model 的重計算次數。

實測生成 1056×608 影片由 685 秒縮短至 464 秒。加入這 Node 後可惜仍未能解決「廣東話」問題!

它不是把整個模型 shortcut 掉,而是用 Chebyshev ridge model 去擬合已經算出的 hidden features,再對未來步數作 spectral forecasting;但當前步的 output heads、video reconstruction、audio reconstruction、sigma mapping 同回傳結構仍然照常執行。這個取捨很務實,因為它換到的是抽樣成本下降,不是完全無損加速,所以 README 已經講明輸出不會與原生 MiniMax H3 bit-identical。

作者後來把預設路徑改成 offline_smoothing_replay,核心原因不是追求更高畫質,而是先救回音訊品質。早期單次流程會令語音清晰度、自然度同穩定性下降,甚至出現 doubled syllables 同 stuttering;現時預設把 audio_blend_weight 維持在 0,並以第二次無 transformer 的 replay 處理 video blend,目的就是切斷後段 video-to-audio feedback 對聲音的干擾。不過,畫面軌跡仍可能改變,動作、視線、時間點,甚至眼睛、手指、四肢細節都有機會走樣。

安裝十分簡單,適合願意做 exact-seed A/B 比對的創作者、工作流調校者,或者已經在 ComfyUI 內使用 MiniMax H3 的團隊。README 也提到舊版 workflow 可能要手動開啟 offline_smoothing_replay,而且 broader checkpoints、prompts、samplers 同 reference inputs 仍未完成足夠驗證,現階段更像是一個有方向、有明確修正策略,但仍需按素材類型逐步確認的加速方案。

  • 以 spectral forecasting 預測部分 future solver steps,重點是減少 MiniMax H3 最昂貴的 transformer evaluations。
  • 保留當前步的原生輸出頭與音畫重建流程,因此屬於近似加速,不是無損複製原生結果。
  • 預設改用 offline_smoothing_replay,主要是修正早期版本對語音自然度與穩定性的破壞。
  • 音訊路線暫時較保守,但視覺結果仍可能出現 motion、pose 與細節結構偏移。
  • 較適合已在 ComfyUI 工作流內做反覆測試、願意接受 A/B 驗證成本的使用情境。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

ComfyUI-MiniMaxH3-Easy:幫 H3 補回可用性

把 MiniMax H3 放進 ComfyUI 後,最麻煩的接線、引用同提示編排,被整理成較順手的一套介面。

Mixed media input

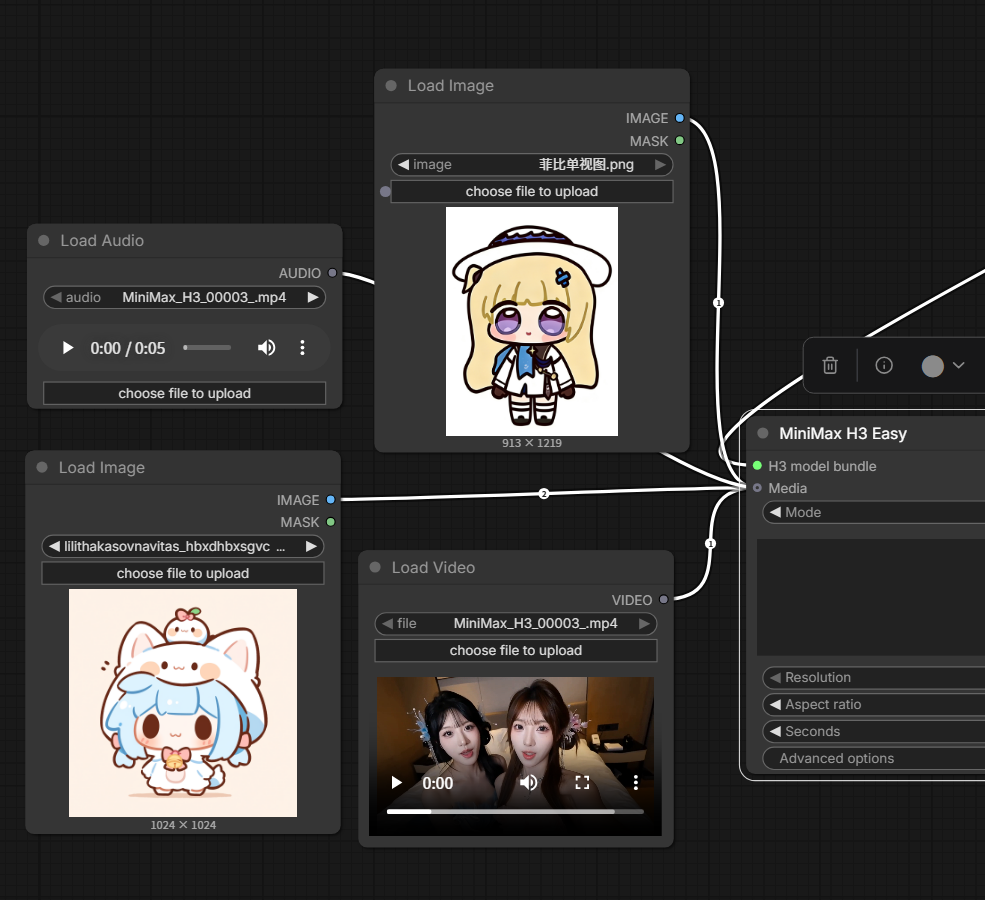
做影片生成時,最阻手往往唔係模型能力,而係節點圖愈接愈亂、參考素材愈加愈難管理。ComfyUI-MiniMaxH3-Easy 屬於 ComfyUI 自訂節點工具,集中處理 MiniMax H3 的 text-to-video、image-to-video 同 reference-to-video 工作流,將原本分散嘅媒體接線、參考標記同提示編輯收埋到同一個操作面。

呢個項目最實際嘅改動,在於保留 ComfyUI 彈性之餘,減少你每次都要手動整理素材順序。主節點用一個 Media 輸入口同時接收圖片、影片同音訊,仲會分開追蹤各自次序;一張圖會走 image-to-video,兩張圖就可用作 first/last-frame generation。做 reference-to-video 時,提示編輯器支援 @ 揀選已連接素材,執行時再自動轉成 MiniMax 建議嘅 <Picture N>、<Video N>、<Audio N> 格式,唔使自己逐個標籤維護。

  • 將多種媒體收進單一 Media 入口,節點圖會乾淨得多
  • @ 參考編輯器有預覽,較適合需要反覆改 prompt 嘅影片生成流程
  • # 對話區塊可直接寫成可編輯 block,送出時自動轉成 <d>...</d>
  • 可接 model-only LoRA、Sage Attention patch,亦可直接連到模型相關節點

同類做法通常要求使用者自己記住引用格式、接線順序同素材對應,ComfyUI-MiniMaxH3-Easy 選擇用較重介面包裝,換來較低出錯率同較高可讀性。代價亦明顯:它改善嘅係 MiniMax H3 在 ComfyUI 入面嘅操作層,不是另起一個新模型,也未見提供生成品質、速度或資源佔用測試數字,因此價值主要落在工作流整理,而唔係模型性能突破。

較受惠嘅會係已經用開 ComfyUI、但又嫌 MiniMax H3 節點圖太碎太亂嘅創作者、影片實驗團隊同需要反覆比對參考素材嘅人。部署方式亦唔複雜,理解上可以當成安裝到 ComfyUI 內嘅一組工作流節點:接好模型或 LoRA、把圖片或影片餵入 Media、再用內建編輯器整理引用同對話內容,就可以直接進入生成流程。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

Page 6 of 7
1 … 4 5 6 7