ComfyUI-FL-MiniMaxH3 時間軸節點

這套 ComfyUI 節點把 MiniMax H3 的提示詞、音訊與影片生成整理成可重拍、可分鏡及可組裝的時間軸工作流。

想控制影片每一秒出現甚麼畫面、配合節拍切分鏡頭,或者只重做其中一段而保留其餘內容,FL MiniMax H3 提供的是一套 ComfyUI workflow nodes,實際處理 MiniMax H3 影片與音訊 latent 的時間軸編排、取樣和合成問題。

核心節點會建立原生的 nested H3 video/audio latent 及 prompt conditioning。你可以手動設定 timeline,亦可接入 FL PROMPT SCHEDULE;系統支援以秒、frame 或 beat 安排提示詞,並把 H3 image、video、video audio、soundtrack 及獨立 audio reference 編碼到同一條可重用時間軸。
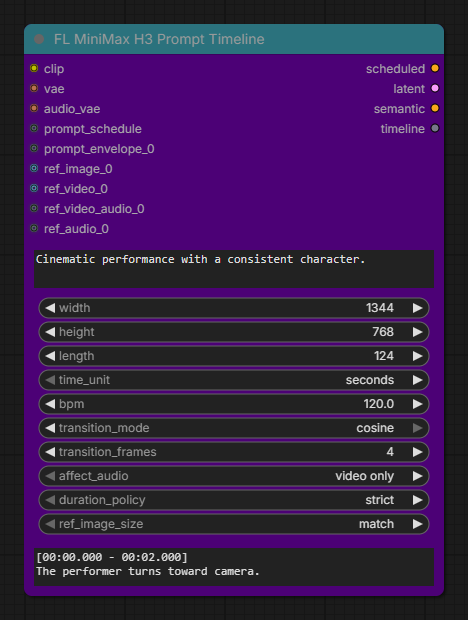
FL MiniMax H3 Prompt Timeline

與先將資料攤平再處理的流程相比,項目保留 MiniMax H3 原有的巢狀影片及音訊結構,並提供 native latent upscaling,調整影片 latent 的高度和寬度時毋須經過 VAE 往返。需要更細緻修整時,pixel-space refinement 才會執行 decode、resize、re-encode,再於指定 sampling-step window 內細化結果。

  • 可按節拍規劃獨立或明確分組的 shots
  • 支援 frame-exact temporal reshots,只重生成指定區間
  • 可把上一個 render 的 authored tail 作為 hard-cut motion context
  • 內置 sampler previews,並可按時間軸組裝最終影片

使用者需要已有節點所需的 H3 text encoder、video VAE 和 audio VAE;適合需要精確控制分鏡、重拍範圍和聲畫結構的 ComfyUI 創作者及影片工作流程,而非用作性能比較。
GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, MiniMax

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

四步生成同步音畫:FastH3 預覽模型拆解

非官放加速 MiniMax FastH3 以四次 Transformer forward 生成同步影片與音訊,但需要專用 VSA-H3 後端及多張高階 GPU。

Og image

文字提示輸入後,FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree 可在四次 Transformer forward 內生成同步影片與音訊,適合測試快速 text-to-audio-video 工作流程。模型明確基於 MiniMaxAI/MiniMax-H3 微調及蒸餾,並以 data-free DMD2 和 VSA-H3 訓練至 step 1300,在 90% sparsity 下換取較少取樣步驟。

模型需要 FastVideo 的 VSA-H3 attention backend,不能只下載權重後以一般推論工具直接執行。官方測試配置使用四張 B200 GPU;其他多 GPU CUDA 系統可改用 Triton kernel,但 GPU 數量必須能整除 H3 的 56 個 attention heads。頁面沒有提供 llama.cpp、Ollama 或 LM Studio 支援,也沒有列出 GGUF 檔案、量化級別、檔案大小或 mmproj 附加檔案,因此不能據此建議 Q4_K_M 或其他量化方案。

  • 四次 forward 生成音訊與影片,速度取向明確
  • DMD2、VSA-H3 及 90% sparsity 用於 data-free 蒸餾
  • 目前只支援 text-to-audio-video,FL2VA 和 Ref2VA 尚未蒸餾
  • 困難動作、細節及部分音訊可能不及 MiniMax H3 base model
  • 頁面未提及 MTP draft speculation、v2 更新或檔名變更

這個 Preview checkpoint 仍可能在動態、細節和音訊穩定度上落後原始 MiniMax H3,定位較接近快速生成與研究測試版本。使用時要留意 MiniMax H3 Community License,以及 FastVideo 安裝流程對 CUDA 13、Blackwell 路徑和專用 kernel wheel 的要求。

模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, MiniMax

Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

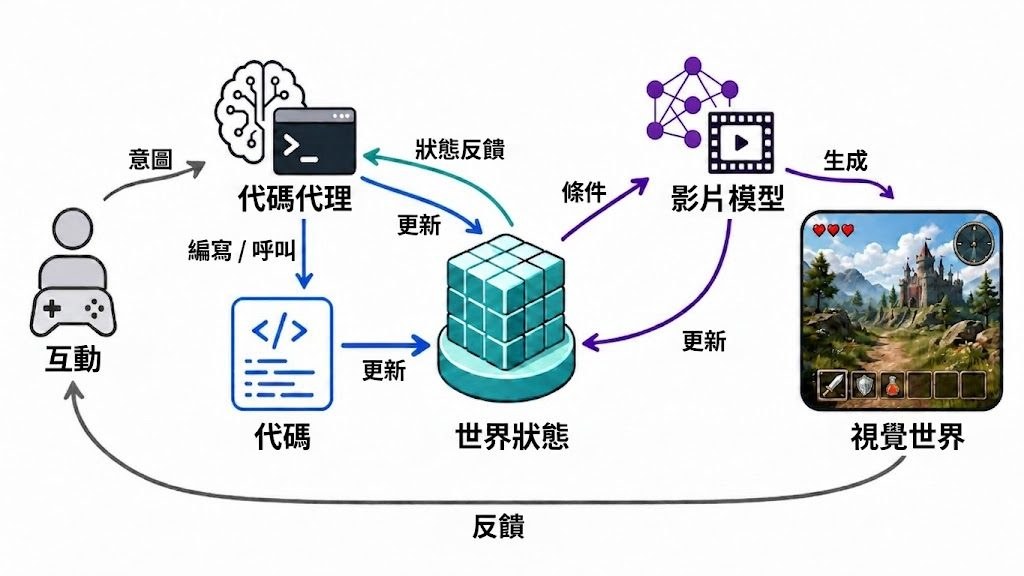
Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

VGI-Bench 揭示影片模型推理仍未可靠

影片生成模型不只要畫面合理,還要令事件按正確過程演變。VGI-Bench以27項任務測試這種能力,最高分只有51%。

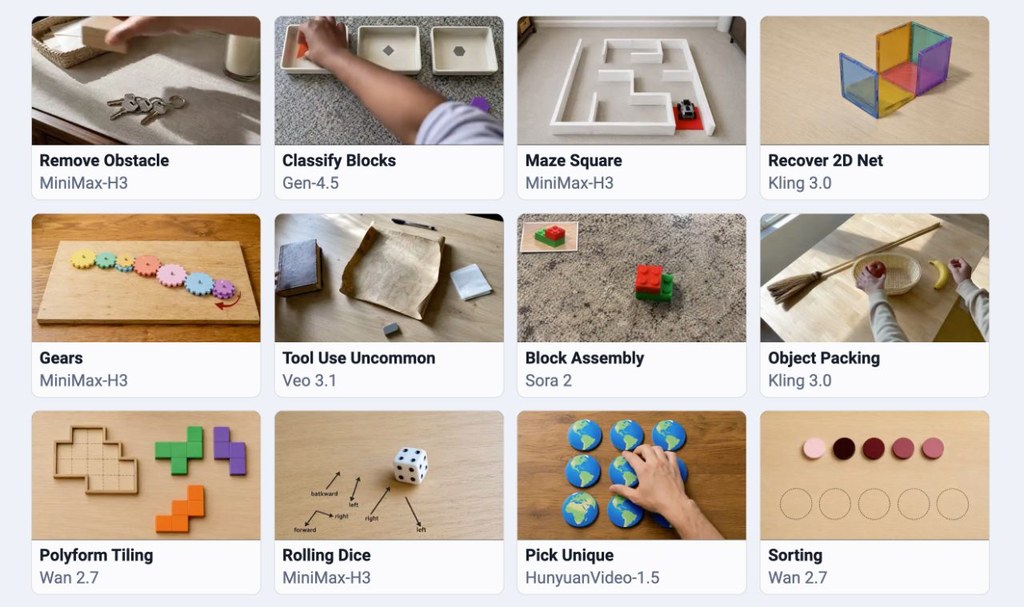
Repository image for hexuan21/VGI-Bench

當影片生成模型要處理空間關係、時間變化、物理操作或結構謎題時,畫面好看並不代表推理正確。VGI-Bench屬於影片模型視覺推理評測基準,實際處理的是如何檢查模型能否生成符合條件、而且過程連貫的影片,而非只交出一個合理的最後畫面。

VGI-Bench包含27項任務及810個測試實例,按任務領域和 skill tags 分成兩層分類,並設有 easy、mid、hard 三個難度級別。測試輸入盡量貼近現時影片模型熟悉的視覺先驗,同時要求輸出反映有效的 evolving process;評分採用 rubric score × completeness score,兼顧答案是否正確及是否完成要求。

結果反映模型能力仍有明顯缺口:Seedance 2.0以51.0%取得最高總分,在 Visual Organization、Spatiotemporal 和 Physical Manipulation 領域領先;MiniMax-H3則以50.6%在 Structured Puzzles 領先。Sora 2、Gen-4.5、Wan 2.7及Veo 3.1等模型亦被納入比較,方便分辨影片品質與視覺推理能力之間的差距。

  • 生成畫面合理,不等於推理過程正確
  • 覆蓋視覺組織、時空推理、結構謎題及物理操作
  • 最高總分只有51.0%,可靠性仍不足
  • 分析涵蓋輸出失敗模式及輸入條件敏感度
  • 去噪後期主要修整早期假設,未必能修正推理錯誤

研究團隊亦檢查 synthetic fine-tuning 的性能轉移邊界,並從 internal denoising 角度分析模型如何修正答案。結果指向有限的 self-correction:後續步驟多數是在完善早期假設,而不是重新推翻錯誤推理。這個基準較適合影片模型研究團隊、模型供應商及需要比較生成式視覺推理能力的評測項目;GitHub資料提供 project page 及 Hugging Face Data & Res 連結,但所給資料沒有列出安裝步驟或完整測試流程,不能直接假定可下載後即時重現。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型訓練, Robotic, Dataset 數據集, MiniMax, Skill 技能

阿里巴巴 PAI 以 PDD 加速 MiniMax-H3 影片生成

阿里巴巴 PAI 團隊把 MiniMax-H3 變成少步數就能出片的版本。你可以把它理解成針對影片生成速度做加速的 LoRA。

Og image

阿里巴巴 PAI 團隊針對 MiniMax-H3 做了 Parallel Decoding Distillation(PDD),目標是用更少推理步數完成影片生成。這份項目同時保留 MiniMax-H3 的兩條路線,分別對應 FL2VA 和 Ref2VA,方便按不同基礎版本套用加速 LoRA。

兩個官方 8-step Acc LoRA,檔名分別是 MiniMax-H3-FL2VA-Acc-8Step.safetensors 和 MiniMax-H3-Ref2VA-Acc-8Step.safetensors,兩者都標示 rank=64、network_alpha=64,並以 BF16 形式提供。這表示它們不是完整底模,而是掛在對應 base model 上的加速適配器。

8-step Acc LoRA 可配合 768p 生成流程,並對比 baseline、Turbo 4-step 版本和 8-step Acc LoRA。

實務上,8-step Acc LoRA 代表在速度和畫面穩定度之間做取捨,重點是把影片生成的推理成本壓低,而不是追求最長流程。相較原始 MiniMax-H3,這類 LoRA 的用途更偏向快速出樣和迭代,適合需要較短等待時間的影片生成工作流。

  • 開發團隊是 Alibaba-PAI,並以 MiniMax-H3 做 PDD 加速
  • 提供兩個 8-step 官方 Acc LoRA,分別對應 FL2VA 和 Ref2VA
  • 檔案以 BF16、rank=64、network_alpha=64 方式發布
  • 頁面有 768p Demo,但未交代 GGUF、mmproj 或硬體需求

項目主頁 · 模型

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, 視頻模型, Video, MiniMax

MiniMax-H3 一次生成 120 秒長影片

它把單次輸出的 MiniMax-H3 變成可接續的長片段影片流程,連音效也一併處理。角色、服裝和道具都會沿鏡頭延續,減少畫面在鏡頭交界處走樣。

Og image

H3-LongVideos 針對的是 MiniMax-H3 在長片段生成時最容易出現的問題:每個 shot 各自生成,角色外觀、服裝和道具很容易在鏡頭交界處漂移。這個 ComfyUI 節點把一段文字拆成多個 beats,再把每個 beat 變成一個 shot,並以前一鏡最後一幀接到下一鏡,令整條影片可以維持連貫。

這個項目是基於 ComfyUI 的 H3 支援來做,不是獨立模型訓練;因此只能確認它面向 MiniMax-H3 工作流。它同時處理 FL2VA 與 REF2VA 兩種條件方式,前者用一幀作為鏡頭錨點,後者用參考圖描述角色外觀,方便同一角色在多個 shot 裡保持一致。

輸出最長可到約 120 秒,並提供 soundscape、latent 和 info 等輸出。soundscape 會帶出場景實際使用的環境聲床,latent 則是按時間軸串接的 sampled latents,但在多 shot 情況下,它不是 images 的等價 latent 版本,因為 trim_seam 和 handoff_offset 截的是已解碼影格,H3 又會壓縮時間,所以 seam 附近的畫面仍會存在;只有單 shot 時才會完全對齊。

有用的是工作流層面的控制:prompt 第一段做 anchor,後續段落一段對應一個 shot;character_memory 管角色和服裝;resolution 與 megapixels 分開控制形狀和尺寸;shot_seconds 是上限而不是固定長度,先用 plan_only 預覽拆鏡、時長和警告,會比直接渲染更穩陣。

  • 以 ComfyUI 把單次 shot 的 H3 生成改成多鏡頭串接,重點在長片段連貫性。
  • 同時處理角色、衣著、道具和旁白/環境聲,減少鏡頭切換時的漂移。
  • plan_only 可以先檢查拆鏡結果和警告,不用先燒算力。
  • 頁面沒有提供 GGUF、量化版本、base model 或推論框架清單。
  • latent 輸出只在單 shot 時可視作等價結果,多 shot 時要留意 seam 與時間壓縮。

項目主頁

Categories: 開源, ComfyUI, 視頻模型, Video, MiniMax

[教學影片]MiniMax H3 六格分鏡生成多鏡頭 AI 影片

MiniMax H3 加入六格分鏡網格參考功能,用戶可直接餵故事板圖,再生成多鏡頭連貫短片,解決單鏡頭 AI 影片動作細節不足的問題。

Og image

AI 影片生成最常見的痛點之一,是鏡頭內動作幅度細,剪接起來又欠缺段落感。MiniMax H3 這次加入的 6-Grid Reference(六格分鏡網格)功能,嘗試從輸入端就解決這個問題:使用者把一張包含六格分鏡的故事板圖丟入模型,H3 會按格子內容分別生成對應鏡頭,再組成一條多鏡頭短片,避免單次生成只能「前後郁幾吋」的局限。

對熟悉影視分鏡流程的人來說,這等於把前期 storyboard 直接搬進生成管線。對一般創作者而言,操作門檻也比逐個鏡頭獨立 prompt 再拼接低很多——畫好六格、寫好提示詞,剩下的運鏡與節奏交給模型處理。

以下是這次教學與功能值得留意的幾個重點:

  • 六格分鏡直接餵入:以一張 2×3 或 3×2 的網格圖作為視覺參考,模型按格生成對應鏡頭,無需逐個 cut 分開生成。
  • 多鏡頭連貫輸出:最終成品會包含多個 shot,而非單一長鏡頭,方便直接接上剪接流程。
  • 適合分鏡先行的工作流:對動畫短片、廣告腳本、遊戲過場等已有 storyboard 習慣的團隊特別受用。
  • 降低逐鏡 prompt 成本:一次輸入即可覆蓋多個鏡頭,減少重複描述角色、場景、風格的工序。
  • 與 H3 既有能力整合:可與 H3 的角色一致性與風格控制一併使用,保持多鏡頭之間的人物與美術統一。

教學影片示範的工作流程大致是:先準備好六格分鏡圖,每格代表一個鏡頭的構圖與動作重點,提示詞內描述場景氛圍與鏡頭運動方向,再由 H3 一次過輸出。對於想快速測試分鏡概念、或者要把動畫前期視覺化的人,這條工作流比起從零開始寫分鏡 prompt 更直觀。

需要留意的是,六格分鏡的格數、比例與每格內容差異會直接影響成品質素,每格的構圖與動作如果太擠迫或太模糊,模型理解鏡頭意圖時容易出錯。建議先用簡潔構圖測試,再逐步加入複雜元素。

影片主頁 • ComfyUI 工作流 • 特別版 H3 模型

Categories: 開源, ComfyUI, AI productions, 多模態模型, Video, MiniMax

MiniMax H3 在 ComfyUI 實現換臉換身工作流

MiniMax H3 配合 ComfyUI 自訂節點,示範如何建立換臉與換身流程,方便整理影像生成工作流。

Og image

由換臉延伸到換身,影片示範 MiniMax H3 在 ComfyUI 中處理人物影像替換的完整流程,重點放在如何把不同步驟串連起來,減少使用者自行摸索節點配置的時間。

流程以 ComfyUI 為操作環境,並配合 custom nodes 建立 Face Swap 和 Body Swap 工作流。對需要處理人物素材、測試影像生成效果,或想將換臉與換身加入現有影像項目的創作者,這類示範可作為起點。

影片涵蓋的內容包括:
– MiniMax H3 在 ComfyUI 中的工作流安排
– Face Swap 換臉流程
– Body Swap 換身流程
– Custom nodes 的配合方式
– 從輸入素材到結果輸出的完整操作示範

Youtube 示範影片

Categories: 開源, ComfyUI, 教學, 安全, MiniMax, UI/UX

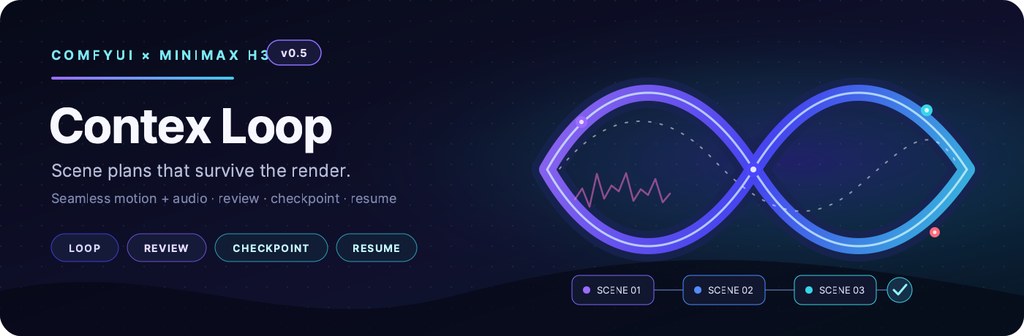
ComfyUI-MiniMaxH3-Contex-Loop:讓 MiniMax H3 多場景影片可重試續作

把多場景影片拆成可審核、可重試的製作流程,減少一次渲染失敗便要由頭再做的浪費。

MiniMax H3 Contex Loop v0.5 — scene plans that survive the render

多場景影片最麻煩的地方,往往不是生成單一鏡頭,而是其中一幕出錯後要重做整段流程。ComfyUI-MiniMaxH3-Contex-Loop 是一套開源 ComfyUI 工作流工具,利用一個可重用的 sampling body,按 scene Plan 逐幕生成 MiniMax H3 影片,並把已接受的片段從磁碟組合起來。

每個場景都可以獨立設定提示詞、seed、時間、圖片、動態影片及音訊參考;Review Gate 會讓使用者選擇批准、重試、reroll 或提早停止。candidate_count 亦可為單一場景生成多個候選,最後由使用者揀選指定 take,減少整條工作流反覆排隊的成本。

  • 支援中斷後 resume、partial assembly 及 atomic checkpoints
  • 可延續現有片段,處理 inpainting 和 two-ended bridges
  • Guide 與 protected AV-prefix transitions 有助維持畫面、動態及聲音連接
  • 支援 latent-to-PNG export,並可從已儲存資產恢復製作

v0.5 要求較新的 ComfyUI,包含原生 Add Guide for MiniMax H3。FFmpeg 放在 PATH 會較方便,沒有時可由 ComfyUI 內置 PyAV 處理 review 和 assembly,因此硬件、模型配置及渲染時間仍然是主要限制。倉庫目前以 main 作為支援的 0.5 發行線,已儲存的 0.4 workflows 和 checkpoints 仍然支援,較適合把生成流程分段管理的影片創作者及技術團隊。

GitHub

Categories: 開源, ComfyUI, AI productions, Video, Image, 框架, MiniMax

Page 5 of 7
1 … 3 4 5 6 7