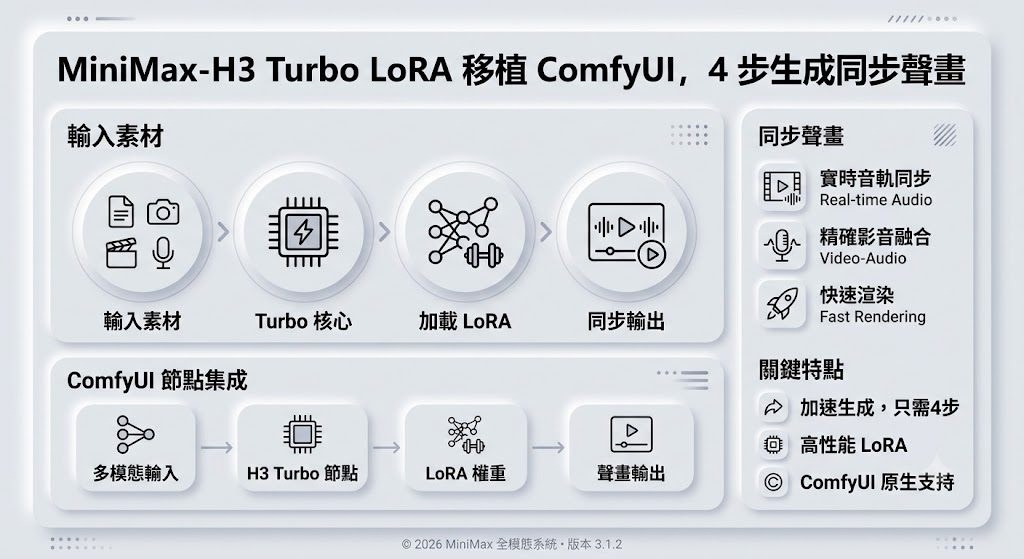
MiniMax-H3 Turbo LoRA 移植 ComfyUI,4 步生成同步聲畫

呢個版本唔係重新訓練主模型,而係把 MiniMax-H3 Turbo LoRA 轉成 ComfyUI 可直接載入的格式。重點在於 4-step 加速生成,同時保留聲畫同步能力。

Og image

想用更少步數生成影片同音訊,呢個頁面最值得留意的地方,是它明確基於 Comfy-Org/MiniMax-H3,而且屬於 adapter 形式的 LoRA,不是完整基礎模型。它針對 ComfyUI 使用的 pruned/curve-form MiniMax-H3 checkpoint 做兼容轉換,目的是讓原本由 larryvrh 發佈的 MiniMax-H3 Turbo LoRA — 4-step audio-video generation preview,可以透過 ComfyUI 內建的 MiniMax-H3 LoRA 載入流程使用。

技術上,核心價值在於把原始 Turbo LoRA 的 four-step distillation 和 dual video/audio sampling 帶入 ComfyUI 工作流。4-step 代表生成步數大幅壓縮,推理延遲有機會下降;頁面同時指出 non-EMA 權重較銳利、較能保持快速動作,EMA 權重則較平滑,但因為當時 EMA 未完全成熟,畫面會較柔。呢種取捨直接影響你想要的觀感:動態表現優先,可先看 non-EMA;畫面過渡想更順,EMA 版本更值得比較。

檔案方面,頁面列出 4 個 .safetensors LoRA 權重,包括初始兼容轉換版,以及兩個 further-trained checkpoint-500 變體:minimax_h3_turbo_4step_pruned_comfyui.safetensors、minimax_h3_turbo_4step_ema_pruned_comfyui.safetensors、minimax_h3_turbo_4step_ckpt500_pruned_comfyui.safetensors,以及對應的 EMA checkpoint-500 版本。

  • 基礎模型已明示為 Comfy-Org/MiniMax-H3,屬於 LoRA adapter 兼容轉換
  • 主要能力是 text-to-video,並帶有 text-to-audio、audio-video、synchronized-audio 標籤
  • 重點方法來自原作者的 four-step distillation,目標是加速推理
  • 頁面提供 ComfyUI workflow 範例下載,定位很明確:直接服務 ComfyUI 用戶

這個 Hugging Face 頁面是第三方整理的 ComfyUI 相容版本,價值在於把原始 MiniMax-H3 Turbo LoRA 接入 ComfyUI 生態,方便直接測試 4-step 聲畫同步生成與 checkpoint-500 變體之間的差異。

項目主頁

Categories: 開源, ComfyUI, 視頻模型, Video, Audio, MiniMax

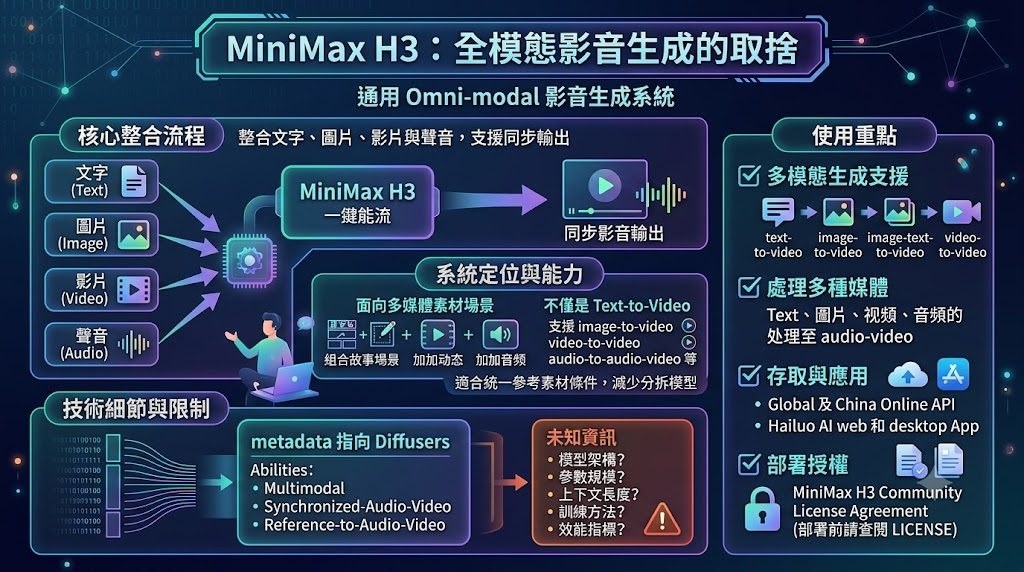
MiniMax H3:全模態影音生成說明書

MiniMax H3 把文字、圖片、影片與聲音整合到同一套生成流程,並支援同步影音輸出。

Og image

MiniMax H3 面向需要由多種媒體素材生成影片的場景,輸入可包括文字、圖片、影片及聲音,輸出則涵蓋影片與同步音訊。它屬於通用 omni-modal generative system,並非只處理 text-to-video,亦標示支援 image-to-video、video-to-video、audio-to-audio-video 等流程。提供的內容未載明它基於哪個 base model,亦無法確認是否由其他模型 fine-tuned from。

這種統一處理方式適合將參考圖片、動態片段或聲音一併納入生成條件,減少工作流程需要分拆成多個模型的情況。metadata 指向 Diffusers,並列出 multimodal、synchronized-audio-video 及 reference-to-audio-video 等能力;不過目前資料未交代模型架構、參數規模、上下文長度、訓練方法或效能指標。

可留意的使用重點包括:
– 支援 text-to-video、image-to-video、image-text-to-video 及 video-to-video。
– 可處理文字、圖片、影片與音訊,並生成 audio-video 組合內容。
– 提供 Global 與中國地區的 Online API,以及 Hailuo AI 網頁和桌面 App。
– 標示使用 MiniMax H3 Community License Agreement,部署前應查閱 LICENSE。

項目主頁

Categories: 開源, 多模態模型, 視頻模型, Video, Image, Audio, 3D, Ollama, MiniMax

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

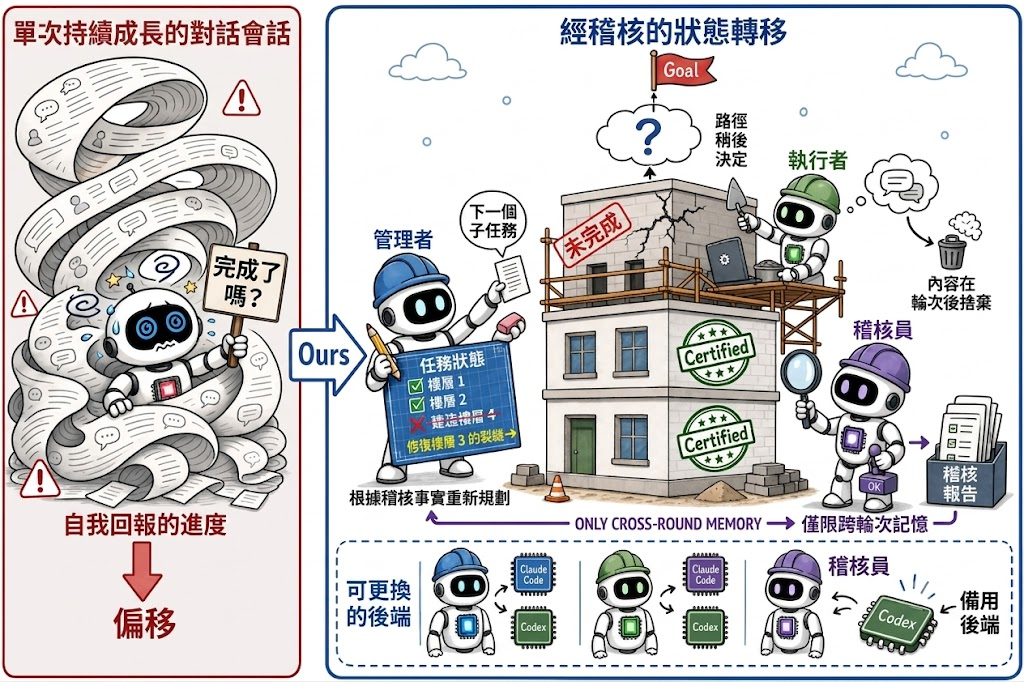
當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Agentic, Qwen, OpenAI, DeepSeek, Gemini, 框架, OpenClaw, Anthropic, Dataset 數據集, MiniMax, Skill 技能

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based on、base model 或 fine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

MiniMax H3 頂級高清影片生成

MiniMax H3 提供咗一套較完整的影片生成 API。它重點不只是出片,仲包括參考生成同影片編輯控制。

Og image

做影片內容時,最麻煩往往不只是「生成一段片」,而係點樣令角色、鏡頭起承轉合同參考素材保持一致。MiniMax H3 屬於多模態影片模型,處理的正正係呢類控制力需求:除咗 Text-to-Video,亦支援以首幀、尾幀、參考圖片、參考影片同音訊去引導生成結果。

對內容團隊、短片創作者同需要自動化出片流程的開發者而言,呢個項目的吸引力在於輸入方式夠彈性。你可以由一段 prompt 起步,也可以加入第一張或最後一張畫面去約束開場與收尾;當需要保留人物、動作、鏡頭風格、聲線或剪接節奏,則可改用 Reference Generation。

MiniMax Just Dropped a Open Source "Seedance Killer"
  • 支援 Text-to-Video、First/Last-Frame Image-to-Video、Reference Generation
  • 統一理解 text、image、video、audio,多種素材可混合輸入
  • 輸出最高為 2K,片長 4 至 15 秒,只接受整數秒
  • 參考輸入上限包括最多 9 張圖片、3 段影片、3 段音訊,混合檔案總數上限 12

規格上,MiniMax H3 支援常見長闊比,圖片、影片與音訊都有清晰的格式及大小限制,例如影片可用 H.264/AVC、H.265/HEVC,圖片可用 JPG、PNG、WEBP,音訊則支援 WAV、MP3。音訊不能單獨提交,必須配合圖片或影片一齊使用;而較大的素材更建議用 URL 方式傳入,避免 API request body 超出 64 MB。

現有資料集中在能力範圍、輸入限制同 API 使用方向,能夠幫你快速判斷適唔適合接入工作流。

項目主頁

Categories: MCP, 多模態模型, 視頻模型, API, Video, Image, Audio, 語音, MiniMax

CantoneseChat:會聽聲調語氣的粵語聊天 App

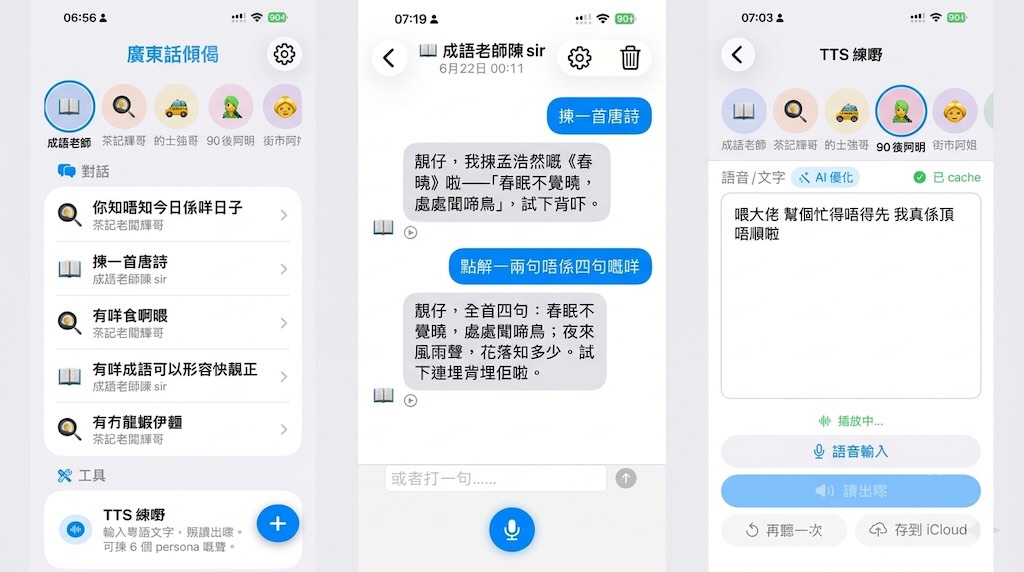
一個針對粵語互動而做的 iOS 項目,把語音辨識、語氣調整同 TTS 串成完整對話流程。重點不只在聊天,而是回應更貼近香港人口吻。

Cantonese Chat iOS app demo — Home / Chat / TTS Lab

CantoneseChat 是一個 iOS 粵語語音聊天工具項目,核心目標不是做通用聊天介面,而是把 iPhone 收音、on-device 粵語 STT、MiniMax cloud 的 LLM + TTS,以及 persona 語氣控制接成一條完整流程。它實際解決的問題,是一般語音助手識到字,但未必講得似香港人,亦未必會按說話者特徵調整語氣。

這個項目最值得留意的地方,是它會先用 AVAudioEngine 收音,再把音訊 downsample 去 16kHz,用 autocorrelation 估 pitch,推斷 VoiceType、Gender 同 AgeGroup,之後把結果注入 LLM system prompt。這種做法不是高精度聲紋身份辨識,而是偏向 heuristic 的語氣適配,所以速度會較直接,代價是分類準確度很受環境噪音、聲線變化同 pitch 規則影響。

安裝與理解方式也算清晰:它是 iPhone 真機導向的 iOS App,因為核心功能依賴 mic、AVAudioEngine、本機語音輸入同雲端模型串接,單看資料已可判斷模擬器未必能完整反映效果。測試時應分開看幾部分:persona 對話是否有語氣差異、TTS Lab 經 AI 粵語優化後是否更口語、pronunciation_overrides.txt 能否修正讀音,以及 iCloud export 有沒有順利保存音頻。

  • 支援 6 個 persona,適合示範同比較不同說話風格
  • 用 pitch heuristic 分類 VoiceType,再推斷 Gender、AgeGroup
  • 整合 on-device 粵語 STT、MiniMax cloud 的 LLM + TTS
  • 提供 pronunciation_overrides.txt 修正粵語讀音
  • 可將生成音頻匯出到 iCloud Drive

適合想做香港市場語音互動介面,例如客服示範、教育對話、角色語音內容,或者想研究粵語人機互動體驗的小團隊。若你重視可控語氣、多 persona 展示同本地口語感,它有明確方向;若你追求嚴格年齡性別判斷,這套規則式分類就應視為體驗輔助,而不是可靠的人口統計模型。

相關模型與模組包括 MiniMax cloud 的 LLM 與 TTS、iOS on-device 粵語 STT,以及項目內以 pitch 為基礎的 VoiceType 分類流程。公開資訊未見標準基準測試或 OSWorld 這類評測結果,所以較合理的判斷方式,是把它看成一個完成度不錯、偏產品原型取向的粵語語音互動項目。

GitHub: https://github.com/elbartohub/CantoneseChat

Categories: 開源, 文字轉語音, Audio, 香港, 語音, 蘋果, MiniMax, 廣東話

MiniMax-M3:開源多模態模型新選擇

MiniMax-M3 已在 Hugging Face 上公開下載。這模型聚焦多模態輸入與模型部署整合。

Og image

MiniMax-M3 是 MiniMaxAI 放上 Hugging Face 的模型。主要提供模型推理,image、video、tool_call 及 think 等標記,顯示它很可圍繞多模態互動、工具調用與對話生成能力而設計。

這項目的用途是把文字、圖片或影片訊息放進同一套模型流程中處理。

值得關注的在於它不只像傳統文字模型那樣處理純文字,還預留了工具調用與多種內容標記格式。對開發 Agentic workflow、聊天助理、內容理解流程的人來說,這類設計可減少自行定義輸入格式的工夫,亦方便把不同媒體資料放進同一條處理鏈。

重點可先看以下幾點:
– 支援 image、video 等多模態標記
– 具備 tool_call 結構,適合工具調用場景
– 可用於聊天、內容理解與自動化互動流程

若你是開發者、研究者,或想找可整合多模態能力的模型,MiniMax-M3 有一定參考價值。至於效能、模型尺寸、硬件需求與基準測試,暫時未有完整列出,使用前宜先核對 Hugging Face 頁面的更新資訊。

項目: https://huggingface.co/MiniMaxAI/MiniMax-M3

Categories: 開源, 模型, 多模態模型, Video, Image, MiniMax

MiniMax Mavis:多 Agent 協作處理長任務

MiniMax 將 Agent 升級為 Mavis,主打多 Agent 團隊協作。它瞄準長時間、步驟多、需要覆核的工作流程。

Og image

MiniMax 把原有 Agent 升級並命名為 Mavis,重點是加入 Agent Teams,讓多個 Agent 在桌面版同時運行,並以不同角色分工合作。這個方向主要處理單一 Agent 面對長任務時容易同時做執行者與裁判、資料整理與事實核對混在一起的問題。

過去把一個複雜要求直接交給單一 AI assistant,回覆速度可以很快,但當內容需要最新資料、來源整理、格式輸出與結果驗證時,流程便容易失焦。Agent Team 的做法是把任務拆成前台與後台、有驗收、有記憶的工作流;用戶仍然只需輸入一個要求,系統再判斷是否拆解、哪些角色可並行、哪些結果需要覆核。

對一般用戶而言,這項目最易理解的用法,是把它視為一個可分工的 AI 工作團隊。若你要處理長篇內容整理、跨格式輸出,或需要連續跟進的知識工作,Mavis 會比單一 Agent 更合適;如果只是一次性的小任務,官方亦暗示未必需要動用 Agent Team。

  • 支援多個 Agent 並行,適合長時間與複雜任務
  • 可建立不同角色分工,提升整理、驗證與交付流程
  • 用戶只需提供一次指令,系統會自行判斷是否拆解任務
  • 整合 TokenPlan 與 Agent Plan,CLI、API、Agent 共用訂閱與 credits

另一個更新是把 TokenPlan 與 Agent Plan 合併成單一訂閱,涵蓋 CLI、API、Agent,以及 M2.7、music、video、voice 等能力,credits 亦可共享。對已同時訂閱兩個計劃的用戶,官方表示會補送一個月會籍。這次內容未見具體跑分或量化基準,重點更偏向產品工作流與使用體驗的重整。

項目: https://www.minimax.io/blog/minimax-agent-team-long-running-1779893953

Categories: Agentic, AI productions, API, Video, 工具, 線上服務, IDE, MiniMax

Page 7 of 7
1 … 5 6 7