MiniMax-H3 Singularity:提升影像轉影片品質

基於 MiniMax-H3 深度微調的多模態影片模型,針對動作模糊、遠景人臉失真與光影過油等痛點進行修補。

Minimax-h3_Singularity 是建基於 MiniMax-H3 的多模態影片生成模型,採用 Apache-2.0 授權,於 ComfyUI 環境原生支援 Text-to-Video(T2V)、Image-to-Video(I2V)、Reference-to-Video(Ref2V)以及 Video-to-Video(V2V)四種工作流程。開發者並非單純做一次 LoRA 貼片,而是將 ref、fl、b25-49 等多個關鍵 checkpoint 進行策略性融合,再以高步數深度微調,最後花三天做精準剪枝與權重優化,目的是在保留 MiniMax-H3 原生 prompt 適應力與泛化能力的同時,壓住高步數訓練帶來的鬼影與過擬合。

這個版本重點針對三類常見瑕疵:高動態場景的運動模糊、Medium-to-Long Shot 距離下的人臉崩壞與糊化,以及人物皮膚過油、光澤不自然的問題。在功能面上,它特別加強了武打對戰、魔法施法、粒子光暈等奇幻動作場景的動感張力,同時提升鏡頭語言對搖鏡、推拉、追蹤等運鏡指令的回應度。

模型以 ComfyUI 節點工作流為主要入口,並附帶 RunningHub 線上 Demo 以及 YouTube、Bilibili 展示頻道連結,方便先觀察實際輸出再決定整合方式。

MiniMax H3 Singularity开源!全面微调融合,基础能力还在!嗨,大家好,这里是啊ban!快去玩!纯推荐分享视频!

重點摘要:

  • 基礎模型:以 MiniMax-H3 為底,融合 ref、fl、b25-49 等 checkpoint 做高步數微調與剪枝
  • 支援工作流:T2V、I2V、Ref2V、V2V 四種 ComfyUI 多模態流程
  • 主要修正:HDR 影像品質、遠景人臉修復、去油感光影、強化武打與魔法 VFX 動感
  • 鏡頭控制:對 pan、tilt、zoom、tracking 等運鏡指令有更敏銳回應
項目主頁

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, MiniMax

MiniMax H3 Semantic Bridge:單卡煉成的極輕量視頻生成適配器

約 11 MB 的小型適配器,可在不改動 H3 權重的情況下,把跨架構語意信號融入 MiniMax H3 的視頻生成流程。

Og image

由社群開發者 speach1sdef178 發佈的 MiniMax H3 Semantic Bridge,基於 MiniMaxAI 嘅 MiniMax-H3 進行延伸,定位係一個輕量嘅 conditioning-space 適配器,主要服務於標準 H3 FL2VA 文字生成視頻流程,整個項目僅用單張 NVIDIA RTX 3090 Ti 24 GB 完成訓練,並無動用多 GPU 叢集。

這並非 LoRa、checkpoint 合併或傳統的參數轉接。此適配器在影片Transformer之前轉換原生H3條件,並將學習到的語意表示以可控強度融合回H3。佢嘅核心做法係將原本用於 SenseNova U1.5 嘅語意表示,透過跨架構遷移與蒸餾,壓縮成一個獨立嘅小型檔案(MiniMaxH3_SemanticBridge_v1.safetensors)。使用時 SenseNova 完全唔需要載入,適配器會喺視頻 transformer 之前轉換 H3 嘅原生 conditioning,再以可控強度將學到嘅語意信號混合返入 H3。檔案本身只有約 11 MB,並唔係 LoRA、權重合併或者傳統參數嫁接,安裝方法係將 MiniMax_H3_Semantic_Bridge_v1.0.zip 解壓至 ComfyUI 自訂節點目錄,再將適配器放入新增嘅 ComfyUI/models/semantic_bridge/ 資料夾即可。

目前 v1 只支援文字條件嘅標準 FL2VA 流程,Ref2VA 參考圖生成或參考音訊工作流並唔適用。官方亦提到,喺參考音訊場景插入呢個適配器時,唱歌同嘴型同步表現會明顯下降,因此使用前要留意任務邊界,避免硬套落唔支援嘅流程。呢個項目提供咗 examples/ 對照素材、workflow JSON 同研究文章,方便用家直接喺 ComfyUI 內做 Native H3 同 Semantic Bridge 嘅 A/B 比較。

重點摘要:

  • 基礎模型:MiniMaxAI/MiniMax-H3,定位係 H3 嘅 conditioning-space 適配器而非權重合併。
  • 檔案規模:約 11 MB 嘅獨立 .safetensors,外加 ComfyUI 自訂節點 zip 同 workflow JSON。
  • 訓練條件:單張 RTX 3090 Ti 24 GB 完成,無需多 GPU 叢集,SenseNova 只用於訓練階段。
  • 支援範圍:適用於 H3 FL2VA 文字生成視頻,Ref2VA 同參考音訊流程未獲支援。
  • 整合方式:放入 ComfyUI custom nodes,並透過新增節點將 conditioning 同 latent 注入原有 H3 流程。

項目主頁

Categories: 開源, ComfyUI, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Audio, MiniMax

Fizgig:免重訓練逐塊修 LoRA,仲可以當遊戲咁變體

你試過 train 好個 LoRA 先發現風格走晒樣、身份感 overbaked 嗎?Fizgig 畀你逐個 block 拉 slider 救返,仲可以一鍵部署上 RunPod,免安裝。

Fizgig LoRA Studio — watch the full video tutorial

對成日同 LoRA 打交道嘅創作者來講,最痛苦嘅唔係訓練,而係訓練完之後先發現結果唔啱用。Fizgig 就係針對呢個痛點而嚟:佢係一個圍繞 Flux 2 Klein 9B、Krea 2 同 MiniMax H3 嘅 LoRA 工作台,聲稱可以喺 16 GB 顯示卡起跳,由普通 LoRA 一直玩到全模型微調都搞得掂。

佢最實用嘅功能叫做「LoRA surgery」:當你發現某個 LoRA 身份感太重、風格被壓扁,可以逐個 block 拉 slider 去修正,唔使重新訓練,直接輸出新嘅 .safetensors。對應到 MiniMax H3 影片 LoRA,仲可以逐 block 預覽每段對動作、面孔同聲音嘅影響,22 格短片連音效並排播俾你揀。

Minimax H3 - Edit your LoRAs directly with Video Previews

如果你鍾意試新變體,Fizgig 提供類似遊戲化嘅 mutation 流程:應用程式提出變化,你揀鍾意嘅,LoRA 就透過選擇演化落去。配合 LoRA Royale,你可以一次過睇晒成個訓練 run 每個 epoch 嘅效果,或者用 crossfade 喺唔同版本之間游走。LoRA Royale 仲可以直接輸出 MP4 或 GIF 格式嘅循環動畫,方便分享成果。

佢支援標準 LoRA、LoKR 甚至全模型微調,完成嘅 fine-tune 會變成普通 checkpoint,而 Checkpoint to LoRA 功能可以將任何 fine-tune 蒸餾返做可分享嘅 LoRA,揀你鍾意嘅 rank。對於冇 GPU 嘅人,官方提供 RunPod 一鍵部署連結,唔使本地安裝就得用到 24 GB 卡嘅 int8 設定。

重點摘要:

  • 逐 block 修復 LoRA:slider 直接調,唔使重訓練,解決 overbaked identity 同風格崩塌
  • 遊戲化變體探索:app 提議 mutation,用戶揀最愛,LoRA 經選擇演化
  • LoRA Royale 視覺化:一次過 render 晒每個 epoch,crossfade 揀最好嗰個,仲可以輸出分享用動畫
  • Block profiling:清楚顯示每個 block 揹住身份、風格定係細節,調之前先知邊度落手
  • 多模型支援:Flux 2 Klein 9B、Krea 2、MiniMax H3 三線齊,由照片、影片到聲音都覆蓋

GitHub

Categories: 開源, ComfyUI, AI productions, Video, MiniMax

VDN-H3 開源:14 秒 MiniMax 影片生成只花 11 秒

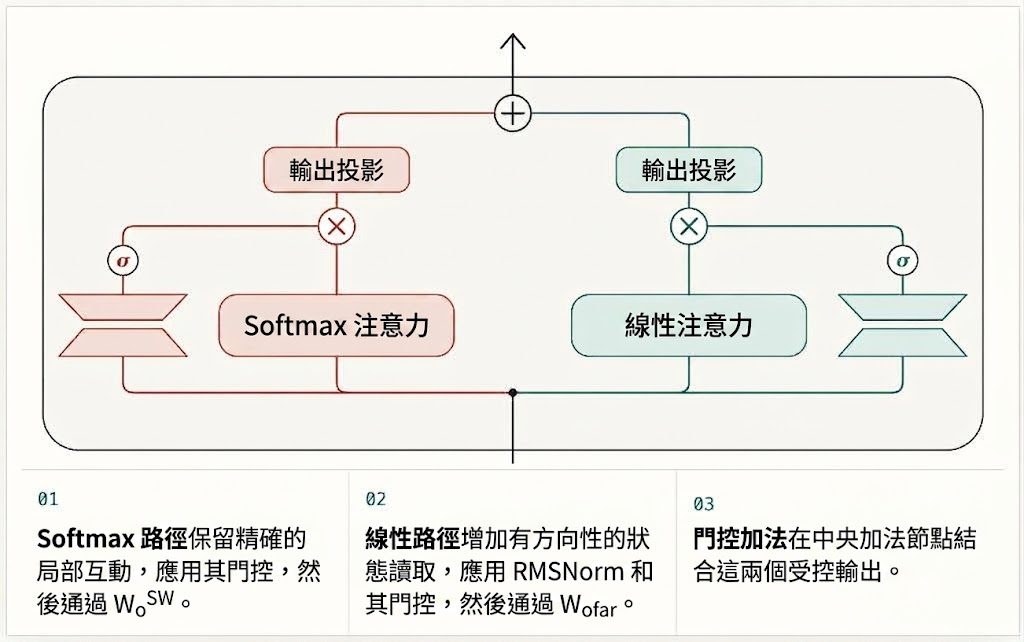
OpenVDN 團隊將 softmax 與線性注意力混合架構(hybrid attention)套用到 MiniMax H3 影片生成模型,在 8 張 B200 上以 8 步去噪產出 14.4 秒 768p 影片,速度比播放還快。

Repository image for OpenVDN/vdn-minimax-h3

影片生成最貴的部分往往不是參數量,而是長序列上的 softmax attention。VDN-H3 針對這個痛點,把 MiniMax H3 骨幹拆成兩條互補分支:滑窗 softmax 負責鄰近幀之間的精細對齊,線性注意力則接手長距離語境與主體一致性,並用 4 向邊界錨點補強全域結構。最終在 8 張 NVIDIA B200 上,用 8 步去噪就能在 11.23 秒內生成 14.4 秒 768p 片段,生成速度比播放還快。

與同類做法的差異在於「近乎無損」這個定位。純線性注意力雖然快,但長序列下容易丟失主體身份、場景佈局與時序依賴;VDN-H3 透過混合架構把這部分成本交回給局部 softmax,線性分支只負責長程記憶,因此視覺品質與原版 H3 幾乎難以區分,也比 MiniMax FastH3 有更好的指令跟隨能力。對需要高吞吐量同時不犧牲一致性的團隊,這個取捨相當實用。

部署面需要 PyTorch 2.13、CUDA 12.9 與 FlashAttention 4(含 nvidia-cutlass-dsl 預釋版依賴),另外還要安裝一份修補過的 Diffusers;骨幹權重不需更動,兩條 LoRA adapter 可在推理時合併進去,等同 plug-and-play 替換。程式碼、訓練流程與優化後的推理 stack 一併開源,研究者與影片生成產品團隊都能直接複用。

重點摘要

  • 8 步去噪、8 張 B200,11.23 秒生成 14.4 秒 768p 影片,生成快過播放。
  • 混合 attention:滑窗 softmax 保留局部細節,線性分支負責長距離語境。
  • 視覺品質與原版 MiniMax H3 近乎無損,比 FastH3 指令跟隨更佳。
  • LoRA adapter 可合併進骨幹推理,不需更動原始權重。
  • 權重、推理 stack 與訓練程式碼同步開源。

項目主頁 · GitHub · 模型· ComfyUI 節點

Categories: 開源, AI productions, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, Python, MiniMax

MiniMax-H3-Motion-Director 全能導演台節點

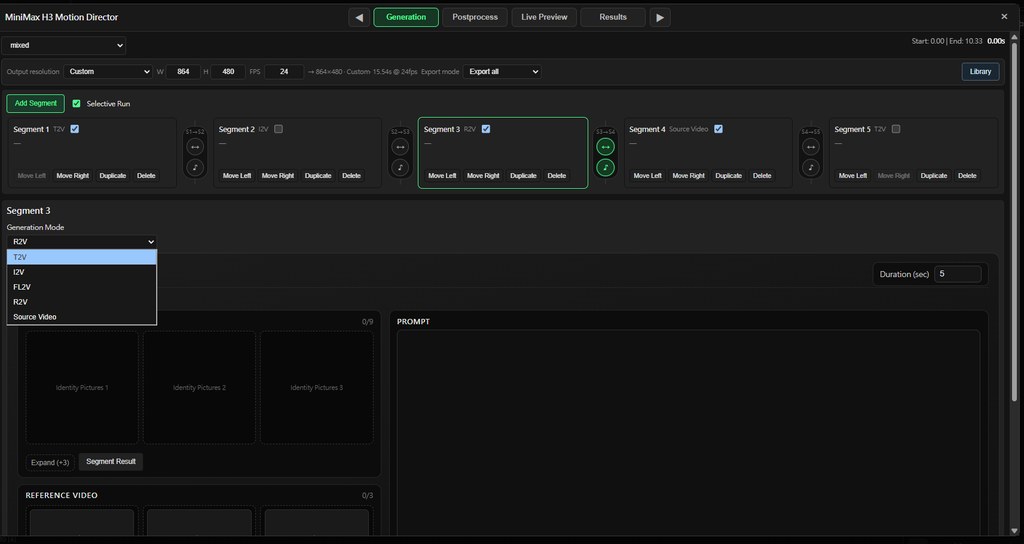
ComfyUI 自訂節點 Motion Director 將 T2V、I2V、V2V 等多段生成整合到同一介面,支援分鏡重跑、跨鏡頭連貫與即時預覽,讓多片段 AI 影片製作不再被節點海淹沒。

MiniMax H3 Motion Director — Mixed Mode

用 ComfyUI 砌 AI 影片嘅朋友,多數都經歷過呢個困局:想做一個有五個鏡頭嘅項目,要由零開始接 T2V、I2V、V2V 各種 workflow,每段調好參數再串埋,節點一多就連自己都搞唔清邊段行緊、邊段要重做。Motion Director 想處理嘅就係呢個問題——佢係一個 ComfyUI 自訂節點,把多段影片生成收納到同一個 Director 介面,等你可以逐段揀唔同生成方法(T2V / I2V / FL2V / R2V / V2V / RV2V),又唔使為咗切換而重新拉整個圖。

佢同一般 ComfyUI 工作流最大嘅分別,係圍繞「項目」做設計。Director 介面入面有 Segment、Multi Segment、Final Result 三層檢視,亦有 Director Live Preview 即時顯示邊段行緊、邊段做完。跨段連貫靠 Motion Context、Context Frames、Latent Scale Lock 同生成音訊接續,仲可以將上一段已解碼嘅幀直接當下一段嘅 I2V/FL2V 輸入,避免每次都重新生成首幀。素材方面提供 Common References 同持久化 Material Library,圖、音、影片、提示詞都可以重複用。

另一個貼地嘅設計係 Selective Run——只要揀要重做嘅片段就得,唔使成條 pipeline 重跑,配合 MIXED 模式用,可以幾段文生、幾段圖生、幾段源影片剪輯混埋做項目。Director 本身係 OUTPUT_NODE,最尾嗰格就可以輸出畫面、音訊同 FPS 畀下游 ComfyUI 節點繼續接。後製方面內置 Global Refine、放大、可揀 NVIDIA RTX VSR / Deblur 同 Face Refine,不過 VSR/Deblur 要相容 NVIDIA VFX runtime,Face Refine 要 UI 揀好對應 detector/SAM 路徑。

適合要處理多鏡頭、有分鏡表、要保持視覺同音訊一致嘅創作者,例如廣告原型、MV 概念、敘事短片預覽,或者要把源影片做局部 V2V/RV2V 修補嘅後期流程。生成方面支援內建 sampling 或外部 ComfyUI SAMPLER + SIGMAS,方便想自己控制 noise schedule 嘅人。版本去到 v1.2.0,採用 GPL-3.0;硬件門檻就睇你揀嘅功能——基本生成跟返 ComfyUI 一般配置,想用 VSR/Deblur 或大尺寸放大就要 NVIDIA 顯卡同對應 runtime。

重點摘要:

  • 多段整合 Director 介面:T2V/I2V/FL2V/R2V/V2V/RV2V 同一畫面揀,逐段切換唔使重拉 workflow
  • Selective Run + Mixed Mode:只重跑指定片段,唔使成條 pipeline 由頭嚟
  • 跨鏡頭連貫:Motion Context、Context Frames、Latent Scale Lock 同音訊接續,仲可以重用上一段解碼幀
  • 內建 Live Preview 與三層檢視:Director 介面直接睇 Segment/Multi Segment/Final Result
  • 後製選項齊全:Global Refine、放大、可選 RTX VSR/Deblur 與 Face Refine,對硬件有特定要求

GitHub

Categories: 開源, ComfyUI, AI productions, NVIDIA, Video, 框架, 庫, MiniMax

ComfyUI-CGlide:MiniMax H3 短片創作者的自訂節點

這是一套給 ComfyUI 用的 MiniMax H3 影片生成自訂節點,把提示詞拼裝、即時預覽、寫檔與續接四步壓成四個節點,特別適合用 H3 拍短片的人。

Repository image for CGlide/ComfyUI-CGlide

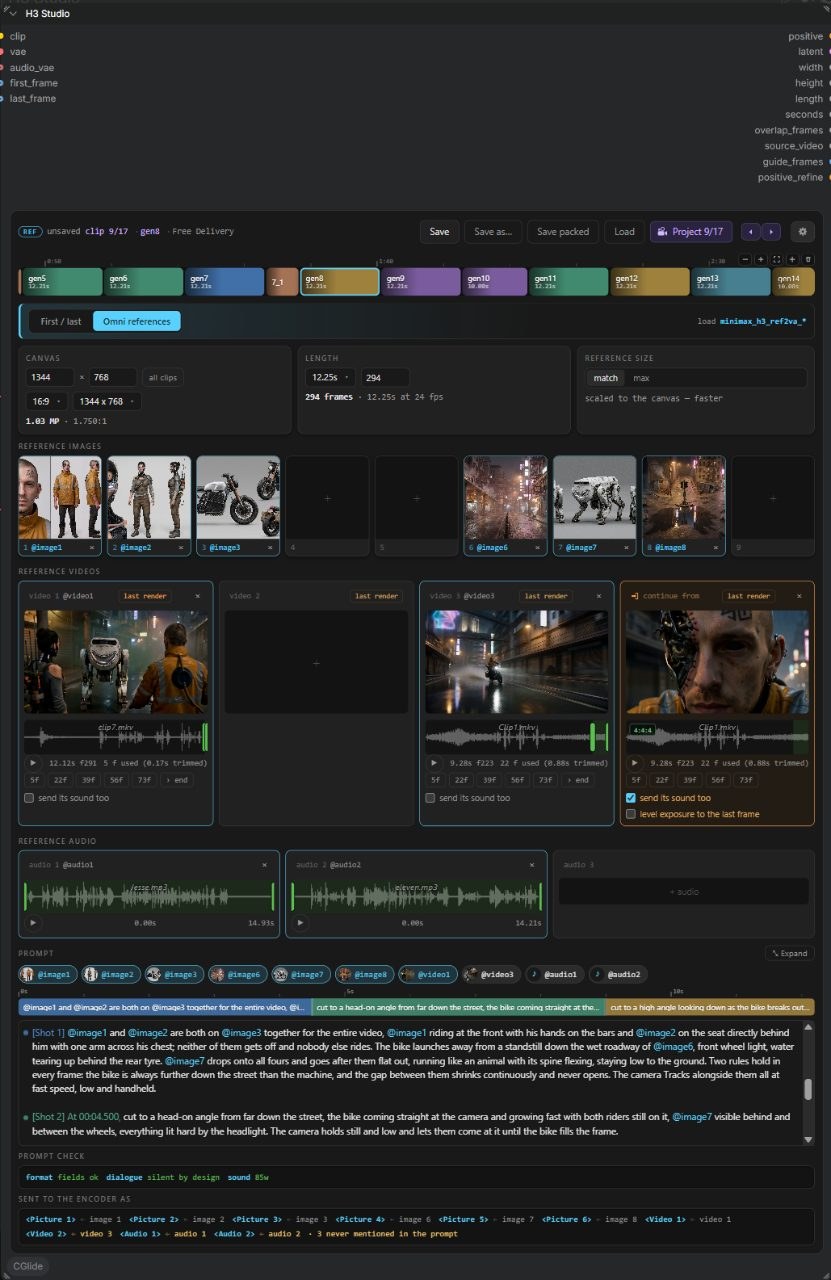
想做 H3 短片但不想在 ComfyUI 裡堆十幾個 loaders 同 text box 嘅人,可以留意 CGlide 嘅呢套自訂節點。佢將成個 H3 影片生成流程拆成四個節點:拼裝 prompt 同 conditioning、邊取樣邊預覽當下鏡頭、寫出影片檔,以及將續寫片段接返去原本嘅 clip。H3 Studio 更加將九張圖、三段影片、三段聲音同 prompt 全部塞入一個面板,但保留原本嘅 sampler 同步數,唔會插手推 sampling。

安裝好簡單,喺 ComfyUI Manager 搵 CGlide 或者 git clone 入 custom_nodes就得,不過官方提醒 ComfyUI 一定要更新,因為低 VRAM 嘅 w4a8 路徑要 0.31.0 或以上,否則會出黑畫面有聲冇畫,唔彈 error。模型要從 Comfy-Org 嘅 MiniMax H3 repo 拎,reference-to-video 或 first-last-frame checkpoint 入 diffusion_models,text encoder 入 text_encoders,影片同音訊 VAE 就擺去 vae。VRAM 唔夠嘅話可以用 Kijai 嘅 w4a8 版同 int8_convrot video VAE,大約 11.8 GB 就推到,原 workflow 唔使改。

H3 Studio: prompts, projects and clip extension for MiniMax H3

呢套節點嘅 chain 機制用 source_video 同 guide_frames 兩個輸出做接駁,比較啱做有連貫性嘅敘事短片,作者就用呢套工具完成咗 THE RECITATION。PyAV、torchaudio 同 ffmpeg 屬於依賴項目,PyAV 多數已經裝好,ffmpeg 放上 PATH 就夠,Glide Video 內部會 shell out 畀佢用。

對習慣 ComfyUI 節點工作流、又想用 H3 拍短片或敘事片段嘅創作者嚟講,呢套節點減少咗重複接線嘅時間,亦令低顯存方案更易落地。

重點摘要:
– 四節點設計:拼 prompt、即時預覽、寫檔、續接,分工清晰。
– H3 Studio 整合面板:九圖三影片三音訊同 prompt 集中管理,但唔干預 sampling。
– 低 VRAM 路徑:w4a8 加 int8_convrot VAE 約 11.8 GB,但要 ComfyUI 0.31.0 以上。
– chain 輸出:source_video 同 guide_frames 支援敘事鏡頭接駁。
– 作者實戰驗證:用同一套工具完成短片 THE RECITATION。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, Video, Audio, 提示詞, 工具, Content Creator, Clone, MiniMax

SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

FastH3 Live:單張消費級 GPU 跑出無限 AI 直播

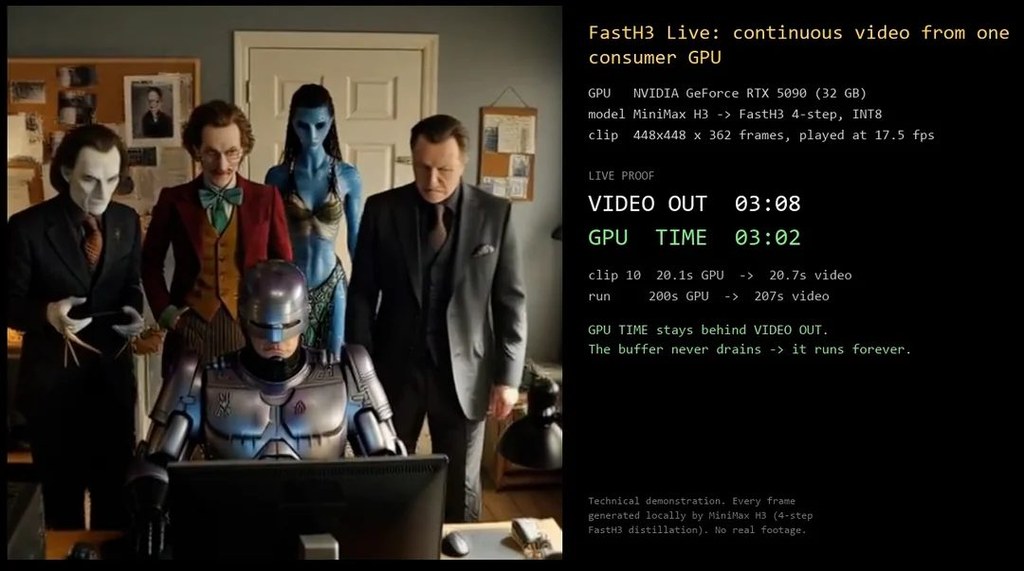
FastH3 Live 將 MiniMax-H3 蒸餾成 4 步模型,配合重定時與 ComfyUI 串流伺服器,用一張 RTX 5090 就能長開 448×448 18fps 嘅無限影片加音訊直播。

Hero image preview

喺消費級硬件上長開一段無止境嘅 AI 影片頻道,一直係文字轉視頻工作流嘅痛點——雲端成本高、本地生成速度慢,仲要面對提示詞同角色一致性嘅限制。FastH3 Live 就係圍繞呢個矛盾設計:佢將 MiniMax-H3 經過 4 步 DMD2 蒸餾成 FastH3,配合一套本地串流伺服器,令生成同播放可以同步進行,前一段影片播放期間,模型已經喺度產出下一段。

整個項目以 ComfyUI 作為運行環境,並喺單張 RTX 5090(32GB、Windows 11)上完成測試。v1.1.0 版本將解析度提升至 448×448、幀率達到 18fps,相比 v1.0.0 嘅 512×288 12fps 有明顯進步。音訊部分亦同步串流,用戶只要用 VLC 指向本地 URL,就可以一直接收新嘅短片,支援多位觀眾同時連線同斷線重連。

對於內容創作者、ComfyUI 用戶或者想試文字轉視頻嘅人來說,呢套工具最直接嘅吸引力係「無限直播」呢個使用場景。項目內附 321 個場景提示詞、503 個已驗證可用嘅角色清單,使用時可以快速組合出唔同長度嘅段落,唔需要每次由零開始寫 prompt。

需要注意嘅限制亦都幾清楚:相關權重屬於 MiniMax-H3 社群授權,適用範圍排除歐盟、英國、韓國同美國,下載前需要確認所在地。

項目主頁 · 數據集

Categories: 開源, ComfyUI, Agentic, 視頻模型, Video, Dataset 數據集, MiniMax

H3-World 讓鍵盤控制生成影片世界

H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, NVIDIA, Video, Python, MiniMax

H3 分鏡技能:分鏡及表情提示

這個 Claude Code 技能把腳本拆成 MiniMax H3 可渲染嘅分鏡,主打情緒表演真正落到畫面。佢直接指出:同一格塞太多表情指令,H3 會靜靜丟棄。

Repository image for phileiny/h3-storyboard-skill

用 H3 做有情緒起伏嘅影片,最容易撞牆嘅位通常唔係 prompt 寫得唔夠仔細,而係你貪心將太多表情塞落同一格。呢個 Claude Code 技能就係針對呢個盲點:佢唔止幫你格式化 H3 嘅 prompt schema,仲會教你點樣拆鏡頭、每格留幾多 beat、點樣導演一張臉。

核心發現來自一個對照實驗。同一個 shock beat、三次跑、同一粒 seed、同一批 reference 圖,只改動鏡頭結構:A 方案係一格 7 秒 close-up 塞 9 個表情指令,結果臉完全唔郁,PSNR 高達 37–42 dB,即係畫面接近凍結;B 方案拆成三格 2–3 秒、每格一個 beat,PSNR 跌到 22–23 dB,所有 beat 都落到;C 方案喺 B 基礎加返 <d> 對白標記,PSNR 再降到 19 dB,但代價係鏡頭時間被 H3 重新分配,背景角色連門一齊被裁走。結論好直接:開工前先數 beat,超過兩三個就要拆鏡頭。

另一個值得留意嘅細節係「唔好寫乜都唔變」。H3 對靜態描述容易洩漏到成個鏡頭,想表達 pause 就交俾剪接手。尺寸同距離方面,佢建議用相對關係(畫面三分二高、離底部一手寬)而唔係絕對數字,否則渲染出嚟會走樣。形狀就靠 reference 圖頂住,純文字三次都搞唔掂一個 1.75:1 嘅窗框。

需要用 H3 拍敘事短片、廣告 storyboard、或者任何要精準控制表情嘅創作者。比起坊間只做翻譯嘅 H3 技能,呢個項目多走一步:佢承認有啲規則只係推論(effect 係真實嘅,cause 仍未隔離),全部齊齊整整列喺 SOURCES.md 分做 verified、partly verified、inferred。

  • 屬於工具類 Claude Code 技能,解決 H3 prompt 表情指令被靜默丟棄嘅問題
  • 對照實驗證明分鏡頭係恢復情緒表現嘅關鍵機制
  • 對白標記唔會令臉郁,只會改變 H3 對鏡頭時間嘅分配
  • 距離用相對關係、形狀靠 reference 圖,純文字描述容易失效
  • SOURCES.md 將規則分三級誠實標註,邊個有控制實驗支持一目了然

GitHub

Categories: 開源, ComfyUI, Anthropic, MiniMax, Skill 技能

Page 4 of 7
1 2 3 4 5 6 7