MOSS Image Edit:一句指令改圖兼支援四圖參考

把人物改成指定穿搭、表情或場景,MOSS Image Edit 透過 LoRA 串連文字與參考圖,並在 ComfyUI 重用參考資訊。

MOSS Image Edit — 用文字编辑图像

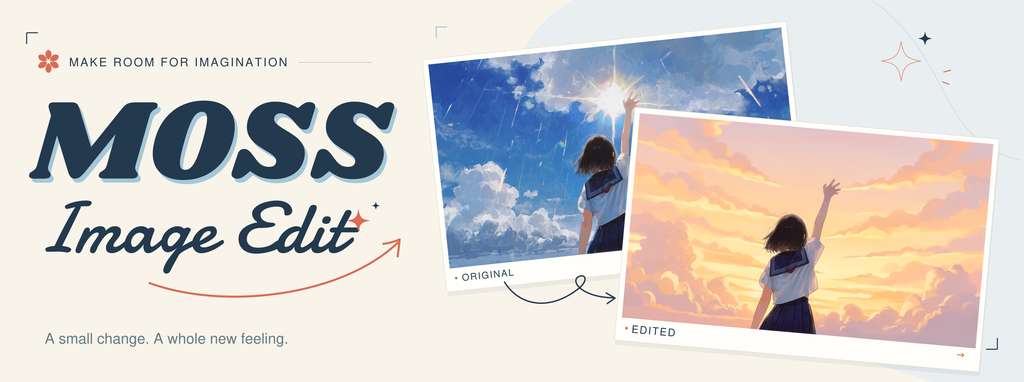
要替相片換衫、改正面表情,或將人物移到另一個場景,不一定要由人手逐項遮罩修改。MOSS Image Edit 是一個面向 MOSS-Image 的圖像編輯 LoRA,接收原圖、自然語言指令及最多四張參考圖,負責把服飾、顏色、光照、季節和畫風等要求轉成編輯結果。

發布內容只有 LoRA 權重及配置,必須配搭 MOSS-Image-Base 或 MOSS-Image-SFT,兩者擇一即可。團隊另備獨立 ComfyUI 節點與單圖、多圖工作流;下載底模和 LoRA、按指南擺放模型,再把工作流拖入 ComfyUI 即可測試,亦可調整輸出尺寸、隨機種子和採樣參數。

多圖模式不是單純追加條件:參考圖之間可互相參照,文字與目標圖則可讀取全部資訊,並要在指令內交代每張圖的用途。適合合併人物、服飾及場景參考,但最多四張圖的限制,也意味著複雜構圖仍需反覆測試提示詞與配置。

架構以 text、ref、target 三類 token 組成共享 MOSS Transformer;參考圖固定在無噪聲時間,文字及目標圖則隨去噪時間變化。參考分支只計算一次並快取各層 K/V,之後逐步重用,CFG 的正、負條件亦可共用同一份快取,減少重複運算。

  • 支援單圖指令式編輯
  • 最多連接四張參考圖
  • 可配搭 Base 或 SFT 底模
  • 提供 ComfyUI 單圖及多圖工作流
  • 沒有公開量化評測或推論供應商整合資料

內容團隊、做商品視覺或社交媒體配圖的人,會較容易感受到其價值。它目前更像是 MOSS-Image 生態中的可調編輯模組,而非一開即用的獨立模型;正式採用前仍應以自身相片、指令及輸出尺寸測試一致性、資源需求與授權條件。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, Image, 影像處理, 提示詞, LoRA

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

CrossTimeEdit-release:用衛星變化還原歷史街景,補回城市記憶

CrossTimeEdit 把歷史街景生成改成有證據約束的影像編輯,利用新舊街景與衛星變化重建城市過去面貌。

CrossTimeEdit teaser

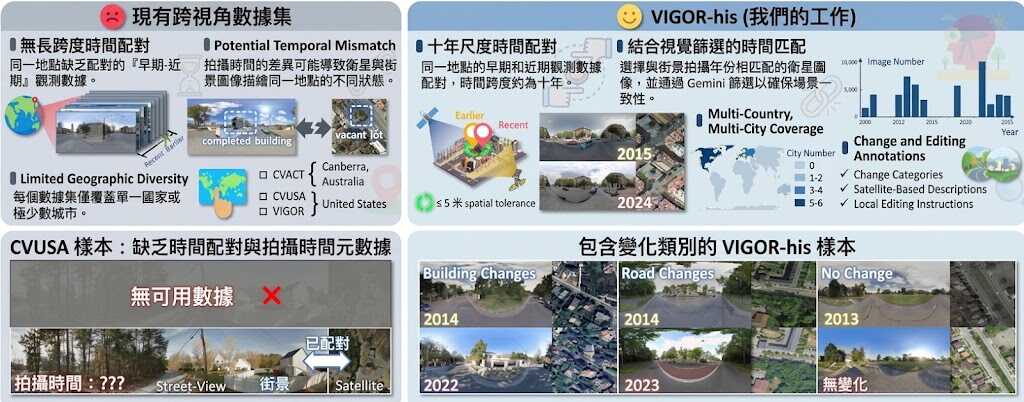
街景資料未必記錄到城市每次改建,CrossTimeEdit 便把近期街景、不同時期的衛星影像和跨視角資訊結合,推算較早期的街道外觀。這個項目屬於視覺生成模型及跨視角資料集,實際處理的是在保留未改變背景的同時,重建建築、道路或其他城市元素的歷史變化。

核心資料集 VIGOR-his 收錄來自三大洲 11 個城市的 43,653 組位置級四元組,配對早期與近期街景、衛星影像,並加入變化分類、衛星變化描述及局部編輯指令。模型以近期街景固定視角和場景內容,再把不同時期的衛星差異當成變化證據,較單純依賴文字提示的生成方式更適合處理具地理關聯的重建工作。

CrossTimeEdit 以 FLUX.2 [Klein] 4B 為起點,先進行 Supervised Fine-Tuning (SFT),再以 Online Reinforcement Learning (RL) 優化。訓練獎勵同時考慮 Instruction Alignment (IA)、Background Preservation (BP) 及 Quality and Physical Plausibility (QP),並透過 Flow-GRPO 與 GDPO 在不同獎勵維度之間作平衡,減少只追求畫面逼真而破壞場景一致性的取捨。

  • VIGOR-his 提供約十年跨度的跨視角城市資料
  • 模型同時保留未變背景及重建指定變化
  • 評估涵蓋指令符合度、背景保留和物理合理性
  • 整體三項編輯指標較預訓練基線提升 17.12%
  • 相比跨視角生成模型,在場景一致性、視覺真實感及感知質素上更佳

城市歷史研究、地理資訊分析、舊城改建記錄和地圖內容補全都可能受益於這套方法,但生成結果仍屬推算,不能取代真實歷史影像。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Stable Diffusion, Image, 庫, LoRA, 強化學習

Fold2Reason 讓語言模型學懂蛋白質結構

Fold2Reason 把蛋白質結構監督加入語言模型訓練,嘗試兼顧一般推理與三維結構讀取。

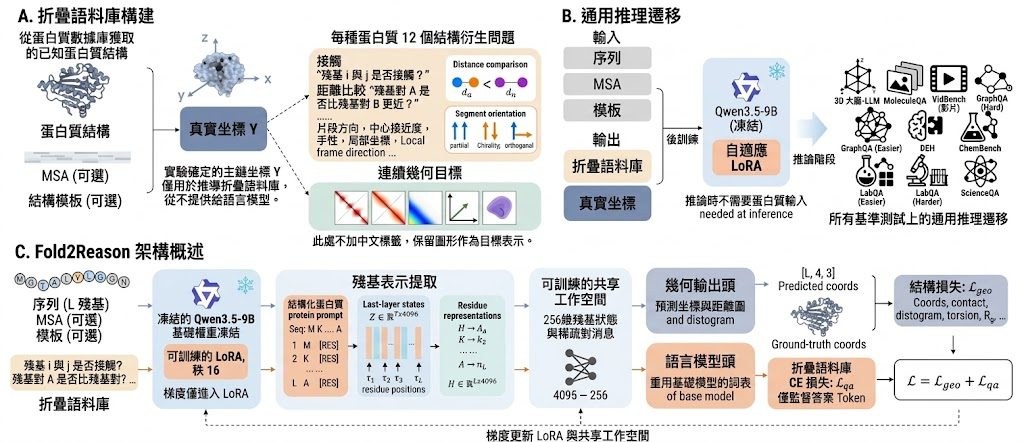
Fold2Reason diagram showing FoldingCorpus construction, general reasoning transfer, and the model architecture

要讓語言模型處理蛋白質問題,難點不只在文字理解,還包括如何保存三維空間關係。Fold2Reason 屬於模型訓練與研究型開源項目,透過 FoldingCorpus 監督資料、共享 spatial workspace 和凍結的 geometry decoder,處理語言模型推理與蛋白質結構讀取之間的銜接。

項目以 Qwen3.5 為主要訓練及評估流程,適合研究人員比較蛋白質結構後訓練對一般能力的影響。結構輸出不直接由語言模型單獨完成,而是交由 workspace 配合 decoder 讀取;一般推理則以適配後的語言模型評估,兩條結果路徑有清楚分工。

相較於只用 FoldingCorpus 訓練的 Pure-LoRA baseline,Fold2Reason 額外引入共享空間表示和凍結幾何解碼器,換來較完整的結構處理流程,同時增加資料、權重與硬件要求。項目提供確定性資料準備、LoRA/workspace checkpoint、已訓練 checkpoint 評估,以及重新訓練所需的管線。

  • 需要 Python 3.12、CUDA 相容的 PyTorch,以及指定版本的 Transformers 和 PEFT
  • dataset.zip 另行提供訓練資料、凍結 decoder 和三組 checkpoint
  • 可評估已發布 checkpoint,亦可重新進行 Qwen3.5 訓練
  • General-10 分數聚合器用於整理一般推理結果
  • 各基準測試相對基礎模型的增益,但未在提供內容列出完整數值

適合研究團隊、蛋白質 AI 模型後訓練及多模態空間表示方向的開發者。它未必適合只想快速調用蛋白質預測功能的使用者。但作為比較 LoRA、空間 workspace 與凍結幾何 decoder 的可重現實驗基礎,項目提供了比單一模型權重更完整的驗證路徑。

GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Medical醫學, 3D, Python, Dataset 數據集, LoRA

DMAD:MiniMax-H3 影片生成壓縮至四步

DMAD 將 MiniMax-H3 的 50 步生成流程壓縮至 4 步,兼顧 1344×768 影片與原生立體聲音輸出。

Videos generated by the 4-step DMAD student of MiniMax-H3 (video only; every clip also has generated audio)

由 50 步縮至 4 步,DMAD 讓 MiniMax-H3-33B 可以更快完成文字轉音訊影片生成,同時保留 1344×768 影片及原生立體聲音。這項目屬於模型蒸餾與推理工具,實際處理的是高質素生成與推理速度之間的取捨。

項目提供兩個 rank 128 的 LoRA,每個約 1.4GB,分別是論文使用的 lora critic,以及在 AVGen-Bench 取得較高分數的 full critic。它們都掛載於 H3 transformer,將 50 步 teacher 轉成四步 student;DMAD 以兩個 discriminator head 分辨真實資料、teacher 樣本與 student 樣本,直接學習 log-density ratio,省卻 DMD 所需的輔助 diffusion model。

  • 4 步生成 1344×768 影片及立體聲音
  • 提供 lora critic 與 full critic 兩個版本
  • 支援獨立推理程式及 Diffusers pipeline
  • 方法以 adversarial distillation 取代額外 score fitting

MiniMax-H3 與 rCM 的人類偏好比較為 84.6%,但 AVGen-Bench 只明確指出 full critic 分數較高,未提供具體差距;選擇模型時仍應按畫面質素、聲畫同步及硬件成本自行測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, MiniMax, LoRA

AcademiaSD LoRAlab Trainer Studio:訓練影像與影片 LoRA

把多個模型的 LoRA 訓練流程集中到一個介面,支持消費級 NVIDIA 8G 顯卡。

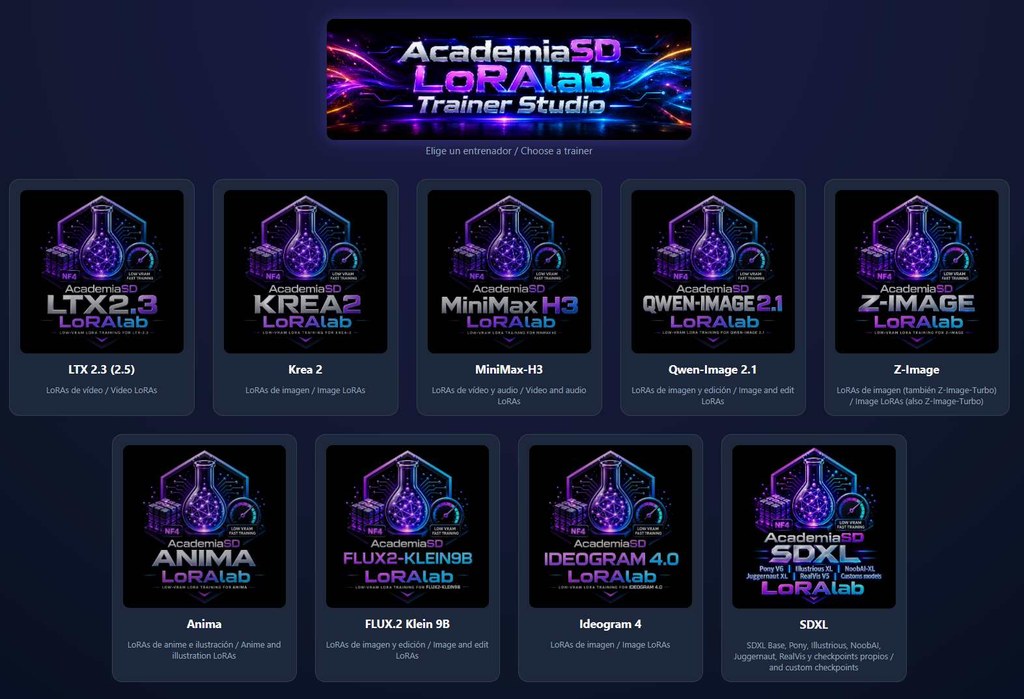
AcademiaSD LoRAlab Trainer Studio

想為角色、物件或畫風訓練 Low-Rank Adaptation(LoRA),不一定要準備高階顯卡;AcademiaSD LoRAlab Trainer Studio 是一套 LoRA 訓練工具,目標是在最低 8 GB VRAM 的消費級 NVIDIA GPU 上處理最新影像及影片模型,並把不同 trainer 收進同一個 Web 介面。

每個模型會以 4-bit NF4 載入,文字編碼器與 VAE 只在 pre-cache 階段執行一次,之後把 GPU 資源集中到訓練。項目支援 Windows 10、Windows 11 及 Linux,使用 Python 3.13、PyTorch 2.14 cu130,以及 Flask + HTML5 介面;同一套安裝環境可加入後續新增的 trainer,毋須為每個模型另建環境。

工作流程包括資料集管理、自動 caption、即時預覽、精確步數續訓及一鍵匯出至 ComfyUI。訓練期間可以修改 steps、儲存及預覽頻率、預覽設定和 learning rate,按下 Save JSON 後,變更會在下一步生效;每個項目亦會分開保存 pre-cache、checkpoint、預覽圖及 LoRA 輸出,刪除快取或訓練內容不會碰到資料集。

  • 匯出的 LoRA 帶有 kohya-style metadata,包含 trigger word、rank、steps 和 resolution
  • CivitAI 及 LoRA managers 可以讀取相關 metadata
  • 一般角色、物件和風格 LoRA 可採用一張圖片配一段 caption
  • 可從同一網絡的其他裝置上載資料集及下載 LoRA

這套工具較適合想在本機反覆試驗、又不想手動管理多個訓練環境的創作者和小型團隊。預覽圖只用來追蹤訓練進度及角色、物件或風格的相似度,不能直接當成最終品質;完成後仍要在 ComfyUI 或 Forge 調整 LoRA 強度及模型品質設定。由於多個模型支援接近同時加入,README 亦明確提醒可能存在錯誤、未完善設定,以及預設訓練參數未必適合每個資料集,使用者需要自行測試並透過 Issues 回報結果。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 工具, Content Creator, Linux, Python, Win, LoRA

ComfyUI-Omnichar:用 .char 讓角色跨模型保持一致

ComfyUI-Omnichar 把角色參考圖、描述和 LoRA 收進同一個 .char,方便在圖像與影片模型之間保持人物連貫。

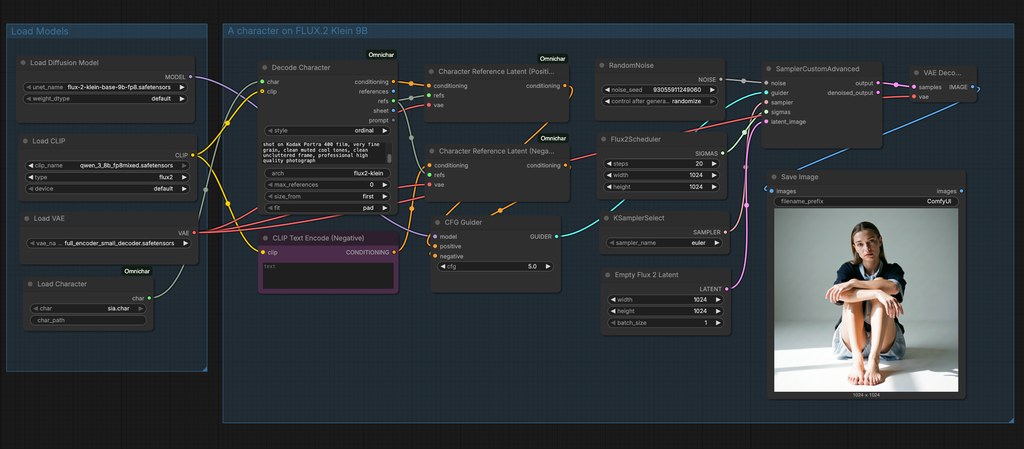
Omnichar nodes in a ComfyUI graph

同一角色要跨圖像與影片模型維持相同面孔、服裝和身形,ComfyUI-Omnichar 以可攜式 .char 檔案處理這個問題。它屬於 ComfyUI 自訂節點工具,讓角色資料不必隨每個工作流程重新整理。

.char 可保存參考圖、鎖定描述,以及可選的訓練 LoRA;檔案可以由 Omnichar Studio、Omnichar Cloud 或 Encode Character 建立,再交給 FLUX.2、MiniMax H3、Krea2、klein9B 及 klein4B 使用。相較於每次手動接入參考圖,這種方式把角色資料、圖片順序和提示詞編號固定下來,代價是工作流程需要配合支援 references 的模型。

  • 透過 Load Character 讀取 .char 檔案
  • Encode Character 可分別加入 face、body 和 cloths 參考圖
  • Decode Character 可輸出 conditioning、references 和 prompt
  • 角色附有 LoRA 時,可同時套用至 MODEL 和 CLIP

安裝需要 ComfyUI、Python 3.10+ 和 omnichar-sdk;.char 檔案放入 ComfyUI/models/characters/ 後,便可由載入節點選取。需要共用 Omnichar Studio 資料夾時,也可設定 INLINE_CHARACTERS_DIR,讓兩邊讀取同一批角色檔案。

生成結果仍會受所選模型、參考圖質素和 GPU 資源影響。對需要製作連續角色插畫、分鏡、短片或多模型內容的創作者,.char 的集中管理會比散落在不同 workflow 的參考圖更容易維護;偏好完全手動控制的人,則未必需要加入這層封裝。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, 模型訓練, Stable Diffusion, API, Video, Image, 提示詞, 工具, Content Creator, Python, MiniMax, LoRA

NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

ComfyUI-MiniMaxH3Mod:可重用參考模組

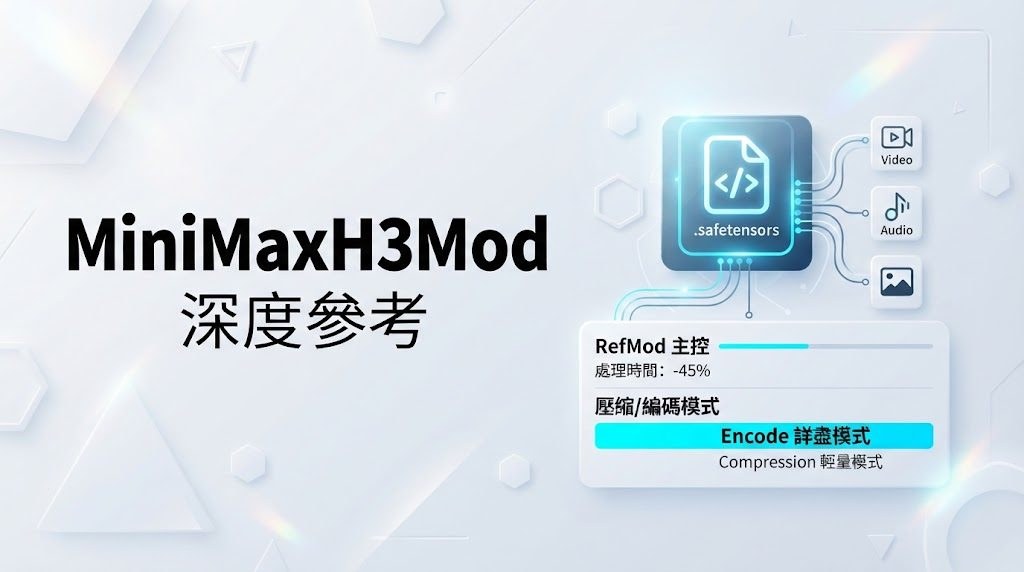
你可以把它理解成 MiniMax H3 的參考素材管理層,把圖像、影片和聲音整理成可重用的 RefMod。

ko-fi

想在 ComfyUI 的 MiniMax H3 工作流中重用同一組人物、場景或聲音參考,不必每次重新編碼原素材。ComfyUI-MiniMaxH3Mod 是一個開源 custom node 項目,處理 RefMod 的建立、儲存、載入、組合及套用,讓圖像、影片和音訊參考可以保存成 .safetensors,再交給 Apply H3 RefMod 使用。它不會訓練 H3 權重,也不是 LoRA 或監督式概念學習工具,而是接入 H3 原生 reference-token 路徑的儲存與選擇層。

使用時需要將項目放入 custom_nodes 後重新啟動,並把標準 H3 video VAE、audio VAE 及原生 CONDITIONING 接到相應節點。項目已提供 Create H3 RefMod、Create H3 RefMod Master、Load H3 RefMods、Apply H3 RefMod 等節點;Master 可以一次處理視覺和音訊,save=False 則可只產生記憶體中的 bundle,不寫入檔案。ComfyUI Manager 可處理 safetensors、numpy 和 Pillow 等 Python 依賴,影片資料夾載入則可按需要加入 opencv-python 或 imageio。

  • 支援圖像、影片、音訊 RefMod,並可在同一個 .safetensors bundle 儲存視覺與聲音。
  • encode 保留較多細節但消耗更多 reference tokens;training 先壓縮 latent,降低 token 成本,亦可能損失細節和動態。
  • Collect H3 RefMod Masks 可處理不同尺寸的 MASK,並按對應參考素材保留尺寸;上游裁走的像素則無法恢復。
  • Full Reference video sampling 會先決定因果 frame 數,避免 16 等限制直接截掉影片尾段。
  • Loader 和 Axis 採用按需增加的參考槽位,並可分開選擇 All、Visual 或 Audio。

它和單純把素材放在工作流內的做法不同,RefMod 會把編碼結果保存下來,之後重用時可避免重複處理來源檔案。壓縮模式適合控制 token 和生成成本,完整 encode 則較適合作為身份或細節比較的基線;兩者都不能保證只轉移指定屬性,身份、服裝、背景和構圖仍可能互相混合。項目支援最多八個參考槽位、子資料夾、外置磁碟及 extra_model_paths.yaml 登記的 RefMod 根目錄,Library 和 Config 亦能搜尋及檢視已保存內容。

可調整的 max_tokens、frame limit、視覺 budget policy 和 Refinement Steps,令項目較適合需要反覆測試參考組合的創作者、ComfyUI 工作流作者,以及要管理大量人物或場景素材的團隊。truncate 會削減畫面內容以符合 token 預算,error 則在超出預算時停止保存;這些選擇直接影響細節保留和工作流是否繼續。項目目前沒有提供可與原生完整 reference workflow 對齊的正式基準測試,Windows 是原先測試環境,Apple Silicon 只覆蓋部分預處理和 H3 VAE 檢查。

音訊支援仍是最大限制。項目可以保存及混合視覺、音訊參考,亦曾成功處理音樂參考,但目前測試未能完成 speaker-identity transfer,因此不能當作已驗證的 voice cloning 解決方案;它亦不會自動修正影音同步。API 和 node schema 仍在演變,節點名稱及輸入欄位可能隨版本調整,適合接受工作流需要維護、並願意自行測試參考強度與 token 取捨的使用者。

GitHub
Categories: 開源, ComfyUI, AI productions, 模型訓練, API, Video, Image, 影像處理, Audio, 工具, Content Creator, Clone, 庫, 語音, 音樂, 蘋果, MiniMax, LoRA

Page 2 of 3
1 2 3