MiniMax-H3 Orbit LoRA 360° Bullet Time 環繞鏡頭

一張相片配合同一張首尾關鍵幀,鏡頭可繞主體 360°移動,場景保持凝固並回到原始畫面。

Og image

想把靜態相片製成可循環播放的環繞鏡頭(Bullet Time),MiniMax-H3 360° Orbit LoRA 針對的正是首尾畫面難以對齊、場景容易變形的問題。它是基於 MiniMaxAI/MiniMax-H3、FL2VA variant 的 LoRA adapter,配合同一張圖片作為 first frame 與 last frame,令鏡頭完成連續 360°orbit,而人物和物件維持原本位置、姿勢及形狀。

模型的 instance prompt 明確要求只移動相機,利用 camera parallax 產生視覺變化;模型不應加入縮放、切鏡、變形或新物件。影片末端回到開始畫面,因此多段 orbit 可以串接,減少循環接點出現跳變。

  • 適合產品展示、人物定格、場景掃視,以及需要無縫循環的短片項目。
  • LoRA 屬於附加權重,不能單獨取代 MiniMax-H3;頁面未提供參數規模、上下文長度或訓練細節。
  • MTP draft speculation、v2 更新、檔名變更及 chat template 注意事項亦未有資料,不能據此推斷推論效能或資源需求。

結果比較採用相同 seed、prompt、解析度和 step count,但展示內容仍屬範例,未有量化的畫質、穩定性或速度指標。對需要精確幾何還原、長片一致性或非環繞運鏡的項目,頁面資料不足以證明效果。

模型

Categories: AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 3D, MiniMax, LoRA

一個 LoRA 同時做卡片自轉與 360 度環繞

MiniMax-H3 的 rank-32 LoRA可按提示詞切換卡片自轉與正常鏡頭環繞,適合製作具指定運鏡效果的短片。

Og image

相片會像按提示詞改為圍繞靜止主體作順時針 360 度運鏡。這個影像轉影片模型配接器基於 MiniMaxAI/MiniMax-H3,並針對 MiniMax-H3 Ref2VA 微調,屬於rank-32 LoRA,並非獨立的完整基礎模型。

模型以提示詞選擇兩種行為:ORB360_CARDSPIN 會讓畫面在5.125秒後準確回到原始相片;ORB360_CW 則維持一般順時針環繞效果。適合產品相片、人物肖像、寵物影像及需要固定鏡頭路徑的短片製作,同一個 LoRA 檔案可以因應不同鏡頭意圖重用。

頁面提供的示例使用單張參考圖,輸出尺寸為1024 x 768,共124幀,以20 steps 及指定 seed 生成。示例亦指出,加入卡片自轉能力後,原有的360度環繞效果仍能正常運作;不過頁面沒有提供系統化基準測試、失敗率、硬體需求或速度數據。

  • LoRA 權重為 rank-32,基於 MiniMax-H3 Ref2VA
  • 以ORB360_CARDSPIN及ORB360_CW切換兩種運鏡行為
  • 卡片自轉片段固定為5.125秒並回到起始畫面
  • 標籤列出 ComfyUI、musubi-tuner及camera-control等相關工具或方向
  • 頁面未提供GGUF檔案、量化版本、mmproj、上下文長度、v2更新或檔名變更資料

頁面展示了 MP4 示例及提示詞檔案,但沒有交代完整安裝流程、推論框架設定或MTP draft speculation支援。

模型

Categories: ComfyUI, AI productions, Video, Image, MiniMax, LoRA

FoMo 不用人手標註,讓影像更貼近感知

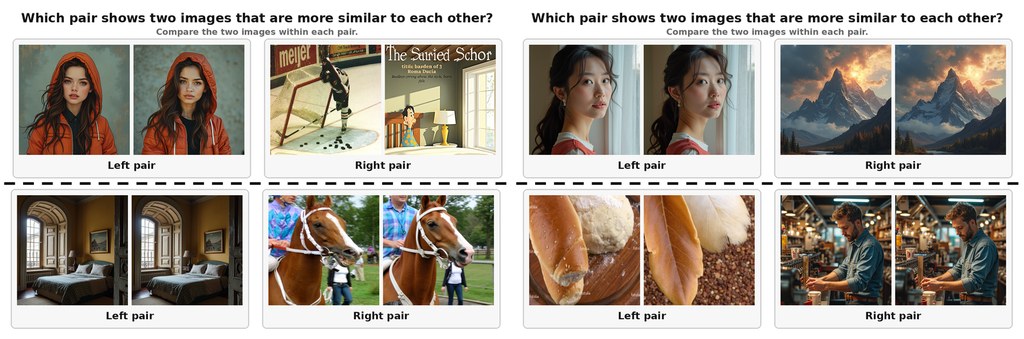
FoMo 借助 diffusion model 生成由淺入深的影像變體,免除大量人工標註,訓練出可比較兩張圖片感知差異的模型。

FoMo: data generation from the forking moment of the diffusion trajectory, and ranked-BCE training

比較原圖與修改版本時,像素差異未必等於人眼感受到的差異。FoMo 以 reference-based perceptual distance metrics(參考式感知距離模型)處理這個問題,透過 FLUX.1-dev 的 img2img 軌跡製造有次序的影像變體,並以此訓練影像品質評估(image quality assessment,IQA)模型,屬於開源模型項目。

它的關鍵做法,是在 diffusion model 的去噪流程中,於不同 denoising steps 重新接回生成軌跡。重新接入得越早,生成圖與原圖的感知偏離通常越大;這個 forking moment 便提供了密集而有排序的監督訊號。項目用 480k 組影像資料配合 pairwise ranking objective,減少依賴人手逐張標註的成本。

項目提供七個模式,涵蓋 LPIPS、DISTS、DreamSim,以及以 frozen DINOv3、CLIP、MAE backbone 配合 prediction head 的版本。DreamSim 透過 LoRA adapters 微調,而 dinov3、clip、mae 會把兩張圖片按次序讀入同一組 token;預設會計算兩個方向的平均分,處理輸出可能不對稱的問題。

  • lower score 代表兩張圖片更相似,raw 輸出也是公開評估採用的數值
  • output=’loss’ 可提供以 identity pair 為錨點的 perceptual loss
  • CNN 類模型使用固定 256px crop,DreamSim 使用固定 224px crop
  • DINOv3、CLIP、MAE 支援 64 至 256px 隨機裁剪,並以 zero-padding 和 attention masking 組批
  • 項目可透過 Python 套件 fomo-iqa 載入預訓練模型,直接比較參考圖與測試圖

FoMo 適合需要自動判斷生成圖片、編輯版本或重建結果相似程度的研究者與影像工具團隊。它的限制也很清楚:訓練訊號來自 FLUX.1-dev 的生成軌跡,不能直接等同人類偏好;不同 backbone 的輸出形式、裁剪策略與對稱處理亦會影響比較結果,因此應按工作流程選擇模型並自行驗證。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Image, 影像處理, 工具, LoRA

AV-GRPO 把音訊影片聯合模型訓練門檻壓到 8 張 A800

這個項目把 GRPO 強化學習帶進多模態模型,並透過「模態錨定解耦」大幅降低跨模態訊號干擾,連 LoRA 微調都能在 8 張 A800 上完成 22B 模型訓練。

Repository image for zhiyuxu03/AV-GRPO

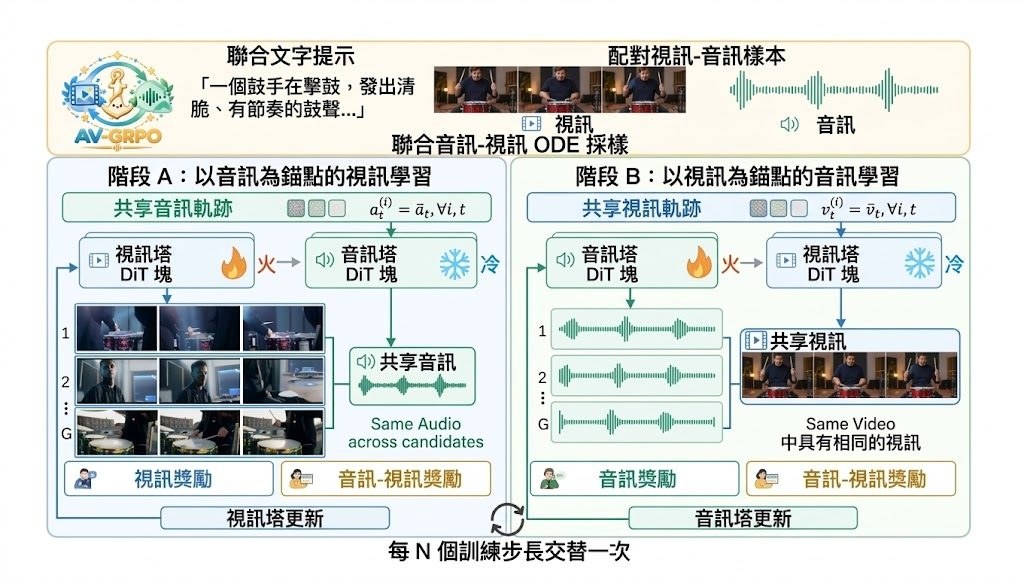
聯合音訊與影片生成一直有個麻煩:模型做出來的影像與聲音品質、文字對齊度、長度同步性常常此消彼長。AV-GRPO 直接把 GRPO 強化學習框架搬進 LTX-2.3 這類 22B 級的雙流模型,並用「模態錨定解耦」的方式,把音訊與影片兩路的學習訊號分開計算,避免強化學習的獎勵把兩個模態的功勞混在一起算不清。配套的 5DAV 數據集同樣沿五個維度拆解,方便精準控制訓練難度。

作者最在意的是算力門檻,這套框架支援全參數微調與 LoRA 微調兩種模式,只要 8 張 A800 就能跑得起來,並整合了模態錨定 rollout、凍結其中一路做軌跡鎖定優化、依模態特性調整擾動強度三個機制,把原本耦合的多模態偏好學習拆成條件式單模態子問題,使獎勵歸因與同步優化都更精準。

在 JavisBench 與 VABench 評測中,AV-GRPO 不論 LoRA 或全參數設定,於生成品質、語意對齊、跨模態同步三項都穩定超越 LTX-2.3 基準。對需要「一次到位」產出高同步影音的團隊、短片創作工具開發者、以及想在有限 GPU 資源下微調大型影音模型的實驗室,吸引力都很高。

重點摘要:

  • 首個針對音訊影片聯合生成設計的 GRPO 框架,解決強化學習獎勵訊號在異質模態間糾纏的問題。
  • 模態錨定解耦讓影片與音訊各自計算 rollout 與獎勵,顯著改善獎勵歸因。
  • 22B 模型在 8 張 A800 上支援 LoRA 或全參數微調,大幅降低硬體門檻。
  • 5DAV 數據集沿五個維度解耦,方便調節難度與做消融實驗。
  • JavisBench 與 VABench 結果顯示生成品質、文字對齊與跨模態同步全面優於 LTX-2.3。

官方尚未提供一鍵安裝或開箱即用的 inference 腳本,整合進 LTX-2 推論流程時仍需自行處理權重合併與路徑替換;對於想直接做線上服務的團隊,整合成本仍是主要取捨。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Audio, 框架, 香港, 工具, LTX, Dataset 數據集, LoRA

LTX-2.5 加入多圖與聲音參考控制

想令影片中的人物、物件和聲音更一致,這個 ComfyUI 擴充項目把多重參考整合到同一條工作流程。

Repository image for liconstudio/ComfyUI-LTX2.5-MSR

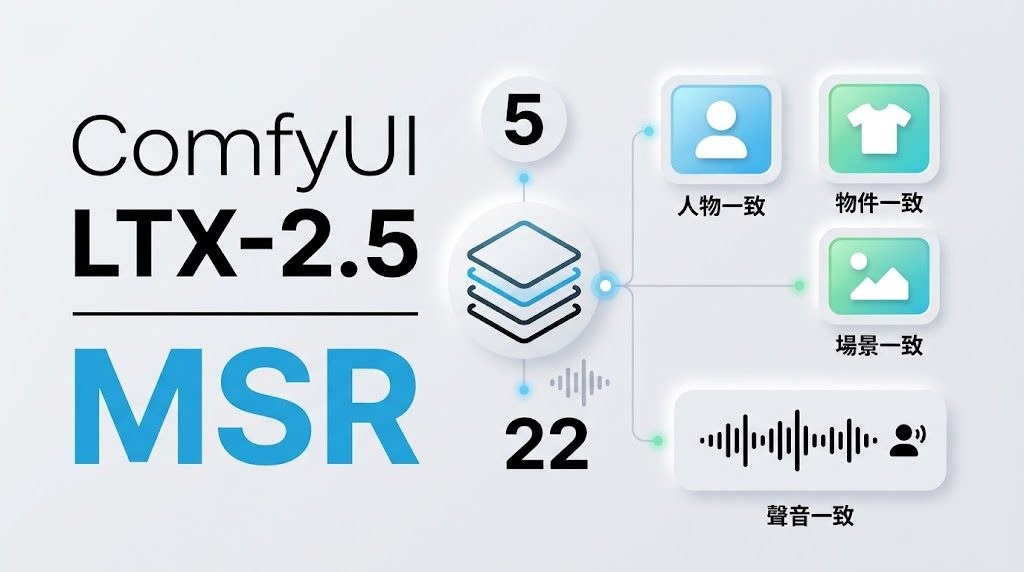
要在 LTX-2.5 生成影片時維持多個人物、物件或場景的連貫性,單靠文字提示往往不夠。ComfyUI-LTX2.5-MSR 是一個 ComfyUI 擴充工具,透過 MSR LoRA 把最多五張獨立編碼的參考圖片加入影片 latent;配合 AVref LoRA,還可為最多兩位說話者加入聲音參考。

它處理的不是普通圖片拼接,而是保留 MSR(Multiple Subject Reference)的訓練方式:每個參考影像都有 learned slot embedding,參考 token 會預先加入模型輸入,並配合固定排序及連續負時間位置,讓 LTX-2.5 的 self-attention 讀取人物、衣物、物件和場景資訊。參考圖片會自動調整大小、置中裁剪及以白色填補,亦支援 tiled VAE encoding。

v1.2.2 將圖片和聲音參考集中到同一個 LoRA loader 及 Reference Guide。兩個 audio latent 可分別配對 pic1 和 pic2;缺少某段聲音時,對應時間窗會保持空白,不會令後面的參考位置前移,並可選擇 25 或 33 幀的圖片參考長度。README 同時提供 V2 範例工作流程,展示加入聲音參考的兩階段 sampling 及 latent-upscale refinement。

使用前需要 LTX-2.5 原生模型、符合要求的 MSR 或 AVref LoRA,以及 ComfyUI 的模型、conditioning、latent、VAE、sampler 和 AV 節點。LoRA 必須包含 reference_slot_embedding 權重,普通 LoRA 會被拒絕;項目資料未提供完整安裝指令或硬件性能測試,因此生成速度、顯存需求及最終一致性仍要按本地模型、解析度和參考數量自行驗證。

  • 最多五張圖片參考,支援人物、物件、背景等不同角色
  • AVref LoRA 可加入最多兩位說話者的聲音參考
  • 稀疏 audio slots 保留絕對時間位置,不會重新排列後續參考
  • 適合單階段生成,也可接入兩階段 latent-upscale 工作流程

GitHub · 模型

Categories: 開源, ComfyUI, AI productions, Embedding, 模型, 模型訓練, Google, NVIDIA, Video, Image, Audio, 工具, 語音, LTX, 蘋果, LoRA

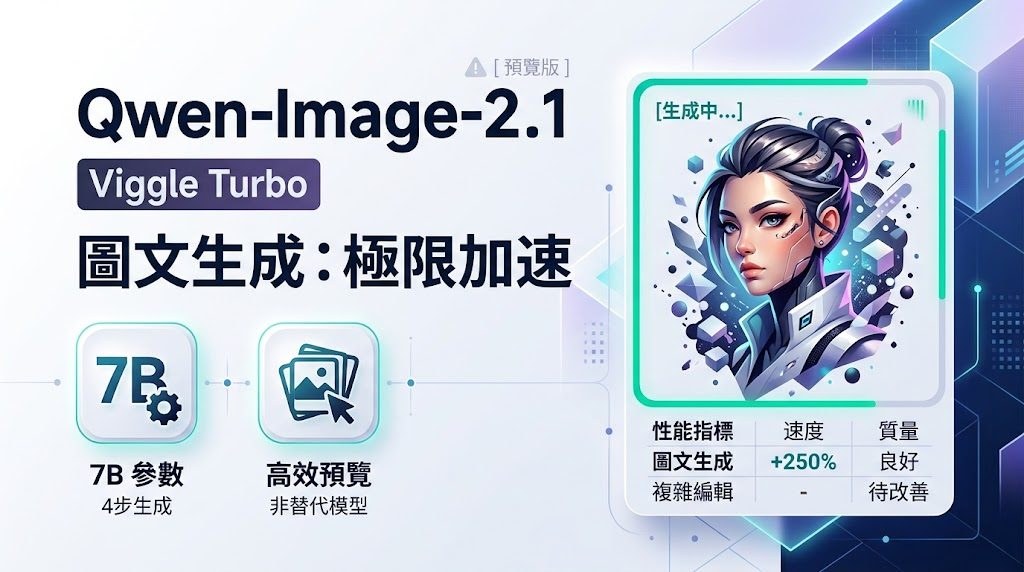
Qwen-Image 2.1 四步生成加速,但複雜編輯仍未完善

Viggle 將 Qwen-Image 2.1 蒸餾至四步生成,換來速度提升,同時保留編輯能力上的取捨。
Og image

面對需要較快出圖、又要按文字指示修改圖片的場景,Qwen-Image-2.1-viggle-turbo 把原始 Qwen/Qwen-Image-2.1 由 40 次 Transformer passes 壓縮至 4 次,支援 text-to-image 及 image-to-image 編輯,亦可配合 1 至 3 張參考圖。模型屬於基於 Qwen/Qwen-Image-2.1 的 adapter 項目,由 Viggle 使用 Distribution Matching Distillation(DMD)訓練,並取消 classifier-free guidance。

項目提供兩個學生模型,取捨集中在下載體積與編輯精準度:

  • transformer/:完整微調的 bf16 Transformer,約 14.2 GB,會取代基礎 Transformer;頁面目前推薦這個版本,質性比較中編輯更忠實。
  • Qwen-Image-2.1-viggle-turbo-4step-lora-r64.safetensors:rank 64、約 340 MB 的 LoRA adapter,載入基礎 Transformer 後運行,下載較快但效果稍弱。
  • peft/:同一 LoRA 的 PEFT key format、F32 權重;LoRA 不會合併入 Transformer,運行時載入可避免 bf16 合併造成的損失。
  • text encoder、VAE 及 processor 沒有隨項目重新發布,會從基礎模型儲存庫載入。

完整微調版本的 DMD objective 加入 low-frequency teacher anchor,兩個版本都是各自訓練流程的 step-400 EMA checkpoint。Text-to-image 在四步下已具可用性,但 v0.1 仍是 preview;多參考圖合成、換臉、保留身份,以及同時包含多項限制的指令,明顯不及原本 40 步的 base model,因此不能視為完整替代品。

因為 QwenImage21Pipeline 尚未納入已發布的 diffusers;同時要安裝 peft、PyTorch、Transformers、Accelerate、Safetensors 及 Pillow。提供內容沒有 GGUF 檔案、GGUF 檔案大小、量化級別、mmproj、上下文長度、Ollama、LM Studio 或 llama.cpp 支援資料,亦沒有 MTP draft speculation 或正式 benchmark 數字;硬件需求只能按完整 Transformer 約 14.2 GB bf16 權重另行規劃。

模型
Categories: Qwen, Image, 影像模型, 影像處理, txt2img, Python, 庫, Dataset 數據集, LoRA

ImIR 免提示詞處理六類影像修復,

ImIR 讓同一個影像修復模型自行判斷輸入問題,毋須提示詞或降級標籤,涵蓋六種常見修復工作。

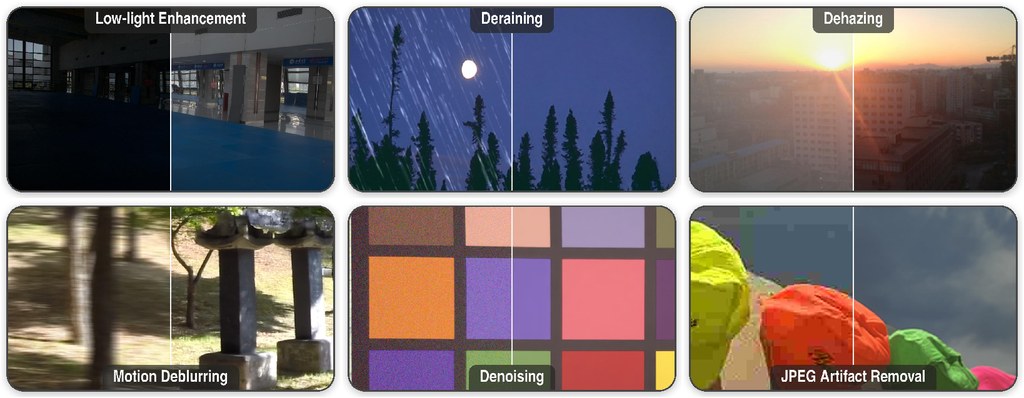
ImIR examples for low-light enhancement, deraining, dehazing, deblurring, denoising, and JPEG artifact removal. Each til

遇到低光、雨痕、霧化或 JPEG 壓縮痕跡時,ImIR 會只從輸入影像推算修復指令,不要求使用者先判斷問題類型。這個項目屬於影像修復模型與推理工具,實際處理的是一個模型難以同時應付多種退化、又依賴文字提示詞的工作流程。

ImIR 把影像分成兩條路徑送入 Qwen-Image-Edit-2511:VAE 保留空間結構,Qwen2.5-VL 配合輕量 token mapper 產生接近乾淨影像的語義指令;主幹模型保持凍結,只訓練一個共享 LoRA adapter。指令強度可以調節,低光增強等答案不唯一的任務,因而能在不同修復程度之間取捨。

項目提供 CLI 和 Python API,使用 Python 3.10 或更新版本、具 CUDA 能力的 NVIDIA GPU,並可從 Hugging Face 自動下載 checkpoint。顯存不足時可啟用 CPU offload,但需要足夠系統記憶體。

  • 一個 adapter 覆蓋除雨、低光增強、去霧、去模糊、去噪及 JPEG 瑕疵移除
  • 不需要文字提示詞,也不需要 degradation label
  • 單一 adapter 約三小時、以一張 GPU 完成訓練
  • 匹配比較中,影像指令優於文字 conditioning

對研究人員而言,這種做法適合測試 task-agnostic restoration;影像處理團隊則可用它簡化多任務推理流程。不過項目需要 NVIDIA CUDA 硬件。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, NVIDIA, Image, 影像模型, 影像處理, Python, LoRA

Page 3 of 3
1 2 3