街景資料未必記錄到城市每次改建,CrossTimeEdit 便把近期街景、不同時期的衛星影像和跨視角資訊結合,推算較早期的街道外觀。這個項目屬於視覺生成模型及跨視角資料集,實際處理的是在保留未改變背景的同時,重建建築、道路或其他城市元素的歷史變化。
核心資料集 VIGOR-his 收錄來自三大洲 11 個城市的 43,653 組位置級四元組,配對早期與近期街景、衛星影像,並加入變化分類、衛星變化描述及局部編輯指令。模型以近期街景固定視角和場景內容,再把不同時期的衛星差異當成變化證據,較單純依賴文字提示的生成方式更適合處理具地理關聯的重建工作。
CrossTimeEdit 以 FLUX.2 [Klein] 4B 為起點,先進行 Supervised Fine-Tuning (SFT),再以 Online Reinforcement Learning (RL) 優化。訓練獎勵同時考慮 Instruction Alignment (IA)、Background Preservation (BP) 及 Quality and Physical Plausibility (QP),並透過 Flow-GRPO 與 GDPO 在不同獎勵維度之間作平衡,減少只追求畫面逼真而破壞場景一致性的取捨。
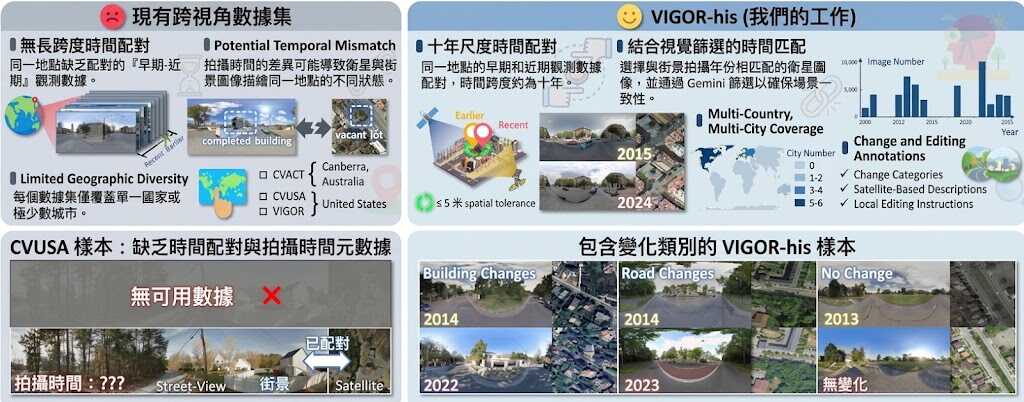
- VIGOR-his 提供約十年跨度的跨視角城市資料
- 模型同時保留未變背景及重建指定變化
- 評估涵蓋指令符合度、背景保留和物理合理性
- 整體三項編輯指標較預訓練基線提升 17.12%
- 相比跨視角生成模型,在場景一致性、視覺真實感及感知質素上更佳
城市歷史研究、地理資訊分析、舊城改建記錄和地圖內容補全都可能受益於這套方法,但生成結果仍屬推算,不能取代真實歷史影像。