Pika-H3-Flex:以圖片配合分段運鏡生成影片

用一張圖片配合分段指令安排鏡頭與聲音;示例展示創作方向,但未證明生成穩定性。

Og image

把人物與場景延伸成影片,Pika-H3-Flex 基於 MiniMaxAI/MiniMax-H3 提供 Image-to-Video 生成適配 Low-Rank Adaptation(LoRA)。

示例以乒乓球 15 秒時間軸指定俯拍、下降、快速搖鏡與環繞,亦要求人物一致及正常速度,並描述音效和音樂。這些是提示詞要求的測試結果。

Hugging Face 上的 Pika-Labs/Pika-H3-Flex 是開源權重(Open Weights)模型,核心功能完全可以免費本地下載與運行:

1. 本地/自建環境免費運行(不需要 API)

  • 開源權重免費下載:官方提供了模型權重、Diffusers 範例與 ComfyUI LoRA 檔案(位於 comfy/loras/)。
  • 支援工作流:可以直接搭配 ComfyUI(支援 R2V、FL2VA、T2V)或 Hugging Face Diffusers 在本地 GPU 上推論。
  • 原生能力:本地運行即可生成原生 480p / 768p、帶同步立體聲音訊(Synchronized audio)的影片。
  • 硬體門檻:基於 MiniMax-H3 架構(約 33B 級別),本地推論需具備較大顯存的 GPU(建議具備 24GB+ VRAM 配合 CPU offload,或高階運算卡)。
Pika H3 Flex Tutorial in ComfyUI | Better Than MiniMax H3 Singularity ?

2. 什麼情況下才會用到付費 Pika API?

Pika 僅將部分雲端進階/託管服務作為選配(Optional Hosted Services):

  • 雲端超解析度升頻:將草稿影片升頻至 1080p、2K 或 4K。
  • 音訊分軌(Audio Stem Separation)。
  • 雲端提示詞增強(Prompt Enhancement API)。

如果只需要常規的影片生成(480p/768p + 音訊),直接下載權重並放進 ComfyUI 或 Diffusers 即可完全免費使用。
模型

Categories: AI productions, 模型, 多模態模型, 模型訓練, Video, Image, Audio, 提示詞, Content Creator, 音樂, MiniMax, LoRA

Viggle Remake 讓 H3 換掉影片人物並保留原有動作

想換掉影片人物、服裝或場景,又不想重拍整段素材?Viggle Remake 可按文字指令重製影片,保留原有動作、鏡頭、節奏與配樂。

Og image

要把影片人物換成其他角色,或改變服裝、天氣和場景,Viggle Remake 可以逐個鏡頭處理整段影片,並保留原有動作、鏡頭運動、時間節奏及配樂。項目屬於 20B 參數的 Video-to-Video 模型,基於 MiniMaxAI/MiniMax-H3,採用 LoRA;亦提供 Viggle app,毋須自行設定 GPU 即可使用。

它不只替換人物,亦能新增或移除物件、調整光線與風格。操作方式有兩種:交由支援 MCP 的 agent 根據影片和一句指令,自動找出剪接點、處理關鍵影格、逐段渲染並檢查結果;或自行撰寫提示詞、繪製一至四張影格,再用 sample.py 渲染鏡頭。前者適合整段影片的自動化製作,後者提供較直接的手動控制。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型規模:20B 參數,採用 LoRA。
  • 主要能力:人物重塑、服裝替換、物件增刪,以及場景、天氣、光線和風格變更。
  • 自動流程可處理多個鏡頭;示例包括 116 秒、69 個剪接點的影片,以及 101 秒影片。
  • 亦可透過 Viggle app 使用,毋須自行準備 GPU;自行執行則提供 sample.py 手動流程。
  • 頁面未列出 GGUF 檔名、量化級別、檔案大小、上下文長度、硬件需求或 llama.cpp、Ollama、LM Studio 支援資訊。

相較於只替換角色的 Viggle-Animate,Remake 擴展至物件增刪和環境變更,目標由角色動畫延伸至整段影片重製。示例展示多種改動及長片段處理能力,但項目文件沒有提供量化基準、硬件效能數據或不同量化版本,不能據此判斷本地執行所需資源或成品品質上限。

模型採用 MiniMax H3 Community License,使用前應先查看授權條款;示例亦註明,片中人物並未參與、批准或認可相關 AI 生成內容。這些限制對涉及真實人物、商業素材及公開發布的影片尤其重要。

模型

Categories: Agentic, AI productions, MCP, 模型, Video, 提示詞, Ollama, 動畫, MiniMax, LoRA

NitroFusion2:讓文字生圖一步生成清晰細節

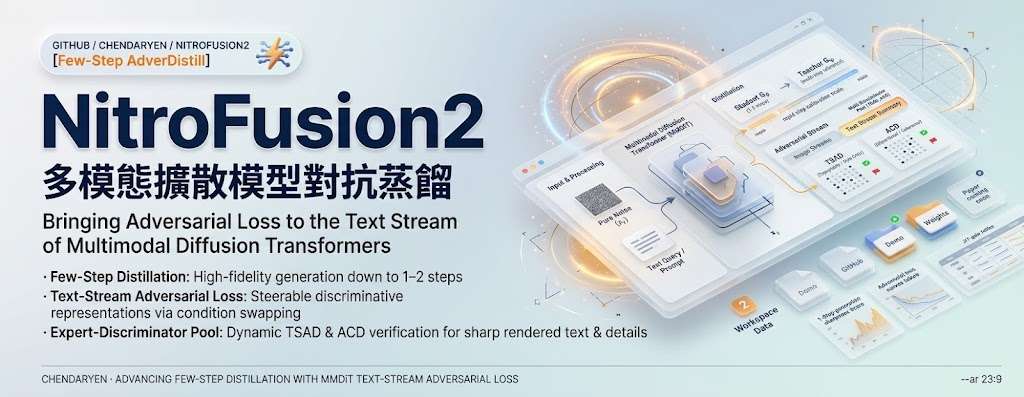
想快速生成帶有清晰文字和細節的圖片,NitroFusion2 把生成步數壓到一至兩步。它以 Z-Image-Turbo 為基礎,也提供減少瑕疵的兩步工作流程。

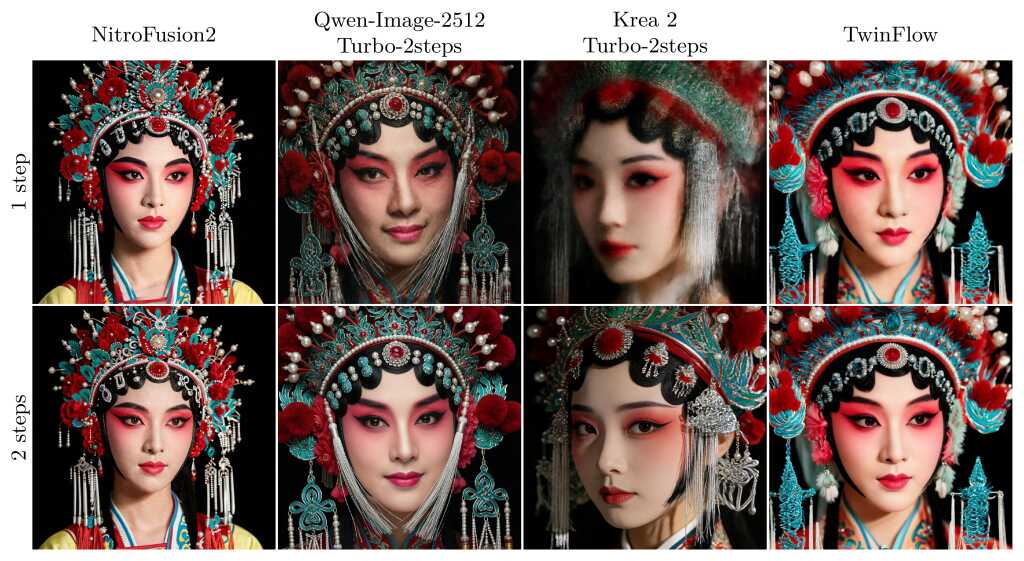
compare opera

需要快速出圖,又不想犧牲圖片中的文字與細節,NitroFusion2 以一至兩步生成作出回應。這個文字轉圖片模型建基於 Z-Image-Turbo,將對抗損失加入多模態擴散 Transformer(Multimodal Diffusion Transformer,MMDiT)的文字串流,讓模型在一步生成時也能呈現銳利文字和細節。

它的做法不只依賴圖片特徵判斷生成結果。MMDiT 的文字 token 經過共同注意力層後已讀取圖片資訊,因此 NitroFusion2 也利用文字串流中的中間狀態進行對抗式蒸餾;訓練方法還會按物件、文字排版或動作等提示,調整判別器關注的內容。這讓單一步生成兼顧速度和細節,但兩步流程仍可能出現瑕疵。

ComfyUI 使用者可直接載入項目提供的一步或兩步 workflow;兩步流程建議先以 0.5 強度套用 de-distillation LoRA,將 NitroFusion2 拉回 Z-Image-Turbo,再於第二步單獨執行 NitroFusion2,以減少部分瑕疵。項目亦提供 Diffusers 推理程式和 GGUF 權重,量化版本由 2.0 GB 至 7.2 GB,方便按可用儲存空間選擇;文件未列出不同版本的品質或速度測試數據。

  • 一步生成,主打清晰文字與細節。
  • 兩步流程可配合 de-distillation LoRA 減少部分瑕疵。
  • 提供 ComfyUI workflow、Diffusers 程式及線上示範。
  • GGUF 權重有多種大小,適合需要量化模型的使用者。

對需要快速製作含文字圖片的設計者,或想在本地工作流程試用少步數生成的開發者,NitroFusion2 提供了直接測試的模型與 workflow。若重視兩步生成的穩定度,應按建議加入 LoRA;生成速度與畫質仍需以依賴提示詞和硬件作驗證。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, 模型訓練, Image, 提示詞, LoRA

BYOD:用單張 GPU 將指令模型改造成雙向擴散模型

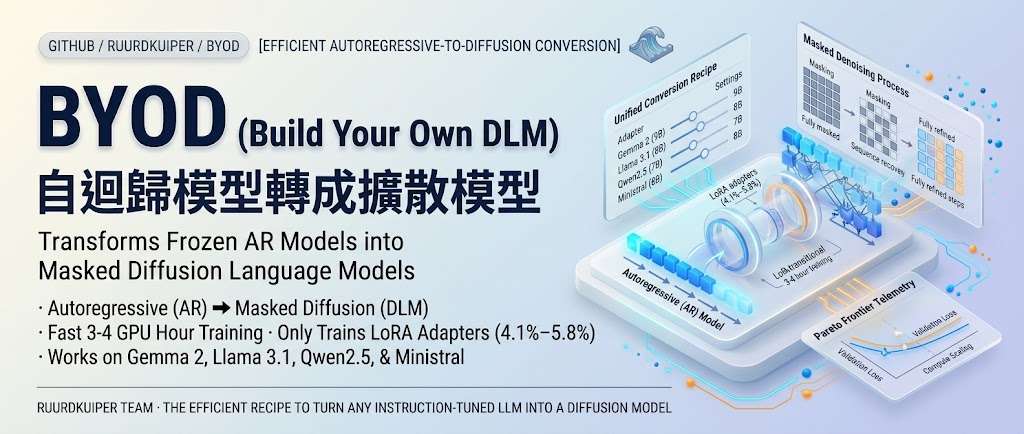
BYOD 讓你從 Colab Notebook 選擇指令模型並進行訓練,再透過互動介面觀察逐步去噪生成;但快速模式不會重現論文分數。

Repository image for RuurdKuiper/BYOD

BYOD 把指令模型轉成雙向遮罩擴散語言模型,讓模型生成文字時能逐步去噪,並在互動頁面即時查看生成變化。它是模型訓練工具,主要處理如何用單張 GPU 訓練這類模型;Colab Notebook 可選模型、啟動訓練及查看 loss 曲線,第 6 步會開啟可調整生成設定的推理介面。

使用方式分為 Colab 和本機兩條路徑:Notebook 會沿用 Colab 的 PyTorch、CUDA 套件,只在啟動推理介面時安裝 Gradio;本機訓練則需 NVIDIA GPU、Hugging Face 讀取權杖,並先接受受限模型的使用條款。本機推理網頁需安裝 .[demo] 套件。訓練資料會自動下載,手動中止時會保存 interrupted/,可載入該次結果繼續推理。

BYOD 以 LoRA 微調既有模型,而非從頭訓練;quick 模式採用較小模型和 rank-128 LoRA,適合先檢查流程,但不會重現論文分數。paper 模式使用 rank-1024 LoRA,原始訓練使用 96 GB 記憶體,對硬件要求高。兩種模式預設均訓練 25,000 次更新,訓練與驗證 loss 若出現 NaN 或無限值,程序會報錯並保留先前最佳 adapter。

  • Notebook 提供模型選擇、訓練和 loss 曲線檢視。
  • 推理介面可調整生成設定,並即時查看去噪過程;也支援載入中斷訓練的結果。
  • 可選 Llama、Gemma、Qwen 和 Ministral;各模型提供不同 quick 或 paper 配置,Ministral 只有 paper 配置。
  • 評估在每個 checkpoint 執行,輸出只保留 best/;本機訓練要求 NVIDIA GPU,quick 模式不等同論文設定。

研究者和模型工程團隊可用它比較不同指令模型經擴散式訓練後的生成過程,也可先透過託管示範體驗已訓練模型。若目標是復現論文結果,應採 paper 配置並準備高記憶體 GPU;低資源測試則可用 quick 模式確認訓練流程。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, NVIDIA, Gemini, 工具, LLaMa, Python, LoRA

FrameForge「換場景、不換主角」統一三種影像生成

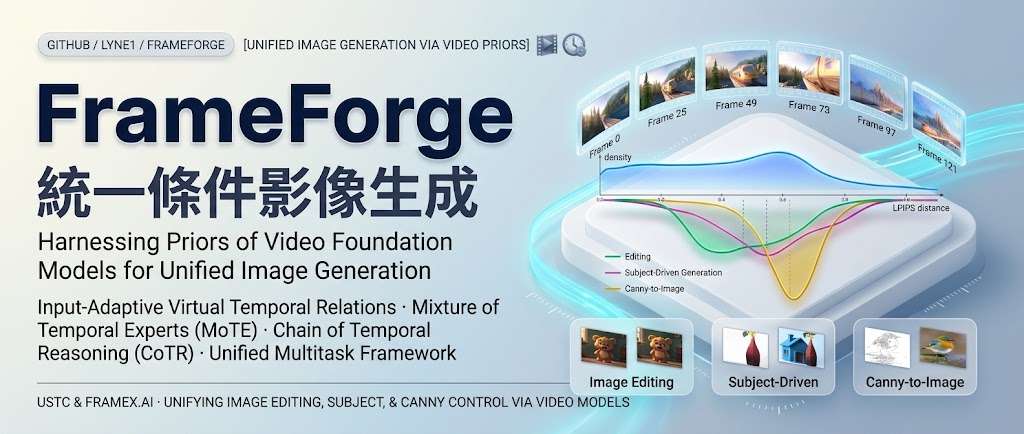
FrameForge 把 HunyuanVideo 1.5 的影片時間帶入影像生成,讓同一套模型處理主體生成、邊緣圖生圖和指令式編輯。

Repository image for Lyne1/FrameForge

同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。

FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。

它用同一個模型處理三種工作:

功能 你提供什麼 可以做什麼
參考主體生成 一張人物、動物或物件的參考圖,加上文字描述 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上
邊緣圖轉圖片 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 依照既有輪廓、姿勢與構圖生成完整圖片
文字指令修圖 原始圖片,加上修改指令 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容

這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。

技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。

官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。

注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Stable Diffusion, Video, Image, 影像模型, Linux, Python, 庫, 中國, LoRA

HDR mini-skill 讓 AI 片由 SDR 轉為 HDR

纯 ffmpeg + 自己生成的 3D LUT,不依赖 zscale / libplacebo / drawtext(Homebrew 的 ffmpeg 常常没带)。

Repository image for limin112/min-skill

把普通(SDR)視頻或其中一段,轉成 10-bit HEVC / HLG / BT.2020 的 HDR 文件:在 HDR 屏幕上,雲、太陽、水面反光、 金屬高光會“發光”。還能做左右對比:同一個文件里左邊 SDR、右邊 HDR。

  • 輸出 HLG HDR、10-bit HEVC 及 SDR/HDR 對比片。
  • 效果取決於素材。 米色卡片、文字、PPT 這類畫面轉成 HDR 只是把“紙”變亮,不適合。
  • 只有在 HDR 屏(Mac XDR、iPhone)上用 QuickTime 才有效果;普通播放器里會發灰、紅偏橙,這是正常的。
  • 原片已經是 HDR 的,腳本會拒絕(退出碼 2)。
  • 沒在真正的 HDR 屏上做過觀感驗證,也沒驗證過上傳各平台後是否保持 HDR;詳見 SKILL.md 末尾“已驗證 / 沒驗證”。

GitHub

Categories: 開源, 文字轉語音, AI productions, 數字人, 模型, Video, 框架, 工具, Content Creator, 3D, 庫, 語音, Anthropic, MiniMax, Skill 技能, LoRA

OmniShowcase:維持物件形態生成 360°影片運鏡

幾張多角度參考圖,就能引導 Wan2.1 生成沿不同鏡頭路徑移動的物件影片,並盡量保持外觀與立體結構一致。現階段程式碼與資料集尚未公開,硬件需求亦未交代。

Repository image for justin4ai/OmniShowcase

想把一件商品或角色放進不同場景,再沿環繞鏡頭拍成影片,難處是視角轉到參考圖以外時,物件外形容易走樣。OmniShowcase 是一個影片生成模型項目,利用少量多視角圖片生成同一物件的影片,鏡頭路徑涵蓋完整 360° 環繞,目標是維持物件身份與 3D 結構。

它以 Wan2.1 image-to-video 模型為基礎,透過輕量 LoRA 調整生成模型。流程會由四張參考圖重建物件,再渲染成一組表面法線圖作為條件;生成影片時,鏡頭不必逐格對齊這組法線圖,提示詞可指定其他運鏡路徑。這令模型能沿指定路徑生成影片,而不只是重播固定的旋轉角度。

  • Showcase-4K 是合成訓練資料集,涵蓋 12 種鏡頭運動及 88 種路徑配置。
  • ShowcaseBench 是評測資料集,提供影片對應的來源網格與鏡頭參數,方便檢查生成結果。
  • 項目展示環繞、螺旋下降、弧線移動、推近及拉遠等運鏡;目前提供的資訊未列出量化評測分數。
  • 訓練資料、評測集、推理程式碼及訓練程式碼均尚待公開,暫時未能按文件安裝或執行。

這種方法適合商品展示、角色視覺化及需要多角度鏡頭素材的內容製作,也可供研究多視角條件影片生成的團隊參考。代價是生成品質依賴參考圖的 3D 重建與表面法線條件。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 提示詞, 3D, Dataset 數據集, LoRA

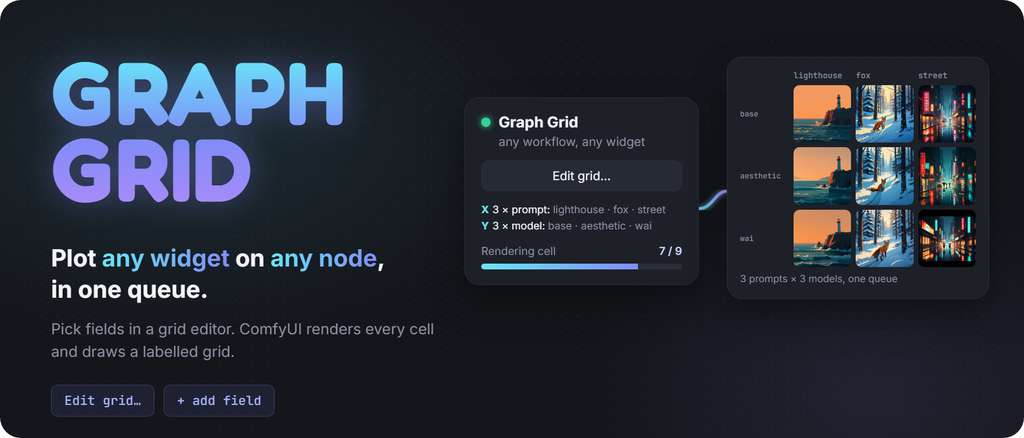
ComfyUI Graph Grid:一個比較提示詞、LoRA 與模型設定

ComfyUI Graph Grid 將不同提示詞、LoRA 強度、採樣器或 checkpoint 排成圖表,列隊生成,方便逐格比較結果。

Graph Grid: plot any widget on any node, in one queue

將提示詞、LoRA 強度、CFG、採樣器或 checkpoint 放到行列中比較,ComfyUI Graph Grid 會一次佇列所有組合,再輸出附有標籤的圖像網格。它屬於 ComfyUI 自訂節點,處理的是影像生成工作流中逐組改參數、逐張記錄和肉眼比對過於零散的問題。

安裝可透過 ComfyUI Manager 搜尋 Graph Grid,或放入 ComfyUI/custom_nodes 後重新啟動。使用時把最終影像輸出接到 Graph Grid,再把 grid 輸出接至 Preview Image 或 Save Image;在編輯器中選擇要變動的 widget,填入行列值後佇列生成即可。項目已在 ComfyUI 0.41.0 測試,標籤位置亦取決於 Pillow 10.1 或更新版本。

它不要求特別的 loader 或 sampler,而是複製每格需要改動的上游圖段,讓 ComfyUI 執行各組設定;沒有變動的節點可載入一次,重複內容亦有機會由快取提供。接線中的 widget 不能直接變更,必須改動負責輸入的上游節點,其他未接入 Graph Grid 的輸出節點仍會以原值執行。

• 可同時比較多個欄位,亦能用數值範圍、下拉選單選項或逐行文字填充。
• 空白格會保留原本設定,Cross with existing 可建立完整組合。
• 適合測試 LoRA 權重、提示詞、模型和採樣參數的差異。
• 生成量會隨行列組合增加,顯存、時間和輸出整理成本仍需自行控制。

對需要挑選模型、整理提示詞實驗,或為影像生成流程建立可重現比較表的創作者和研究者,Graph Grid 能補足 ComfyUI 原生流程缺少的批量對照介面;它不會替你判斷哪組設定最好,價值在於把比較過程變得一致、可視化和容易回看。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Image, 提示詞, Content Creator, LoRA

DirCast-code:AI 同時導播與解說,直播一手包辦

DirCast 每秒查看 Dota 2 十名英雄的鏡頭,自行選擇播出畫面並配上解說。它把導播與主播工作交給同一個模型,但目前評估仍集中於有限的職業賽事。

DirCast

直播觀眾看到的畫面和聽到的解說,通常由導播與主播共同決定;DirCast 嘗試讓 AI 每秒查看十名英雄的原始鏡頭,選出播出畫面,再按該畫面決定何時發言及說甚麼。這個研究型工具以 Dota 2 賽事為場景,處理的是如何在比賽仍在進行時,同步完成選鏡和解說,而非只替已剪好的直播影片配音。

DirCast 使用單一串流影片語言模型 Qwen3-VL-8B,並以 LoRA 微調。模型先低解像度掃描各英雄鏡頭及遊戲狀態,再由導播模組決定維持現有畫面或切換;選中的鏡頭會再以高解像度讀取,供發言判斷和文字生成。這種安排把全場掃描與播出畫面的細節理解分開,也讓模型的解說跟隨自己選出的畫面。

模型不會永久保留所有低解像度鏡頭:這些畫面只在設定的時間窗內留在上下文,播出畫面、事件和已生成的說話則會保留,令處理長賽事時的上下文成本受控。訓練時加入受擾動的播出流程,讓模型練習從自己選錯鏡頭後恢復;事件標記則協助它把擊殺等值得呈現的時刻納入選鏡考量。控制切鏡與發言的門檻亦會按頻率調節,避免節奏過密。

研究資料集包含 27 場職業 Dota 2 比賽,記錄每名英雄的鏡頭、人類導播選擇及主播解說。示範涵蓋兩場留出比賽,展示模型切到鏡頭外發生的交戰並作出評論;但這些例子不足以證明它已能應付不同遊戲、直播延遲或長期穩定運作,現階段較適合研究團隊測試自動化直播製作,而非直接取代真人轉播團隊。

  • 每秒掃描十路英雄鏡頭,並自行選擇播出畫面。
  • 同一模型負責導播決策、發言時機及解說文字。
  • 低解像度畫面會過期,播出內容與事件記錄則留在上下文。
  • 訓練資料來自 27 場職業 Dota 2 比賽,公開示範展示兩場留出賽事。

GitHub 儲存庫提供模型、資料處理與賽事狀態相關程式碼;研究人員可據此檢視流程或測試模型。儲存庫資訊未列出完整安裝步驟、硬件需求或可直接重現的評估指標,因此部署成本與相對真人導播、主播的穩定差距,仍需更多測試才能判斷。

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, 模型, 模型訓練, Qwen, OpenAI, Video, 工具, 庫, Dataset 數據集, LoRA

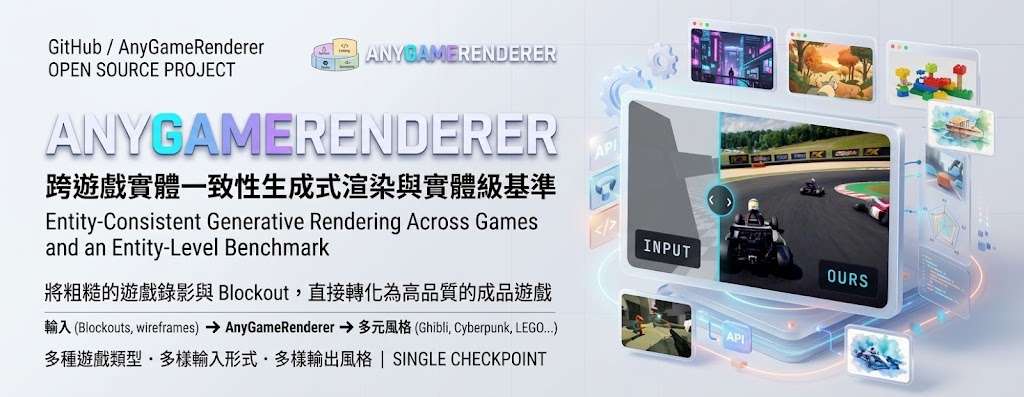
AnyGameRenderer 把粗糙遊戲錄影變成可玩風格畫面

由灰色方塊與代理色組成的遊戲錄影,配合文字提示即可重繪成不同風格,同時保留角色、物件數量與動作時間。

genre trenchfire

遊戲原型仍是灰色方塊、彩色幾何體,AnyGameRenderer 就能把一段 24 fps、2 至 15 秒的普通影片,重繪成 AAA 寫實、LEGO、Ghibli、蠟筆或 synthwave 等風格。它屬於生成式影片模型,處理的是「畫面變漂亮後,角色位置、數量和出現時間仍要對得上」的問題。

輸入不需要逐物件標籤、引擎掛鈎或固定遊戲引擎格式,wireframe、semantic map、粗略 3D mockup、彩色 primitive 和 engine whitebox 都可作為來源。單一 checkpoint 已涵蓋 tower defense、kart racing、shooters、survivors-like 和回合制戰鬥等類型,適合 AI 遊戲生成工具、原型展示和美術風格探索。

  • 保留 entity correspondence,細小及遠距離物件較不容易消失
  • 文字提示可改變整體美術風格,同一段輸入可產生多種世界觀
  • 以 entity-level benchmark 評估,而非只看逐幀畫面相似度
  • LoRA 訓練尺寸為 1344×768、124 frames;更長影片可執行,但未按該長度訓練

59 個測試案例、753 個 ground-truth entities 中,temporal match 由 zero-shot base 的 50.9% 升至 62.9%,position match 由 57.1% 升至 61.9%;未渲染率由 4.1% 降至 2.9%,hallucination rate 由 52.1% 降至 46.0%。提升仍未代表每個物件都能穩定對齊,長片段和高密度場景仍需檢查輸出。

需要 Python 3.10、PyTorch 2.9.1+cu128 等環境資訊,以及 setup_env.sh 和權重下載流程;完整執行仍需要相應 GPU 環境。項目同時公開模型與資料集連結,較適合希望把可玩原型快速轉成視覺樣片的開發者和研究團隊。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Video, 工具, 3D, Python, 編程, Dataset 數據集, LoRA

Page 1 of 3
1 2 3